Anuncio¡Presentamos MongoDB 8.0, el MongoDB más rápido de la historia! Leer más > >>
AnuncioVoyage AI se une a MongoDB para potenciar aplicaciones de IA más precisas y confiables en Atlas. Más información > >>

¿Qué es la Inteligencia Artificial (IA)?

Pruebe MongoDB Atlas gratis

La inteligencia artificial (IA) es la capacidad de las máquinas para pensar racionalmente, resolver problemas y tomar decisiones sin la supervisión de una mente humana. Con la llegada del aprendizaje automático y las tecnologías de aprendizaje profundo, las máquinas pueden "pensar" y "aprender" basándose en los datos que se les suministran y realizar tareas que antes solo podían realizar los humanos. En este artículo, exploraremos más sobre inteligencia artificial, IA generativa y cómo MongoDB está cambiando la fachada de la IA generativa al simplificar el procesamiento de IA, habilitar búsquedas basadas en el contexto y mejorar la precisión de los grandes modelos de lenguaje (LLM).

Índice

Explicación de la inteligencia artificial

La inteligencia artificial es un campo de la informática que permite a las máquinas participar en el razonamiento, la toma de decisiones inteligentes y el análisis de datos, a una escala que se percibe como superior a la comprensión y las capacidades humanas. Incluye campos como la ciencia de datos, la estadística, la neurociencia y el aprendizaje automático, que a su vez incluye técnicas de aprendizaje profundo, en las que se basan nuestros algoritmos modernos. Estos algoritmos son la base para que la IA tome decisiones similares a las humanas al comprender los datos en los patrones y realizar tareas difíciles con facilidad y precisión.

Algunos ejemplos populares de sistemas de inteligencia artificial incluyen ChatGPT, asistentes virtuales como Alexa y Siri, autos autónomos y motores de recomendación.

Cómo es que la IA es similar a la inteligencia humana

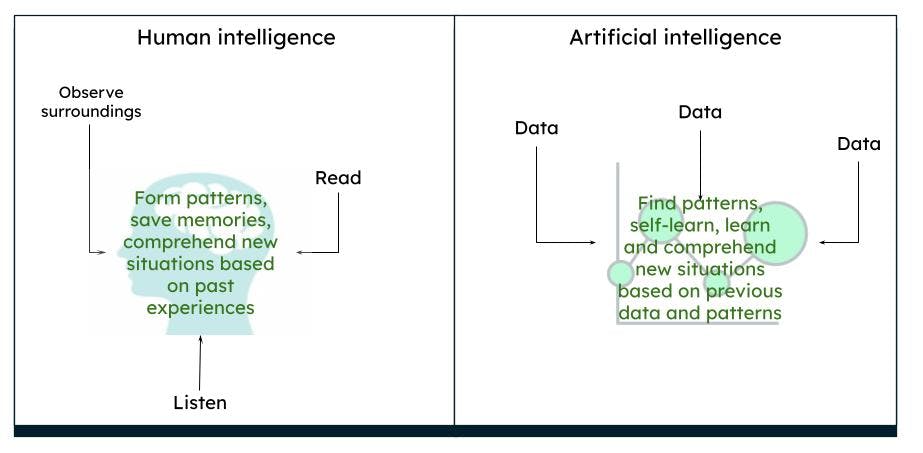
El cerebro humano funciona de una manera compleja. Pensamos, actuamos y tomamos decisiones con base en nuestras experiencias y recuerdos pasados, que dan como resultado patrones casados en el entorno y las situaciones. A lo largo de un periodo de tiempo, lo que observamos es lo que el cerebro percibe como real. Por ejemplo, si vemos constantemente una rosa roja, nuestro cerebro procesa que una rosa es de color rojo y tiene cierta forma y tamaño. Si leemos o escuchamos que las rosas también pueden ser amarillas o de color rosa, basándonos en nuestro conocimiento previo de una rosa roja, imaginamos que una rosa amarilla o de color rosa se parece mucho, en cierto modo, a una rosa roja.

Representación de la inteligencia humana frente a la inteligencia artificial

La IA funciona de la misma manera. Cuando una computadora recibe suficientes datos, es capaz de deducir ciertos resultados a partir de los patrones de datos mediante algoritmos. Por ejemplo, si se proporcionan datos sobre rosas y colores, la próxima vez que la computadora vea un objeto similar, puede identificarlo como una rosa de un color determinado.

IA frente al aprendizaje automático

La IA es un término más amplio que consiste en teorías y sistemas para construir máquinas que realicen tareas que requieran inteligencia. El aprendizaje automático es una rama de la IA que se centra en analizar datos para encontrar patrones y orientar la toma de decisiones mediante diversos algoritmos, sin necesidad de programación explícita. Las técnicas de aprendizaje automático consisten en métodos de aprendizaje supervisado, no supervisado y de refuerzo.

Aprenda más sobre cómo nuestro Grupo de investigación de aprendizaje automático de MongoDB está brindando los últimos avances en aprendizaje automático.

Aprendizaje profundo

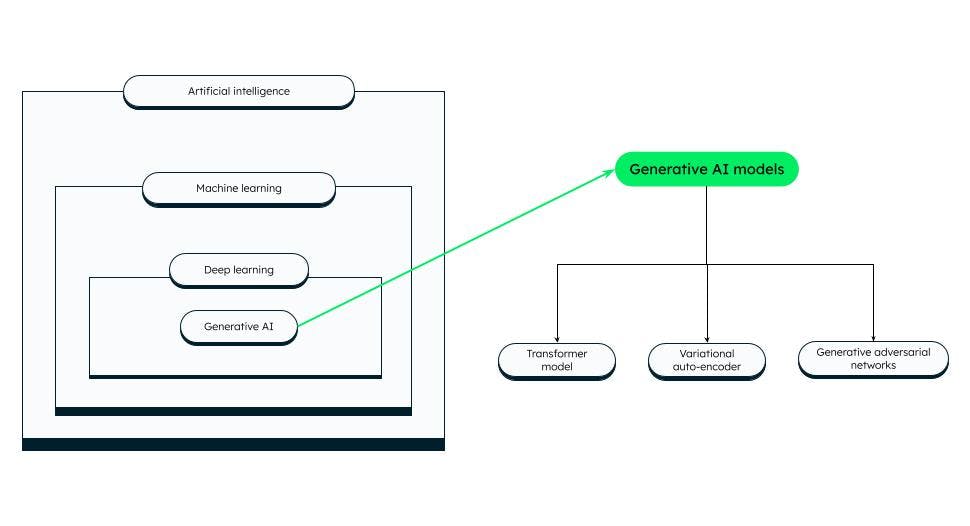
Aprendizaje profundo es un subconjunto del aprendizaje automático que se asemeja a la inteligencia humana. Los modelos de aprendizaje profundo consisten en redes neuronales profundas artificiales —es decir, neuronas (o nodos) interconectadas— y tienen muchas capas, lo que les permite procesar patrones de datos más complejos que los algoritmos de aprendizaje automático. Los LLM y las IA generativas son subconjuntos del aprendizaje profundo. Hay muchas redes neuronales artificiales que se pueden utilizar para tareas específicas.

Todas estas redes neuronales se basan en un “perceptrón”, que es la red neuronal más básica utilizada para la clasificación binaria. El perceptrón consiste en una sola capa de neuronas que toma una capa de entrada, aplica pesos y alimenta a la capa de salida.

A continuación se muestran varios tipos comunes de aprendizaje profundo:

Red neuronal feedforward (FNN)

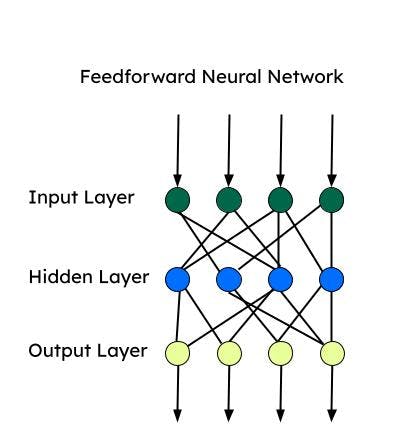
Feedforward es una de las primeras redes neuronales artificiales desarrolladas y consiste en un grupo de múltiples perceptrones en cada capa. También se la conoce como perceptrón multicapa (MLP). Sólo suministra información en una dirección, es decir, hacia adelante, y no hay bucles. Las redes neuronales feedforward tienen entrada, salida y una capa oculta que procesa la entrada. Las FNN se utilizan para el aprendizaje supervisado, cuando los datos no dependen del tiempo ni son secuenciales.

Redes neuronales convolucionales (CNN)

Las CNN son un tipo de FNN que se utilizan para tareas complejas de clasificación de imágenes, visión por computadora, análisis de imágenes y procesamiento de lenguaje natural. Una CNN mira un parche de imagen a la vez y avanza con un menor número de parámetros a la vez para aprender o extraer las funcionalidades más importantes. La extracción de funcionalidades se realiza mediante kernels durante una operación de convolución.

Redes neuronales recurrentes (RNN)

Las redes neuronales recurrentes (RNN) son más adecuadas para datos secuenciales, donde el orden de entrada es crucial. La información secuencial se captura mediante un bucle en la capa de entrada. Las RNN son más adecuadas para datos de series de tiempo y procesamiento de lenguaje natural. La memoria a corto y largo plazo (LSTM) es un tipo de RNN que tiene celdas de memoria para almacenar las dependencias de los datos secuenciales. Las LSTM son bastante buenas en reconocimiento de voz, análisis de sentimientos y traducción.

Autocodificador

Los autocodificadores consisten en un codificador y un decodificador. Los codificadores comprimen las dimensiones de los datos a un espacio dimensional inferior (espacio latente). Los decodificadores reconstruyen los datos de entrada utilizando el espacio latente. Los autocodificadores se pueden utilizar para la eliminación de emisiones, la reducción de dimensionalidad y el aprendizaje de funcionalidades.

Redes de autoatención (SAN)

La arquitectura codificador-decodificador puede recordar secuencias más cortas. No obstante, puede olvidar parte de la información (particularmente la información que se recibe primero) en una secuencia larga. Con un mecanismo de atención, el decodificador puede atender a toda la secuencia y utilizar el contexto de toda la secuencia para producir la salida. La autoatención permite procesar todo el texto de entrada a la vez y crea relaciones entre todas las palabras en toda la secuencia. Con esta funcionalidad, la autoatención funciona más rápido que una RNN o CNN para dependencias de largo alcance.

Historia de la inteligencia artificial

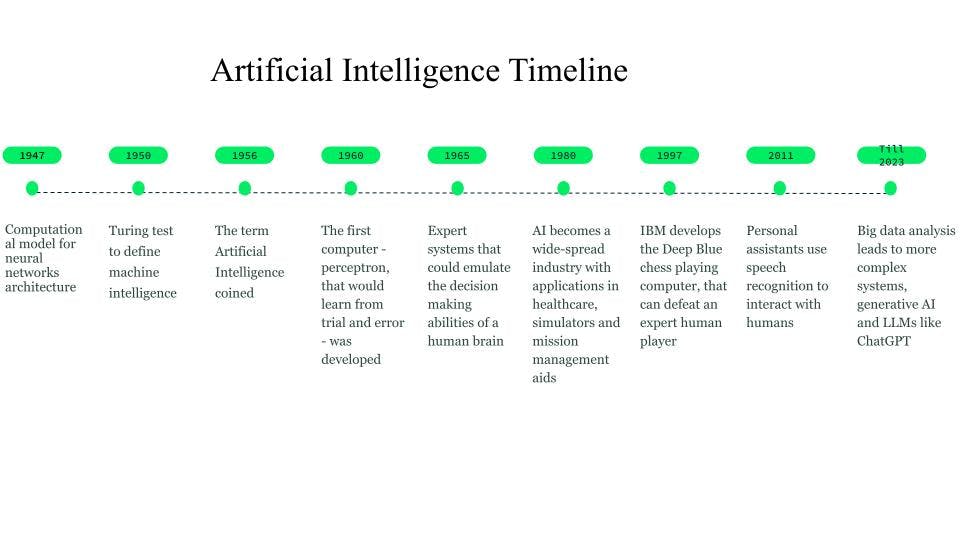
Aunque las primeras imaginaciones comenzaron en el año 750 a.C. a través de libros e ideas basadas en la ciencia ficción y las máquinas pensantes, las primeras bases de las redes neuronales fueron sentadas en 1947 por Walter Pitts y Warren McCulloch, que crearon un modelo computacional para la arquitectura de las redes neuronales.

En 1950, Alan Turing introdujo el test de Turing, para definir la inteligencia de las máquinas.

El término inteligencia artificial se acuñó en 1956, cuando John McCarthy organizó un taller de IA y definió el término como la ciencia y la ingeniería de hacer que las máquinas sean inteligentes. A principios de la década de 1960, Frank Rosenblatt desarrolló el primer programa informático, Perceptrón, que un programa de IA aprendería de prueba y error. Más tarde, en 1963, John McCarthy fundó el laboratorio de IA.

El siguiente gran avance en la IA llegó con los sistemas expertos, sistemas informáticos basados en el conocimiento que requieren inteligencia humana, pero que podían emular las capacidades de toma de decisiones de un experto humano. Estos sistemas fueron formas de IA bastante exitosas y se utilizaron como tecnología de IA en la atención médica, en simuladores de combate y entrenamiento, y como ayudas para la gestión de misiones. Durante la década de 1980, la inteligencia artificial se convirtió en una industria en la que se invirtieron miles de millones de dólares en sistemas expertos, sistemas de visión y robótica.

En 1997, el desarrollo de Deep Blue, el ordenador de IBM que jugaba al ajedrez y derrotó al entonces campeón mundial de ajedrez, despertó un mayor interés por la inteligencia artificial. Desde entonces, se han producido rápidos avances en este campo.

Alrededor de 2010, los investigadores que trabajaban en la traducción del lenguaje natural descubrieron que, en comparación con los modelos con sistemas basados en reglas, los modelos que se alimentaban con grandes cantidades de datos de texto diversos producían resultados mucho mejores. En 2011, entraron en escena asistentes personales como Cortana, Siri y Alexa, que podían responder preguntas mediante el procesamiento de lenguaje natural y realizar tareas.

En 2014, los modelos de lenguaje comenzaron a comprender el contexto en el que aparecía una palabra. Los trabajos posteriores dieron lugar a modelos de lenguaje generales que proporcionaban modelos de base o fundamentales que podían adaptarse a un caso de uso o dominio específico.

Estos modelos básicos nos han llevado hacia la IA generativa y los grandes modelos de lenguaje (LLM) como ChatGPT. Junto con esto, la IA agéntica está surgiendo como una tecnología relacionada, un tipo de sistema de inteligencia artificial que puede tomar decisiones, realizar acciones y adaptarse de forma autónoma a entornos cambiantes para lograr un objetivo específico.

Historia y cronología de la IA

Tipos de IA

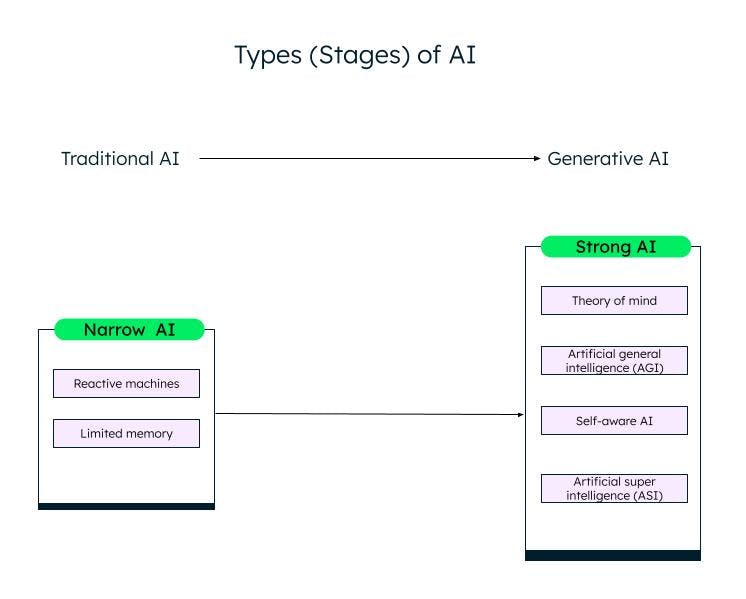
Una clasificación amplia de la inteligencia artificial, basada en su capacidad, es la IA estrecha (o débil) y la IA fuerte. A través de la investigación y los avances en el campo del aprendizaje automático y los algoritmos de aprendizaje profundo, estamos avanzando de la IA débil a la IA fuerte.

IA estrecha

Los sistemas de IA débil/IA estrecha, o de inteligencia artificial estrecha (ANI), se entrenan para realizar tareas específicas y tienen capacidades limitadas en función de los datos con los que se entrenan. También se conocen como sistemas de IA tradicionales, en los que el sistema puede responder de forma inteligente en función de un determinado conjunto de entradas y reglas. Sin embargo, no puede crear nada nuevo.

Las IA tradicionales o débiles se clasifican a su vez en dos categorías: máquinas reactivas y memoria limitada.

Máquinas reactivas

La forma más antigua de inteligencia artificial eran las máquinas reactivas que no tenían memoria pero podían emular la capacidad de un humano para responder a diferentes estímulos. No pueden aprender de su experiencia (no tienen memoria) y basan su respuesta en una combinación limitada de entradas. La máquina Deep Blue de IBM es una máquina reactiva.

IA de memoria limitada

Los sistemas de memoria limitada tienen memoria y pueden aprender y tomar decisiones basándose en los datos de entrada proporcionados. La mayoría de las IA que vemos —los autos autónomos, los chatbots, los asistentes personales como Alexa y los sistemas de recomendación como el de Netflix— son ejemplos de IA de memoria limitada.

IA fuerte

Con la innovación de ChatGPT y otros modelos de IA generativa similares, estamos entrando lentamente en la fase de IA fuerte. La IA generativa es una especie de IA de última generación, que puede crear algo nuevo basado en las entradas del usuario. ChatGPT es un ejemplo de IA generativa basada en el modelo de lenguaje grande (LLM). Queda mucho trabajo por hacer en la IA fuerte, que se puede clasificar de la siguiente manera:

Teoría de la mente (ToM)

La ToM es una habilidad cognitiva que permite comprender los distintos estados mentales —como las creencias, los pensamientos y los sentimientos de los demás— para explicar su comportamiento y sus acciones. Los investigadores están trabajando para aplicar la ToM a la IA con el objetivo de permitir que los sistemas de IA comprendan las emociones y los estados mentales de los seres humanos. ChatGPT, la nuevo IA que puede interactuar con humanos en lenguaje natural y producir nuevos contenidos, ha demostrado alguna forma de teoría de la mente durante las pruebas. Sin embargo, todavía no posee la capacidad de comprender deseos, creencias o emociones. Las respuestas de ChatGPT se basan en datos y patrones comunes.

Inteligencia artificial general (AGI)

La inteligencia artificial general es la siguiente etapa del desarrollo de la IA, en la que un sistema o agente de IA se comportará exactamente como un ser humano, desarrollando de forma independiente múltiples competencias y funcionalidades, además de establecer conexiones y generalizaciones, con poco o ningún entrenamiento.

Autoconsciente

La siguiente etapa es un punto de singularidad de la IA, donde las máquinas serán conscientes de sí mismas. Tendrán sus propios deseos, creencias y emociones, además de comprender las emociones, deseos y creencias de los humanos. Los agentes autoconscientes se pueden utilizar en el cuidado de la salud y la robótica.

Superinteligencia artificial (ASI)

La IA autoconsciente puede conducir a la ASI, en la que los agentes de IA podrían convertirse en sistemas de inteligencia artificial superinteligentes y superar a los humanos en valores y motivaciones. Las IA autoconscientes y las ASI podrían plantear problemas relacionados con el empleo y la ética, por lo que los investigadores y los gobiernos deben estar alerta y establecer normas y directrices.

Diferentes etapas (tipos) de IA
Modelos fundacionales

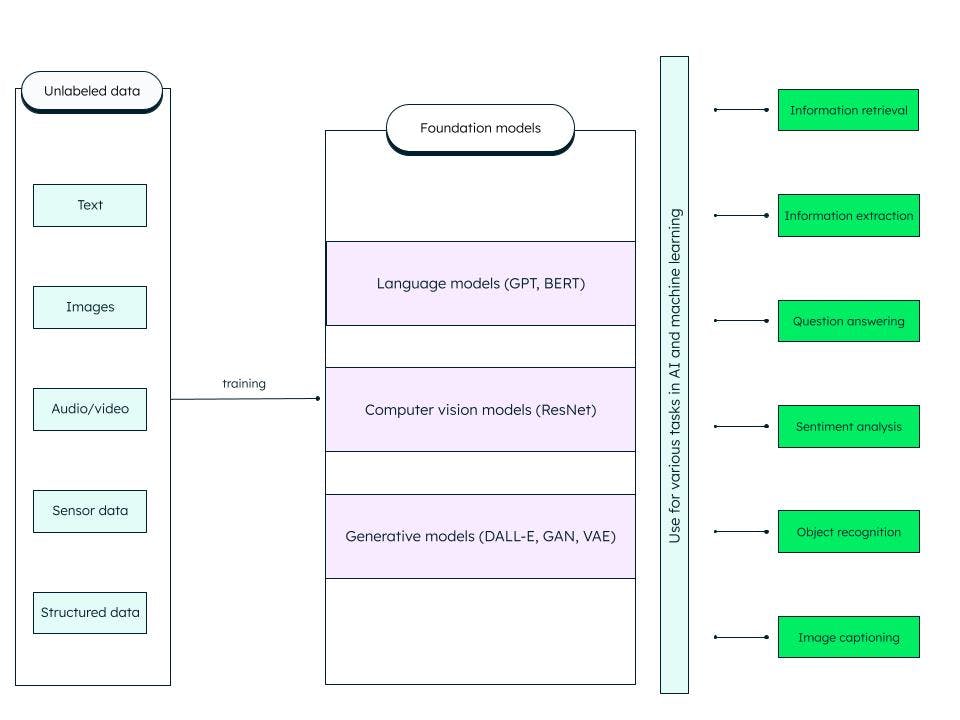
Los modelos de base son redes neuronales profundas artificiales generalizadas capacitadas en grandes cantidades de datos no estructurados. Están diseñados para servir como modelos de uso general. Podemos construir modelos más específicos para tareas de IA y aprendizaje automático personalizando estos modelos de base preentrenados.

Por ejemplo, un modelo básico como el gran modelo de lenguaje entrenado en datos de texto puede utilizarse para diversas tareas, como la recuperación de información y las preguntas y respuestas. El transformador preentrenado generativo o GPT (en el que se basa el famoso ChatGPT) y BERT (representaciones codificadoras bidireccionales a partir de transformadores) son ejemplos de modelos de base LLM. ResNet (red residual) es un modelo básico popular de visión artificial para tareas de clasificación de imágenes y visión artificial. Los modelos de base son muy adaptables y pueden autosupervisarse e improvisar a través de indicaciones y ajustes.

¿Qué incluye el modelo base?

IA Generativa

IA generativa se basa en modelos de base que pueden realizar tareas como la clasificación, la finalización de oraciones, la generación de imágenes o voz y la creación de datos sintéticos (generados artificialmente). Los modelos de base se ajustan para adaptarse a la tarea generativa específica en cuestión. El éxito de un modelo de IA generativa depende de la calidad y la diversidad de los datos, así como de la velocidad de generación.

Modelos de IA generativa

Existen diferentes categorías de modelos de IA generativa, y algunas de las destacadas son:

Modelo de Transformer

La arquitectura basada en transformadores es bastante precisa para identificar las relaciones contextuales entre palabras (datos). La generación de texto, la traducción automática y el modelado del lenguaje, como GPT (utilizado en ChatGPT), son ejemplos de arquitectura de transformadores.

Attention is all you need

El modelo de transformador funciona con un mecanismo de autoatención, en el que la importancia de cada elemento en una secuencia de entrada se sopesa durante el procesamiento del texto, capturando así la información contextual de manera efectiva.

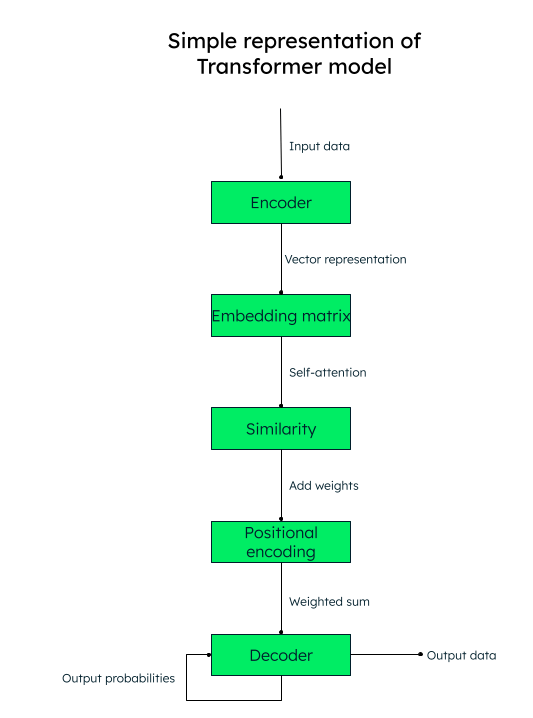
Por ejemplo, si quiere traducir el texto en inglés “Me encanta escribir sobre inteligencia artificial” al español, el modelo transformador pasaría esta secuencia de palabras (tokens) al codificador (red neuronal). Las palabras de entrada se convierten en una representación vectorial numérica (incrustaciones de palabras), que consta de los vectores de query (la transformación necesaria), la clave (entrada) y el valor (salida).

Por ejemplo, para la palabra “amor” en nuestra oración, tendríamos vectores q*amor, k*amor, y v_amor. Se crea una matriz con la puntuación de similitud de cada palabra con otra. Por ejemplo, se generaría la similitud de la palabra “amor” con todas las demás palabras de la oración, una puntuación más alta indica más similitud.

El siguiente paso es calcular los pesos de atención que determinan cuánta importancia se le debe dar a cada palabra de la oración en relación a la palabra clave principal (“amor”, en nuestro caso). El siguiente paso consiste en agregar las codificaciones posicionales a las representaciones vectoriales. Las incrustaciones posicionales (similitud + codificación posicional) ayudan al decodificador (otra red neuronal) a decidir el orden en el que deben colocarse los tokens de salida (palabras).

Representación del modelo de Transformer

Autocodificadores variacionales (VAE)

Los VAE son bastante populares para la generación de imágenes, la compresión de datos y la eliminación de ruido en imágenes. En un VAE, la red neuronal del codificador toma los puntos de datos de entrada y los mapea a una representación espacial latente. Un espacio latente es la representación de datos en una dimensión inferior mediante la extracción de las características más importantes de los datos y el descarte de otras características. La red neuronal del decodificador reconstruye los datos de salida basándose en la representación latente.

Redes generativas antagónicas (GAN)

Las GAN se utilizan ampliamente para crear imágenes realistas, arte, videos deepfake, traducción de imagen a imagen e imágenes de súper resolución. Una GAN consiste en un generador (red neuronal) que toma ruido aleatorio o una semilla como entrada y crea muestras de datos sintéticos (como una imagen). Las muestras de datos sintéticos se introducen luego en otra red neuronal, el discriminador, que utiliza la clasificación binaria para determinar si las muestras son falsas o reales. Mediante el entrenamiento adversarial, el generador y el discriminador se entrenan simultáneamente hasta alcanzar un equilibrio de Nash, en el que el generador puede producir datos realistas de alta calidad (como imágenes) y el discriminador los clasifica con precisión como reales o falsos.

Grande modelo de lenguaje (LLM)

Los LLM son un modelo básico que se entrenan con grandes conjuntos de datos y proporcionan una experiencia casi precisa y atractiva para los usuarios. Para poder crear estos modelos, es necesario capturar grandes cantidades de datos de múltiples fuentes, almacenarlos correctamente y procesarlos y recuperarlos en función de la relevancia, cuando sea necesario.

Los LLM se pueden utilizar para la resolución de problemas generales, como responder preguntas, generar texto, clasificar y resumir textos, y ajustar mediante el ajuste y la incitación a entrenar con un conjunto mínimo de datos para resolver problemas específicos.

¿Cómo funciona un LLM?

Los modelos básicos aprenden de los patrones de datos y producen un resultado flexible y generalizable, que luego se puede aplicar a diferentes instancias específicas. Uno de estos casos es el LLM, que se aplica a las entradas basadas en texto. Los LLM constan de datos, arquitectura y entrenamiento. Por lo general, los datos son petabytes de libros grandes, conversaciones y contenido de texto. La arquitectura es una red neuronal profunda y, en el caso de GPT, es el transformador. Durante el entrenamiento, el modelo aprende a predecir la siguiente palabra de cualquier oración dada.

Sin embargo, hay tres problemas con el LLM:

  • Si se ha desarrollado o cambiado alguna información después de que el modelo esté completamente entrenado, el modelo no lo sabrá y podría dar resultados obsoletos. Por ejemplo, si le pide al modelo: "Dame una lista de buenas películas de comedia en los últimos 6 meses", ¡el modelo no podría hacerlo si se entrenara hace seis meses!

  • Es posible que el modelo tenga información incorrecta dentro de su representación interna.

  • El modelo no puede acceder a sus datos privados y podría presentar información sesgada o incompleta basada en conocimientos limitados.

Generación aumentada de recuperación (RAG)

El marco de IA RAG tiene como objetivo resolver los problemas anteriores y mejorar la calidad de las respuestas de LLM proporcionando al modelo una verdad fundamentada en una base de conocimiento externa que complementa la información presentada internamente en el LLM. Esto reduce las posibilidades de que el modelo identifique incorrectamente un patrón u objeto inexistente (alucinaciones) y la información incorrecta, engañosa y desactualizada.

La arquitectura de recuperación utiliza un almacén de vectores y aumenta la capacidad de LLM a través de la búsqueda vectorial.

MongoDB Atlas, la plataforma unificada de datos, proporciona búsqueda vectorial dentro de la plataforma (que puede configurar en unos sencillos pasos) para mejorar la salida de su LLM y producir resultados más precisos.

Aprendimos en la sección anterior sobre el modelo de transformador y que los vectores son representaciones numéricas de datos de texto. Por ejemplo, la representación vectorial de nuestra oración anterior, “Me encanta escribir sobre inteligencia artificial”, podría ser similar a:

“Me encanta...” = [0.33, 0.45, 0.72, -0.23…..]

La representación vectorial anterior incluye la relación entre cada palabra, por ejemplo, cómo la palabra “artificial” se relaciona con la palabra “inteligencia” o con la palabra “guardar”, o cuál es el contexto de la palabra “‘amor”’ en esta oración.

Estos vectores se generan (como vimos en el modelo de transformador) enviando los datos de entrada a través de una red neural profunda (codificador).

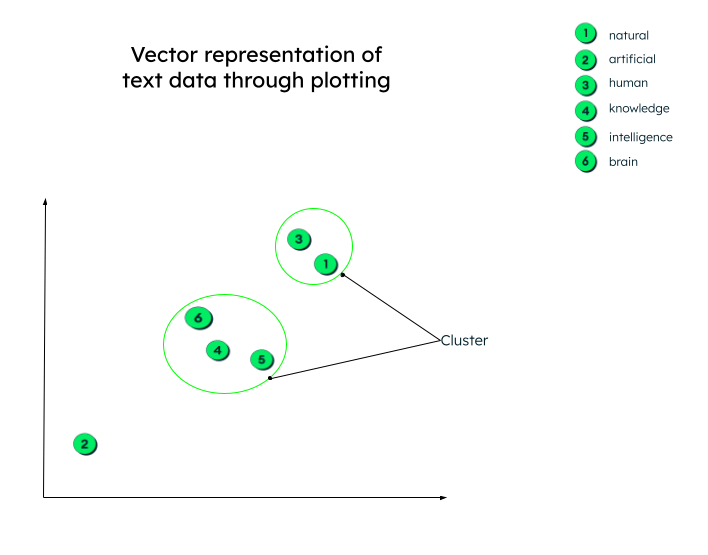
En realidad, las representaciones vectoriales pueden tener cualquier cantidad de dimensiones. Cuantos más parámetros tengan los datos, más dimensiones tendrán. Para poder dar sentido a estos números y entender qué ocurre después de que se generen estos vectores, tracemos un grafo en dos dimensiones para facilitar la comprensión.

Todos los vectores se trazan según su representación numérica. Tenga en cuenta que las incrustaciones (vectores) que tienen un significado similar se trazarán cerca unas de otras, formando así un clúster.

Representación gráfica de vectores

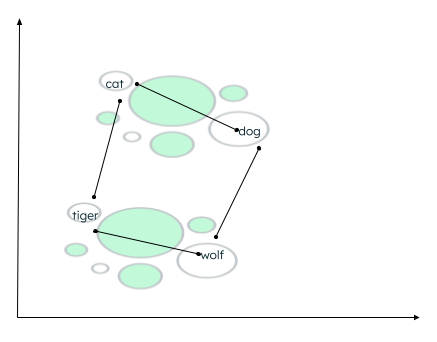
Puede haber muchos contextos en los que se pueden agrupar los datos. La relación depende de cómo el codificador incrusta los datos de origen y de cómo se calcula la distancia entre los vectores. En el siguiente ejemplo, se pueden establecer dos tipos de relaciones:

  • Tanto el gato como el perro son animales domésticos, mientras que el tigre y el lobo son animales salvajes.
  • Gato y tigre pertenecen a la misma familia, mientras que perro y lobo pertenecen a la misma familia de animales.

Cálculo de la distancia de palabras similares

Una función de similitud determina qué palabras están más cerca y etiqueta las palabras colocadas cerca como vecinas. Esta agrupación/clúster se realiza utilizando el algoritmo de k-vecino más cercano, donde el valor de k representa el número de vecinos que se identificarán. Para encontrar la similitud, la búsqueda vectorial admite muchos métodos, como encontrar lo siguiente:

  • Distancia euclidiana entre los extremos de los dos vectores.
  • Coseno (ángulo) entre los dos vectores.
  • Punto (escalar) producto de los vectores.

MongoDB Atlas proporciona las funciones de búsqueda vectorial dentro de la propia plataforma Atlas, a través de marcos de IA, y admite todas las funciones de similitud anteriores.

MongoDB siempre ha admitido la búsqueda vectorial en dos dimensiones. Sin embargo, la nueva búsqueda vectorial permite capacidades poderosas debido a la incrustación y permite dimensiones más altas.

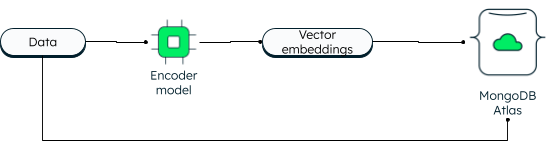
Las aplicaciones pueden escribir los datos, así como las incrustaciones vectoriales en la base de datos. Los vectores de datos se generan utilizando un modelo de codificador. La búsqueda en Atlas utiliza el algoritmo de vecino más cercano aproximado (ANN) a través del gráfico de Pequeño mundo navegable jerárquico (HNSW). ANN es una variación del vecino más cercano de k, pero con una mayor velocidad de recuperación.

Cómo se almacenan los vectores en MongoDB Atlas

Durante la lectura, la query se codifica y se envía en la etapa de agregación $search junto con el vector de destino. Si desea aprender los pasos, siga el tutorial sobre la creación de aplicaciones de IA generativa con MongoDB.

La ventaja de tener vectores junto a los datos operativos es que puede acceder a toda la información dentro de una única plataforma, incluso a sus datos privados, a los que no se podría acceder de otra manera.

La búsqueda vectorial de Atlas simplifica la arquitectura de su aplicación. Como Atlas está totalmente gestionado, la plataforma MongoDB Atlas se encarga de todo, desde la sincronización de datos hasta la seguridad y la privacidad. Los desarrolladores pueden trabajar con la base de datos y la búsqueda vectorial utilizando la MongoDB Query API unificada. Puede implementar Atlas en más de 125 regiones en los tres principales proveedores de nube. Atlas le proporciona un tiempo de actividad continuo con una automatización avanzada que garantiza un alto rendimiento independientemente de la escala de la aplicación.

Algunos casos de uso destacados de la búsqueda vectorial en Atlas son:

  • Búsqueda semántica.
  • Sistemas de preguntas y respuestas.
  • Extracción de funcionalidades.
  • Recomendación y puntuación de relevancia.
  • Generación de sinónimos.
  • Búsqueda de imágenes.

¿Cómo funciona la búsqueda vectorial de Atlas?

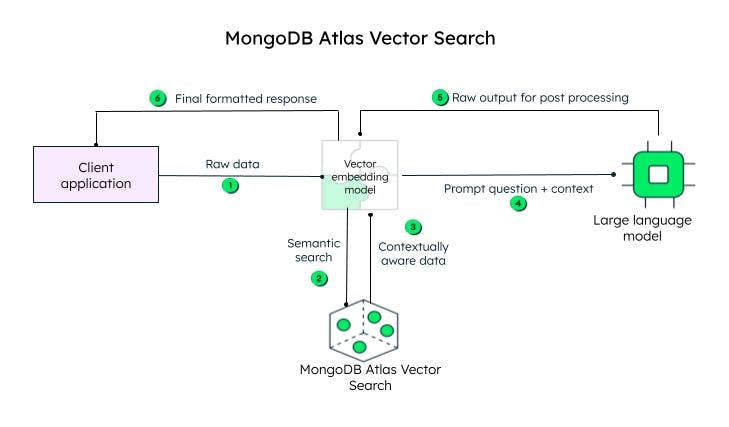
La aplicación del cliente envía los datos sin procesar. El modelo de incrustación vectorial crea vectores para cada texto de la query inicial (datos sin procesar). Marcos como Llamaindex y LangChain se integran bien con MongoDB Atlas para crear incrustaciones y enviar datos a MongoDB para agregar conciencia contextual. La query consciente del contexto, conocida como mensaje, se envía entonces a un LLM, que genera una respuesta codificada, para ser procesada por el modelo de incrustación vectorial (decodificador) y enviada al cliente tras la decodificación.

Pasos para lograr la búsqueda vectorial en MongoDB Atlas

Las incrustaciones vectoriales pueden almacenarse en el documento de la base de datos de MongoDB como un arreglo de números de punto flotante, junto con el contenido, en el campo content_embeddings.


Si el número de dimensiones en los datos de entrada es mayor, el número de puntos flotantes será mayor.

A continuación, establezca la definición de índice agregándola al generador de definiciones:


La definición del índice incluye el modelo que encontraría los clústeres de similitud, las dimensiones y la función de similitud (de los tres métodos admitidos por MongoDB) que utilizaría el modelo.

¡Eso es todo! Solo dos pasos y listo.

Para poder buscar, puede utilizar el operador de agregación $search especificando el operador knnBeta y dando las incrustaciones vectoriales del query en el campo vectorial. También debe especificar la ruta de las incrustaciones de contenido que deben consultarse para la búsqueda vectorial. MongoDB también proporciona filtros adicionales para reducir la búsqueda y la cantidad de vecinos más cercanos que debería devolver el algoritmo de k-vecino más cercano.


Como tanto las incrustaciones vectoriales como los datos residen en la misma plataforma, puede acceder a su carga de trabajo operativa y a sus vectores mediante una sola MongoDB Query API unificada. Para aprender a utilizar la funcionalidad paso a paso, consulte nuestro tutorial sobre la creación de aplicaciones de IA generativa mediante búsqueda vectorial.

Casos de uso de IA importantes

La IA se está aplicando con éxito en diversos ámbitos, como la venta minorista, la salud y la fabricación. Algunos casos de uso populares de la IA son:

  • Procesamiento del lenguaje natural (PLN): la IA se utiliza activamente en el análisis de sentimientos, los asistentes virtuales, los chatbots, el reconocimiento de voz y la traducción de textos. Como hemos visto anteriormente, utilizando el poder de LLM y la búsqueda vectorial, los sistemas de IA pueden producir resultados en lenguaje humano.

  • Visión artificial: con las redes neuronales modernas, los sistemas de IA son capaces de realizar con precisión la clasificación de imágenes, el reconocimiento de rostros y objetos, y la generación de imágenes.

  • Sistemas de recomendación y filtrado de contenidos: los sistemas de IA son capaces de recomendar contenidos a los usuarios utilizando modelos de aprendizaje profundo y aprendizaje automático sin ninguna intervención humana.

  • Atención médica: la tecnología de inteligencia artificial ha llevado la atención médica a un nuevo nivel al ayudar a los médicos en el diagnóstico temprano de enfermedades, la investigación médica y el descubrimiento de fármacos, y al almacenamiento seguro de los registros médicos electrónicos de los pacientes.

  • Autos autónomos: los autos autónomos funcionan con algoritmos de IA, datos de sensores y visión artificial.

  • - Robótica: los robots industriales aumentan la productividad y realizan tareas complejas con precisión. De manera similar, los robots de servicio pueden realizar sus tareas de manera eficiente en los sectores sanitario y hotelero.

Uso ético de la IA, gobernanza de la IA y regulaciones

Con los rápidos desarrollos que se están produciendo en el campo de la IA, es importante establecer normas y reglamentos y abordar las consideraciones éticas para que los sistemas de IA se utilicen de forma justa, transparente y para el fin adecuado.

La ética de la IA se centra en las implicaciones morales y éticas de las herramientas y tecnologías de IA, es decir, la equidad, la privacidad, la transparencia y la rendición de cuentas.

El gobierno establece los marcos, la estructura y las reglas de cumplimiento para regular la IA y garantizar el uso responsable de la IA.

El gobierno también crea regulaciones de IA (es decir, marcos legales) para garantizar la seguridad de los datos, la protección del consumidor y el cumplimiento de los estándares de seguridad.

Herramientas y servicios de IA

Los datos son el núcleo de todas las operaciones de IA, y MongoDB es una plataforma en la que puede confiar para crear sólidas aplicaciones de IA. Como base de datos con un esquema flexible, MongoDB proporciona una solución de almacenamiento centralizada, con capacidades de administración de datos integradas, procesamiento de datos avanzado, análisis en tiempo real, escalabilidad y mucho más. Algunas otras herramientas y servicios populares son:

  • ChatGPT: ChatGPT casi se ha convertido en parte de la vida cotidiana, desde hacer preguntas sencillas hasta planificar vacaciones, programar, escribir poesía y resumir textos.

  • Dall-E 2: Dall-E 2 es un proyecto de OpenAI, al igual que ChatGPT, y genera gráficos por computadora como imágenes, pinturas y dibujos a partir de indicaciones de texto.

  • - Stable Diffusion 2: se trata de una herramienta de IA de texto a imagen para aplicaciones de IA generativa. A diferencia de las herramientas de OpenAI, a las que se accede a través de portales de navegadores, Stable Diffusion 2 está disponible para su descarga e instalación, y los usuarios pueden acceder al código fuente y a los algoritmos públicamente.

Visite nuestro centro de aprendizaje de IA para obtener más información sobre las soluciones de IA de MongoDB.

Preguntas frecuentes

Comience a usar Atlas hoy mismo

Comience en cuestión de segundos. Nuestros clústeres gratuitos vienen con 512 MB de almacenamiento para que pueda jugar con datos de muestra y orientarse con nuestra plataforma.
Probar gratisContactar a ventas
PRIMEROS PASOS CON:
  • Más de 125 regiones en todo el mundo
  • Conjuntos de datos de muestra
  • Autenticación siempre activa
  • Cifrado de extremo a extremo
  • Herramientas de línea de comandos