Descubre cómo combinar MongoDB Atlas búsqueda vectorial y grandes modelos de lenguaje (LLM) para agilizar el proceso de ajuste de reclamaciones.
caso de uso: Gen AI, Gestión de Contenidos
Industrias: Seguro, Finanzas, Fabricación y movilidad, Venta minorista
Productos: MongoDB Atlas, Búsquedavectorial de MongoDB Atlas
emparejar: LangChain
Descripción general de la solución
Uno de los mayores desafíos para los peritos de siniestros es la agregación de información proveniente de diversos sistemas y formatos de datos. A lo largo de los años, las compañías de seguros han acumulado terabytes de datos no estructurados en sus bases de datos, los cuales pueden ayudar a descubrir información valiosa para el negocio, brindar mejores experiencias al cliente y optimizar las operaciones. Sin embargo, muchas empresas no aprovechan este potencial.
Para ayudar a su organización a superar estos desafíos, puede crear una solución de gestión de reclamaciones con MongoDB que combine Atlas Vector Search y LLM en un sistema de recuperación aumentada (RAG). Este marco permite a las organizaciones ir más allá de las limitaciones de los modelos básicos y utilizar sus datos propios para crear modelos que tengan en cuenta el contexto, optimizando las operaciones con todo el potencial de la IA.
Arquitectura de referencia
MongoDB ofrece una experiencia de desarrollo unificada al almacenar documentos junto a sus embeddings vectoriales y metadatos asociados, eliminando la necesidad de recuperar datos de otros lugares. Esto permite a los usuarios centrarse en desarrollar su aplicación en vez de mantener una tecnología por separado. En última instancia, los datos obtenidos de MongoDB búsqueda vectorial se envían al LLM como contexto.
El proceso de flujo de consultas RAG es el siguiente:
El usuario escribe un comando en lenguaje natural.
El modelo de embedding de Voyage IA vectoriza el prompt.
Atlas búsqueda vectorial utiliza el prompt vectorizado para recuperar documentos relevantes.
El LLM utiliza tanto el contexto como la pregunta original para generar una respuesta.
El usuario recibe una respuesta.
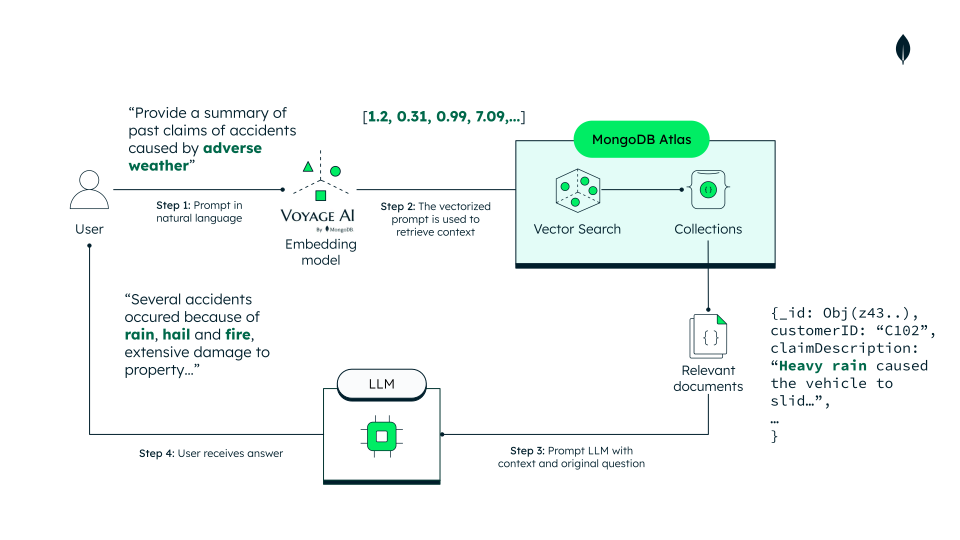
Figura 1. Flujo de consulta de RAG
Enfoque de modelo de datos
En la solución demo, el modelo de datos es un diseño simplificado que emula datos reales de reclamaciones de seguros. El enfoque aprovecha el modelo orientado a documentos de MongoDB para gestionar la estructura de datos diversa que almacena incrustaciones junto con su documento relacionado.
La colección claims_final almacena información de reclamaciones. Los campos correspondientes son el campo claimDescription y su embedding correspondiente claimDescriptionEmbedding. Esta incrustación está indexada y se utiliza para recuperar documentos asociados con el mensaje del usuario. Los documentos en esta colección son los siguientes:
{ "_id": { "$oid": "65cc809c76da22d0089dfb2e" }, "customerID": "c105", "policyNumber": "p105", "claimID": "cl105", "claimStatusCode": "Subrogation", "claimDescription": "High winds caused ...", "totalLossAmount": 4200, "claimFNOLDate": "2023-10-27", "claimClosedDate": "2024-09-01", "claimLineCode": "Auto", "damageDescription": "Roof caved in ...", "insurableObject": { "insurableObjectId": "abc105", "vehicleMake": "Make105", "vehicleModel": "Model105" }, "coverages": [ { "coverageCode": "888", "description": "3rd party responsible" }, { "coverageCode": "777", "description": "Vehicle rental/loaner service for customer" } ], "claimDescriptionEmbedding": [-0.017, ..., 0.011], "damageDescriptionEmbedding": [-0.047, ..., -0.043], "photo": "105.jpg", "photoEmbedding": [9.629, ..., 14.075] }
Compilar la solución
Para obtener instrucciones de configuración detalladas, segur las instrucciones README de este repositorio de GitHub.. Las instrucciones guían a través de los siguientes pasos:
Crear un índice de búsqueda vectorial
Cree y configure un índice de búsqueda de Atlas Vector Search para claimDescriptionEmbeddingCohere llamado vector_index_claim_description_cohere. Debe estructurar el índice de búsqueda de la siguiente manera:
{ "fields": [ { "type": "vector", "path": "claimDescriptionEmbeddingCohere", "numDimensions": 350, "similarity": "cosine" } ] }
Debes ejecutar tanto el frontend como el backend. Tendrás acceso a una Interfaz de Usuario web que te permitirá hacer preguntas al LLM, obtener una respuesta, y ver los documentos de referencia utilizados como contexto.
Para probar la herramienta de búsqueda semántica de MongoDB ahora mismo, visite la guía de inicio rápido de Atlas Vector Search.
Lecciones clave
Generación de incrustaciones de texto: Puede crear incrustaciones utilizando diferentes modelos y opciones de implementación. Es importante tener en cuenta los requisitos de privacidad y protección de datos. Puede implementar un modelo localmente si sus datos deben permanecer en los servidores. De lo contrario, puede llamar a una API y obtener sus incrustaciones vectoriales, como se explica en este tutorial. Puede utilizar Voyage AI o modelos de código abierto.
Creación de índices de búsqueda vectorial: Puede crear índices de búsqueda vectorial en MongoDB Atlas. Como alternativa, también puede crear índices para implementaciones locales.
Realice una consulta de búsqueda vectorial: Puede ejecutar consultas de búsqueda vectorial con la canalización de agregación de MongoDB, lo que le permite concatenar varias operaciones en su flujo de trabajo. Este enfoque elimina la necesidad de aprender otro lenguaje de programación o cambiar de contexto.
Desarrolle una implementación rápida de RAG: Puede desarrollar una implementación rápida de RAG con un marco de trabajo LangChain que combine MongoDB Atlas Vector Search y LLM.
Autores
Luca Napoli, soluciones empresariales, MongoDB
Jeff Needham, Soluciones sectoriales, MongoDB