对于任何给定的查询,在给定可用索引的情况下,MongoDB 查询规划器会选择并缓存最高效的查询计划。为了评估查询计划的效率,查询规划器会在试用期内运行所有候选计划。一般情况下,获胜计划是在试用期间产生最多结果同时执行最少工作量的查询计划。
关联的计划缓存条目用于具有相同查询形状的后续查询。
下图演示了查询规划器逻辑:
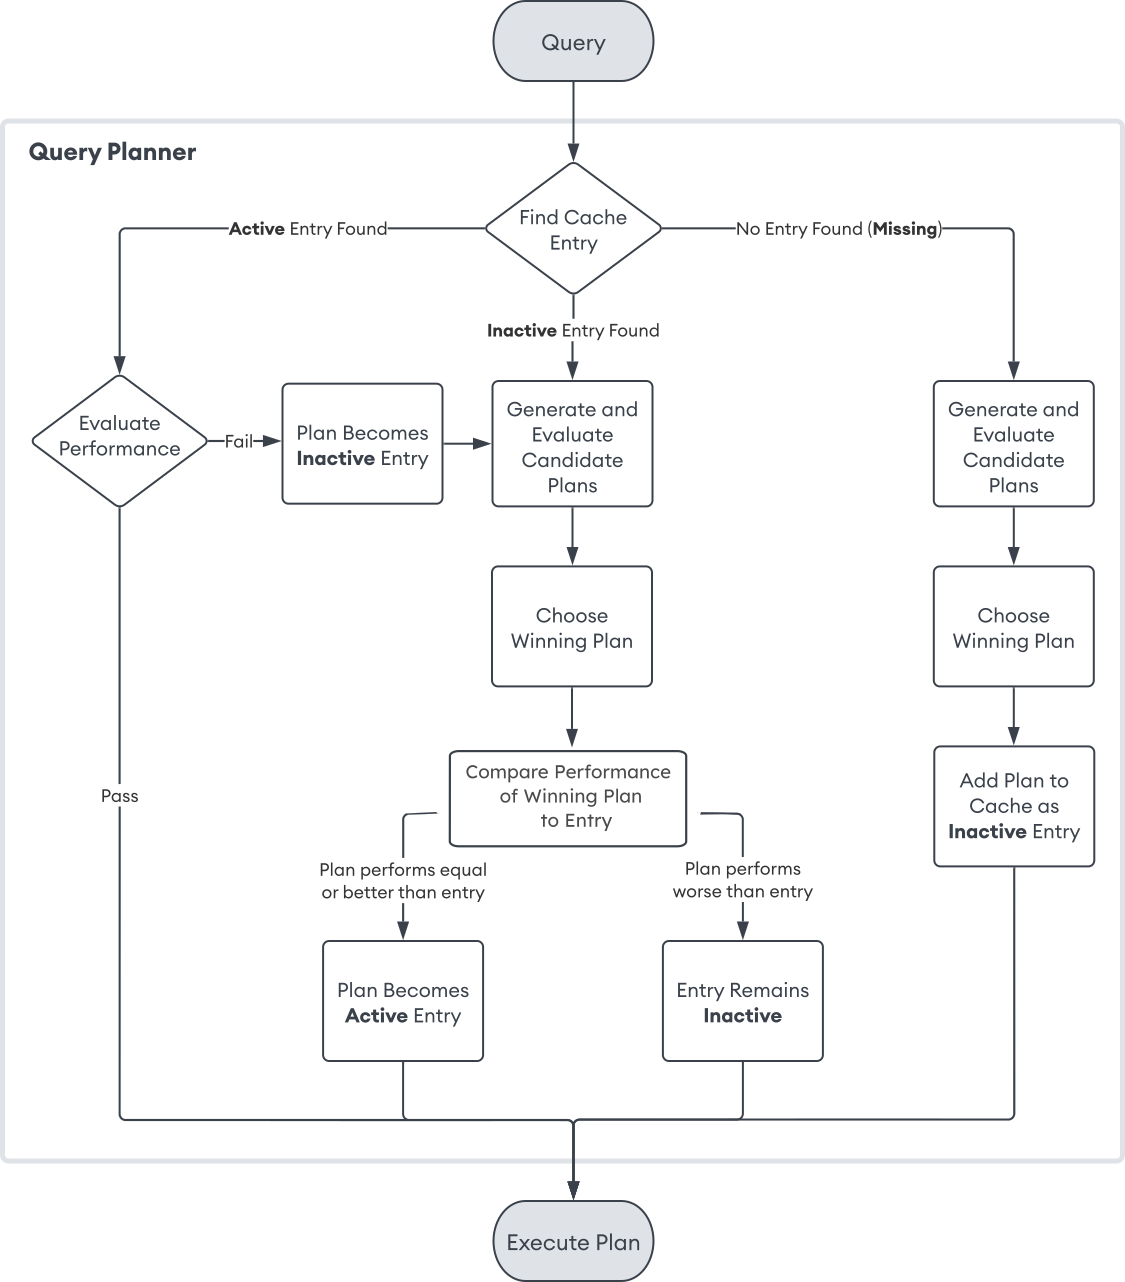
注意
使用 explain 会忽略所有现有的计划缓存条目,并防止 MongoDB 查询计划器创建新的计划缓存条目。
规划缓存条目状态
每个计划缓存查询结构都与缓存中的三种状态之一相关联:
州 | 说明 |
|---|---|
缓存中不存在此形状的条目。 对于查询,如果查询结构的缓存条目状态为 Missing(缺失):
| |
缓存中的条目是此形状的占位符条目。也就是说,规划器已查看形状,计算了一个值来量化计划所需的工作量,并存储了形状占位符条目,但查询结构不用于生成查询计划。 对于查询,如果形状的缓存条目状态为 Active(非活动):
| |
See Plan Cache Flushes for additional scenarios that trigger changes to the plan cache.
查询计划和缓存信息
要查看给定查询的查询计划信息,可以使用 db.collection.explain() 或 cursor.explain()。
要查看集合的计划缓存信息,可以使用 $planCacheStats 聚合阶段。
计划缓存刷新
如果 mongod 重新启动或关闭,查询计划缓存将不复存在。此外:
任何 DDL事件都会清除相关集合的计划缓存。DDL 事件示例包括删除集合以及创建、删除或隐藏索引。
最近最少使用 (LRU) 缓存替换机制会清除最近最少访问的缓存条目,而无论条目处于何种状态。
此外,用户还可:
使用
PlanCache.clear()方法手动清除整个计划缓存。使用
PlanCache.clearPlansByQuery()方法手动清除特定计划缓存条目。
计划缓存调试信息大小限制
从 MongoDB 5.0开始,仅当所有集合的plan caches累积大小低于0.5时,计划缓存才会保存完整的plan cache条目 GB。 当所有集合的plan caches累积大小超过此阈值时,将存储额外的plan cache条目,但不会包含以下调试信息:
plan cache 条目的估计大小(以字节为单位)可在 $planCacheStats 的输出中找到。
queryHash 和 planCacheKey
queryHash
为了帮助识别具有相同查询结构的慢速查询,每个查询结构都与一个 queryHash 相关联。queryHash 是一个十六进制字符串,表示查询结构的哈希值,并且仅依赖于查询结构。
注意
与任何哈希函数一样,两个不同的查询结构可能会产生相同的哈希值。但是,不同查询结构之间不太可能发生哈希冲突。
planCacheKey
为了获得对查询计划缓存的更多见解,MongoDB 提供了 planCacheKey。
planCacheKey 是计划缓存查询结构的哈希值,通过形状的任何可用索引进一步区分。
注意
与 queryHash 不同,planCacheKey 是查询结构和该结构当前可用索引的函数。换言之,如果添加/删除可以支持该查询结构的索引,则 planCacheKey 值可能会更改,而 queryHash 值不会更改。
例如,考虑一个具有以下索引的集合 foo:
db.foo.createIndex( { x: 1 } ) db.foo.createIndex( { x: 1, y: 1 } ) db.foo.createIndex( { x: 1, z: 1 }, { partialFilterExpression: { x: { $gt: 10 } } } )
对集合的以下查询具有相同的结构:
db.foo.explain().find( { x: { $gt: 5 } } ) // Query Operation 1 db.foo.explain().find( { x: { $gt: 20 } } ) // Query Operation 2
给定这些查询,带有部分筛选器表达式的索引可以支持查询操作 2,但不支持查询操作 1。由于可用于支持查询操作 1 的索引与查询操作 2 的索引不同,因此,这两个查询具有不同的 planCacheKey。
如果删除其中一个索引,或者,添加了新索引 { x: 1, a: 1 },则两个查询操作的 planCacheKey 将发生变化。
可用性
queryHash 和 planCacheKey 可用于:
记录慢速查询时的日志消息,包括分析器日志消息和诊断日志消息(即 mongod/mongos 日志消息)。
$planCacheStats聚合阶段PlanCache.listQueryShapes()方法/planCacheListQueryShapes命令PlanCache.getPlansByQuery()方法/planCacheListPlans命令
索引筛选器
索引筛选器由 planCacheSetFilter 命令,并确定计划器针对查询结构评估哪些索引。查询结构由查询、排序和投影规范的组合构成。如果给定查询结构存在索引筛选器,则计划器仅考虑筛选器中指定的索引。
当查询结构存在索引筛选器时,MongoDB 会忽略 hint()。要查看 MongoDB 是否为查询结构应用了索引筛选器,请检查 db.collection.explain() 或 cursor.explain() 方法的 indexFilterSet 字段。
索引过滤器仅影响规划师评估哪些索引;规划师仍可选择集合扫描作为给定查询结构的获胜计划。
索引筛选器在服务器进程期间存在,而在关闭后会消失。MongoDB 还提供用于手动删除筛选器的命令。
由于索引筛选器会覆盖计划程序的预期行为以及 hint() 方法,因此请谨慎使用索引筛选器。
从 MongoDB 6.0 开始,索引筛选器会使用之前使用 planCacheSetFilter 命令设置的排序规则。