A MongoDB Vector Search query takes the form of an aggregation pipeline that uses $vectorSearch as the first stage. This page explains the syntax, options, and behavior of the $vectorSearch stage.
Clientes aceitos
Sintaxe
Campos
O estágio $vectorSearch recebe um documento com os seguintes campos:
Tipos de pesquisas vetoriais
When you define a $vectorSearch stage, you can use the exact field to specify whether to run an ANN or ENN search.
Para a pesquisa ANN, o MongoDB pesquisa vetorial encontra incorporações vetoriais em seus dados que estão mais próximas da incorporação vetorial em sua query com base em sua proximidade no espaço multidimensional e com base no número de vizinhos que considera. Ele usa o algoritmo Hierarchical Navigable Small Worlds e encontra as incorporações vetoriais mais semelhantes à incorporação vetorial em sua query sem digitalizar todos os vetores. Portanto, a pesquisa ANN é ideal para consultar grandes conjuntos de dados sem filtro significativo.
Observação
Normalmente, considera-se que a recuperação ideal para a pesquisa ANN seja em torno de 90-95% de sobreposição nos resultados com a pesquisa ENN, mas com latência significativamente menor. Isso fornece um bom equilíbrio entre precisão e desempenho. Para conseguir isso com a Vector Search do MongoDB , ajuste o parâmetro numCandidates no momento da query.
numCandidates Seleção
Você deve especificar o campo numCandidates para executar a pesquisa ANN. Este campo determina quantos vizinhos mais próximos a pesquisa vetorial MongoDB considera durante a pesquisa.
When you perform a vector search using the Hierarchical Navigable Small Worlds index structure, MongoDB Vector Search accumulates results by populating a priority queue. The numCandidates parameter controls the size of this queue, which determines how long to search before returning the top limit results. A larger queue (higher numCandidates) allows the search to explore more of the Hierarchical Navigable Small Worlds graph, potentially finding better matches at the cost of increased query latency.
Recomendamos que você especifique um número numCandidates pelo menos 20 vezes maior que o número de documentos a serem devolvidos (limit) para aumentar a precisão e reduzir discrepâncias entre os resultados da consulta ENN e ANN. Por exemplo, se você definir limit para retornar 5 resultados, considere definir numCandidates para 100 como um ponto de partida. Para saber mais, consulte Como medir a precisão dos resultados da sua query.
This overrequest pattern is the recommended way to trade off latency and recall in your ANN searches. However, we recommend tuning the numCandidates parameter based on your specific dataset size and query requirements. To ensure that you get accurate results, consider the following variables:
Para uma pesquisa ENN (ENN), a pesquisa vetorial do MongoDB pesquisa exaustivamente todas as incorporações de vetor indexadas calculando a distância entre todas as incorporações e encontra o vizinho mais próximo exato para a incorporação do vetor em sua query. Isso é computacionalmente intensivo e pode impacto negativamente a latência da query. Portanto, recomendamos pesquisas ENN para os seguintes casos de uso:
Considerações
$vectorSearch deve ser o primeiro estágio de qualquer pipeline onde
aparece.
Limitações
$vectorSearch can't be used in view definition and the following pipeline stages:
$facetestágio do pipeline
| [1] | You can pass the results of $vectorSearch to this stage. |
Indexação de pesquisa vetorial do MongoDB
Para saber mais sobre esses tipos de campo do MongoDB Vector Search, consulte Como indexar campos para o Vector Search.
Pontuação da pesquisa vetorial do MongoDB
O MongoDB Vector Search atribui uma pontuação, em um intervalo fixo de 0 a 1 (onde 0 indica baixa similaridade e 1 indica alta similaridade), a cada documento retornado.
Observação
Pre-filtering your data doesn't affect the score that MongoDB Vector Search returns using vectorSearchScore for $vectorSearch queries.
Filtro de pesquisa vetorial MongoDB
MongoDB pesquisa vetorial suporta filtro de dados. Você pode:
Pre-filter your data by using the
filteroption in your MongoDB Vector Search query.post-filter the results of your MongoDB Vector Search query by using
$matchand other supported aggregation pipeline stages.
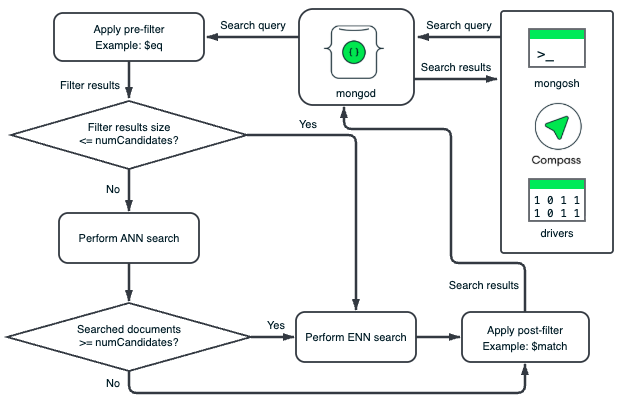
A pesquisa vetorial do MongoDB executa operações de pré-filtro e publicação-filtro independentemente em segmentos de dados. O grafo HNSW para cada segmento é baseado apenas nos vetores nesse segmento. A pesquisa vetorial do MongoDB aplica os filtros aos documentos de cada segmento para eliminar documentos que não atendem aos critérios de filtro. A pré-filtragem garante que os documentos sejam eliminados antes que a pesquisa vetorial do MongoDB percorra o grafo HNSW e a filtragem após a publicação garante que documentos ou campos irrelevantes nos documentos sejam eliminados dos resultados da pesquisa vetorial.
Dados de pesquisa de pré-filtro
Você pode pré-filtrar seus dados para restringir o escopo da sua pesquisa semântica e garantir que apenas vetores relevantes sejam considerados para comparação. Quando você pré-filtra seus dados usando a opção filter, a pesquisa vetorial do MongoDB executa a pesquisa semântica em apenas um subconjunto de seus dados, o que aumenta a precisão dos resultados da pesquisa.
A pré-filtragem pode ser muito restritiva, pois o pré-filtro pode excluir dados que não correspondem exatamente ao pré-filtro, mas são semanticamente semelhantes à query que você deseja considerar durante a pesquisa vetorial. Para atenuar isso, recomendamos definir um critério de filtro amplo para garantir que sua query faça o seguinte:
Inclui o máximo de resultados relevantes possível.
Exclui dados irrelevantes dos resultados.
Retorna o número solicitado de documentos nos resultados.
Importante
As queries filtradas são normalmente mais lentas do que uma query não filtrada equivalente.
Resultados da pesquisa de publicação-filtro
If your index size isn't optimal for pre-filtering or if you set broad pre-filtering criteria, you can post-filter your vector search results to return only relevant data. To filter the results of your vector search, you can use any supported aggregation pipeline stage, such as the $match stage, after the $vectorSearch stage. To learn more, see Additional Performance Recommendations.
To select the fields to return in the results, use the $project stage unless you need all the fields in the results. We recommend excluding the vector field in the $project stage to improve query performance.
For example, you can use the $project stage to include the vectorSearchScore and then use the $match stage to return only documents above a certain score threshold.
Considerações de filtro
MongoDB Vector Search supports the short form of
$eq. In the short form, you don't need to specify$eqin the query.Por exemplo, considere o seguinte filtro com
$eq:"filter": { "_id": { "$eq": ObjectId("5a9427648b0beebeb69537a5") } Isso equivale ao seguinte filtro, que usa a forma abreviada de
$eq:"filter": { "_id": ObjectId("5a9427648b0beebeb69537a5") } You can use the
$andMQL operator to specify an array of filters in a single query.Por exemplo, considere o seguinte pré-filtro para documentos com um campo
genresigual aActione um campoyearcom o valor1999,2000ou2001:"filter": { "$and": [ { "genres": "Action" }, { "year": { "$in": [ 1999, 2000, 2001 ] } } ] } For advanced filtering capabilities such as fuzzy search, phrase matching, location filtering, and other analyzed text, use the vectorSearch operator in a
$searchstage.
Exemplos
Pré-requisitos
Antes de executar estes exemplos, realize as seguintes ações:
Add the sample dataset used in the query to your cluster.
Crie índices de pesquisa vetorial do MongoDB para a coleção. Para obter instruções, consulte o procedimento Criar um índice de pesquisa vetorial do MongoDB e configure o índice para as query de amostra na linguagem desejada.
Consultas
Saiba mais
Os tutoriais a seguir demonstram casos de uso adicionais para o estágio $vectorSearch.