MongoDB의 인과적으로 일관된 클라이언트 세션을 사용하면 읽기 및 쓰기 문제의 다양한 조합을 통해 서로 다른 인과적 일관성을 보장할 수 있습니다.
다음 표에는 다양한 조합이 제공하는 구체적인 보장이 나열되어 있습니다.
readConcern | 쓰기 고려 | 쓰기 읽기 | 단조적 읽기 | 단조로운 쓰기 | 읽기 후 쓰기 |
|---|---|---|---|---|---|
✅ | ✅ | ✅ | ✅ | ||
✅ | ✅ | ||||
✅ |
데이터 내구성과 인과적 일관성을 원하는 경우, 표에서 볼 수 있듯이 "majority" 읽기 고려가 있는 읽기 작업과 "majority" 쓰기 고려가 있는 쓰기 작업만 네 가지 인과적 일관성을 모두 보장할 수 있습니다. 즉, 인과적으로 일관된 클라이언트 세션은 다음에 대해서만 인과적 일관성을 보장할 수 있습니다.
"majority"읽기 고려가 있는 읽기 작업, 즉, 대부분의 복제본 세트 멤버가 승인하고 지속적으로 데이터를 반환하는 읽기 작업입니다."majority"쓰기 고려가 있는 쓰기 작업, 다시 말해, 복제본 세트의 투표 노드 과반수에게 작업이 적용되었다는 승인을 요청하는 쓰기 작업입니다.
데이터 내구성이 없는(즉, 쓰기가 롤백될 수 있음) 인과적 일관성을 원하는 경우 { w: 1 } 쓰기 고려가 있는 쓰기 연산도 인과적 일관성을 제공할 수 있습니다.
참고
읽기 및 쓰기 고려의 다른 조합도 일부 상황에서는 네 가지 인과적 일관성 보장을 모두 충족할 수 있지만 모든 상황에서 반드시 그런 것은 아닙니다.
읽기 고려 "majority" 및 쓰기 고려 "majority"는 네트워크 파티션과 같이 복제본 세트의 두 노드가 일시적으로 자신이 프라이머리라고 믿는 상황에서도 네 가지 인과적 일관성이 보장되도록 합니다. 그리고 두 프라이머리 모두 { w: 1 } 쓰기 고려로 쓰기를 완료할 수 있지만, 하나의 프라이머리만 "majority" 쓰기 고려로 쓰기를 완료할 수 있습니다.
예를 들어 네트워크 파티션이 5명의 복제본 세트 멤버를 분할하는 상황을 생각해 보세요:
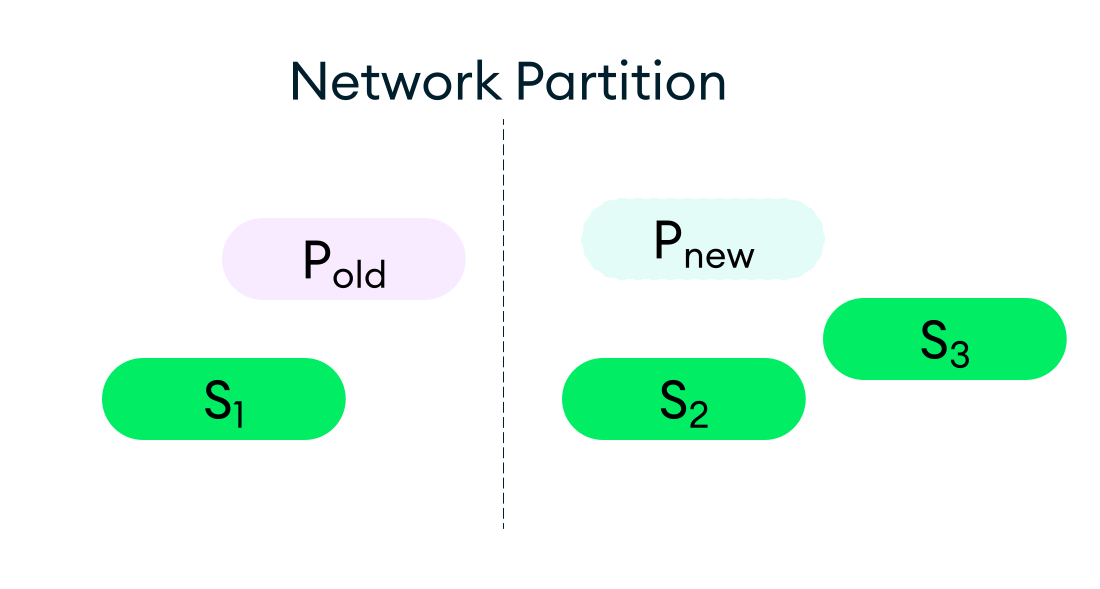
예시
위의 파티션으로
"majority"쓰기 고려로 쓸 경우P새로운 항목에서 완료할 수 있지만P오래된 항목에서는 완료할 수 없습니다.{ w: 1 }쓰기 고려를 가진 쓰기는P이전 또는P신규 항목에서 완료할 수 있습니다. 그러나P이전에 대한 쓰기(S1에 복제된 쓰기 포함)는 이러한 멤버가 나머지 복제본 세트와 다시 통신하면 롤백됩니다.P새로운"majority"쓰기 고려가 있는 성공적인 쓰기 후"majority"읽기 고려가 있는 일관된 읽기는P새로운 항목,S2 및S3에 대한 쓰기를 관찰할 수 있습니다. 또한 읽기는 복제본 세트의 나머지 부분과 통신하고 복제본 세트의 다른 멤버와 동기화할 수 있게 되면P오래된 항목 및S1에 대한 쓰기를 관찰할 수 있습니다. 이전에P오래된 항목에 쓰거나 파티션 처리 동안S1에 복제된 모든 쓰기는 롤백됩니다.
Scenarios
읽기 고려 및 쓰기 고려 관련 요구 사항을 설명하기 위해 다음 시나리오에서는 클라이언트가 읽기 및 쓰기 고려가 다양하게 조합된 일련의 작업을 복제본 세트에 실행하도록 합니다.
읽기 고려 "majority" 및 쓰기 고려 "majority"
인과적으로 일관된 세션에서 읽기 고려 "majority"와 쓰기 고려 "majority"을 사용하면 다음과 같은 인과적 일관성이 보장됩니다.
자체 쓰기 읽기 ✅ 단조적 읽기 ✅ 단조적 쓰기 ✅ 읽기 후 쓰기
참고
시나리오 1(읽기 고려 '대다수' 및 쓰기 고려 '대다수')
프라이머리가 두 개인 이 일시적인 기간 동안에는 P 새로운 항목만이 { w: "majority" } 쓰기 고려를 통해 쓰기를 수행할 수 있으므로 클라이언트 세션에서 다음 작업 순서를 성공적으로 실행할 수 있습니다.
시퀀스 | 예시 |
|---|---|
1. 1을 쓰기 고려 (write concern) | 항목 |
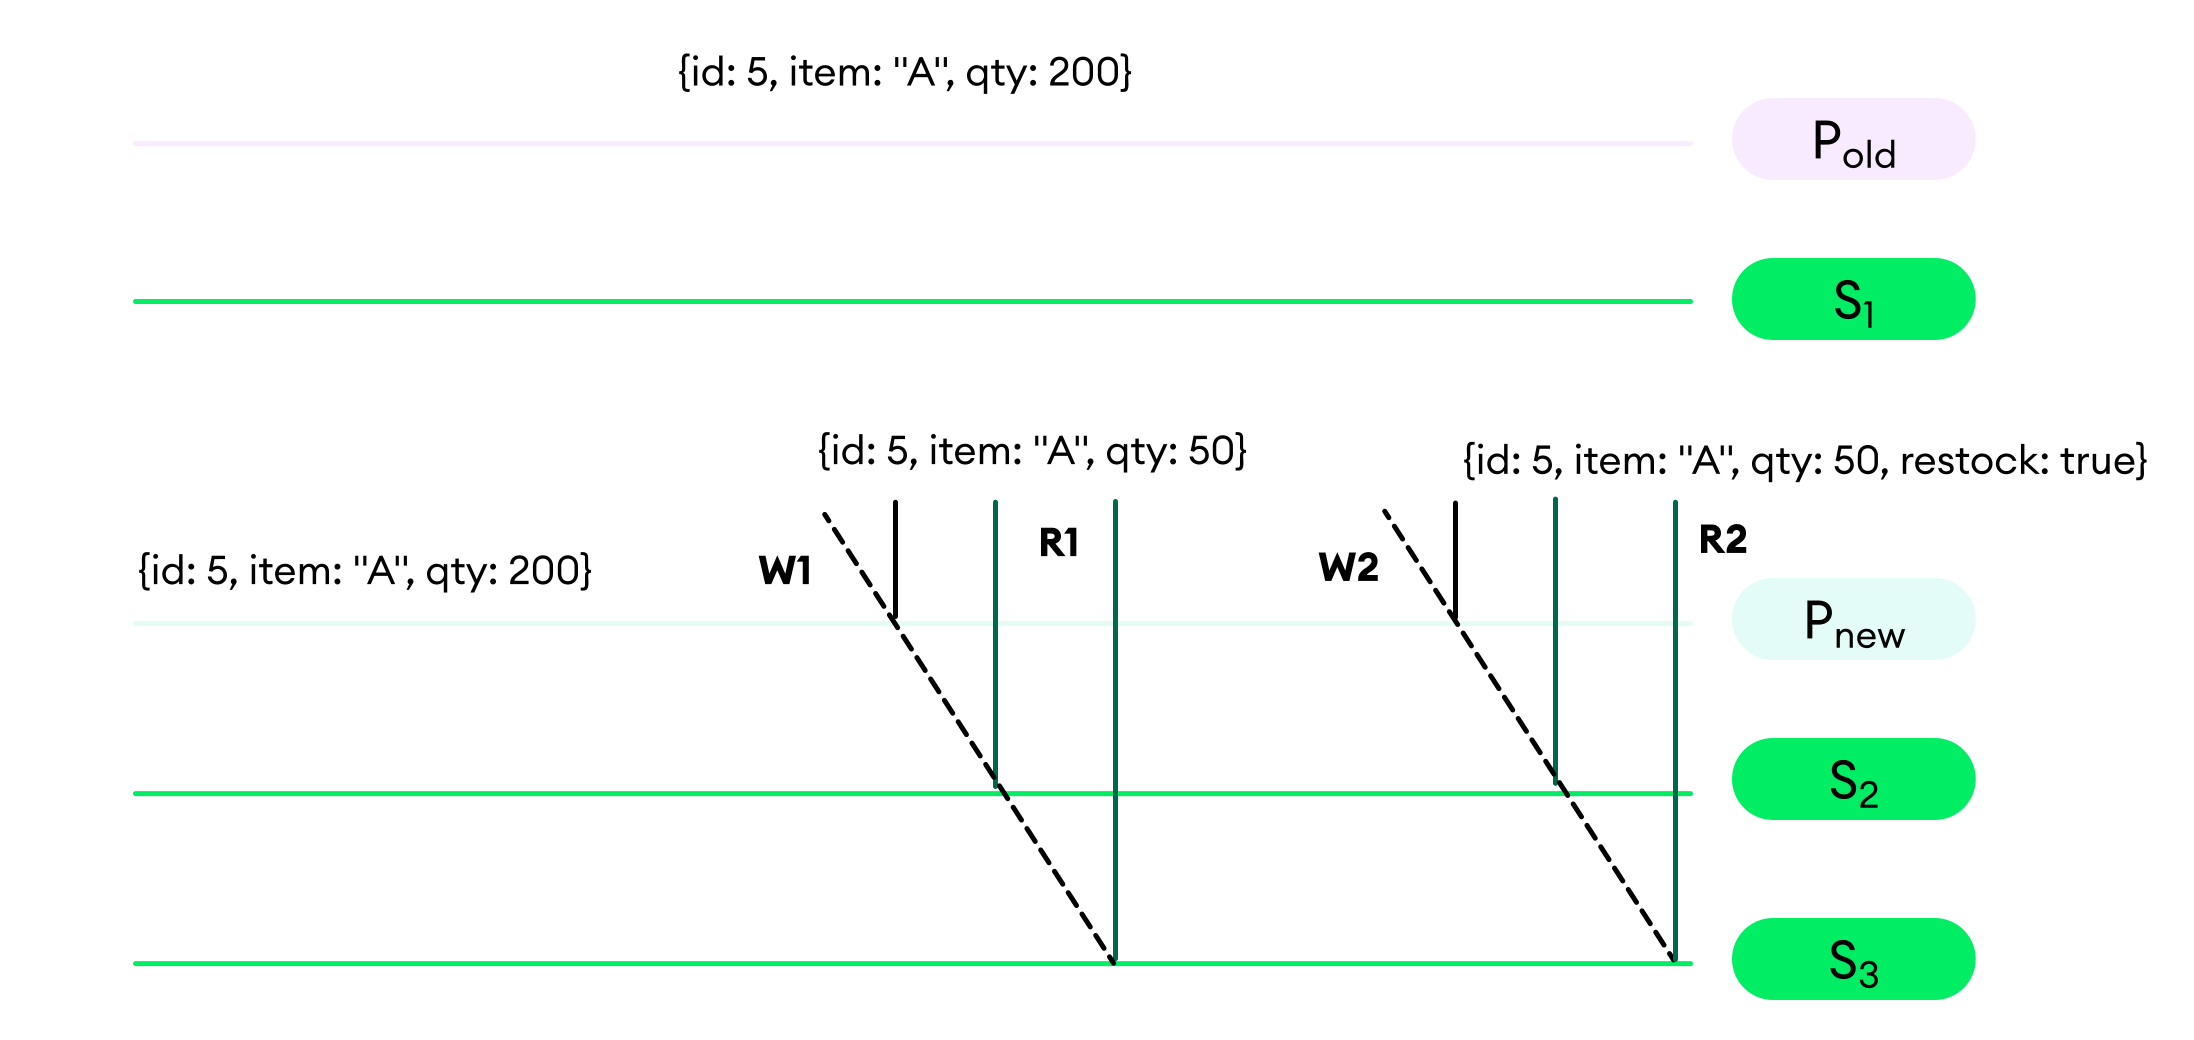
✅ 자체 쓰기 읽기 | 읽기 1는 쓰기 (write) 1 이후의 상태를 반영하는 |
✅ 단조적 읽기 | 읽기 2는 읽기 1 이후의 상태를 반영하는 |
✅ 단조적 쓰기 | 쓰기는 2 쓰기 이후의 상태를 반영하는 1 |
✅ 읽기 다음에 쓰기 | 쓰기 2는 읽기 1 이후의 데이터 상태를 반영하는 |
참고
시나리오 2 (읽기 고려 '대다수' 및 쓰기 고려 '대다수')
읽기 고려가 있는 읽기1의 경우 "majority"가 S 1으로 라우팅되는 대체 시퀀스를 고려합니다:
시퀀스 | 예시 |
|---|---|
1.1 | 항목 |
이 시퀀스에서 읽기는 1 P 오래된 항목에서 과반수 커밋 포인트가 진행되기 전에 반환될 수 없습니다. 이는 P 오래된 항목 및 S 1이 복제본 세트의 나머지 부분과 통신할 수 있을 때까지 진행될 수 없습니다. 이때 P 오래된 항목이 중단(아직 중단되지 경우)되며, 두 멤버가 복제본 세트의 다른 멤버로부터 동기화(쓰기 포함1)합니다.
✅ 자체 쓰기 읽기 | 읽기 1은 네트워크 파티션이 복구되고 멤버가 복제본 세트의 다른 멤버와 동기화된 후에도 쓰기 1 이후의 데이터 상태를 반영합니다. 읽기 2가 쓰기 1과 쓰기 2 이후의 상태를 반영하는 |
✅ 단조적 읽기 | 읽기는2 |
✅ 단조적 쓰기 | 쓰기는 2 쓰기 이후의 상태를 반영하는 1 |
✅ 읽기 다음에 쓰기 | 쓰기 2는 읽기 1 이후의 데이터 상태를 반영하는 |
읽기 고려 "majority" 및 쓰기 고려 {w: 1}
인과적으로 일관된 세션에서 읽기 고려 "majority"와 쓰기 고려 { w: 1 }을 사용하면 데이터 내구성에 대한 인과적 일관성을 원하는 경우 다음과 같은 인과적 일관성이 보장됩니다.
자체 쓰기 읽기 ❌ 단조적 읽기 ❌ 단조적 쓰기 ✅ 읽기 후 쓰기
데이터 내구성 없이 인과적 일관성을 유지하려는 경우:
자체 쓰기 읽기 ✅ 단조적 읽기 ✅ 단조적 쓰기 ✅ 읽기 후 쓰기
참고
시나리오 3(읽기 고려 '대다수' 및 쓰기 고려 {w: 1})
두 개의 프라이머리가 있는 일시적인 기간 동안 P 오래된 항목 및 P 새로운 항목 모두 { w: 1 } 쓰기 고려를 통해 쓰기를 수행할 수 있으므로 클라이언트 세션에서 다음 작업 순서를 성공적으로 실행할 수 있지만 데이터 내구성이 유지되는 인과적 일관성을 원하는 경우 인과적으로 일관되지 않을 수 있습니다:
시퀀스 | 예시 |
|---|---|
1. 쓰기 1 | 항목 |
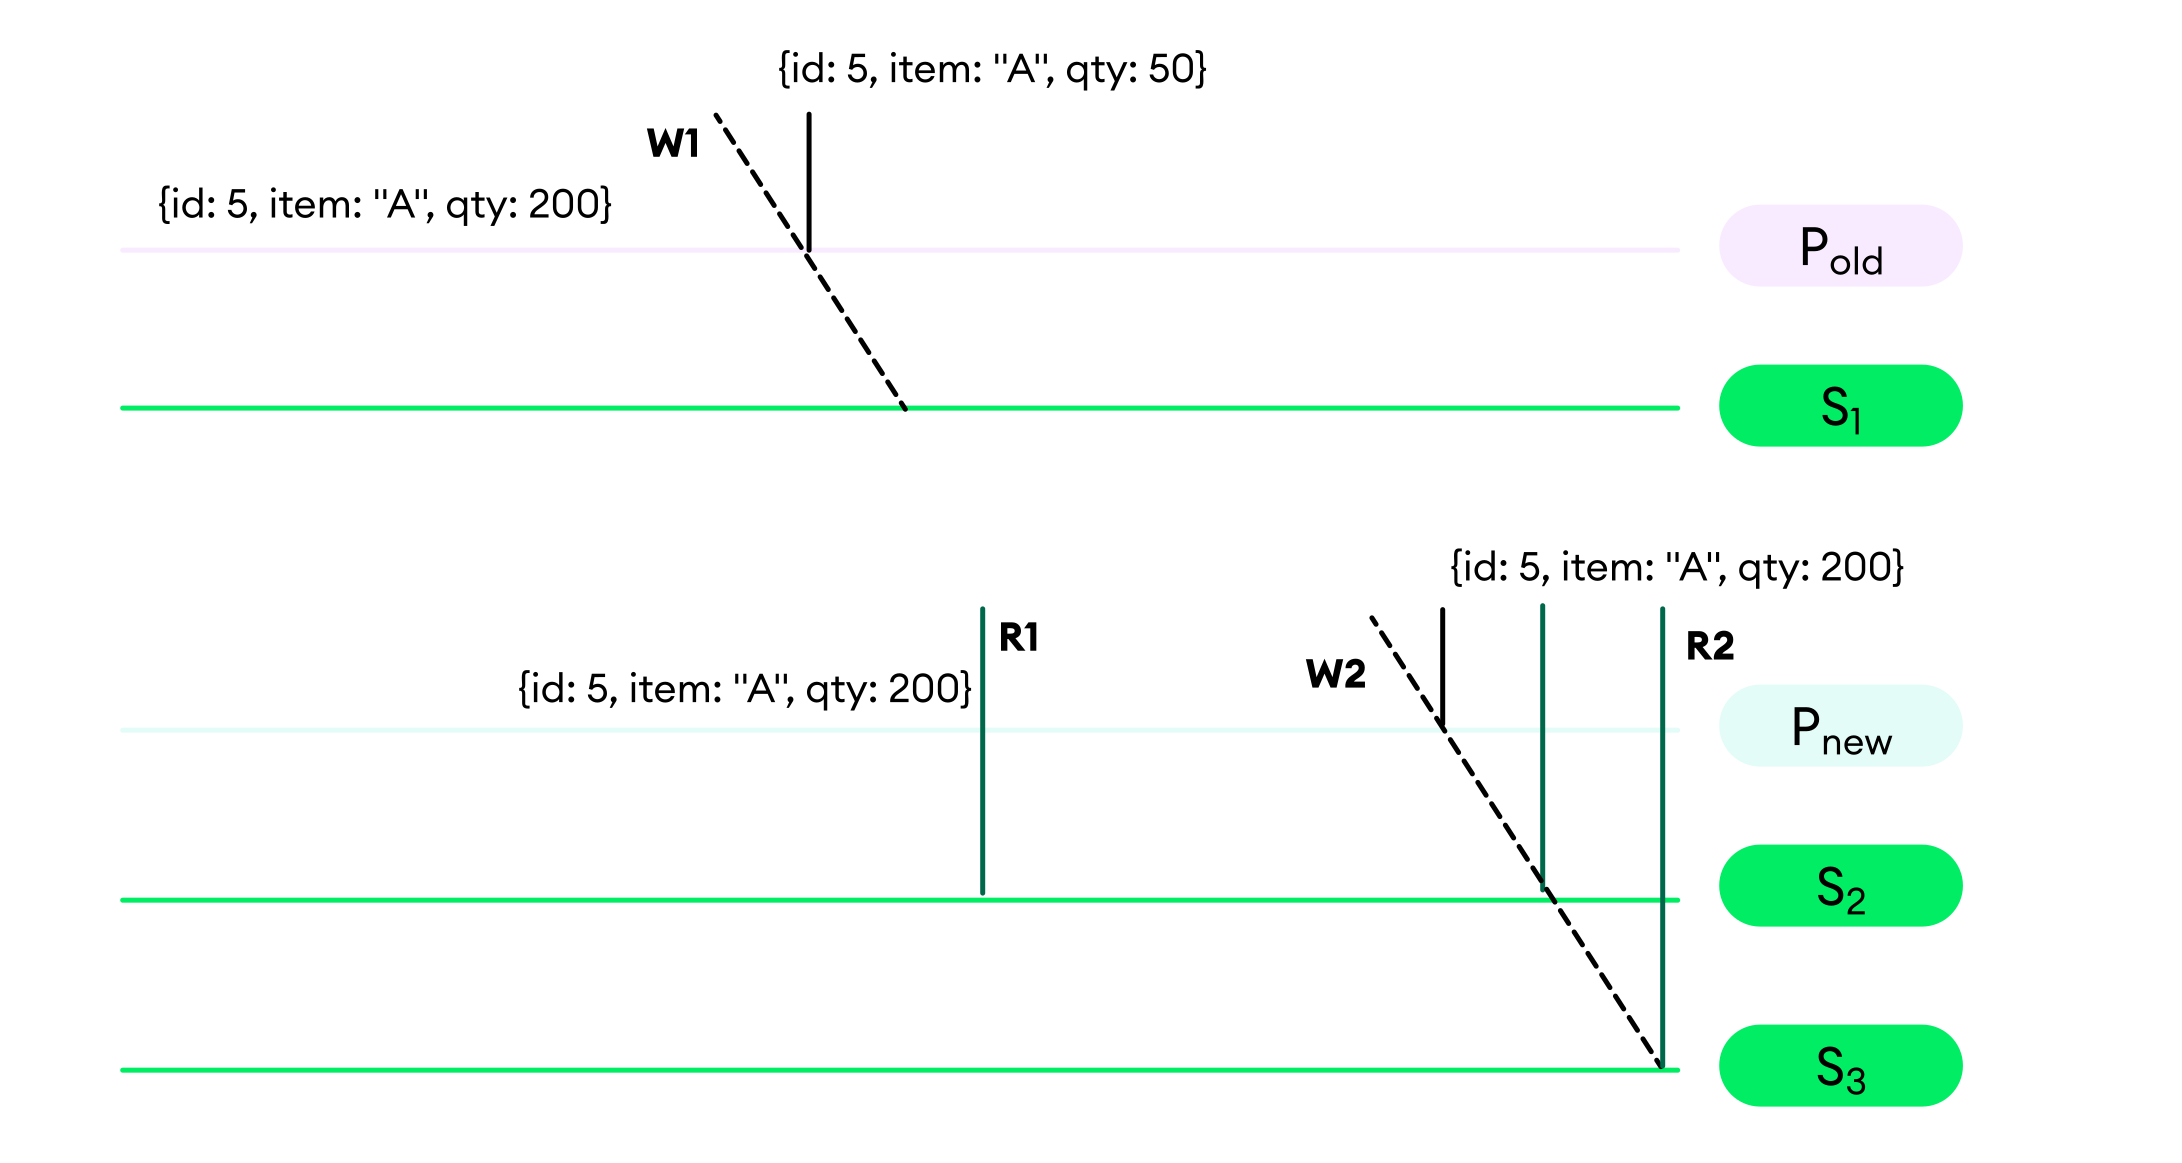
해당 시퀀스에서,
읽기 1은 쓰기 1의 시점을 지나
P에서 새로 과반수 커밋 포인트가 진행될 때까지 반환할 수 없습니다.읽기 2는 과반수 커밋 포인트가 쓰기2 시점을 지나
P새로운 항목으로 진행될 때까지 반환할 수 없습니다.쓰기 1은 네트워크 파티션이 복구될 때 롤백됩니다.
데이터 내구성이 유지된 인과적 일관성을 원하는 경우
❌ 자체 쓰기 읽기 | 읽기1은 쓰기1 이후의 상태를 반영하지 않는 |
✅ 단조적 읽기 | 읽기는2 |
❌ 단조적 쓰기 | 쓰기2는 쓰기1 이후의 상태를 반영하지 않는 |
✅ 읽기 다음에 쓰기 | 쓰기 2는 읽기 1 이후의 데이터 상태를 반영하는 |
➤ 데이터 내구성이 유지된 인과적 일관성을 원하는 경우
✅ 자체 쓰기 읽기 | 읽기1은 쓰기1에 해당하는 상태 를 반영하는 |
✅ 단조적 읽기 | 읽기는2 |
✅ 단조적 쓰기 | 쓰기2는 쓰기1을 롤백한 후 쓰기1 해당하는 |
✅ 읽기 다음에 쓰기 | 쓰기 2는 읽기 1 이후의 상태를 반영하는 |
참고
시나리오 4(읽기 고려 '대다수' 및 쓰기 고려 {w: 1})
읽기 고려가 있는 읽기1의 경우 "majority"가 S 1으로 라우팅되는 대체 시퀀스를 고려합니다:
시퀀스 | 예시 |
|---|---|
1. 쓰기 1 | 항목 |
해당 시퀀스에서:
- 읽기 1은
S1에서 과반수 커밋 포인트가 진행될 때까지 반환할 수 없습니다.P이전 및S1이 나머지 복제본 세트와 통신할 수 있을 때까지는 이 문제가 발생하지 않습니다. 이때P이전이 물러나고(아직 물러나지 않은 경우), 쓰기 1이P이전과S1에서 롤백되고, 두 노드는 복제본 세트의 다른 노드로부터 동기화됩니다.
데이터 내구성이 유지된 인과적 일관성을 원하는 경우
❌ 자체 쓰기 읽기 | 읽기 1에서 읽은 데이터는 롤백된 쓰기 1의 결과를 반영하지 않습니다. |
✅ 단조적 읽기 | 읽기2는 읽기1 이후의 상태를 반영하는 |
❌ 단조적 쓰기 | 쓰기 2는 쓰기 1 이후의 상태를 반영하지 않는 |
✅ 읽기 다음에 쓰기 | 쓰기 2는 읽기 1 이후의 상태를 반영하는 |
➤ 데이터 내구성이 유지된 인과적 일관성을 원하는 경우
✅ 자체 쓰기 읽기 | 읽기1은 궁극적으로 쓰기1이 롤백된 이후 쓰기 1의 최종 결과를 반영하는 데이터를 반환합니다. |
✅ 단조적 읽기 | 읽기2는 읽기1 이후의 상태를 반영하는 |
✅ 단조적 쓰기 | 쓰기2는 쓰기1을 롤백한 후 쓰기1 해당하는 |
✅ 읽기 다음에 쓰기 | 쓰기 2는 읽기 1 이후의 데이터 상태를 반영하는 |
읽기 고려 "local" 및 쓰기 고려 {w: 1}
인과적으로 일관된 세션에서 읽기 고려 "local"와 쓰기 고려 { w: 1 }를 사용하면 인과적 일관성을 보장할 수 없습니다.
❌ 자체 쓰기 읽기 ❌ 단조적 읽기 ❌ 단조적 쓰기 ❌ 읽기 후 쓰기
이 조합은 상황에 따라 네 가지 인과적 일관성 보장을 모두 충족할 수 있지만 모든 상황에서 반드시 그런 것은 아닙니다.
참고
시나리오 5(읽기 고려 '로컬' 및 쓰기 고려 {w: 1})
이 일시적인 기간 동안에는 P 이전 및 P 신규 모두 { w: 1 } 쓰기 고려를 통해 쓰기를 수행할 수 있으므로 클라이언트 세션에서 다음 작업 순서를 성공적으로 실행할 수 있지만 인과적으로 일관되지 않을 수 있습니다:
시퀀스 | 예시 |
|---|---|
항목 |
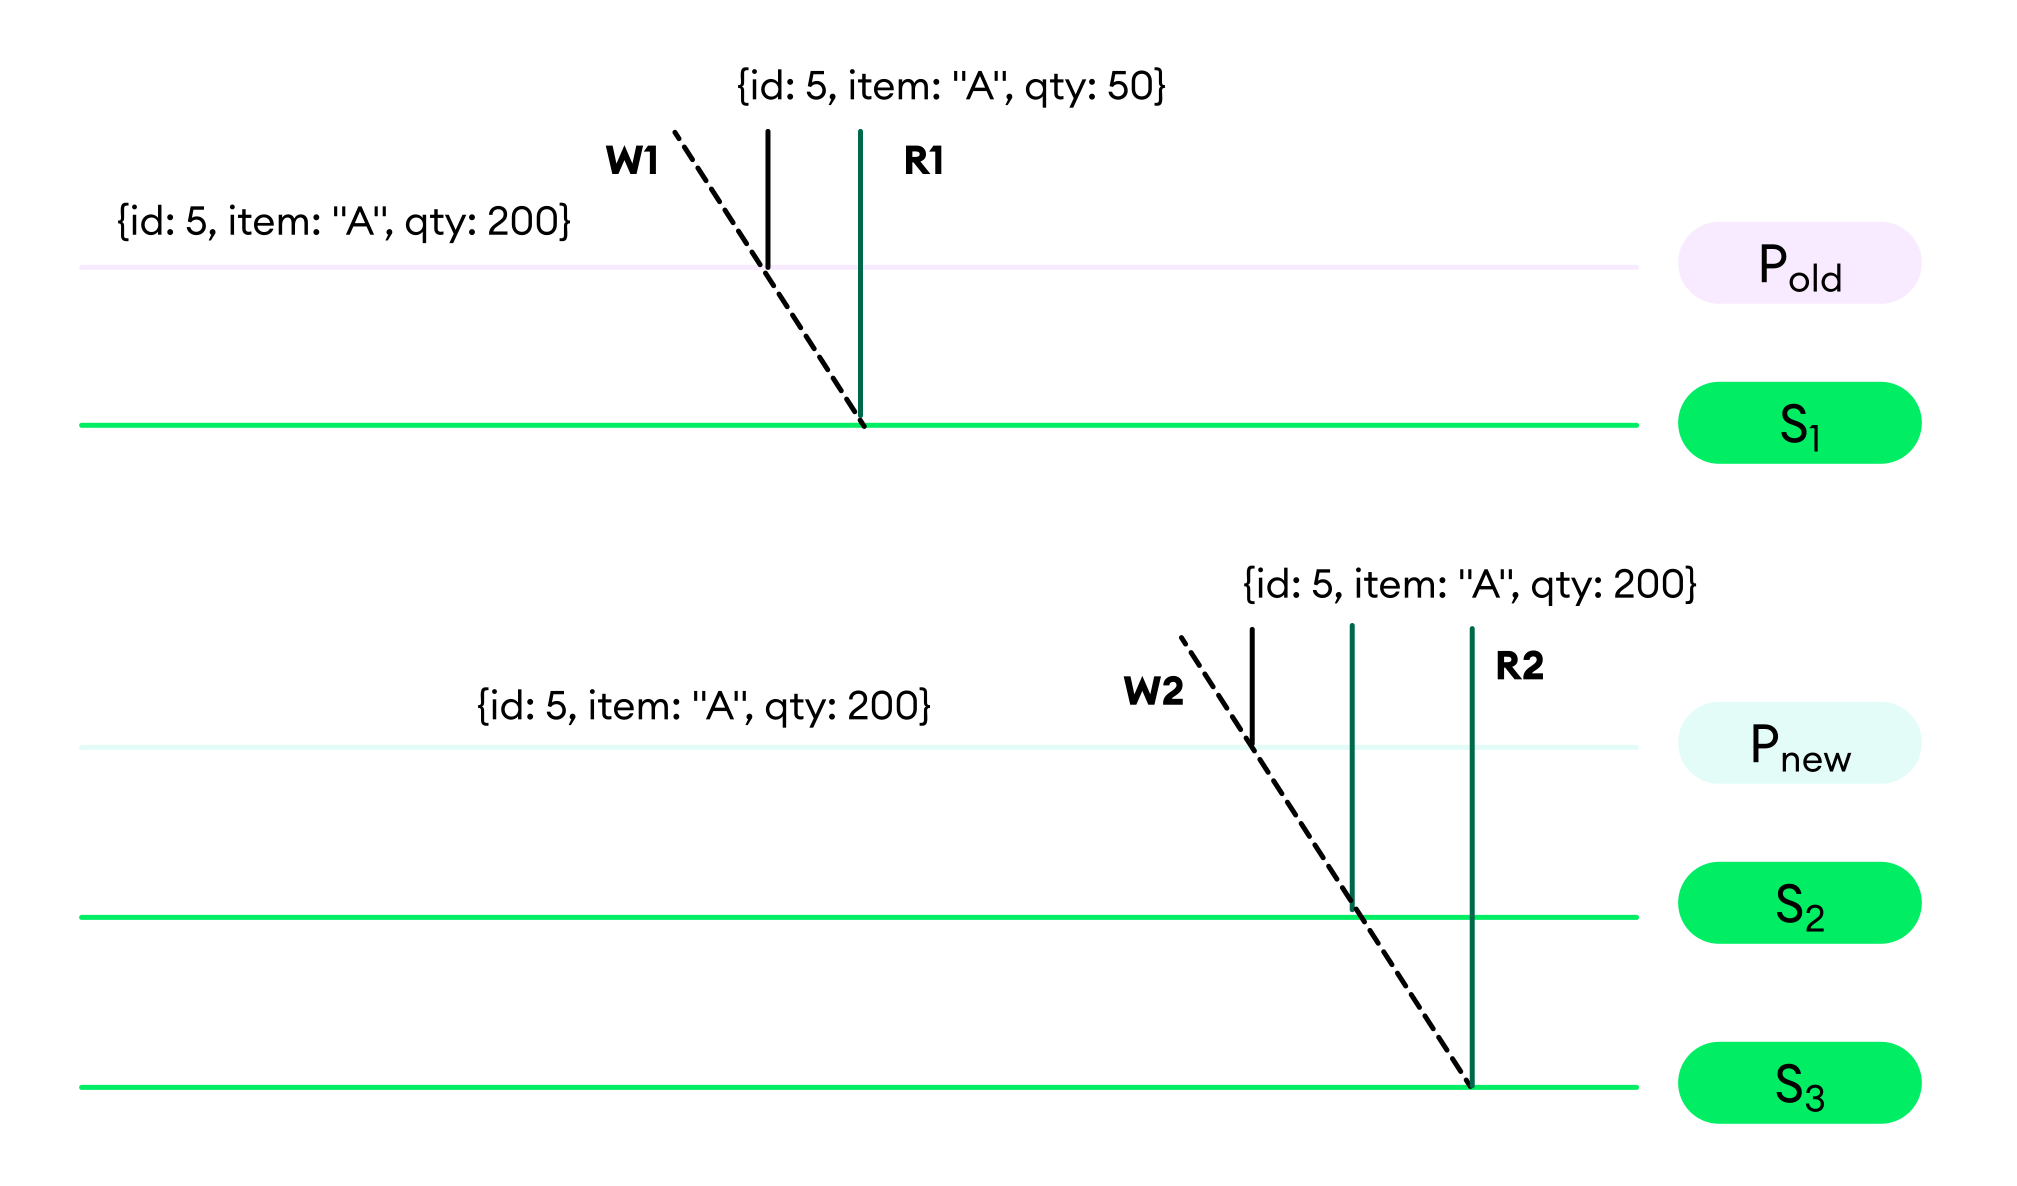
❌ 자체 쓰기 읽기 | 읽기 2가 쓰기 1과 쓰기 2가 아니라 Write 2 이후의 상태만 반영하는 |
❌ 단조적 읽기 | 읽기 2는 읽기 1 이후의 상태를 반영하지 않는 |
❌ 단조적 쓰기 | 쓰기2는 쓰기1 이후의 상태를 반영하지 않는 |
❌ 읽기 후 쓰기 | 쓰기 2는 읽기 1 이후의 상태를 반영하지 않는 |
읽기 고려 "local" 및 쓰기 고려 "majority"
인과적으로 일관된 세션에서 읽기 고려 "local"와 쓰기 고려 "majority"을 사용하면 다음과 같은 인과적 일관성이 보장됩니다.
❌ 자체 쓰기 읽기 ❌ 단조적 읽기 ✅ 단조적 쓰기 ❌ 읽기 후 쓰기
이 조합은 상황에 따라 네 가지 인과적 일관성 보장을 모두 충족할 수 있지만 모든 상황에서 반드시 그런 것은 아닙니다.
참고
시나리오 6(읽기 고려 '로컬' 및 쓰기 고려 '대다수')
이 일시적인 기간 동안에는 P 새로운 항목만이 { w: "majority" } 쓰기 고려를 통해 쓰기를 수행할 수 있으므로 클라이언트 세션에서 다음 작업 순서를 성공적으로 실행할 수 있지만 인과적으로 일관되지 않을 수 있습니다:
시퀀스 | 예시 |
|---|---|
1. 1을 쓰기 고려 (write concern) | 항목 |
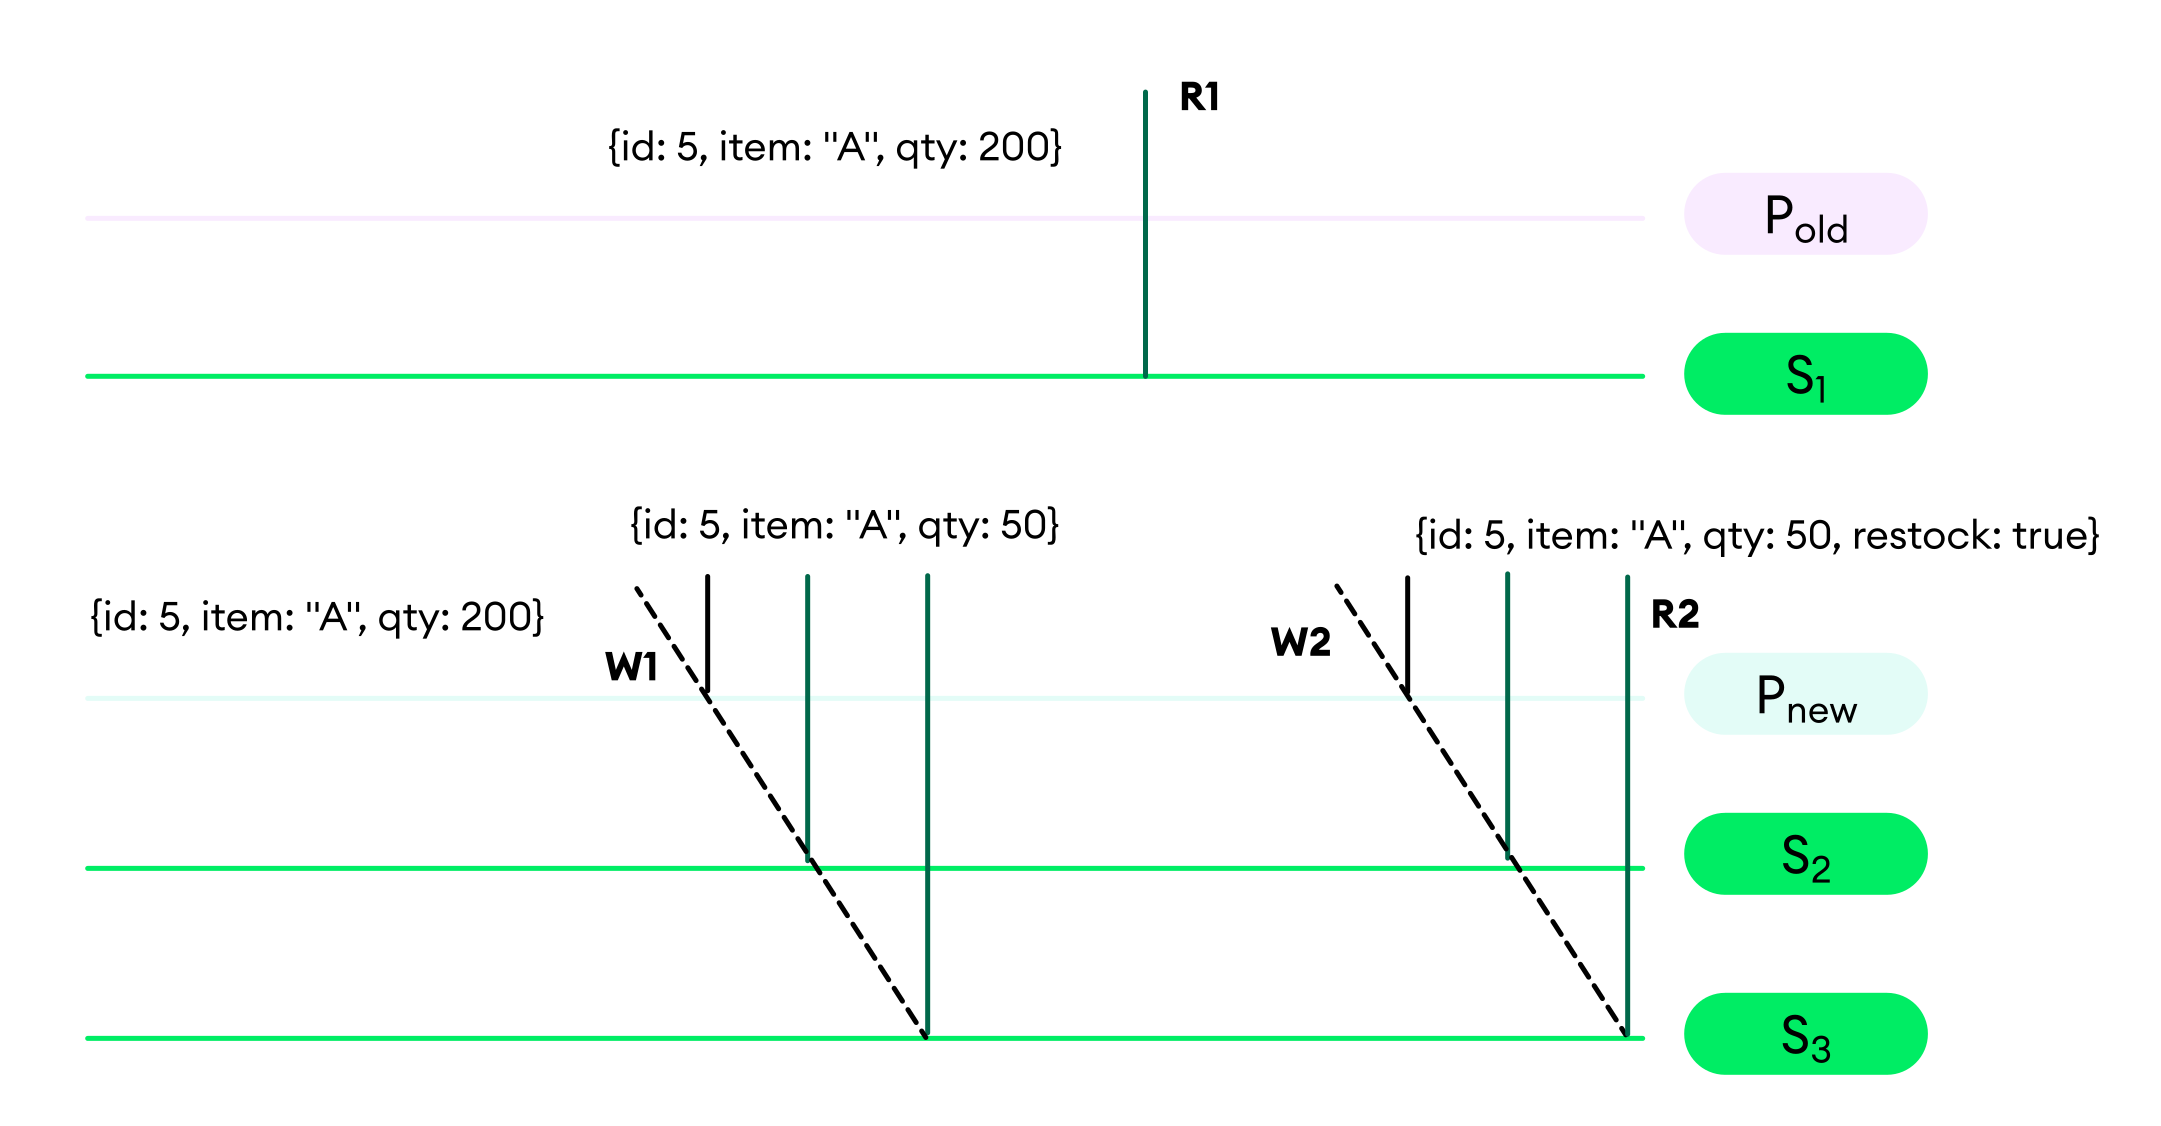
❌ 자체 쓰기 읽기 | 읽기1은 쓰기 1 이후의 상태를 반영하지 않는 |
❌ 단조적 읽기입니다. | 읽기 2는 읽기 1 이후의 상태를 반영하지 않는 |
✅ 단조적 쓰기 | 쓰기는 2 쓰기 이후의 상태를 반영하는 1 |
❌ 읽기 후 쓰기 | 쓰기 2는 읽기 1 이후의 상태를 반영하지 않는 |