本页面探讨我们的 MongoDB 向量搜索的 性能基准测试结果。MongoDB 提供一范围解决方案,可以支持各种实现需求。客户数可以选择适合其特定业务设置的性能和准确性级别。
结果总结
在 2048 维度使用
voyage-3-large个嵌入的 15.3M 个向量时,配置了量化的MongoDB Vector Search 保持了 90-95% 的准确性,查询延迟低于 50 毫秒。二值量化提供了一种更经济的解决方案,其成本约为索引服务价格的四分之一。由于它使用高保真向量进行重排序,因此对于许多大规模扩展工作负载来说,它可能是一个更可取的选择,尽管我们建议在示例数据集上运行测试,以确保性能符合您的需求。
在运行较大工作负载时进行量化时,我们建议使用超过 1024 个维度。
选择性过滤器可以提高或降低性能,具体取决于为
numCandidates选择的值。在运行高度并发的工作负载时,二进制量化重新评分的额外成本会导致吞吐量降低。
分片可略微提高吞吐量,但我们仍建议扩大搜索节点的数量或搜索节点上可用内核的数量,以提高吞吐量。
多维基准测试中的召回率和延迟分析
第一组结果显示的是我们对 5. 5 百万个文档数据集进行的测试,该数据集包含多个维度的向量(256、512、1024、2048),每个文档中的所有向量均使用 voyage-3-large 生成。
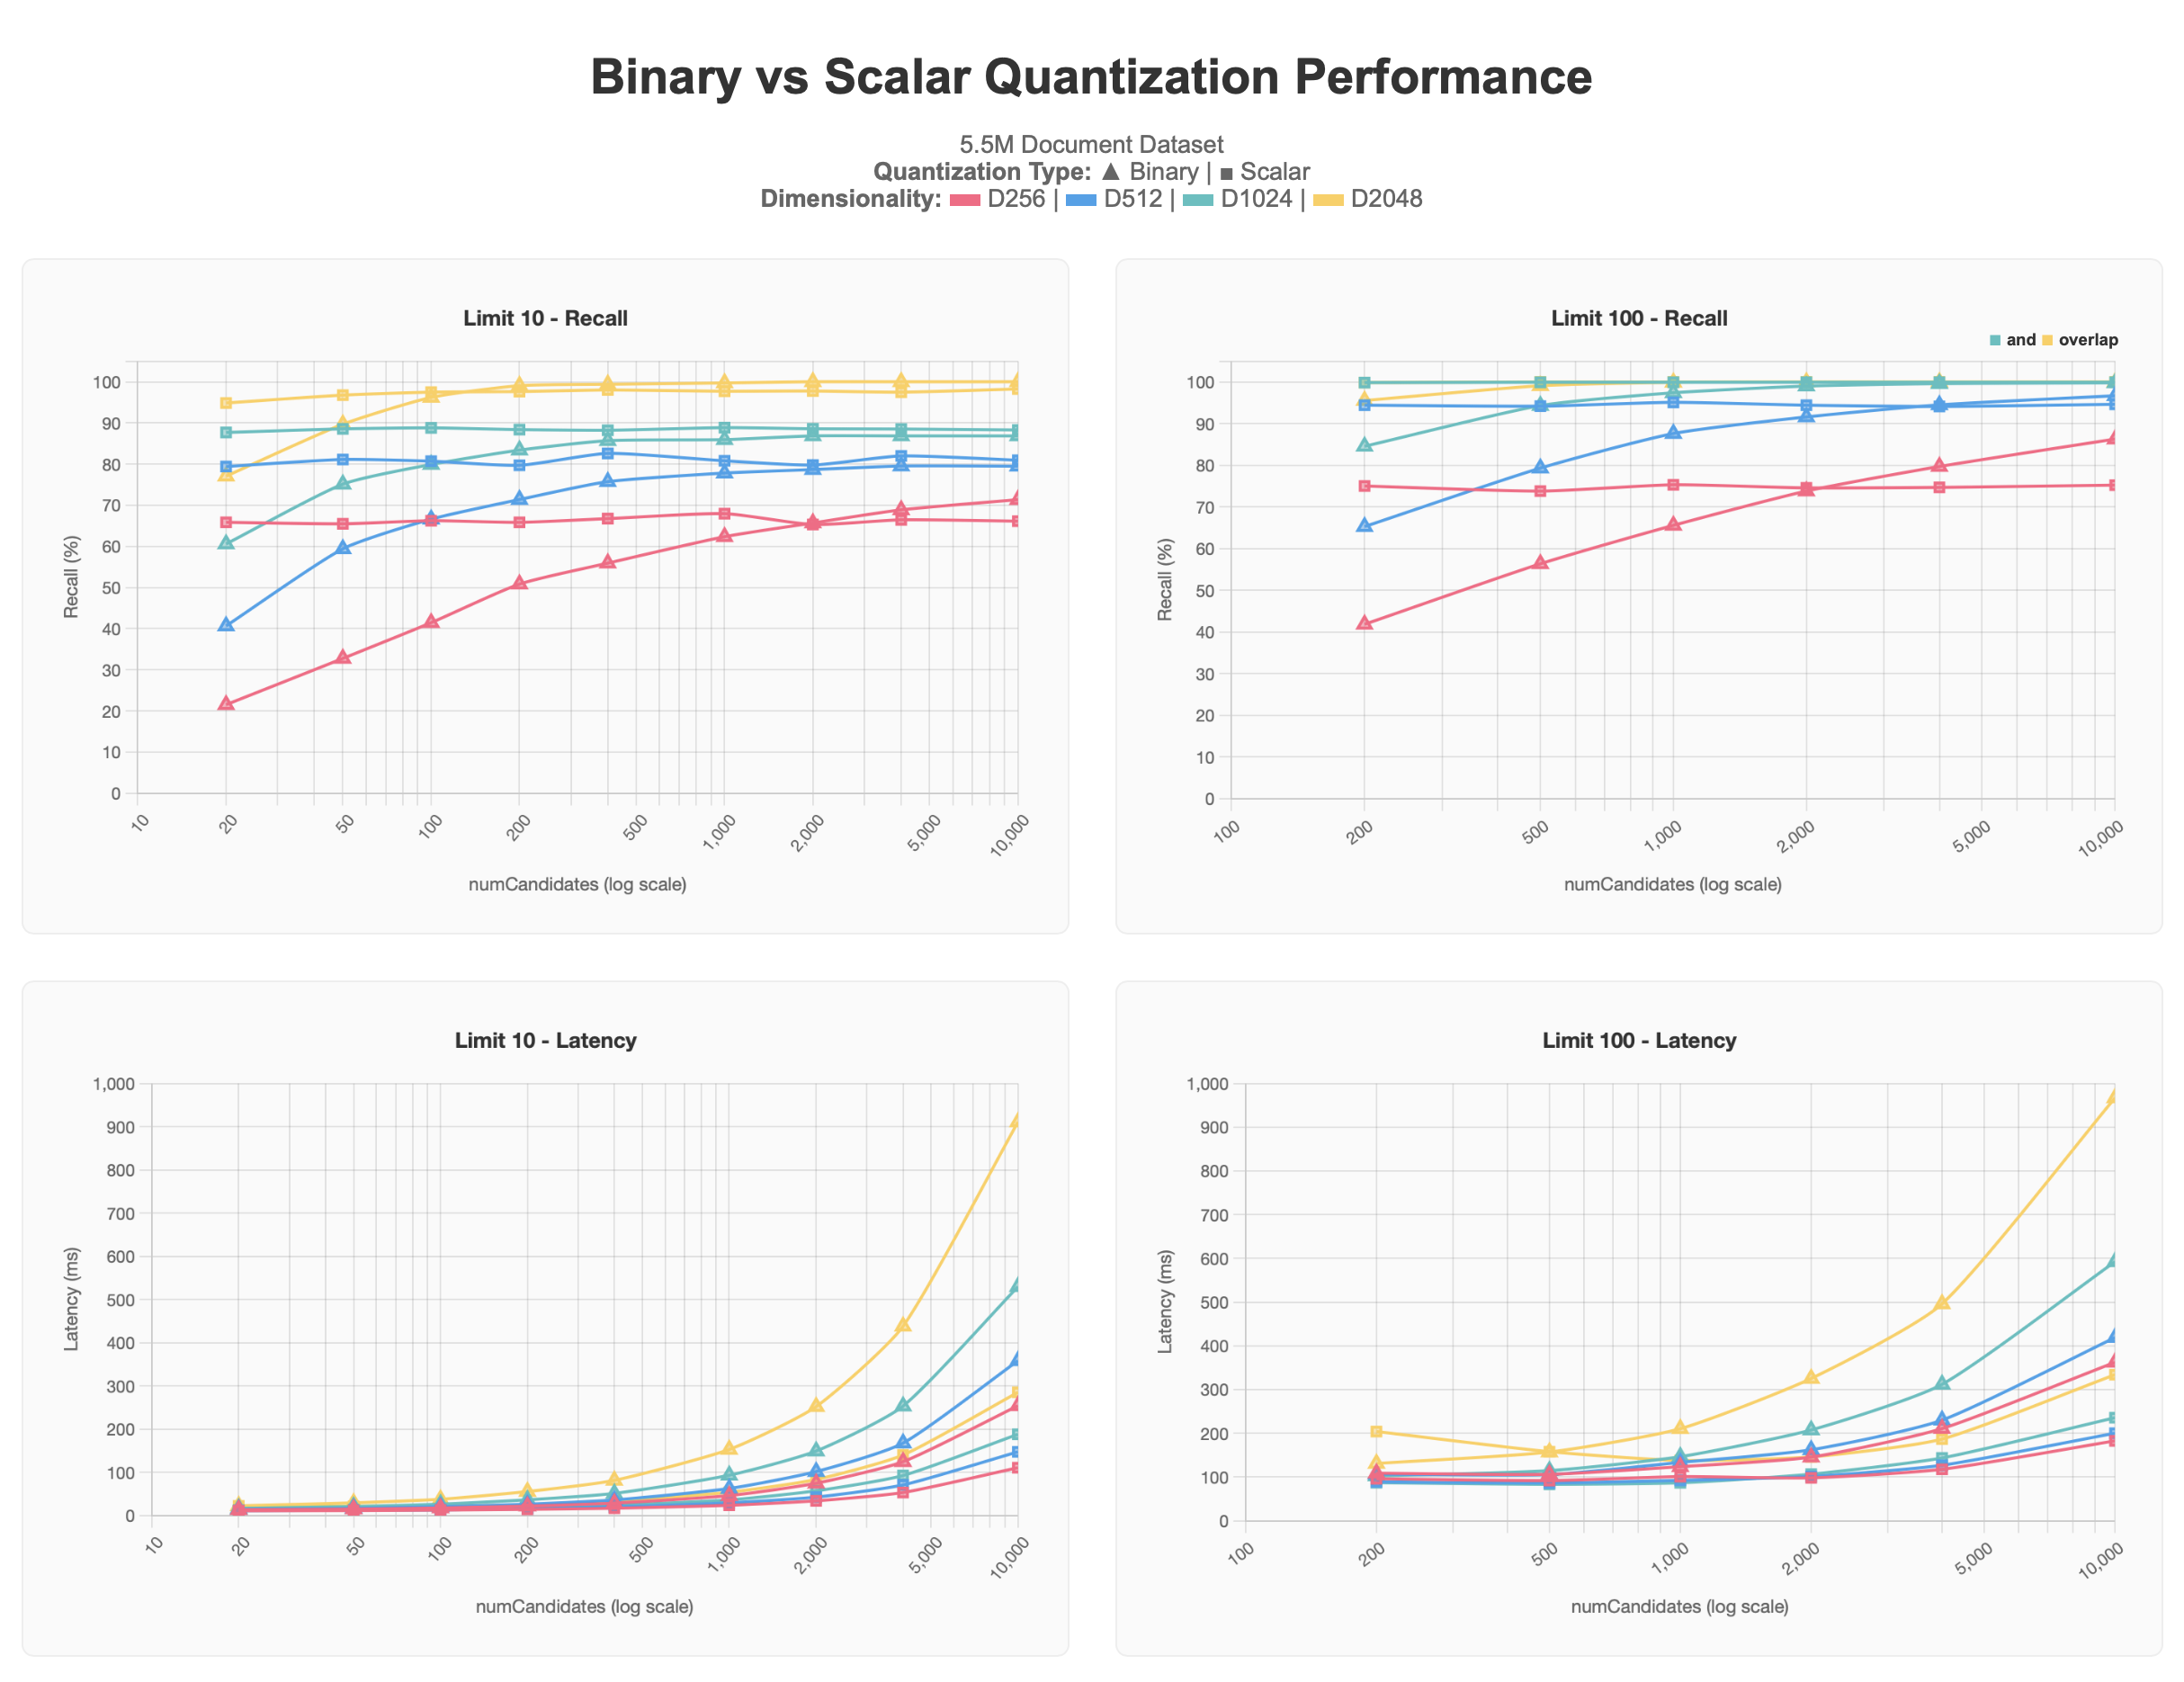
标量量化结果的起始级别都高于二进制量化结果的级别,但即使 numCandidates 增加,仍会保持在渐近级别。相反,随着请求的 numCandidates 越多,二进制量化查询就会产生更准确的结果,接近标量量化的渐近线,并且在某些情况下超过标量量化的渐近线,但费用是更高的延迟,特别是在超过 1000 的 numCandidates 时。
limit 的值越低,通常需要更高的 numCandidates 才能接近 100% 的准确度,因为查询对最高结果的选择性更强。这种效果在二进制量化图中尤为明显。高维向量(1024d 及以上)在较低的 numCandidates 处达到 90-95% 的目标范围,因为更丰富的表示使得更容易区分附近的邻居。将结果 limit 到 100 以达到 90-95% 目标范围并具有较低 numCandidates 的测试,比将结果 limit 到 10 的测试更好,因为较大的结果集为搜索提供了更多机会显示相关邻居。
根据这些信息,我们认为,在处理大型数据集时,我们建议维度至少为 1024 维,并应用量化来扩展规模,而不是采用更低维度且不进行量化的方案,同时应用场景请求的向量数量也是考量因素之一。
更大规模的基准测试结果
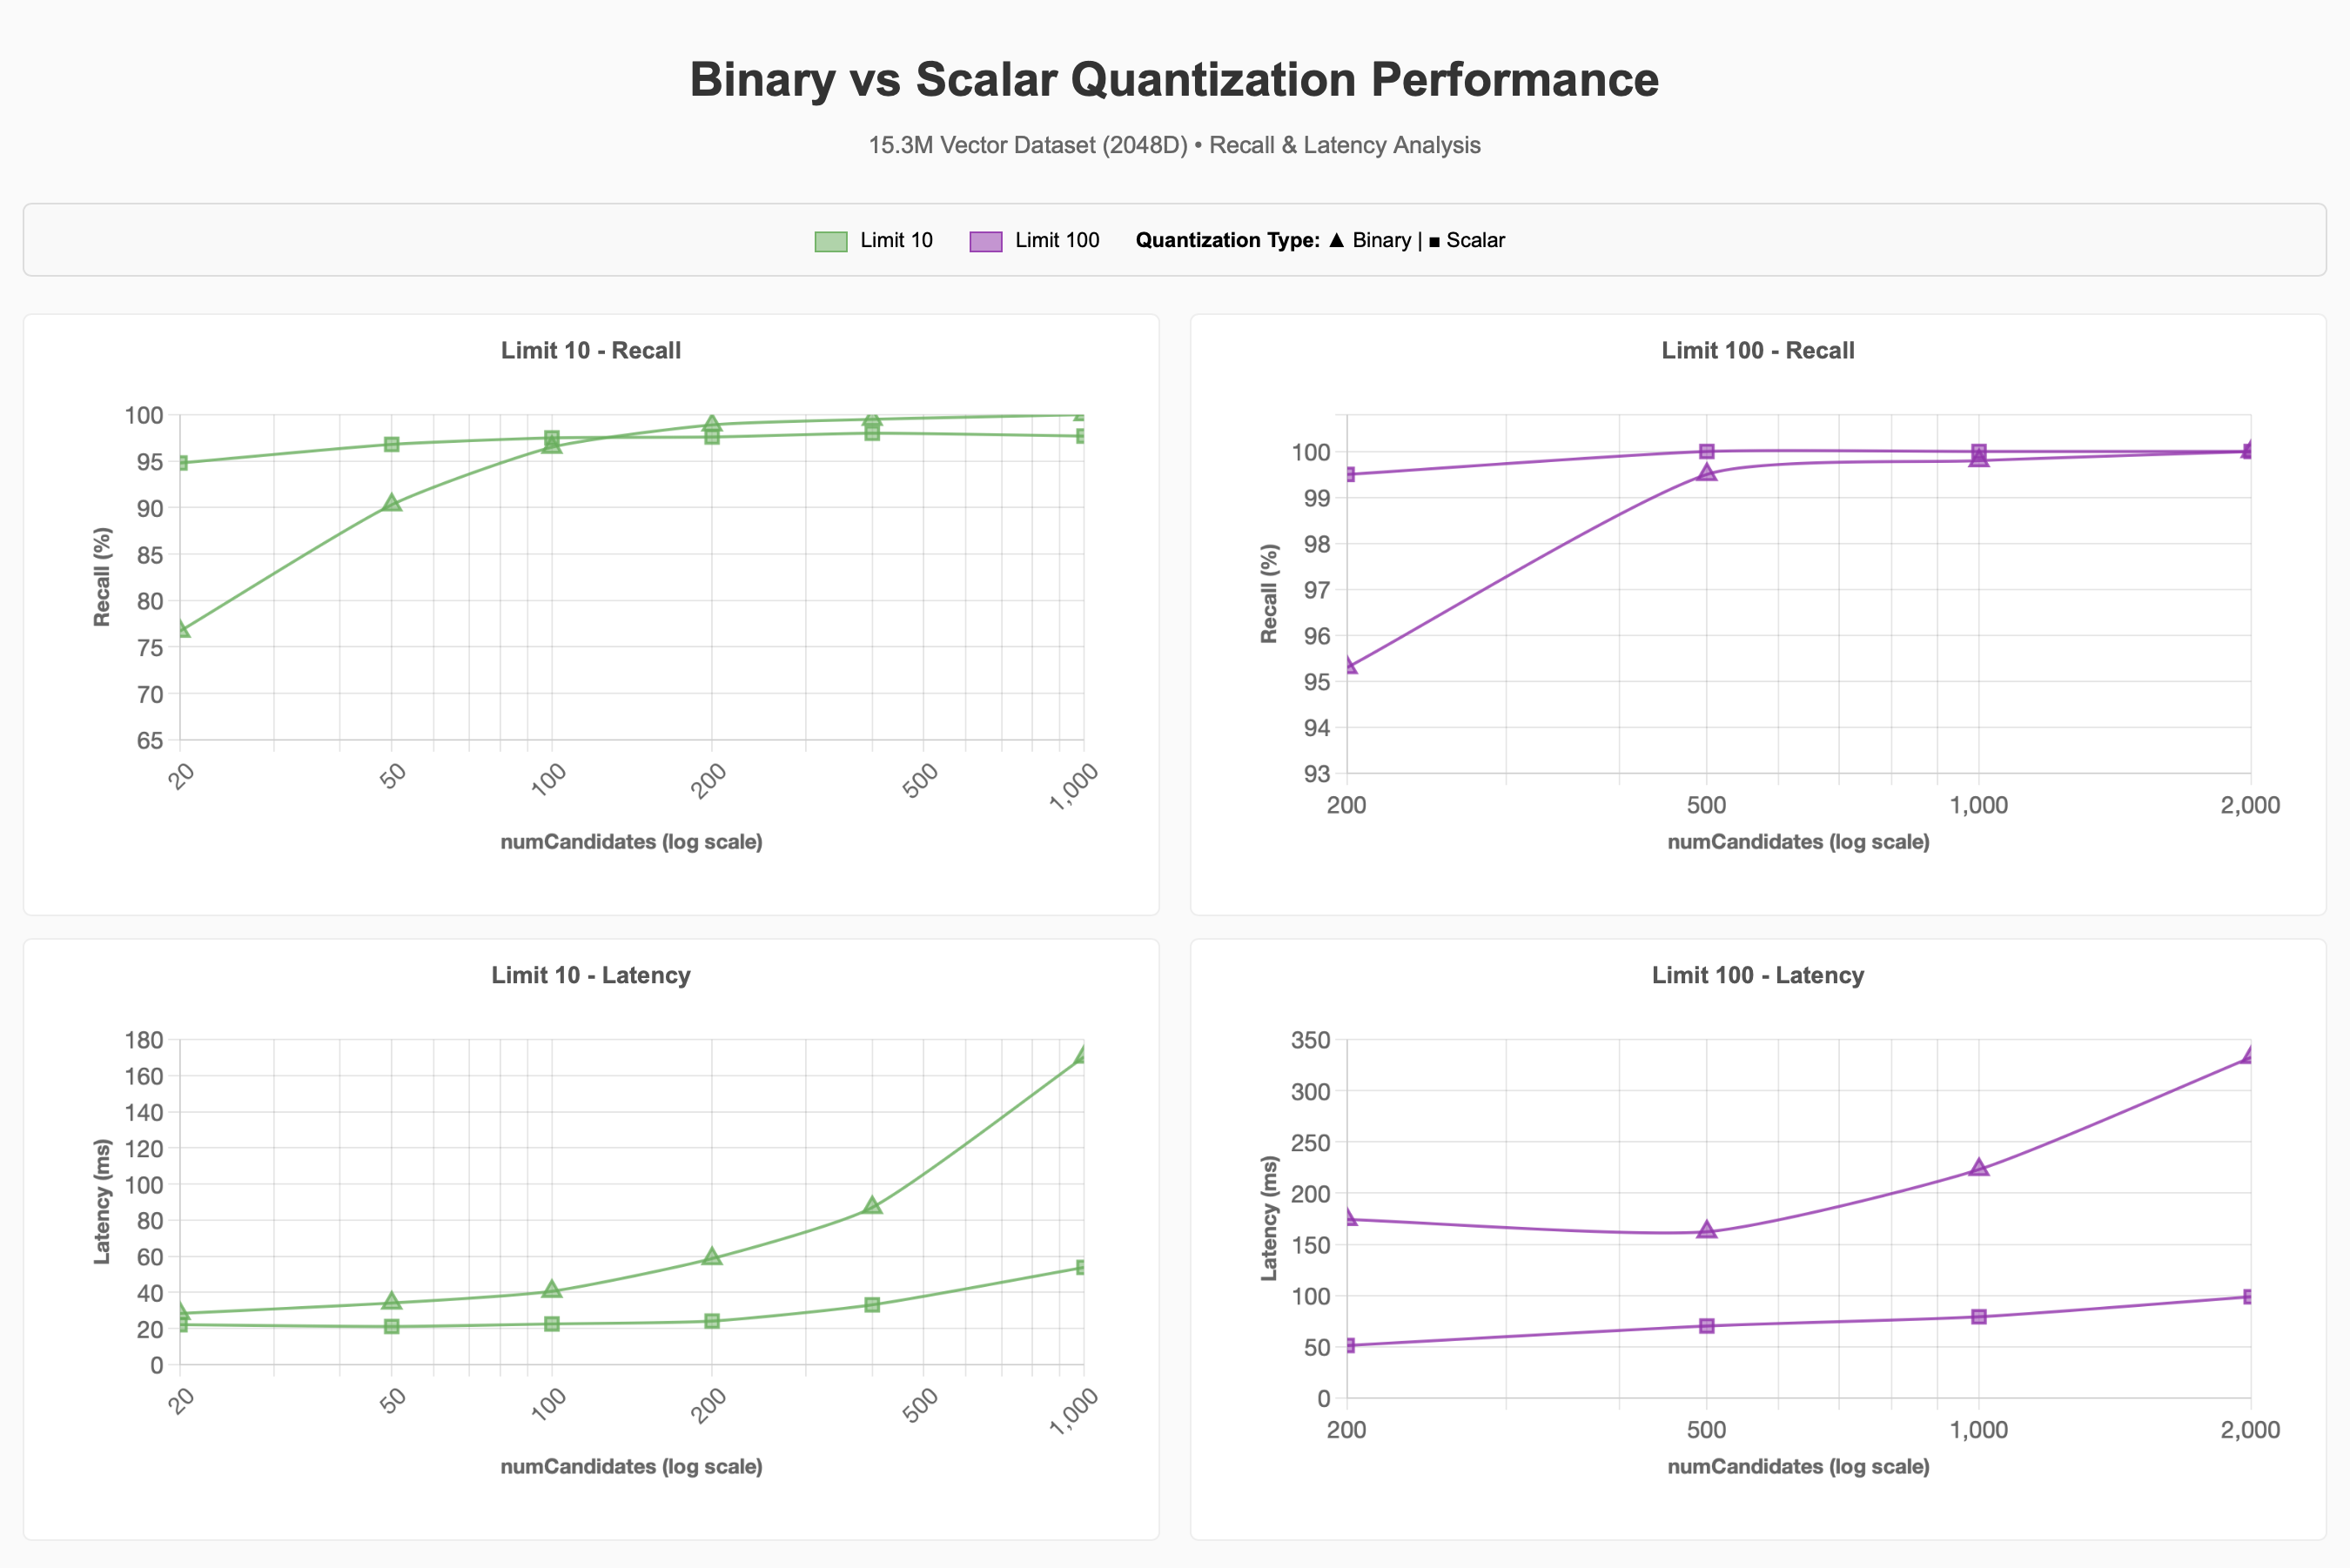
对于较大的 15.3M 向量数据集,我们将维度固定为 2048 维,并检查了量化、过滤和并发操作对性能的影响。我们最终选择将维度固定在 2048 维,这是因为前一组测试的结果显示,更高维度能更有效地保持召回率,不过,要达到 90-95% 的召回率目标,1024 维可能同样适用。
召回率和延迟分析
我们观察到,与基线相比,使用二进制量化要实现 90–95% 的召回率目标,需要花费更多的 numCandidates。较高的 numCandidates 通常意味着更高的延迟,但这可能会有所不同。
过滤
我们观察了在数据集上使用选择性过滤器时召回率与延迟的变化情况,当约 500 千条项目(占语料库的 ~3%)属于宠物用品类别(总项目数 15.3 百万条)时:
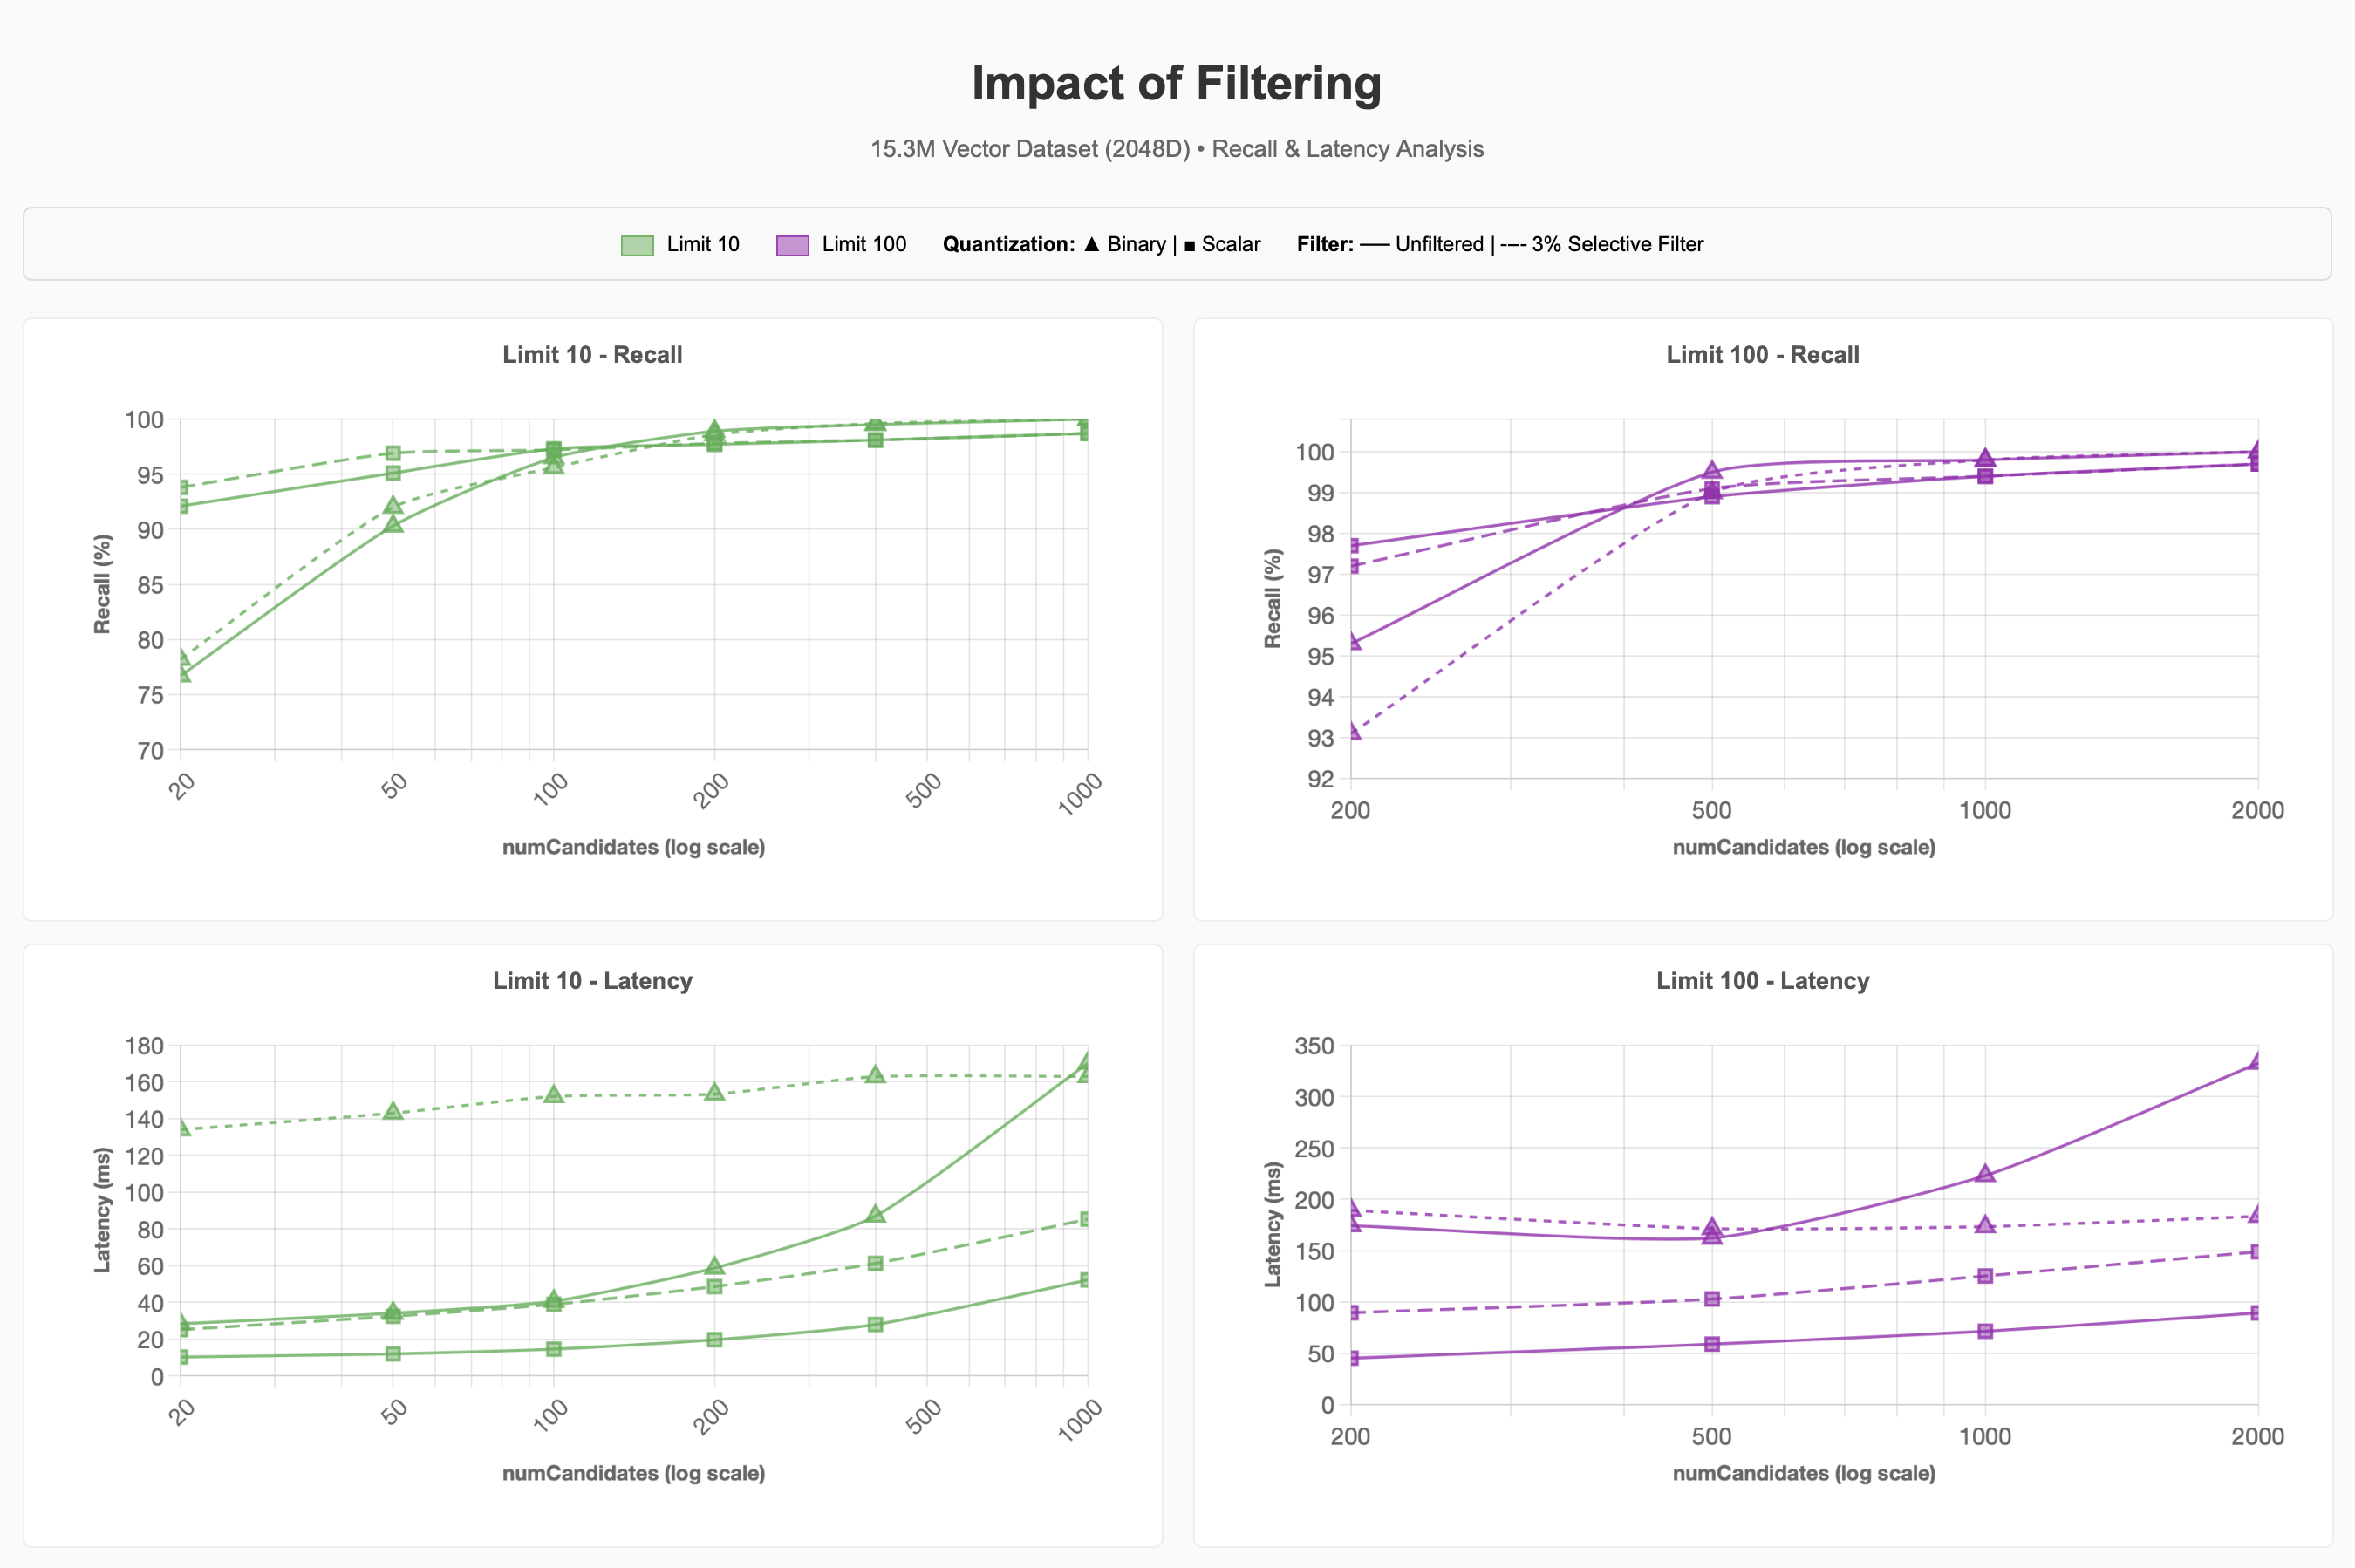
选择性过滤器是一种仅匹配少量数据片段(在本例中,约为 3%)的过滤器。由于搜索引擎现在必须在这个小子集中找到最近邻居,它必须探索更多的索引,并评估更多的候选对象,以达到相同的找回率。每个查询执行的工作量比未过滤的查询更多。
正如预期的那样,我们可以看到 3% 选择性过滤器可能会导致查询执行更多工作。对于较低 limit 值的二进制量化,实现 90-95% 的召回率所需的工作量大约是未过滤查询的 4 倍。
Lucene 10 的未来改进(支持用于分层可导航小世界的 Acorn-1搜索策略)可能会改进此进程。但是,当请求的候选数量超过分段内与元数据过滤匹配的向量数量时,执行 ENN 表明,无论选择哪种量化机制,过滤的选择性在查询性能中都发挥着重要作用。
并发
在使用标量和二进制量化时,这些测试会根据不同的 limit 值在 1、 10 和 100 之间扩展并发请求。numCandidates 是通过选择能达到 90-95% 召回率的值来选定的:
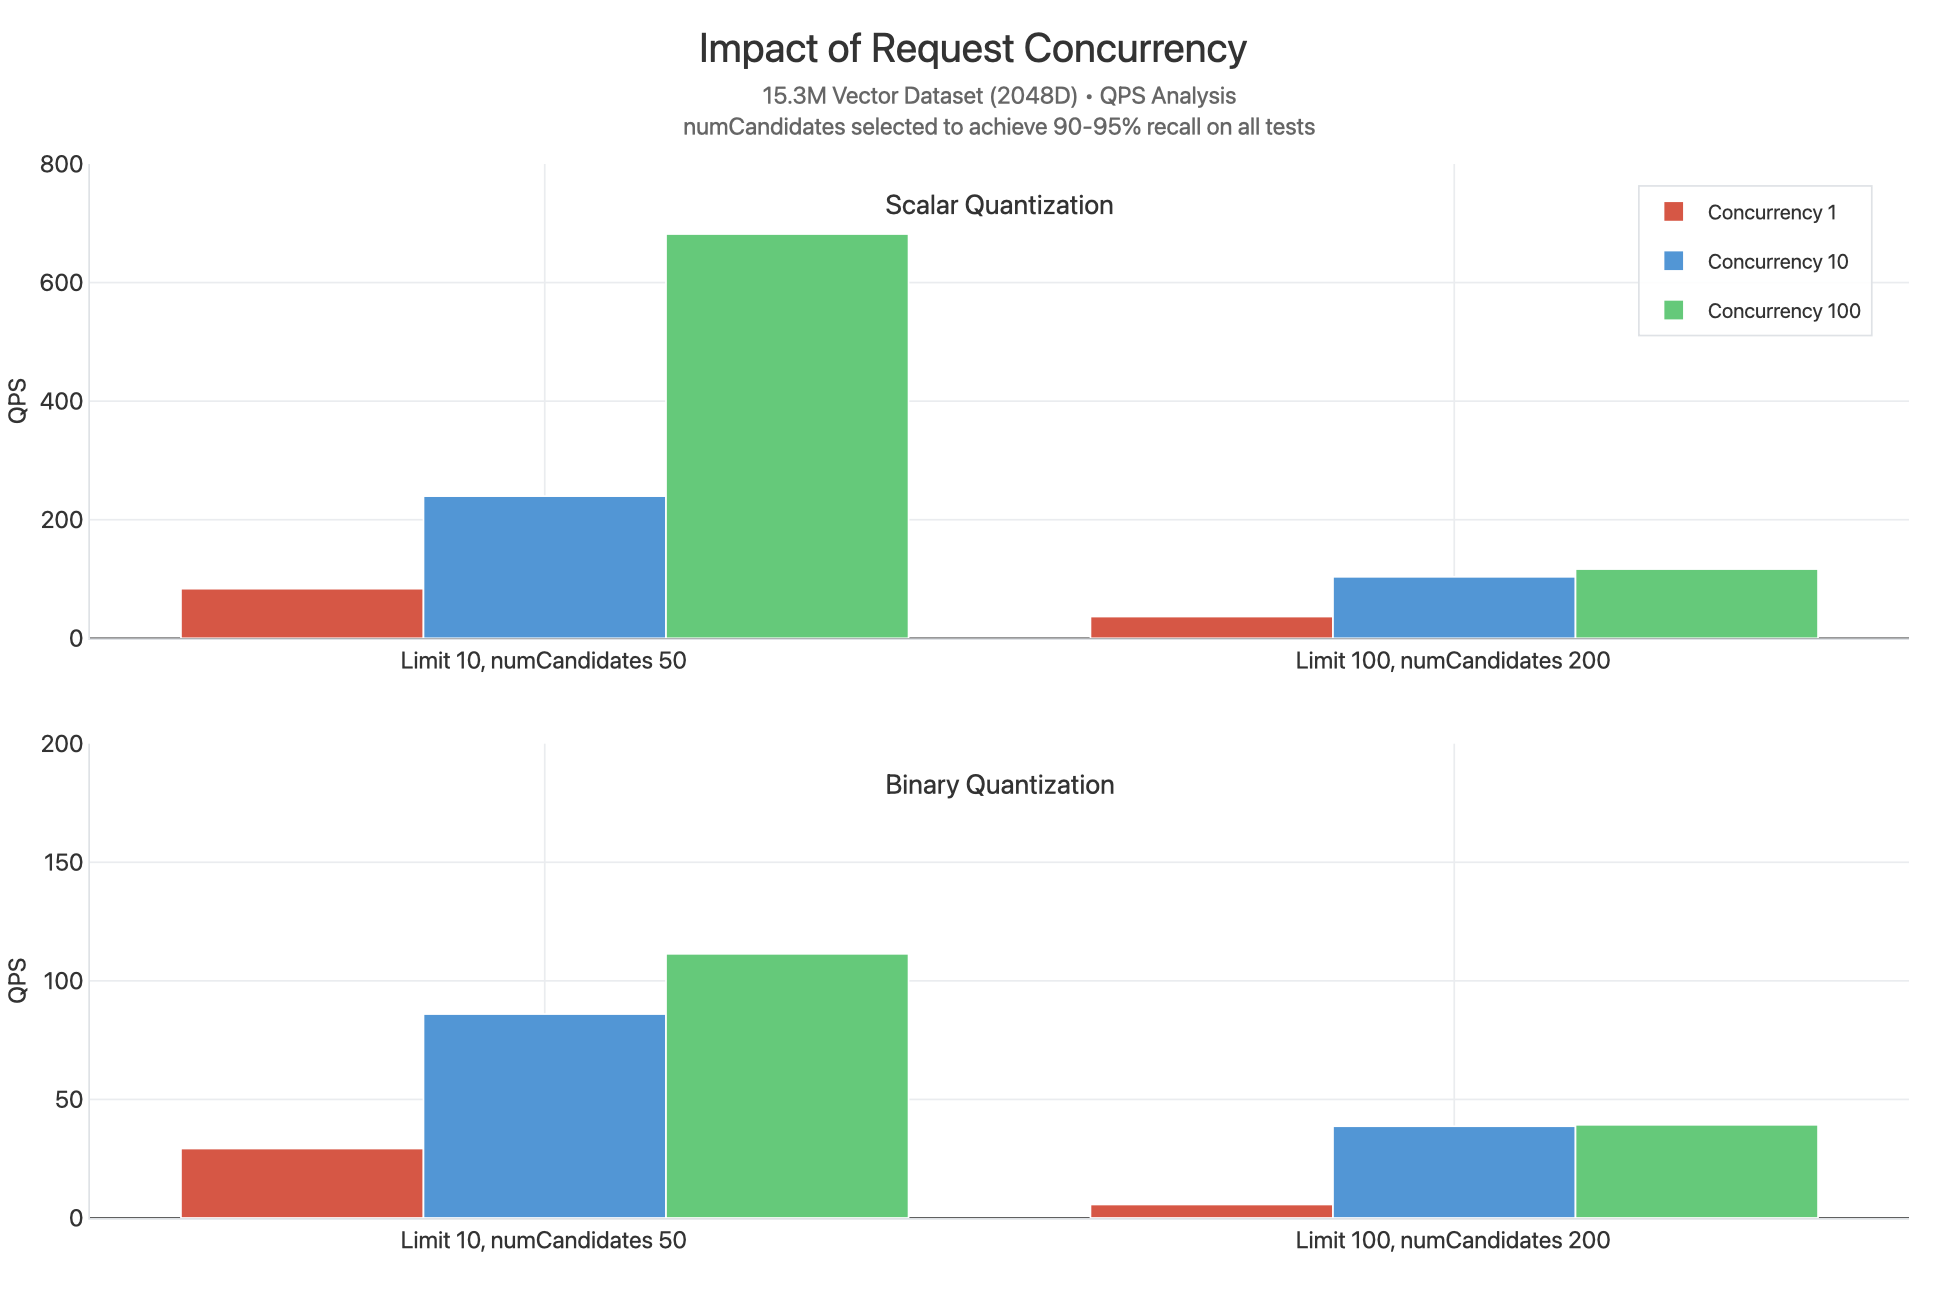
我们观察到,标量量化在 limit 的所有值下均实现了更高的 `QPS`,这可能是因为每个查询都可以在较低的 numCandidates 下完成,并且无需重新评分。在更高的并发性下,并发性 10 和并发性 100 的 QPS 曲线相互非常接近,这表明系统正在有效利用可用的 CPU 资源,并且额外的并发性主要影响延迟。
一个特殊的数据点是极限 10,并发 100 的标量量化产生显著更高的 QPS。这可能是因为没有重新评分,较低的 limit 值意味着对此查询执行的比较较少,从而允许每个请求更快地返回,并使内核可用于为其他查询提供服务。
通过扩展搜索节点层级或扩展搜索节点数量,从最小 2 个节点扩展到 32 个节点,增加可用 vCPU 的数量来提供服务请求,可能有助于解决并发瓶颈,并使 QPS 规模达到数千。
分片
我们还观察了当集群和集合基于 _id 进行分片,并且对二进制量化索引执行无过滤查询时会出现的情况。
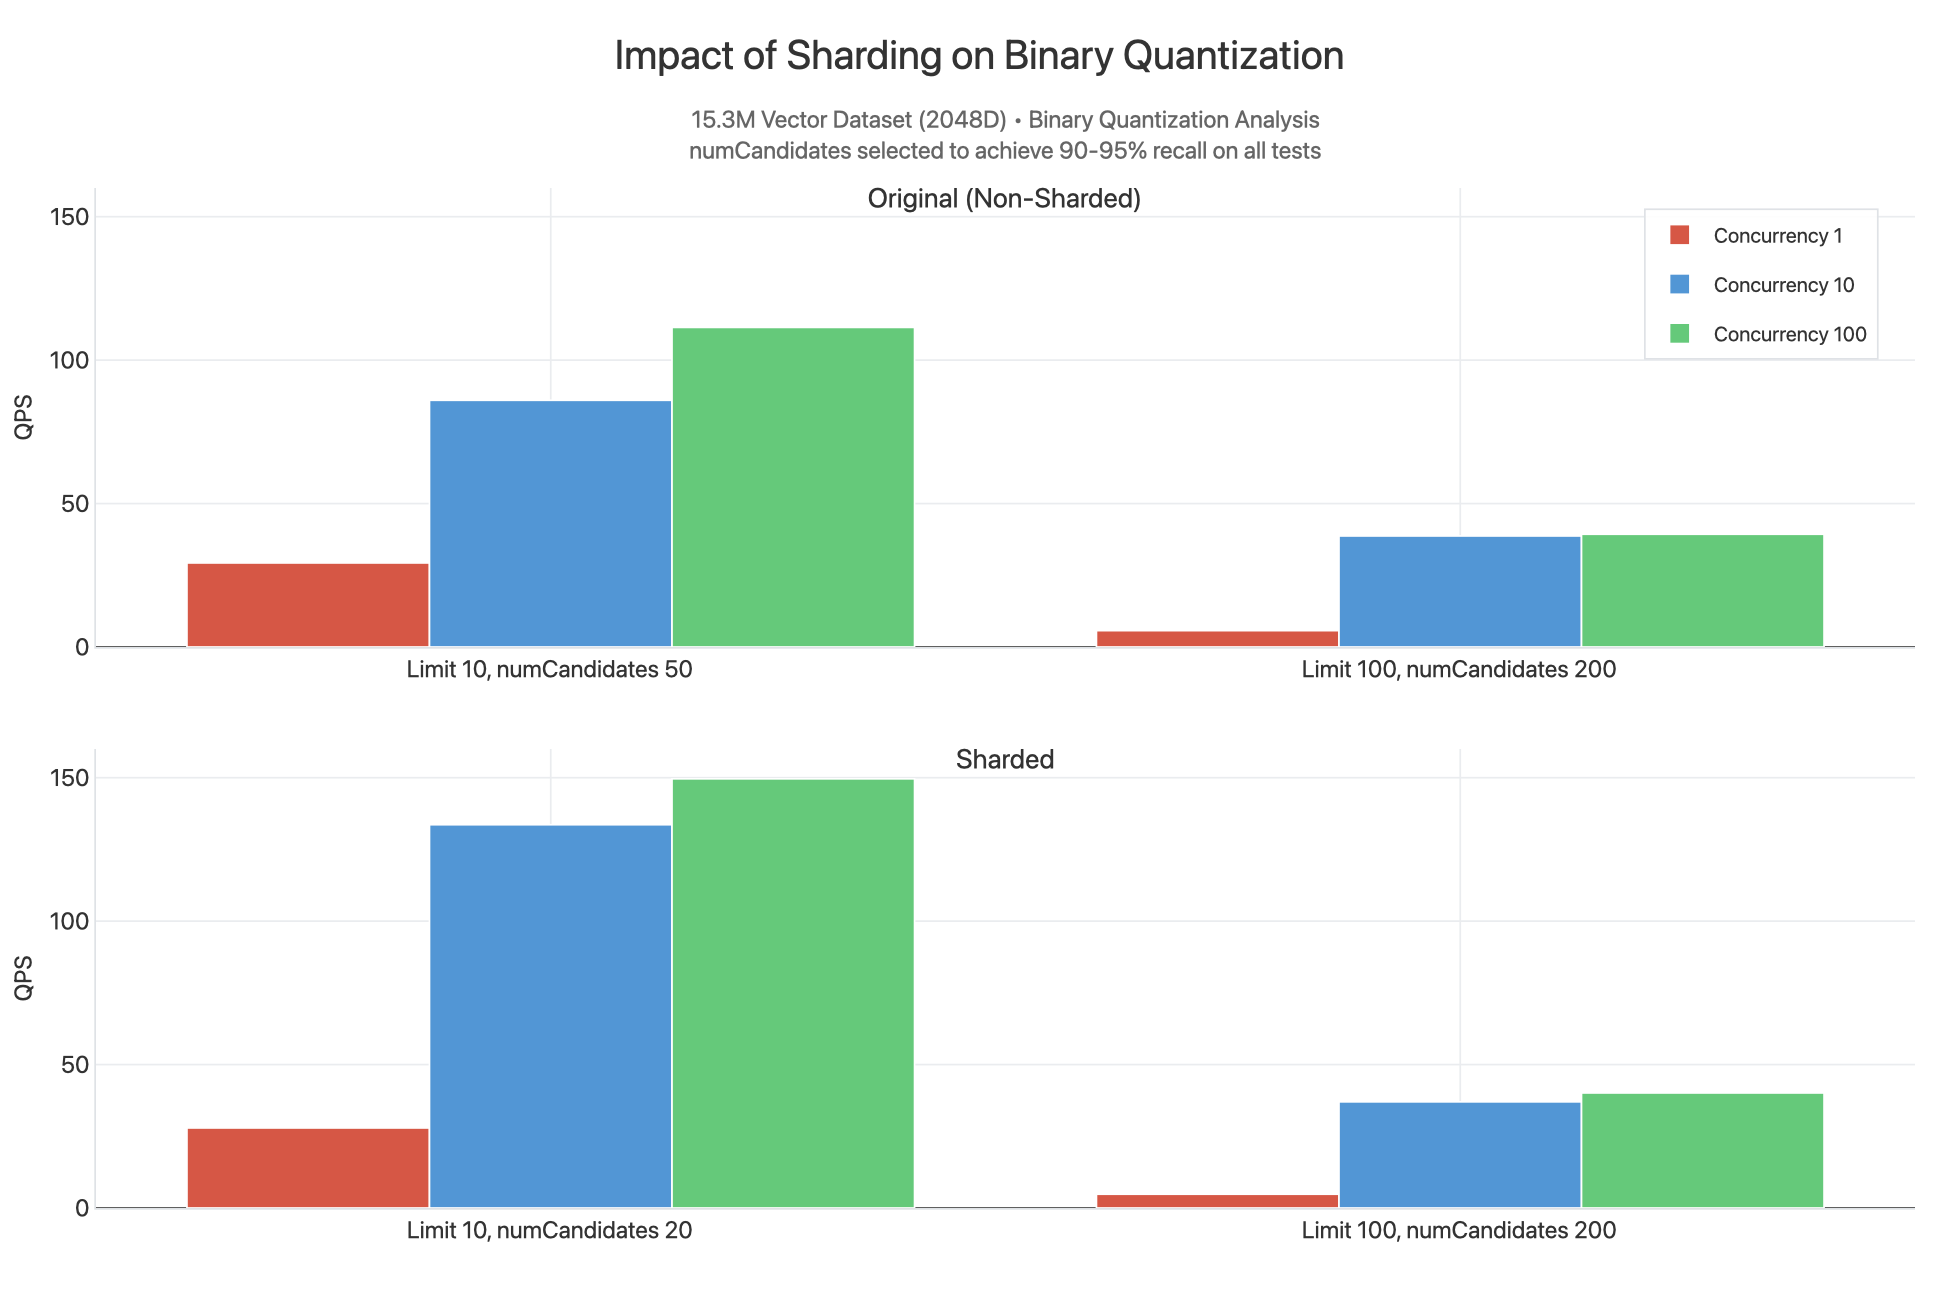
这里,我们看到分片结果在极限值 10 时具有更高的 QPS,因为 numCandidates 的较低值可以产生 90- 95 % 召回率范围内的结果。这是因为 15.3M 数据集被分割成三个分片,每个分片都有自己的索引,这些索引中的 5.1M 向量分布在包含 HNSW 图表的各个片段中。从功能上讲,我们正在进行一个不太高级的搜索,其中更有可能的是,分散在 3 个分片上的每个查询同时可以找到最接近的 n 个向量。因此,分片后的 QPS 会稍高一些,因为可以减少 numCandidates,让更多的内核为查询提供服务,但差异并不明显。由于向量搜索性能保持可靠,您无需对集群进行分片即可扩展其吞吐量。
注意
当 limit 为 100、numCandidates 为 200 时,数值相近。我们可能希望使用智能分片键匹配作为过滤器,来处理过滤查询,从而获得更好的性能。