Range-based sharding involves dividing data into contiguous ranges determined by the shard key values. In this model, documents with "close" shard key values are likely to be in the same chunk or shard. This allows for efficient queries where reads target documents within a contiguous range. However, both read and write performance may decrease with poor shard key selection. See Shard Key Selection.

如果没有配置其他选项(例如哈希分片或区域所需的选项),则默认分片方法是基于范围的分片。
分片键选择
当分片键显示以下特征时,范围分片最有效:
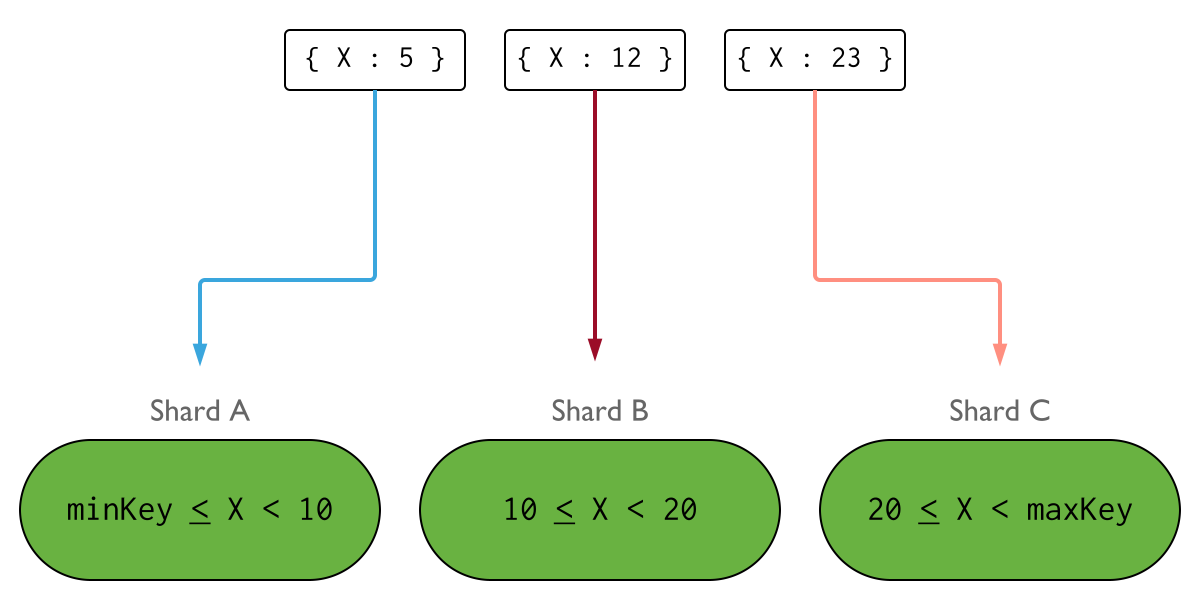
下图演示了使用字段 X 作为分片键的分片集群。如果 X 的值范围较大、频率较低且以非单调速率变化,则插入操作的分布可能会如下所示:
将集合分片
使用 sh.shardCollection() 方法,指定集合的全名空间以及用作分片键的目标索引或复合索引。
sh.shardCollection( "database.collection", { <shard key> } )
对填充的集合进行分片
如果对已填充的集合分片,最初只会创建一个数据段。然后负载均衡器会根据配置的范围大小,在必要时迁移该数据段中的范围。
对空集合进行分片
如果您对空集合分片:
没有为空集合或不存在的集合指定区域和区域范围:
分片操作创建一个空数据段来覆盖分片键值的整个范围。
创建初始数据段后,负载均衡器会根据需要在分片之间迁移初始数据段,并管理未来的数据段分配。
为空集合或不存在的集合指定了区域和区域范围:
分片操作为定义的区域范围创建空数据段以及任何附加数据段以覆盖分片键值的整个范围,并根据区域范围执行初始数据段分发。数据段的初始创建和分发可以更快地设置区域分片。
在初始分布之后,负载均衡器将管理未来的数据段分布。
提示
要学习;了解如何部署分片分片集群和实现范围分片,请参阅部署自管理分片集群。