此参考架构介绍了如何使用 Temporal 在 MongoDB Atlas 上构建持久性 AI 工作流,以实现事件驱动式摄取、语义检索和代理执行。
它支持需要检索增强生成 (RAG)和多步 AI 工作流的团队,以便在故障、重试和长时间运行的操作中继续可靠地运行。
该架构支持两种摄取模式。在事件流模式中,源更新在调用 Temporal 之前会流经 Kafka 和 Atlas Stream Processing。在直接模式中,源更新会立即 trigger Temporal 工作流。在这两种情况下,MongoDB Atlas 存储操作数据、语义知识和应用状态,而 Temporal 协调提取、分块、嵌入、索引和检索操作。
解决方案 1:通过 Kafka 和 Atlas Stream Processing 摄取
此模式适用于已经使用 Kafka 进行事件传输、变更传播或解耦系统集成的环境。Kafka 为大量或多种源更新提供标准入口层,而 Atlas Stream Processing 则在调用 Temporal 之前转换和路由事件。当吸收必须与工作流执行独立扩展时,或当团队除 AI 管道外还希望在多个下游消费者之间建立公共事件主干时,此分离很重要。内容更新来源于多种平台,例如 S3、API 或数据库或消息系统。
示意图
下图显示了此流程。
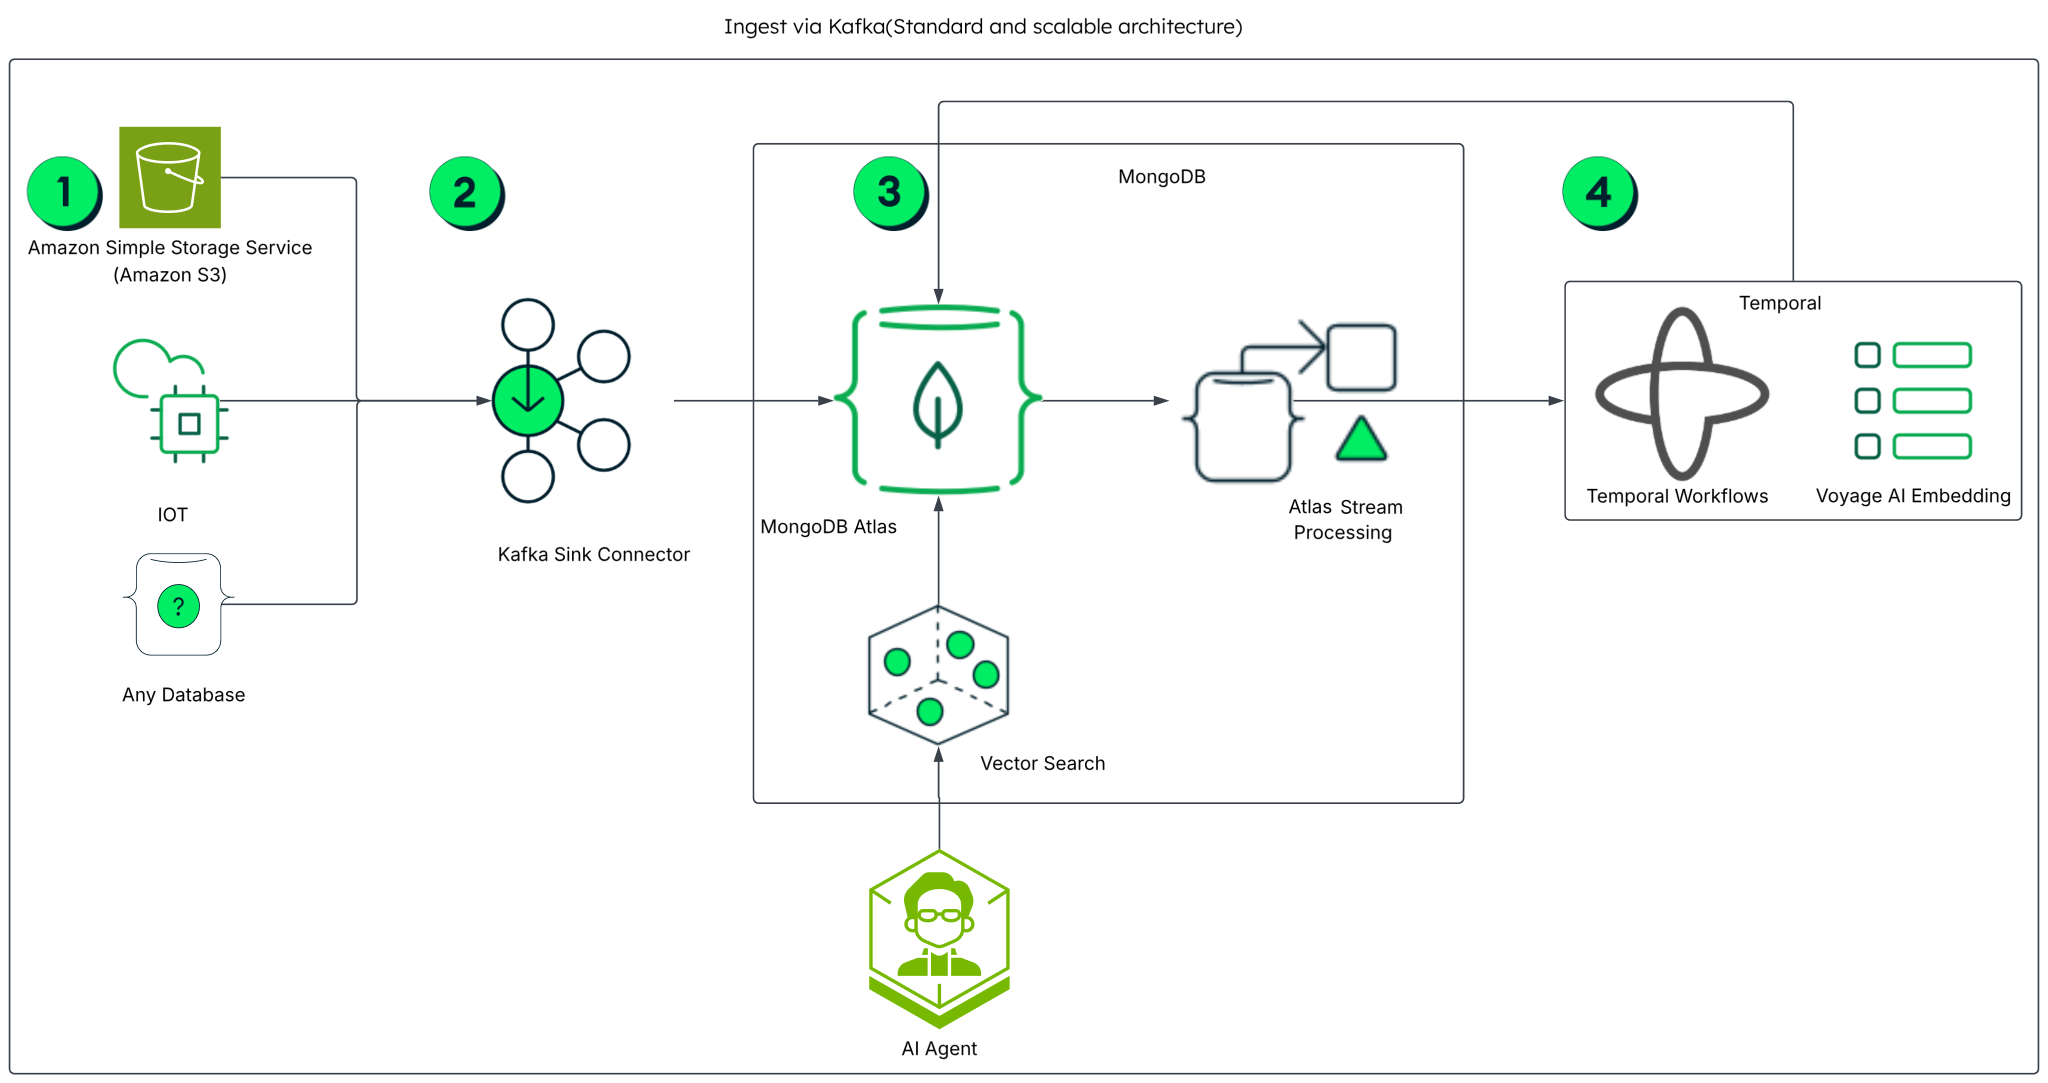
图 1。通过 Kafka 和 Atlas Stream Processing 摄取
数据流
以下步骤介绍此流程:
源系统产生或曝露内容
内容来源于 Amazon S3、IoT 平台和操作数据库等上游系统。这些系统提供管道处理的原始文档、记录或事件。当新内容或更新内容可用时,源系统会向 Kafka Sink Connector 发出事件,后者会将其写入 MongoDB
sources集合。Kafka Sink Connector
Kafka Sink Connector 是流媒体层与 MongoDB 之间的持久性消息交接。它从 Kafka 主题消费事件,并将其作为文档写入 MongoDB Atlas。此组件提供了 direct trigger 所没有的两个功能:它将多个不同的源扇入一个有序流,并对背压进行缓冲。
MongoDB(Atlas、Stream Processing 和向量搜索)
MongoDB 在此架构中扮演双重角色,出现在流程中的两个不同点。
MongoDB Atlas 是 Kafka Sink Connector 事件的登陆区域。Sink Connector 写入的原始源文档作为从外部世界到达的预发布环境记录存在于 Atlas 中。
Atlas Stream Processing 充当该登陆区域和 Temporal 之间的 trigger。它通过变更流监视入境文档,并启动下游工作流。这将 MongoDB 从被动存储转变为主动事件源,无需进行轮询,并使向 Temporal 的交接从计划转变为事件驱动。
Atlas Vector Search 为代理提供服务读取路径,以原生聚合管道阶段的形式运行语义相似性搜索,无需单独的矢量数据库,也无需跨系统查询扩展。
MongoDB 出现在数据流的两侧:它接收原始事件并提供最终嵌入式向量。Atlas Stream Processing 连接二者。
时间和 Voyage AI 嵌入
Atlas Stream Processing 调用 Temporal,而不是 Temporal 直接接收事件。处理核心与解决方案 2 相同:时态工作流程提供持久性、可恢复的编排,而 Voyage AI嵌入在这些工作流程中作为可独立重试的活动运行。
在此解决方案中,Temporal 消耗 MongoDB 事件,而不是直接接收源事件。它只会接收来自 Atlas Stream Processing 的干净、规范的 trigger,无论该 trigger 是源于 S3、IoT 还是数据库。此阶段是双向的:Temporal 在处理完成后将嵌入的、已索引的数据块写回 MongoDB 知识集合。
解决方案 2:将数据源直接吸收到 Temporal
此模式适用于可以将可靠的对象、API 或应用程序事件直接发出到工作流 trigger 的系统。它减少了架构层并使内吸路径简单明了,同时保留了长时间运行的提取和嵌入步骤的可恢复性。由于工作流是使用源引用而不是原始内容触发的,下游管道保持源不可知,并且可以以最小的组织变更支持其他上游系统。
示意图
下图显示了此流程。
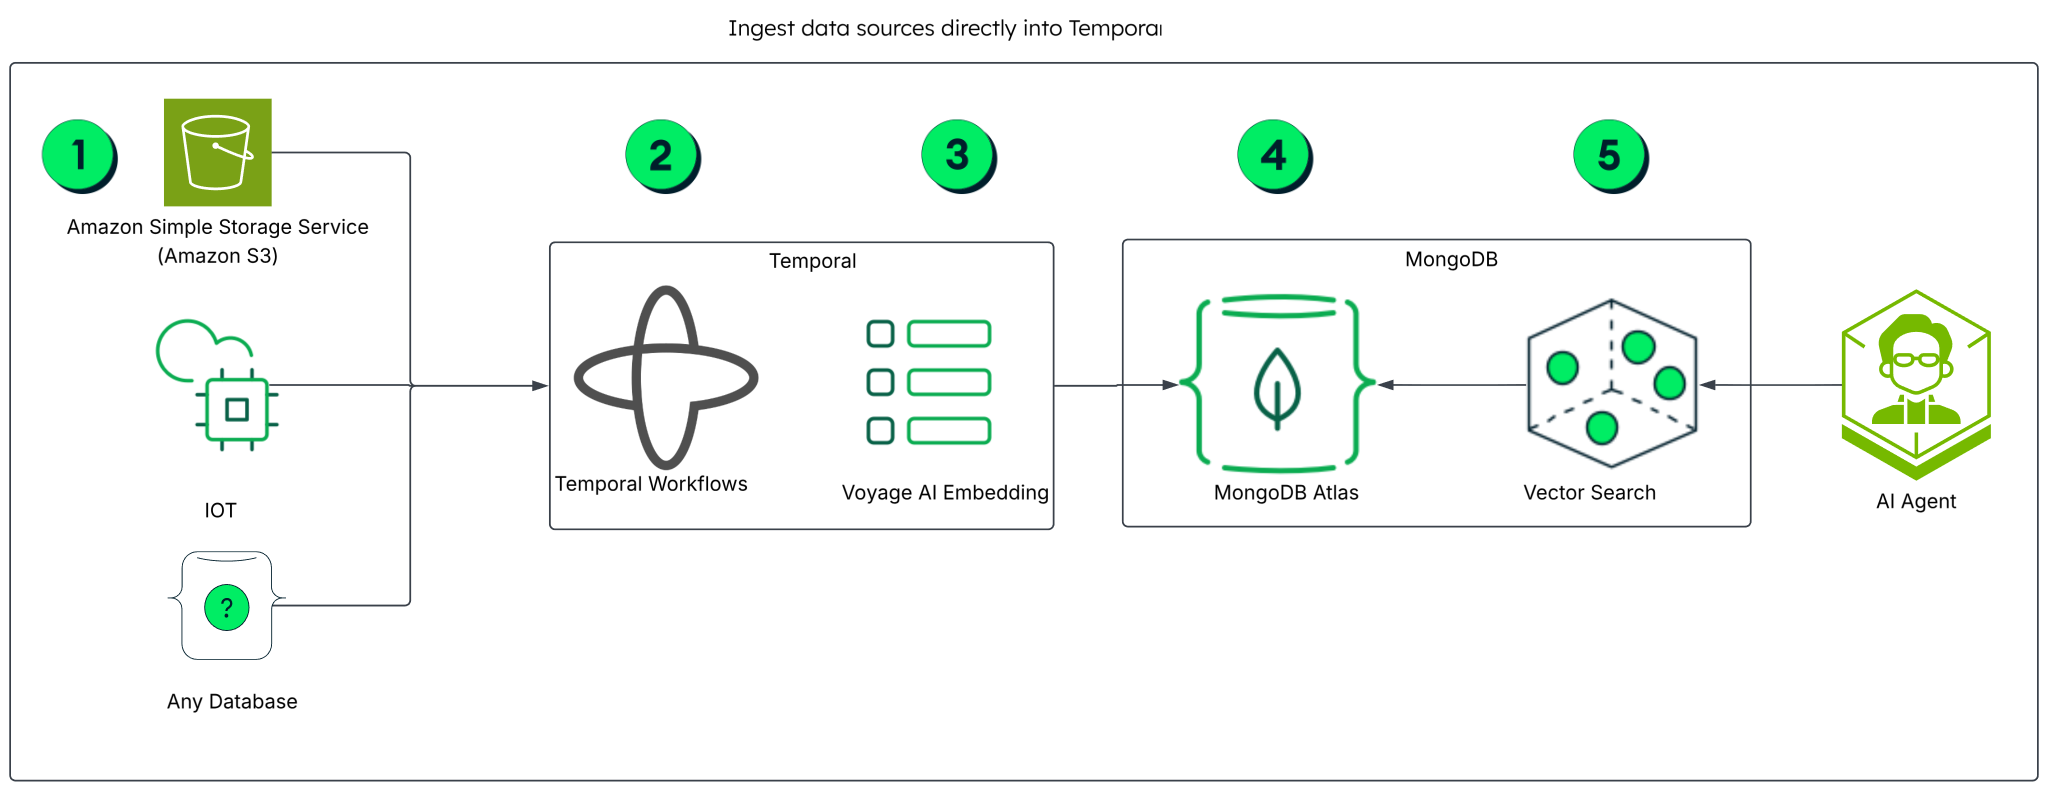
图 2。将数据源直接吸收到 Temporal
数据流
以下步骤介绍此流程:
源系统产生或曝露内容
内容来源于 Amazon S3、IoT 平台和操作数据库等上游系统。这些系统提供管道处理的原始文档、记录或事件。当新内容或更新内容可用时,源系统会向轻量级适配器发出事件,例如 Amazon Web Services Lambda、网络钩或连接器。适配器会启动 Temporal 工作流,并仅传递源引用和所需元数据。这可以将源特定逻辑保持在工作流之外,以便您可以添加新的源类型,而无需更改下游管道。
时间管理摄取生命周期
工作流开始后,Temporal 协调摄取步骤中的执行、重试和恢复。这使处理路径具有持久性,因此,长时间运行的操作可以在发生故障或重启时继续可靠地运行。工作流检索源内容并将其转换为下游 AI 处理的规范形式,在开始语义转换之前在源类型之间创建一致的表示。
Voyage AI 在工作流内生成嵌入
Voyage AI嵌入作为工作流程的一部分运行,而不是作为外部的即发即弃步骤运行。这样可以将可观察值和可恢复值嵌入同一执行路径中,并使语义转换与摄取生命周期紧密结合。
MongoDB Atlas 存储内容、元数据和嵌入
MongoDB Atlas 将处理后的内容、相关元数据和嵌入向量持久存储在单一平台中。这就创建了一个持久性知识层,可以支持内吸写入路径和下游检索路径。
Atlas Vector Search 使知识可检索
Atlas Vector Search 对嵌入内容进行索引,以便您可以按语义相似性对其进行查询。由于嵌入和操作元数据保留在同一平台中,因此以后的应用程序和代理请求检索相关上下文,而无需单独的向量存储或同步层。
代理请求流
此流程适用于两种摄取解决方案。它使用与摄取相同的持久性原则:架构不会将代理执行视为短暂的 API 请求,而是将检索和推理作为工作流驱动的操作运行,您可以观察、重试和恢复这些操作。当代理执行多次检索调用、调用外部工具或需要在最终结果之前返回逐步状态更新时,这很重要。
示意图
下图显示代理的组件。
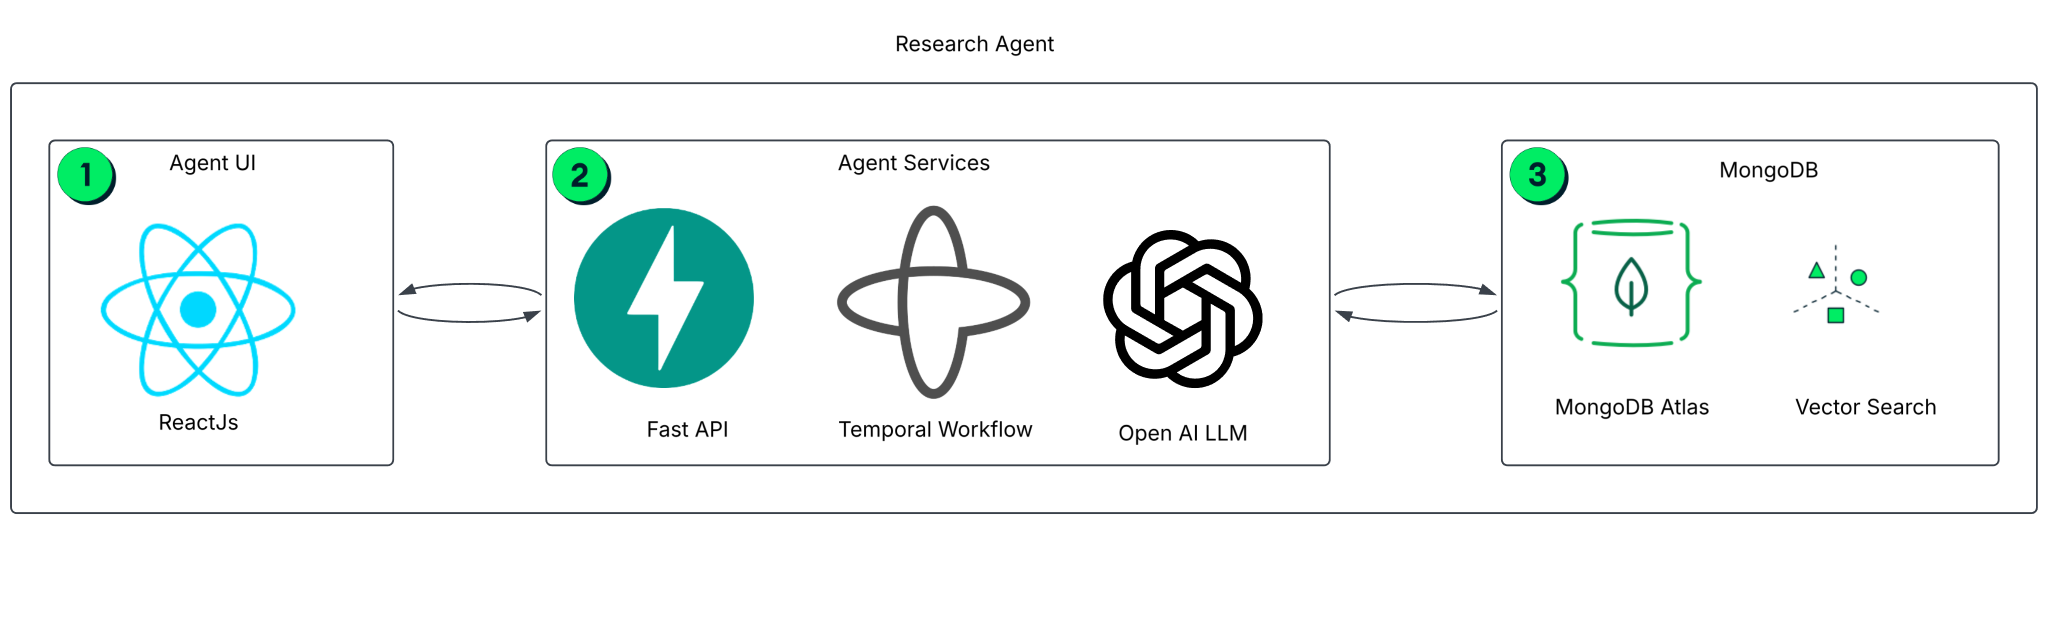
图 3。研究代理架构
数据流
以下步骤介绍此流程:
启动代理研究请求
当代理 API 通过用户界面接收用户查询时,它会启动持久性时间工作流。系统会立即返回工作流标识符,以便用户界面在研究代理检索上下文并推理回答时追踪进度。
从 MongoDB Atlas Vector Search 检索上下文
MongoDB Atlas 托管元数据、向量嵌入和语义索引。在用户交互过程中,代理嵌入查询并使用 MongoDB Atlas Vector Search 检索相关上下文,通常在最终合成之前应用重新排序层。有关索引和查询模式,请参阅 Atlas Vector Search 文档。
返回持久性研究结果
研究工作流程可协调工具执行、模型交互和最终综合。时态通过重试和状态持久性来维护进程,因此用户界面会提供经过验证的回答。有关持久性执行的更多信息,请参阅 Temporal 文档。
组件
以下组件实现了此架构。
MongoDB Atlas
使用 MongoDB Atlas 来存储内容摄取管道的分阶段和嵌入数据块、MongoDB Atlas 向量搜索索引以及代理的状态在单一数据库中。由于代理读取的数据与内容摄取管道写入的数据相同,因此没有独立的内存存储可以保持同步。
Atlas Stream Processing
使用 Atlas Stream Processing 在流媒体源和 Temporal 工作流之间提供可选的事件驱动集成路径。它处理入站事件的实时转换和路由,以实现高吞吐量架构。这使您可以实现近实时摄取,而无需 Kafka,前提是选择直接的源到 Temporal 连接。
Voyage AI
使用 Voyage AI 为此架构生成嵌入并执行结果重排名。由于嵌入和重排名与工作流协调分离,团队可以独立于摄取和检索管道升级模型。
Atlas Vector Search
使用 MongoDB Atlas Vector Search 通过语义索引检索文档上下文和代理内存。研究代理查询与主存储使用的 MongoDB Atlas 集群相同,因此检索使用当前操作数据。
时态
使用 Temporal 作为挑战性和代理工作流的持久性执行层,可在源系统、MongoDB Atlas 和外部 AI 服务中使用。它协调抽取、分块、嵌入和索引等长时间运行的步骤,并提供内置重试、检查点和恢复功能。这允许工作流在失败或中断后从上次成功状态恢复,而不是重新启动。通过使用持久性编排,Temporal 可帮助团队可靠地运行、回填和演进生产 AI 管道。
例外、注意事项和权衡
在采用此架构之前,请考虑直接和基于 Kafka 的摄取之间的权衡。直接的源到 Temporal 连接可操作的移动部件较少。基于 Kafka 的路径会添加消息中间件,这会引入额外的基础设施,但如果您的组织已经通过 Kafka 路由源更新,则该路径很合适。
实现和学习更多
有关部署指导和技术文档,请参阅 mdb-temporal-pra Github 存储库。