このリファレンスアーキテクチャは、イベント駆動型の取り込み、意味論的な取り出し、エージェントによる実行のために Temporal を使用して MongoDB Atlas 上で耐久性のある AI ワークフローをビルドする方法を説明します。
これは、検索拡張生成 (RAG) と複数の手順の AI ワークフローが、障害、再試行、および長時間の操作を経ても確実に続行できるようにする㌨ために、チームをサポートします。
アーキテクチャは 2 つの取り込みパスワードなしをサポートします。イベントストリームパスワードなしの場合、ソースの更新は Kafka と Atlas Stream Processing を経由してから Temporal を呼び出します。直接パスワードなしの場合、ソースの更新は直ちに Temporal ワークフローをtriggerします。いずれの場合も、MongoDB Atlas は操作データ、意味的知識、およびアプリケーション状態を保存し、Temporal は抽出、チャンク、埋め込み、インデックスの作成、および取得操作を調整します。
ソリューション 1: Kafka および Atlas Stream Processing を介した取り込み
このパターンは、イベント転送、変更伝播、またはシステムの分離統合に Kafka を既に使用している環境に適しています。Kafka は、大量または多様なソースの更新の標準入力レイヤーを提供し、Atlas Stream Processing は Temporal を呼び出す前にイベントを変換してルーティングします。この分離は、インジェストをワークフロー実行から独立して増やす必要がある場合、またはチームが AI パイプラインに加えて複数のダウンストリームコンシューマー間で共通のイベントバックボーンを必要とする場合に重要になります。コンテンツの更新は、S3、API、データベース、またはメッセージングシステムなどの様々なプラットフォームから発生します。
図
次の図はこのフローを示しています。
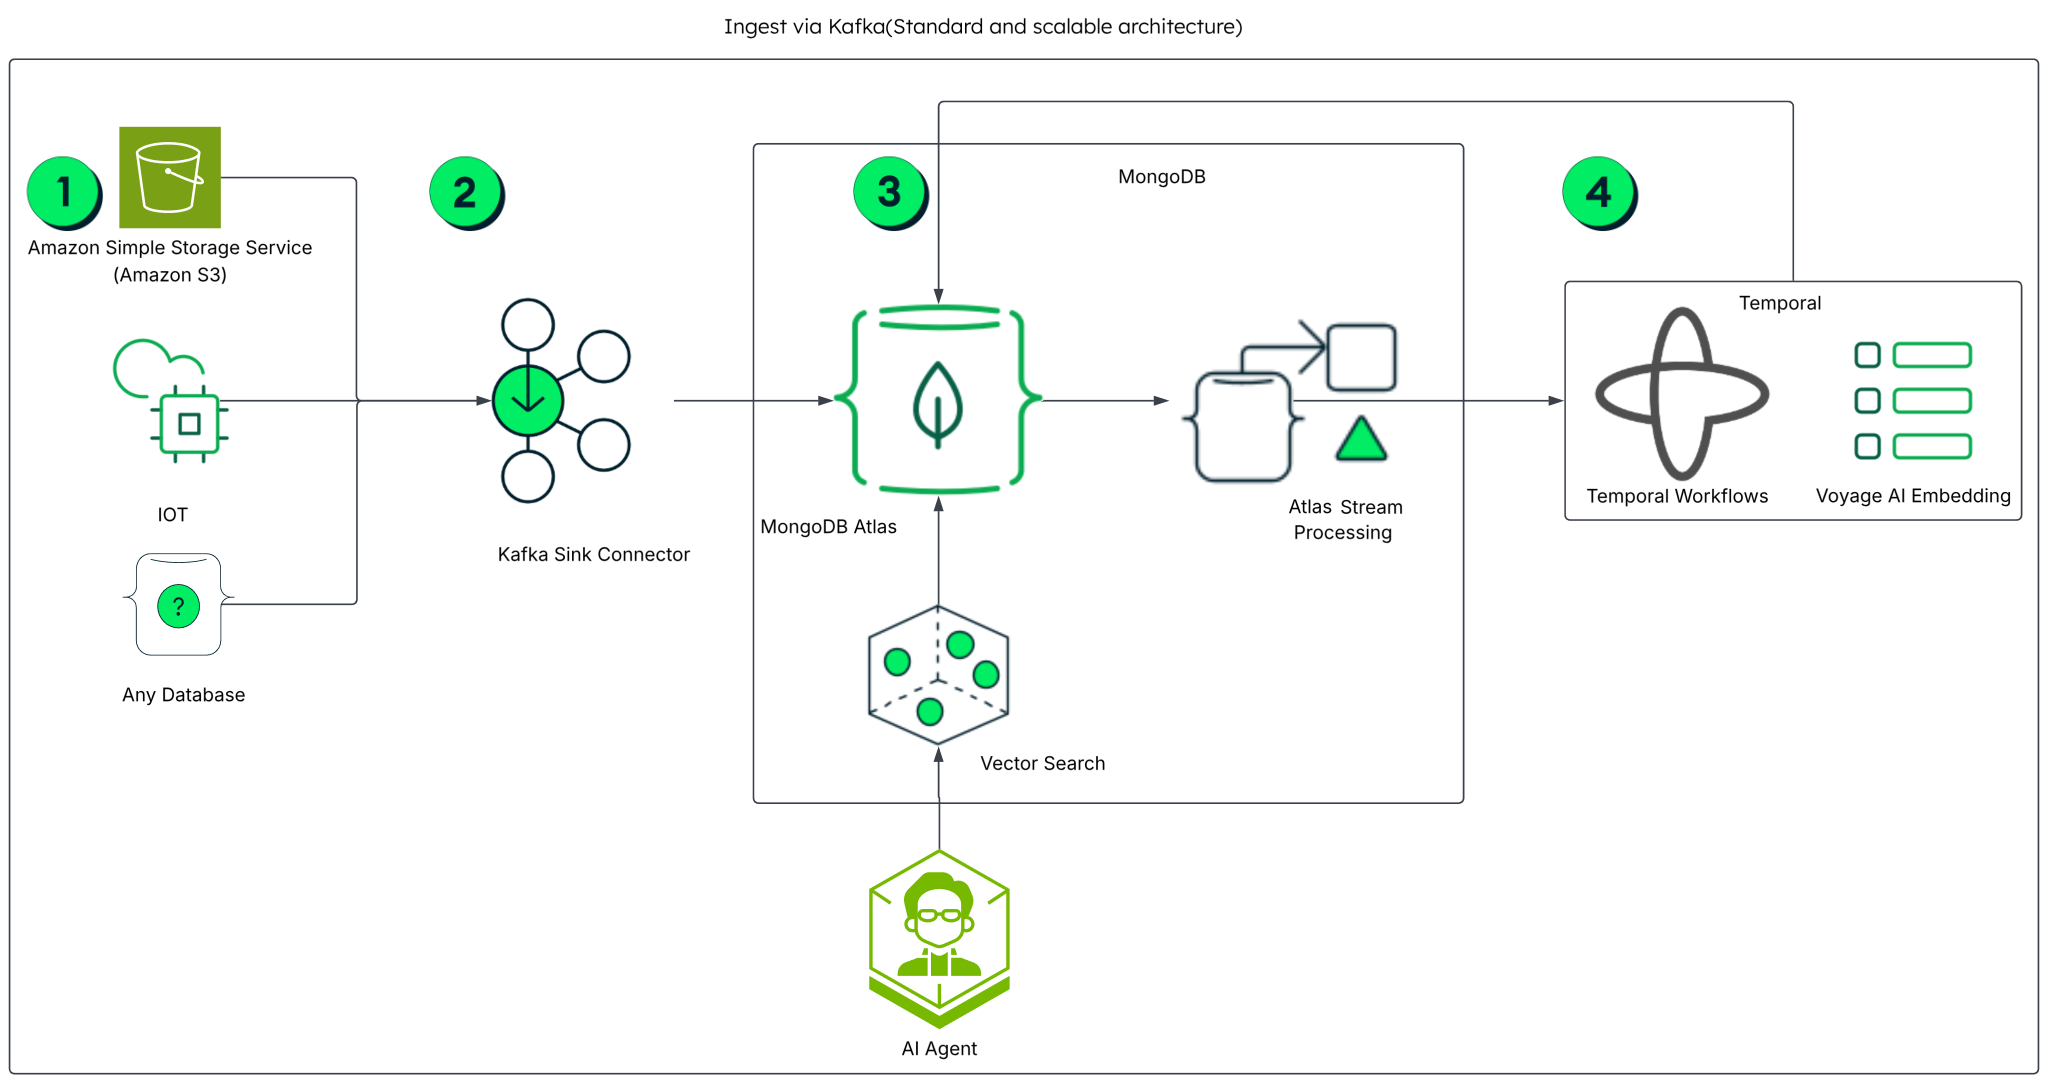
図 1Kafka と Atlas Stream Processing を介して取り込みます
データフロー
次の手順でこのフローを説明します。
ソース システムはコンテンツを生成または公開します
コンテンツは、Amazon S3、IoT プラットフォーム、および操作データベースなどのアップストリームシステムから発生します。これらのシステムは、パイプラインが処理する生のドキュメント、レコード、またはイベントを提供します。新しいコンテンツまたは更新されたコンテンツが利用可能になると、ソースシステムはイベントを Kafka Sink Connector に発行し、それが MongoDB
sourcesコレクションに書き込みます。Kafka Sink Connector
Kafka Sink Connector は、ストリーミングレイヤーと MongoDB の間の耐久性があるメッセージの引き渡しです。Kafka トピックからイベントを消費し、ドキュメントとして MongoDB Atlas に書き込みます。このコンポーネントは、直接の trigger では得られない 2 つの機能を提供します。つまり、複数の様々なソースを 1 つの順序付きストリームにファンインし、バックプレッシャーに対するバッファとなります。
MongoDB (Atlas, Stream Processing, および ベクトル検索)
MongoDB はこのアーキテクチャでは、フローの 2 つの異なる点に表示されるという、二重のロールを果たします。
MongoDB Atlas は、Kafka Sink Connector イベントのランディング ゾーンです。Sink Connector が書き込み (write) 生のソース ドキュメントは、外部から到着したもののステージング環境レコードとして Atlas に存在します。
Atlas Stream Processing は、このランディングゾーンと Temporal の間で trigger として機能します。変更ストリームを通じて受信ドキュメントを監視し、ダウンストリームのワークフローを開始します。これにより、MongoDB は受動的な保存先から能動的なイベントソースに変わり、ポーリングループの必要がなくなり、Temporal への引き継ぎがスケジュールではなくイベント駆動型になります。
Atlas Vector Search は、エージェントの読み取りパスとして機能し、ネイティブの集計パイプライン ステージとしてセマンティック類似検索を実行します。個別のベクトルデータベースやクロスシステムクエリのファンアウトはありません。
MongoDB はデータ フローの両側に表示されます。つまり、生のイベントを受信し、最終的な埋め込みベクトルを提供します。Atlas Stream Processing はこの 2 つを接続します。
Temporal と Voyage AI 埋め込み
Atlas Stream Processing は、Temporal がイベントを直接受け取るのではなく、Temporal を呼び出します。プロセシングコアは、ソリューション 2 と同じです。Temporal ワークフローは耐久性のある再開可能なオーケストレーションを提供し、Voyage AI 埋め込みはこれらのワークフロー内で独立して再試行可能なアクティビティとして実行されます。
このソリューションでは、Temporal はソース イベントを直接受信するのではなく、MongoDB イベントを消費します。この trigger が S3、IoT、またはデータベースのどこから発生したかにかかわらず、Atlas Stream Processing からのクリーンで正規化された trigger のみを受信します。このステージは両方向です。プロセシングが完了すると、Temporal は埋め込まれたインデックス付きのチャンクを MongoDB 知識コレクションに書き戻します。
ソリューション 2: データソースを Temporal に直接取り込む
このパスワードなしは、信頼性の高いオブジェクト、API、またはアプリケーション イベントをワークフローの trigger に直接出力できるシステムに適しています。これにより、アーキテクチャのレイヤーが減少され、取り込みパスが簡単になります。その一方で、長時間にわたる抽出と埋め込みの手順の再開可能性は維持されます。ワークフローは生のコンテンツではなく、ソース参照でトリガーされるため、ダウンストリーム パイプラインはソースに依存せず、最小限のオーケストレーション変更で追加のアップストリーム システムをサポートできます。
図
次の図はこのフローを示しています。

図 2データソースを時間に直接取り込みます
データフロー
次の手順でこのフローを説明します。
ソース システムはコンテンツを生成または公開します
コンテンツは、Amazon S3、IoT プラットフォーム、および操作データベースなどのアップストリームシステムから発生します。これらのシステムは、パイプラインが処理する生のドキュメント、レコード、またはイベントを提供します。新しいコンテンツまたは更新されたコンテンツが利用可能になると、ソース システムは Amazon Web Services Lambda、ウェブフック、またはコネクタのような軽量アダプターにイベントを発行します。アダプターは Temporal ワークフローを開始し、ソース参照と必要なメタデータのみを渡します。これにより、ソース固有のロジックがワークフローの外に保持されるため、ダウンストリーム パイプラインを変更することなく新しいソース タイプを追加できます。
Temporal は取り込みライフサイクルを管理します
ワークフローが開始すると、Temporal は取り込みステップ間での実行、再試行、および復旧を調整します。これによりプロセシングパスの耐久性が高まり、障害や再起動が発生しても長時間実行される操作が確実に続行されるようになります。ワークフローはソース コンテンツを取得し、ダウンストリーム AI プロセシング用に正規化された形式に変換し、意味的な変換が開始される前にソース タイプ間でコンシステントな表現を作成します。
Voyage AI はワークフロー内で埋め込みを生成します
Voyage AI 埋め込みは、外部のファイアアンドフォゲット ステップとしてではなく、ワークフローの一部として実行されます。これにより、埋め込みは同じ実行パス内で観測可能で復元可能になり、意味変換は取り込みライフサイクルに密接に結び付けられます。
MongoDB Atlas は、コンテンツ、メタデータ、および埋め込みを保存 (する)
MongoDB Atlas は、処理されたコンテンツ、関連するメタデータ、および埋め込みベクトルを 1 つのプラットフォームに持続します。これにより、取り込み書き込みパスとダウンストリーム取得パスの両方をサポートする耐久性のある知識レイヤーが作成されます。
Atlas Vector Search により知識を取得できるようになります
Atlas Vector Search は埋め込みコンテンツにインデックスを付けることで、意味的類似性によってクエリできます。埋め込みと操作メタデータは同じプラットフォーム内に残るため、後続のアプリケーションとエージェントのリクエストでは、別のベクトルストアや同期レイヤーを使用せずに関連するコンテキストを検索できます。
エージェントのリクエストフロー
このフローは両方の取り込みソリューションに適用されます。取り込みと同じ持続性の原則を使用します。エージェントの実行を短命の API リクエストとして扱うのではなく、アーキテクチャはワークフローに基づいた操作として取得と推理を実行します。これらの操作は監視、再試行、再開できます。これは、エージェントが複数の取得呼び出しを実行したり、外部ツールを呼び出したり、最終結果の前に進行状況の更新を返す必要がある場合に重要になります。
図
次の図はエージェントのコンポーネントを示しています。
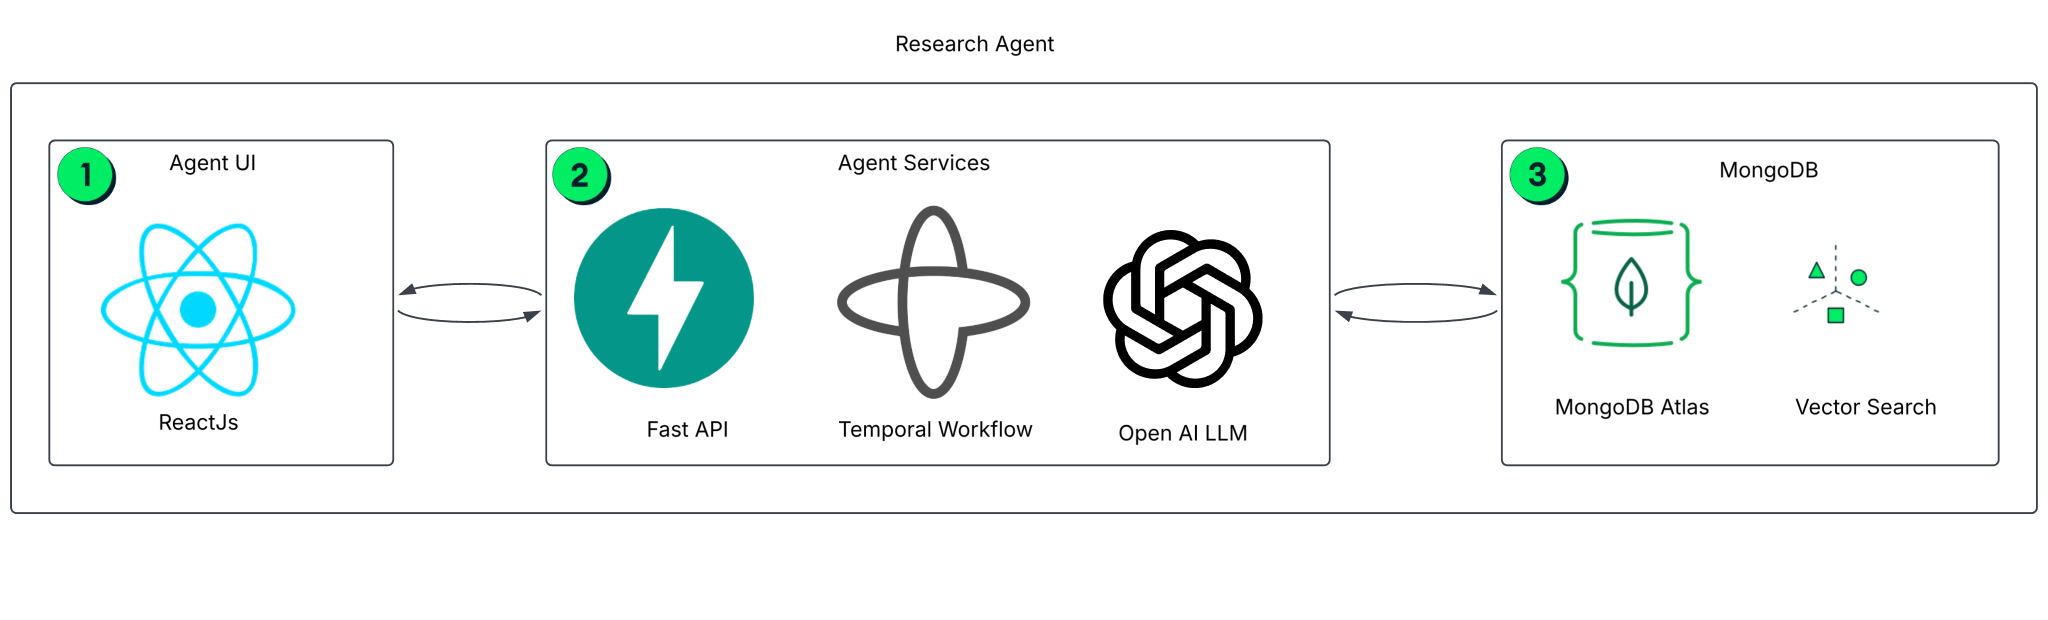
図 3リサーチエージェントアーキテクチャ
データフロー
次の手順でこのフローを説明します。
エージェントのリサーチ リクエストを開始する
エージェント API は、UI を通じてユーザー クエリを受信すると、耐久性がある Temporal ワークフローを開始します。システムはワークフロー識別子を直ちに返すため、研究エージェントがコンテキストを検索する、答える、UI は進捗状況を追跡する。
MongoDB Atlas Vector Search からコンテキストを検索する
MongoDB Atlas は、メタデータ、ベクトル埋め込み、および意味インデックスをホストします。ユーザーの操作中、エージェントはクエリを埋め込み、MongoDB Atlas Vector Search を使用して関連するコンテキストを検索します。この際、最終的な合成の前にリランキングレイヤーを適用することが多くあります。インデックスの作成とクエリのパターンについては、Atlas Vector Search ドキュメントを参照してください。
耐久性のある研究結果を返す
研究ワークフローでは、ツール実行、モデルの相互作用、最終的な合成が調整されます。Temporal は、再試行と状態の永続化によってプロセスを維持するため、UI は検証済みの回答を提供します。耐久性のある実行の詳細については、Temporal ドキュメントを参照してください。
コンポーネント
次のコンポーネントはこのアーキテクチャを実装します。
MongoDB Atlas
MongoDB Atlas を使用して、取り込みパイプラインのステージングされたチャンクと埋め込まれたチャンク、MongoDB Atlas Vector Search インデックス、およびエージェントの状態を 1 つのデータベースに保存します。エージェントは取り込みパイプラインが書き込むのと同じデータを読み取るため、同期を維持する別のメモリストアはありません。
Atlas Stream Processing
Atlas Stream Processing を使用して、ストリーミングソースと Temporal ワークフローの間に任意のイベント駆動型統合パスを提供します。スループットの高いアーキテクチャの受信イベントのリアルタイム変換とルーティングを取り扱います。これにより、カフカを必要とせずに、にほぼリアルタイムでの取り込みを実装できます。これは、ソースから Temporal への直接接続を選択した場合です。
Voyage AI
このアーキテクチャでは、Voyage AI を使用して埋め込みを生成し、結果の再ランキングを実行します。埋め込みと再ランキングはワークフローのオーケストレーションとは別であるため、チームは取り込みパイプラインと取得パイプラインとは独立してモデルをアップグレードできます。
Atlas Vector Search
MongoDB Atlas Vector Search を使用して、意味インデックスの作成を通じてドキュメントのコンテキストとエージェントメモリを検索します。リサーチ エージェントは、プライマリ ストレージに使用されるのと同じ MongoDB Atlas クラスターをクエリするため、検索には現在の操作データが使用されます。
一時的な
Temporal を、ソース システム、MongoDB Atlas、外部 AI サービスにおける取り込みとエージェント㎎ークフローの耐久性実行レイヤーとして使用します。抽出、チャンク、埋め込み、インデックスの作成などの時間のかかる手順を調整し、組み込みの再試行、チェックポイント、復旧を提供します。これにより、ワークフローは失敗や中断後に再開始するのではなく、最後に成功した状態から再開できます。Temporal はオーケストレーションを耐久性のあるものにすることで、チームが本番 AI パイプラインを確実に操作、バックフィル、開発するのに役立ちます。
例外、注意事項、トレードオフ
このアーキテクチャを採用する前に、直接取り込みとKafkaベースの取り込みのトレードオフを考慮してください。ソースからTemporalへの直接接続は、操作する可動部分が少なくなります。Kafkaベースのパスにはメッセージブローカーが追加され、追加のインフラストラクチャが必要になりますが、組織で既にKafkaを介してソースの更新をルーティングしている場合は自然に適合します。
実装と詳細を学ぶ
配置のガイダンスと技術文書については、mdb-temporal-pra Github リポジトリを参照してください。