此参考架构介绍了如何在 MongoDB Atlas 上实现操作数据层 (ODL),以整合孤立的操作数据,并为下游操作型、分析型和 AI 工作负载提供服务。
ODL 是一种架构模式,可将现有记录系统中的数据集成并组织到集中且可查询的层中。它将现代应用程序和数据产品与旧版平台解耦,使企业无需完全替换这些系统,也能支持单一视图、数据即服务以及 AI/智能体 AI 用例等举措。MongoDB Atlas 为 ODL 提供核心数据平台,并在单一服务中将灵活的文档模型与事务型、搜索、分析和向量功能相结合。
ODL 实现级别
只读:作为高性能读取副本,用于分担源系统的查询负载,并基于操作数据公开稳定的 API。
丰富:将源数据与元数据和外部数据集相结合,为分析和 AI 提供情境视图,无需修改上游系统。
读写:作为业务工作流的一部分接受写入,以实现运营现代化,并逐步减少对旧版记录系统的依赖。
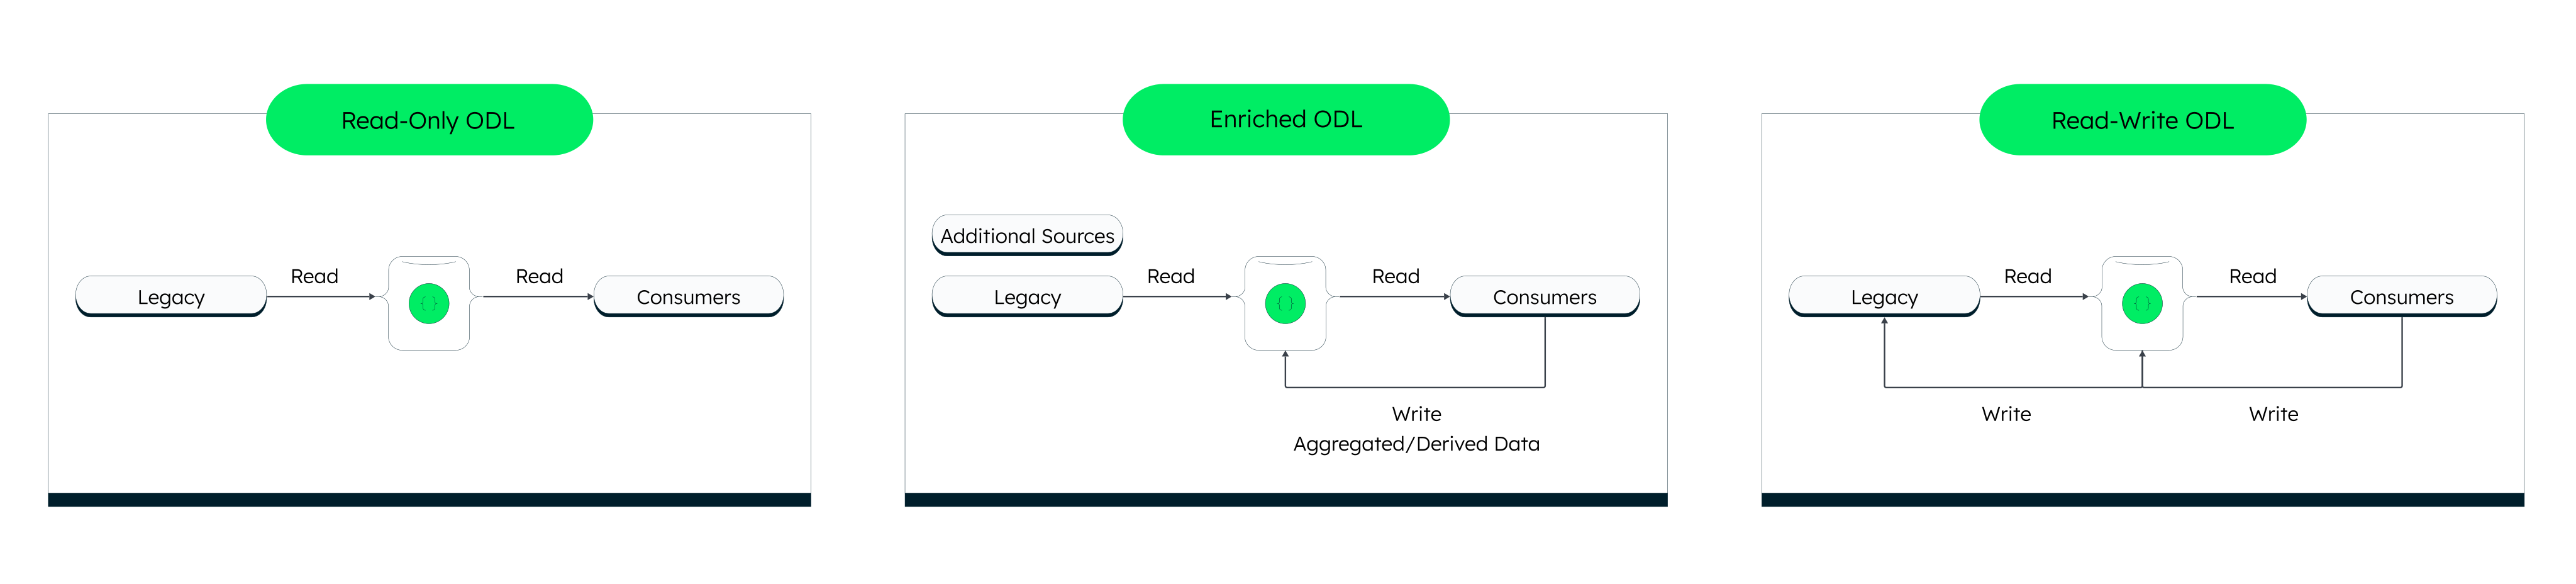
图 1. MongoDB 操作数据层的实现级别。
注意
下图展示了可实现操作数据层 (ODL) 的不同级别。它仅用于说明概念,并非此解决方案的参考架构。
示意图
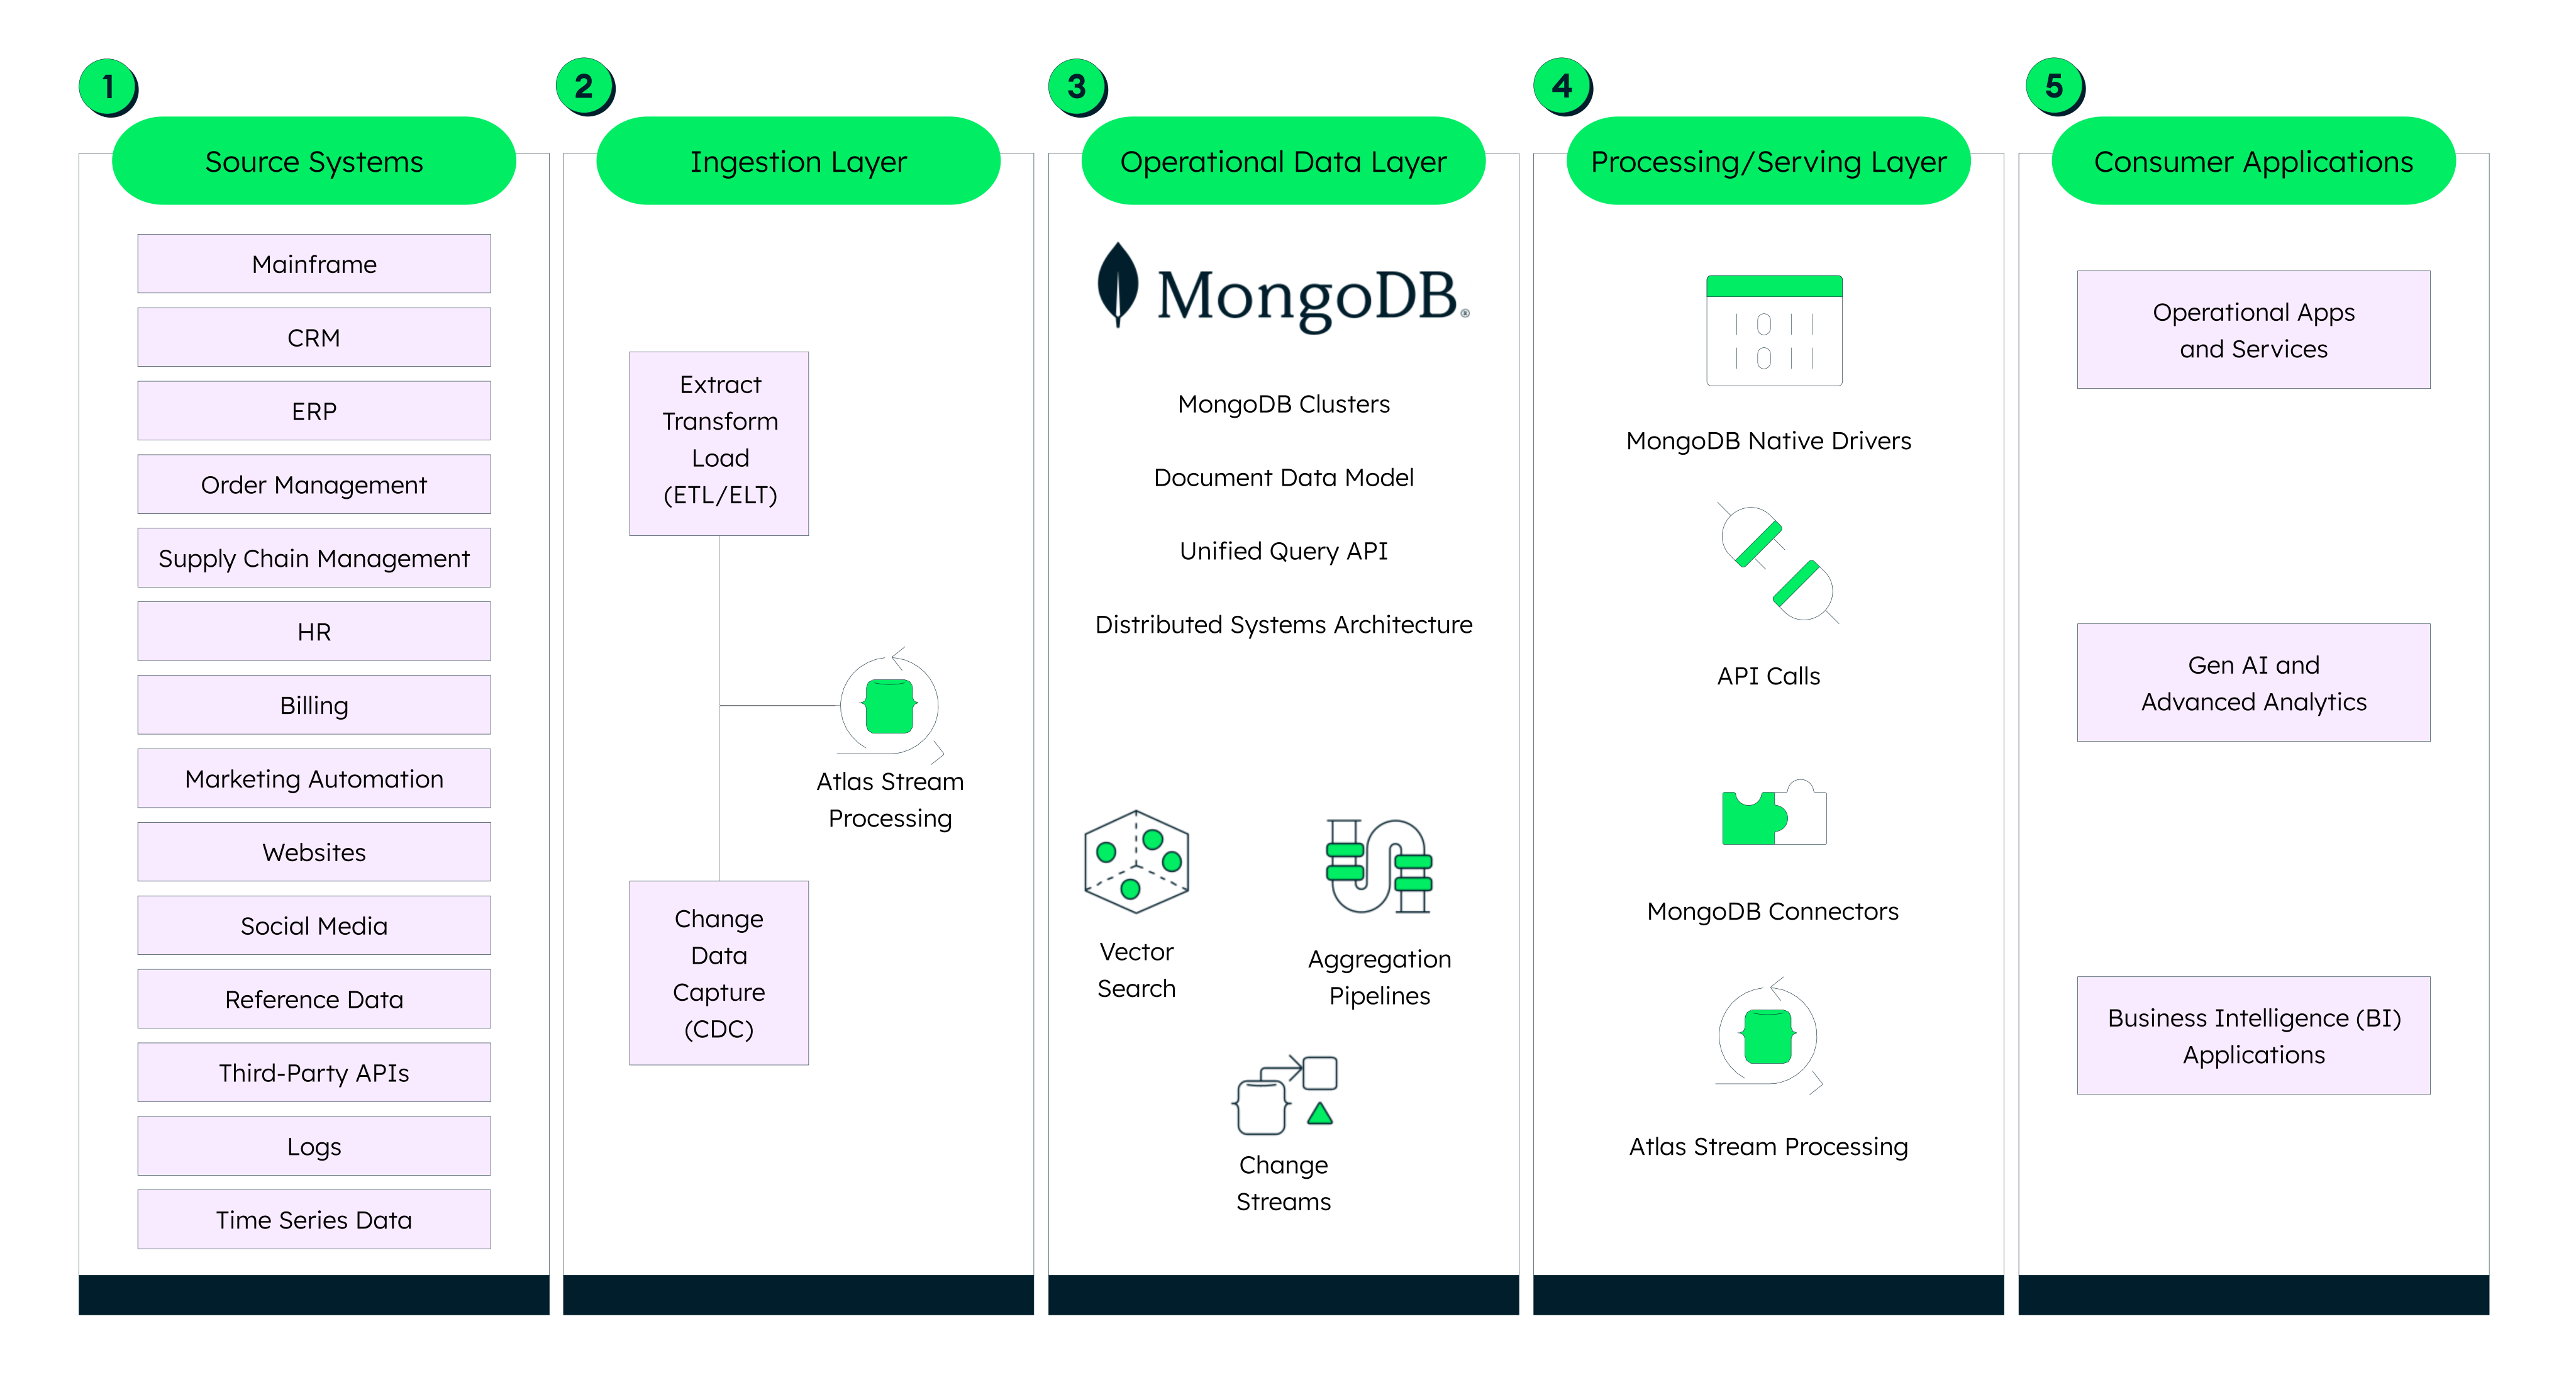
图 2. 操作数据层参考架构
数据流
源系统
企业应用程序、操作数据库、第三方 API 和旧版平台作为记录系统。它们会捕获业务事务和事件,您可以将这些数据同步到 ODL,以实现实时且上下文感知的访问。
- 常见源系统包括:大型机、CRM、ERP、订单管理、供应链管理、人力资源、计费、营销自动化、网站、社交媒体、参考数据、第三方 API、日志、时间序列数据等。
数据摄取层
通过批处理提取-转换-加载 (ETL)/提取-加载-转换 (ELT) 作业和实时流媒体或变更数据捕获 (CDC),数据从源系统移动到MongoDB Atlas 。使用 mongoimport、批量写入 API、ETL 平台、 MongoDB Kafka Connector和Atlas Stream Processing等工具,根据延迟和吞吐量要求加载、转换和路由事件。
操作数据层 (MongoDB Atlas)
MongoDB Atlas 集群将结构化、半结构化和非结构化数据整合到文档数据模型中,并支持混合工作负载:通过统一查询 API 进行事务处理、实时分析、全文搜索和向量搜索。ODL 在云端运行,并通过分片和副本集进行水平扩展。
处理/服务层
API网关位于边缘,负责管理身份验证、速率限制和外部访问权限。服务网格管理服务到服务的通信,数据代理层在应用连接池化、缓存和策略执行时根据工作负载类型路由查询。 MongoDB Change Streams和Atlas Stream Processing可以在不进行轮询的情况下向下游消费者发布数据更改。
使用方应用程序
运营应用程序、Gen AI和代理AI系统以及BI工具使用MongoDB原生驱动程序、 Atlas SQL和连接器连接到 ODL。它们受益于整合、受管控且近乎实时的企业数据视图,而无需直接依赖传统系统。
例外、注意事项和权衡
要在 MongoDB Atlas 上保持高性能 ODL,您必须在复杂性与架构目标之间取得平衡:
双写入协调(写入ODL):写入(“Y 加载”)ODL 会带来 ODL 和传统系统之间数据漂移的风险。使用消息平台或API网关以及事务发件箱和 saga 模型等模式来协调写入并定义明确的一致性ACID 一致性保证,而不是依赖分布式锁或 2PC(双阶段提交)。
工作负载隔离 — OLTP、在线分析处理 (OLAP) 和 AI:直接在主节点上运行分析或 AI 工作负载会降低事务性能。为避免这种情况,请使用支持
secondaryPreferred读取的副本集、分片集群以及专用的搜索和向量索引来隔离每种工作负载类型,确保在线事务处理 (OLTP)、分析和检索增强生成 (RAG)/AI 查询不会争用相同资源。延迟与摄取成本:ODL 可以支持低延迟查询,但数据时效性取决于数据摄取方式。批量 ETL/ELT、CDC 和实时流式传输(例如通过 MongoDB Kafka Connector 和 Atlas Stream Processing 实现)具有不同的运维和成本特征。请仅将始终开启的流式传输保留给真正需要近实时更新的用例。
模式演进和文档增长:MongoDB 灵活的 document model 支持快速模式演进,但仍然需要规范的设计。应用既定的模式设计模式和嵌入与引用指导,避免团队之间的文档臃肿、深度嵌套结构和不兼容的模式漂移,尤其是在高度丰富的 ODL 中。
ODL 的适用场景:ODL 适合用于统一分散的操作数据;它们并非旨在取代纯分析平台。虽然 ODL 并非旨在直接取代核心记录系统,但它可以作为多步迁移策略中的第一步,随着时间的推移最终取代旧版记录系统。
实现指南
设计数据摄取和建模
批量摄取:使用
mongoimport、批量写入 API、 Atlas Data Federation物化或 ETL 工具从源系统加载计划导出。ETL/ELT:使用MongoDB Spark Connector和编排工具提取数据,然后加载前转换 (ETL) 或将原始数据加载到Atlas并使用聚合管道 (ELT) 进行转换。
实时摄取:将MongoDB Kafka Connector和Atlas Stream Processing用于事件驱动的管道,捕获 CDC 流或主题事件,并以最小的延迟写入Atlas 。
设计访问层
实现一个围绕 ODL 的三层访问层:
服务网格:使用 Istio 或 Linkerd 等工具,通过双向 TLS、重试和跟踪来保护和观察服务到服务的流量。
数据代理层:集中管理连接,并根据工作负载类型将查询路由到 MongoDB Atlas,同时在靠近数据的位置应用连接池、缓存和策略强制执行。
配置查询路由
OLTP:将事务读取和写入路由到主节点,以保证核心业务流程的一致性和低延迟运行。
OLAP/BI:使用 secondaryPreferred 将分析和报告工作负载路由到从节点,并考虑对历史数据或冷数据使用 Atlas Data Federation 或物化视图,以避免影响操作型工作负载。
AI/RAG:使用MongoDB Vector Search 对与操作数据一起存储的嵌入进行语义和混合搜索,并通过聚合管道将结果与元数据相结合,为代理和法学硕士驱动的应用程序提供服务。
建立安全机制和数据信任
对传输中和静态数据进行加密:对所有外部接入点强制执行 TLS,并使用 Atlas 中的内置加密功能来满足数据保护要求。
管理身份和访问权限:实施 OpenID Connect (OIDC) 和 OAuth 2.0 等行业标准协议,以处理身份验证并颁发包含基于角色声明的标准化令牌(如 JSON Web Token)。利用解耦授权模式,在 API 和服务层实施细粒度、基于策略的访问控制,确保安全逻辑与应用程序代码分离。
集中管理密钥:虽然 OIDC 和 OAuth 2.0 处理用户和服务身份,但 ODL 仍依赖存在于令牌生命周期之外的凭证和密钥。这些包括数据库连接凭证、OAuth 客户端密钥、TLS 证书和加密密钥。使用专用的密钥管理解决方案(例如 Vault 服务、由 HSM 支持的密钥管理器或云提供商原生的密钥存储)来存储和轮换这些凭证和密钥,然后将其注入运行时,而不是嵌入配置文件。
Atlas 审核和治理:将 ODL 作为数据掩码、聚合及访问策略的统一执行点,让生产者和使用方保持解耦,同时确保治理在各业务域中一致应用。
了解详情
探索不同行业如何实施 ODL:
金融服务:基于AI的 Agentic 投资组合管理