Esta arquitetura de referência descreve como criar fluxos de trabalho de IA duráveis no MongoDB Atlas com Temporal para ingestão orientada a eventos, recuperação semântica e execução de agente.
Ele oferece suporte a equipes que precisam de geração aumentada de recuperação (RAG) e fluxos de trabalho de IA de várias etapas para continuar de forma confiável em falhas, novas tentativas e operações de longa duração.
A arquitetura suporta dois padrões de ingestão. No padrão de fluxo de eventos, as atualizações de origem fluem através do Kafka e do Atlas Stream Processing antes de invocar o Temporal. No padrão direto, as atualizações de origem trigger os fluxos de trabalho temporais imediatamente. Em ambos os casos, o MongoDB Atlas armazena dados operacionais, conhecimento semântico e estado do aplicativo, enquanto o Temporal coordena as operações de extração, parte, embedding, indexação e recuperação.
Solução 1: Ingerir através do Kafka e do Atlas Stream Processing
Esse padrão é adequado para ambientes que já usam o Kafka para transporte de eventos, propagação de alterações ou integração de sistemas desacoplados. O Kafka fornece uma camada de entrada padrão para atualizações de origem de alto volume ou variadas, enquanto o Atlas Stream Processing transforma e roteia eventos antes de invocar o Temporal. Essa separação é importante quando a ingestão deve ser dimensionada independentemente da execução do fluxo de trabalho, ou quando as equipes desejam um backbone de eventos comum em vários consumidores downstream, além do pipeline de IA. As atualizações de conteúdo são originadas de diversas plataformas, como S3, APIs ou um banco de dados ou sistema de mensagens.
Diagrama
O diagrama a seguir mostra esse fluxo.
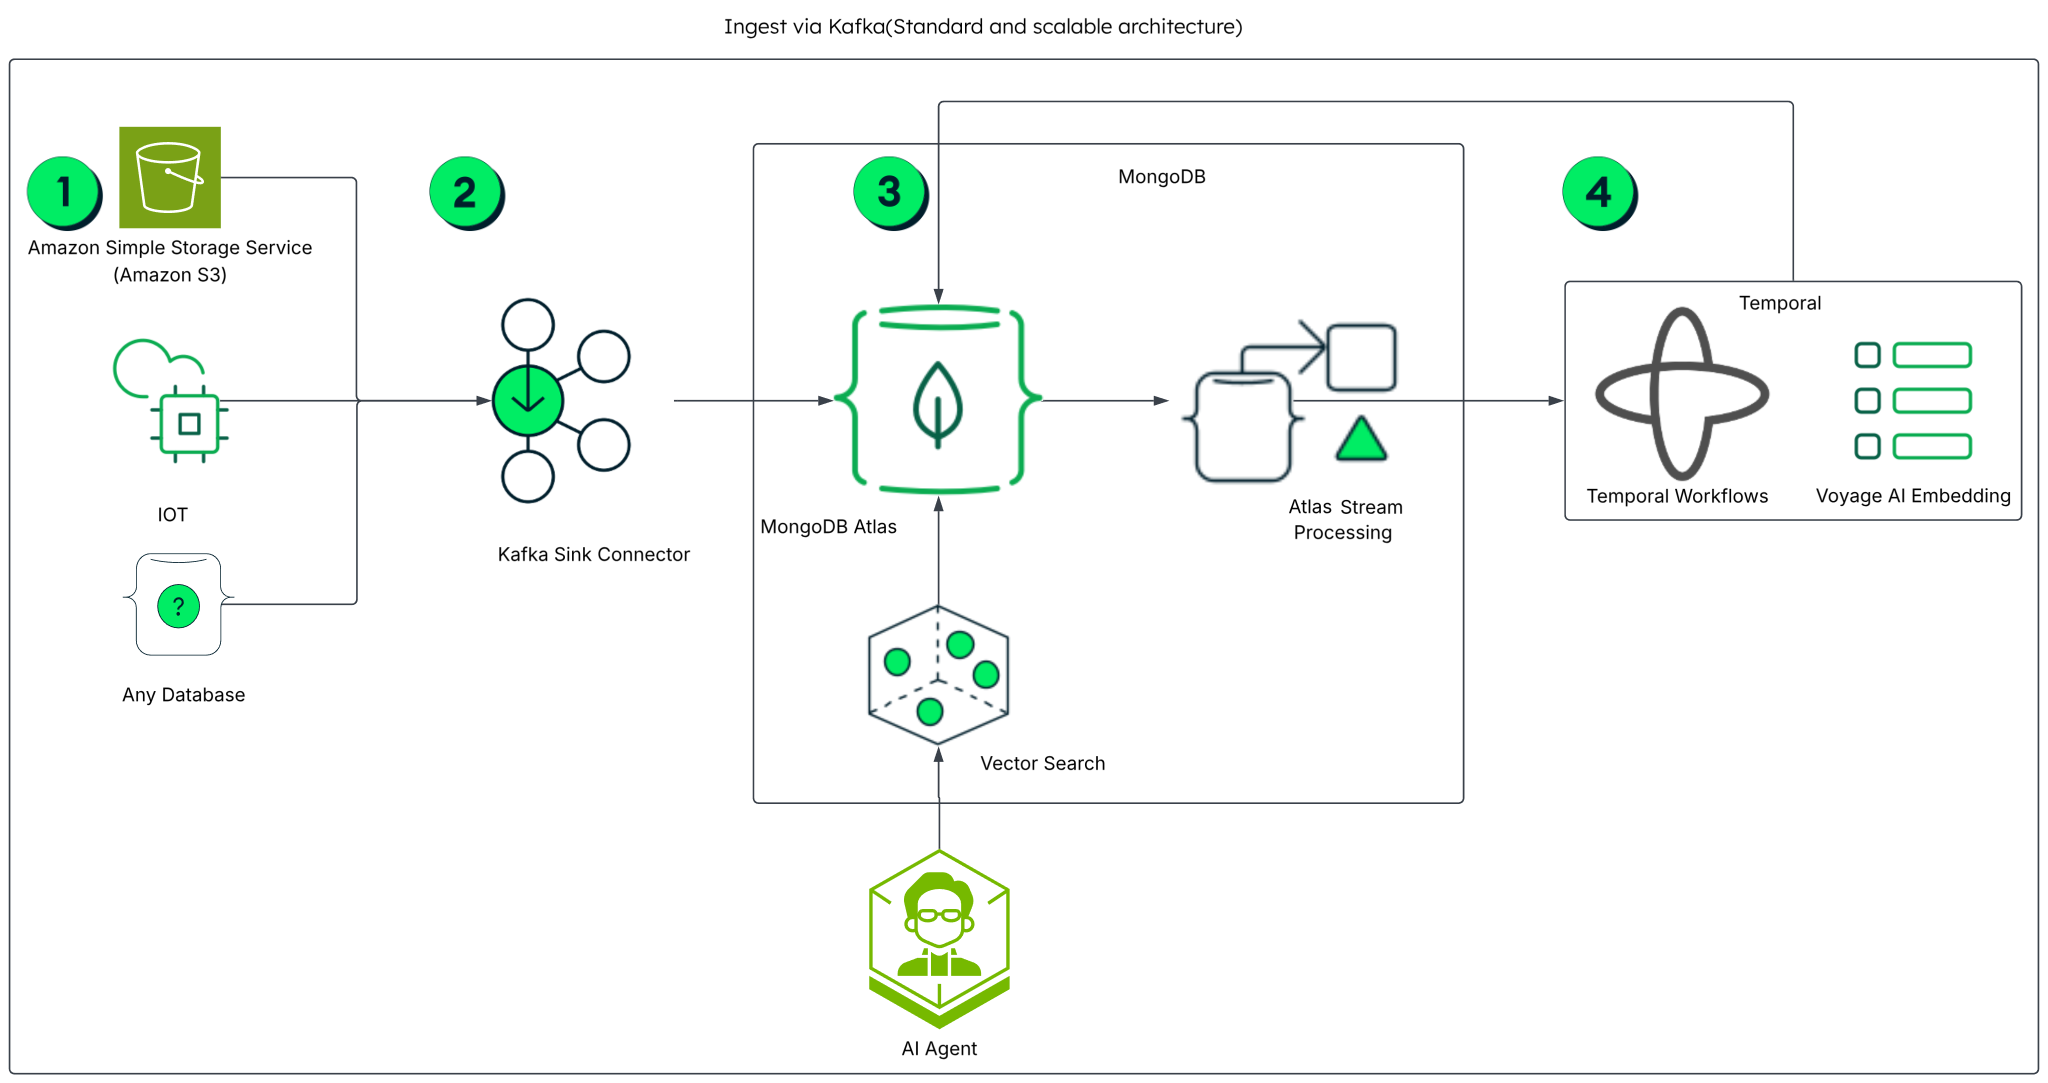
Figura 1. Ingerir por meio do Kafka e do Atlas Stream Processing
Fluxo de dados
As etapas a seguir descrevem esse fluxo:
Os sistemas de origem produzem ou expõem conteúdo
O conteúdo se origina de sistemas upstream, como Amazon S3, plataformas IoT e banco de dados operacionais. Esses sistemas fornecem os documentos, registros ou eventos brutos que o pipeline processa. Quando o conteúdo novo ou atualizado fica disponível, o sistema de origem emite um evento para o Kafka Sink Connector, que o grava na coleção MongoDB
sources.Kafka Sink Connector
O Kafka Sink Connector é a entrega de mensagens durável entre a camada de streaming e o MongoDB. Ele consome eventos de tópicos Kafka e os grava no MongoDB Atlas como documentos. Este componente fornece duas coisas que o trigger direto não fornece: ele agrupa várias fontes variadas em um fluxo ordenado e armazena em buffer contra a contrapressão.
MongoDB (Atlas, Stream Processing e pesquisa vetorial)
O MongoDB desempenha uma função dupla nesta arquitetura, aparecendo em dois pontos diferentes no fluxo.
O MongoDB Atlas é a zona de destino para eventos do Kafka Sink Connector. Os documentos de origem brutos que o Sink Connector grava ficam no Atlas como o registro de staging do que chegou do mundo exterior.
O Atlas Stream Processing atua como o trigger entre essa zona de aterrissagem e o Temporal. Ele observa os documentos de entrada por meio de streams de alterações e inicia o fluxo de trabalho downstream. Isso transforma o MongoDB de um armazenamento passivo em uma fonte de eventos ativa, eliminando a necessidade de um loop de polling e tornando a transferência para o Temporal orientada a eventos em vez de agendada.
O Atlas Vector Search serve o caminho de leitura para o agente, executando a pesquisa de similaridade semântica como uma fase do pipeline de agregação nativa, sem banco de dados vetorial separado e sem fan-out de query entre sistemas.
O MongoDB aparece em ambos os lados do fluxo de dados: ele recebe eventos brutos e serve os vetores incorporados finais. O Atlas Stream Processing conecta os dois.
Embedding temporal e Voyage AI
O Atlas Stream Processing invoca o Temporal, em vez de o Temporal receber o evento diretamente. O núcleo de processamento é o mesmo da Solução 2: os fluxos de trabalho temporais fornecem orquestração durável e retomável, e a incorporação do Voyage AI é executada como atividades independentemente repetíveis nesses fluxos de trabalho.
Nesta solução, o Temporal consome eventos do MongoDB em vez de receber eventos de origem diretamente. Ele só recebe um trigger limpo e normalizado do Atlas Stream Processing, independentemente de o trigger ter se originado do S3, IoT ou de um banco de dados. Esta etapa é bidirecional: o Temporal grava as partes incorporadas e indexadas de volta na coleção de conhecimento do MongoDB assim que o processamento é concluído.
Solução 2: Ingerir fontes de dados diretamente no Temporal
Este padrão é adequado para sistemas que podem emitir eventos confiáveis de objeto, API ou aplicativo diretamente em um trigger de fluxo de trabalho. Ele reduz as camadas arquitetônicas e mantém o caminho de ingestão simples, ao mesmo tempo em que preserva a capacidade de retomada para etapas de extração e embedding de longa duração. Como o fluxo de trabalho é acionado com uma referência de origem em vez de conteúdo bruto, o pipeline downstream permanece agnóstico à origem e pode suportar sistemas upstream adicionais com alterações mínimas de orquestração.
Diagrama
O diagrama a seguir mostra esse fluxo.
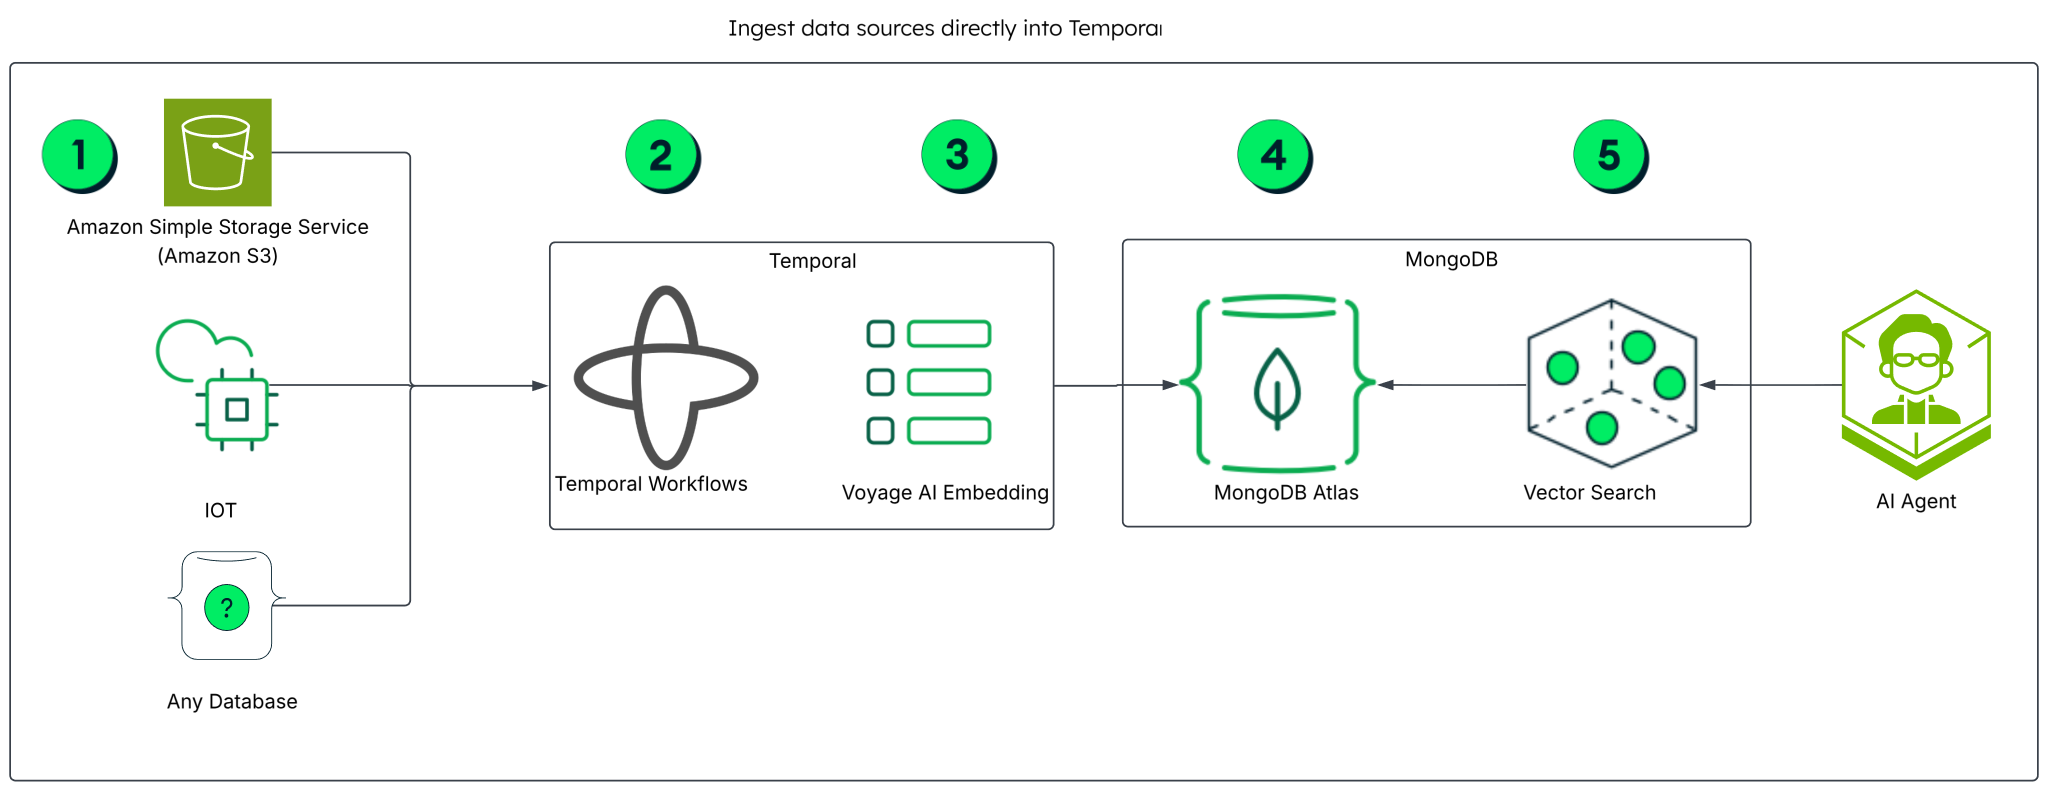
Figura 2. Ingerir fontes de dados diretamente no Temporal
Fluxo de dados
As etapas a seguir descrevem esse fluxo:
Os sistemas de origem produzem ou expõem conteúdo
O conteúdo se origina de sistemas upstream, como Amazon S3, plataformas IoT e banco de dados operacionais. Esses sistemas fornecem os documentos, registros ou eventos brutos que o pipeline processa. Quando o conteúdo novo ou atualizado fica disponível, o sistema de origem emite um evento para um adaptador leve, como Amazon Web Services Lambda, um webhook ou um conector. O adaptador inicia o fluxo de trabalho Temporal e passa apenas a referência de origem e os metadados necessários. Isso mantém a lógica específica da origem fora do fluxo de trabalho, para que você possa adicionar novos tipos de origem sem alterar o pipeline downstream.
Temporal gerencia o ciclo de vida da ingestão
Após o início do fluxo de trabalho, o Temporal coordena a execução, as tentativas e a recuperação em todas as etapas de ingestão. Isso torna o caminho de processamento durável, para que as operações de longa duração continuem de forma confiável em caso de falhas ou reinícios. O fluxo de trabalho recupera o conteúdo de origem e o converte em um formulário normalizado para processamento de IA a jusante, criando uma representação consistente em todos os tipos de origem antes do início da transformação semântica.
O Voyage AI gera embedding dentro do fluxo de trabalho
A execução de embedding do Voyage AI faz parte do fluxo de trabalho, e não uma etapa externa de "disparar e esquecer". Isso mantém o embedding observável e recuperável no mesmo caminho de execução e mantém a transformação semântica firmemente acoplada ao ciclo de vida da ingestão.
O MongoDB Atlas armazena conteúdo, metadados e embedding
O MongoDB Atlas persiste o conteúdo processado, os metadados relacionados e os vetores de embedding em uma única plataforma. Isso cria uma camada de conhecimento durável que suporta o caminho de gravação de ingestão e o caminho de recuperação downstream.
O Atlas Vector Search torna o conhecimento recuperável
O Atlas Vector Search indexa o conteúdo incorporado para que você possa consultá-lo por similaridade semântica. Como os embeddings e os metadados operacionais permanecem na mesma plataforma, as solicitações posteriores de aplicativos e agentes recuperam o contexto relevante sem um armazenamento vetorial separado ou uma camada de sincronização.
Fluxo de solicitação do agente
Este fluxo se aplica a ambas as soluções de ingestão. Ele usa os mesmos princípios de durabilidade da ingestão: em vez de tratar a execução do agente como uma solicitação de API de curta duração, a arquitetura executa a recuperação e o raciocínio como operações orientadas por fluxo de trabalho que você pode observar, repetir e retomar. Isso é importante quando o agente executa várias chamadas de recuperação, invoca FERRAMENTAS externas ou precisa retornar atualizações de status progressivas antes de um resultado final.
Diagrama
O diagrama a seguir mostra os componentes do agente.
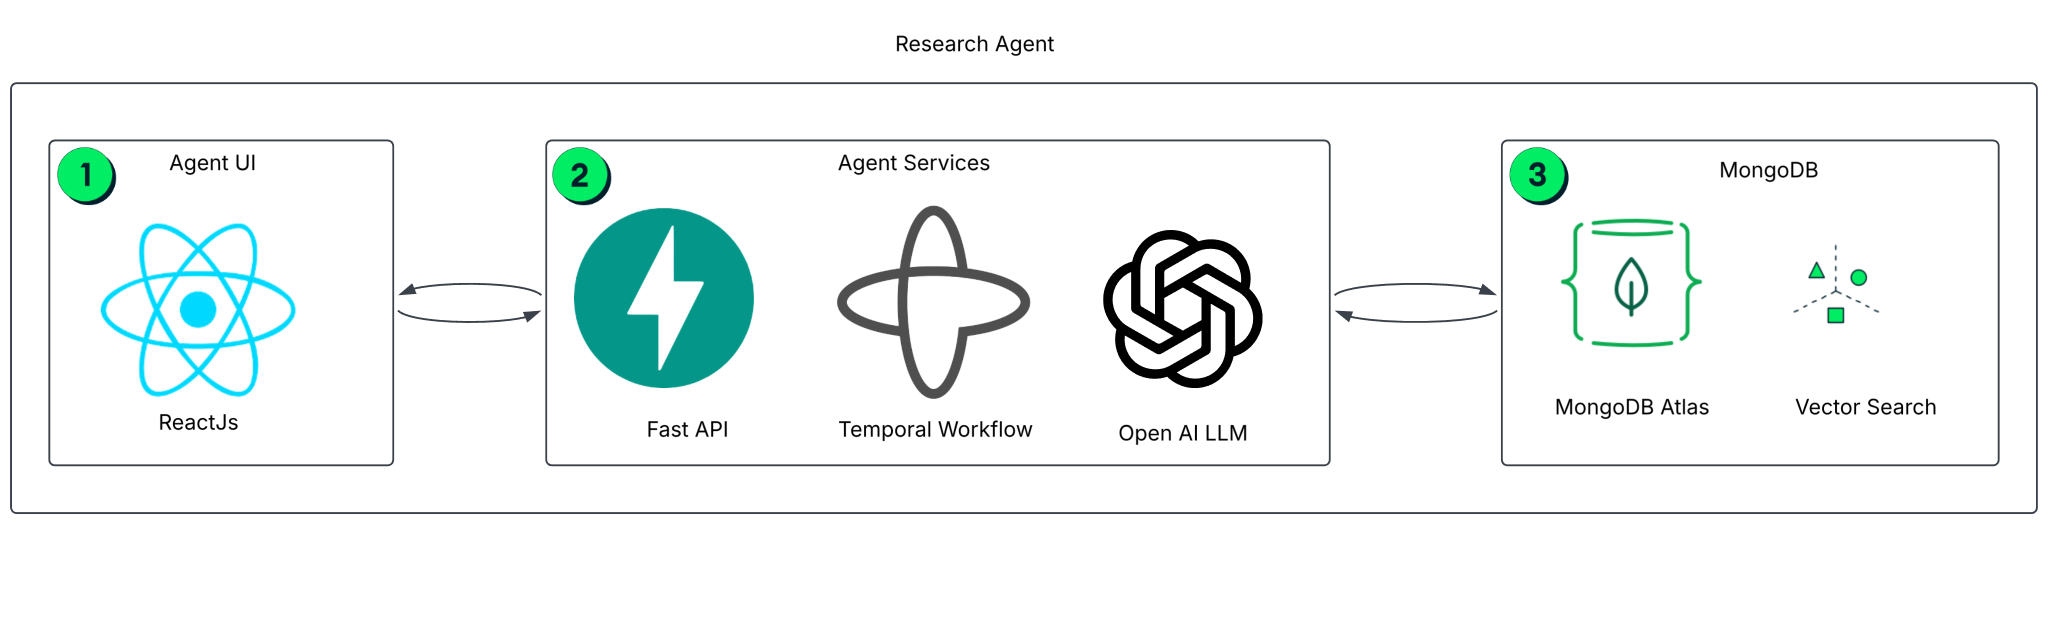
Figura 3. Arquitetura do Agente de Pesquisa
Fluxo de dados
As etapas a seguir descrevem esse fluxo:
Iniciar uma solicitação de pesquisa de agente
Quando a API do agente recebe uma query do usuário por meio da IU, ela inicia um fluxo de trabalho Temporal durável. O sistema retorna imediatamente um identificador de fluxo de trabalho, para que a IU possa acompanhar o progresso à medida que o agente de pesquisa recupera o contexto e raciocina sobre uma resposta.
Recupere o contexto do MongoDB Atlas Vector Search
O MongoDB Atlas hospeda os metadados, embedding vetorial e índice semântico. Durante uma interação do usuário, o agente incorpora a query e usa o Atlas Vector Search do MongoDB para recuperar o contexto relevante, geralmente aplicando uma camada de reclassificação antes da síntese final. Para padrões de indexação e query, consulte a documentação do Atlas Vector Search.
Retornar um resultado de pesquisa durável
O fluxo de trabalho de pesquisa coordena a execução de ferramentas, interações de modelo e síntese final. O Temporal mantém o processo por meio de novas tentativas e persistência de estado, para que a IU forneça uma resposta validada. Para saber mais sobre execução durável, consulte a documentação do Temporal.
Componentes
Os seguintes componentes implementam esta arquitetura.
MongoDB Atlas
Use o MongoDB Atlas para armazenar as partes preparadas e incorporadas do pipeline de ingestão, o índice de pesquisa vetorial do MongoDB Atlas e o estado do agente em um único banco de dados. Como o agente lê os mesmos dados que o pipeline de ingestão grava, não há um armazenamento de memória separado para manter em sincronização.
Atlas Stream Processing
Use Atlas Stream Processing para fornecer um caminho de integração opcional e orientado a eventos entre fontes de streaming e fluxos de trabalho Temporal. Ele gerencia a transformação e o roteamento em tempo real de eventos de entrada para arquiteturas de alta taxa de transferência. Isso permite que você implemente a ingestão quase em tempo real sem exigir o Kafka, se você escolher uma conexão direta da fonte para o Temporal.
Voyage AI
Use Voyage AI para gerar o embedding e realizar a reclassificação de resultados para esta arquitetura. Como o embedding e a reclassificação são separados da orquestração do fluxo de trabalho, as equipes podem atualizar o modelo independentemente do pipeline de ingestão e recuperação.
Atlas Vector Search
Use MongoDB Atlas Vector Search para recuperar o contexto do documento e a memória do agente por meio da indexação semântica. O agente de pesquisa consulta o mesmo cluster do MongoDB Atlas usado para armazenamento primário, portanto, a recuperação usa dados operacionais atuais.
Temporal
Use Temporal como a camada de execução durável para ingestão e fluxos de trabalho agentic em sistemas de origem, MongoDB Atlas e serviços externos de IA. Ele coordena etapas de longa duração, como extração, parte, embedding e indexação, e fornece novas tentativas integradas, checkpointing e recuperação. Isso permite que os fluxos de trabalho sejam retomados do último estado bem-sucedido após uma falha ou interrupção, em vez de reiniciar. Ao tornar a orquestração durável, o Temporal ajuda as equipes a operar, preencher e desenvolver de forma confiável pipeline de IA de produção.
Exceções, Advertências e Compromissos
Considere as compensações entre a ingestão direta e a baseada em Kafka antes de adotar esta arquitetura. Uma conexão direta de origem para Temporal tem menos componentes móveis para operar. Um caminho baseado em Kafka adiciona um agente de mensagens, o que introduz infraestrutura adicional, mas se encaixa naturalmente se sua organização já roteia atualizações de origem por meio do Kafka.
Implementação e saiba mais
Consulte o repositório do GitHub mdb-temporal-pra para obter orientação de implantação e documentação técnica.