您可以将MongoDB与 MLflow 集成,以将 MLflow 跟踪和模型注册表数据存储在MongoDB中。 MLflow 是一个用于管理机器学习和 GenAI 应用程序生命周期的开源平台。 mlflow-mongodb 集成适用于运行MongoDB 8.0 或更高版本的Atlas、 MongoDB Enterprise Advanced和MongoDB Community Edition部署。本页介绍如何配置 MLflow 以使用MongoDB、日志运行、注册模型以及从 GenAI应用程序捕获跟踪。
Overview
mlflow-mongodb包是在 MLflow服务器内运行的 MLflow 插件。该插件仅在MongoDB中存储以下 MLflow 元元数据:
工件是运行生成的文件,例如模型文件、图像和跟踪有效负载。 MLflow 将工件写入单独的工件存储,而不是MongoDB。本教程将工件存储在 MLflow服务器的本地磁盘上。对于生产部署,请配置工件存储,例如Amazon S3。
您可以独立配置跟踪存储和模型注册表存储。示例,一个存储可以使用MongoDB ,而另一个存储则使用不同的 MLflow后端。本教程将MongoDB用于这两个存储。
先决条件
在开始之前,请确保您具备以下内容:
运行MongoDB版本 8.0 或更高版本的MongoDB 部署。
对存储 MLflow 数据的数据库具有读写写入访问权限的数据库用户。
从 MLflow服务器到部署的网络访问权限。
Python 3.11 到 3.14。
MLflow 3.5 或更高版本的 3.x发布。
安装和配置
以下过程将安装 mlflow-mongodb包并启动在MongoDB中存储数据的 MLflow服务器:
启动 MLflow服务器。
运行以下命令以启动服务器。将 <connection-string> 替换为上一步中的连接字符串:
export TRACKING_STORE_URI="<connection-string>"export REGISTRY_STORE_URI="<connection-string>"export MLFLOW_BIND_HOST="127.0.0.1"export MLFLOW_BIND_PORT="5000"
mlflow server \  --backend-store-uri "${TRACKING_STORE_URI}" \  --registry-store-uri "${REGISTRY_STORE_URI}" \  --host "${MLFLOW_BIND_HOST}" \  --port "${MLFLOW_BIND_PORT}"
MLflow 将工件存储在服务器上的 mlartifacts目录中。要查看 MLflow用户界面,请在浏览器中打开 http://127.0.0.1:5000。
记录运行
以下过程记录了存储参数、指标和工件的运行:
创建示例文件。
以下示例创建了一个名为 mongodb-backend-demo 的实验,然后通过调用 mlflow.start_run() 方法启动运行。运行会记录以下项目:
model_typeparameteraccuracy衡量标准run-summary.txt工件
本教程中的示例通过调用 mlflow.set_tracking_uri() 方法连接到服务器。要在不更改客户端代码的情况下连接 MLflow 客户端,请将 MLFLOW_TRACKING_URI 环境变量设立为 http://127.0.0.1:5000。
将以下代码保存在名为 log_run.py 的文件中:
import mlflow
mlflow.set_tracking_uri("http://127.0.0.1:5000")mlflow.set_experiment("mongodb-backend-demo")
with mlflow.start_run() as run:    mlflow.log_param("model_type", "example")    mlflow.log_metric("accuracy", 0.92)    mlflow.log_text("Hello from the MongoDB backend", "run-summary.txt")    print("run_id:", run.info.run_id)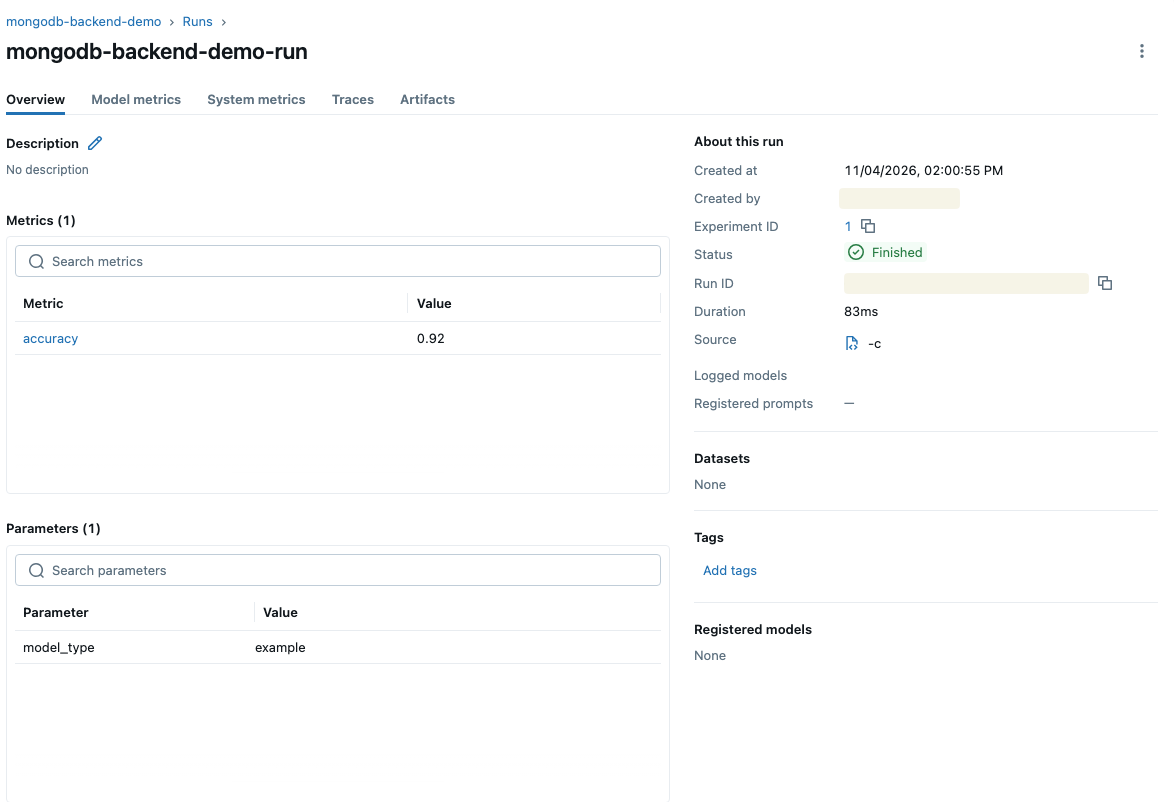
模型注册表
要注册模型,请使用以下方法之一:
使用
log_model()方法(例如mlflow.pyfunc.log_model())日志模型时,请传递registered_model_name参数。调用
mlflow.register_model()方法并传递运行记录的模型的 URI,例如runs:/<run-id>/model。
每次使用现有名称注册模型时,MLflow 都会创建该模型的新版本。要管理版本,请使用 MlflowClient 方法,例如 set_registered_model_alias() 和 set_model_version_tag()。
创建示例文件。
以下示例调用 log_model() 方法并将模型注册为 mongodb-backend-demo-model。然后,代码会设置别名和标签。将文件另存为 register_model.py:
import mlflowfrom mlflow import MlflowClientfrom mlflow.pyfunc import PythonModel
mlflow.set_tracking_uri("http://127.0.0.1:5000")mlflow.set_experiment("mongodb-backend-demo")
class EchoModel(PythonModel):    def predict(self, context, model_input):        return model_input
with mlflow.start_run():    mlflow.pyfunc.log_model(        name="model",        python_model=EchoModel(),        registered_model_name="mongodb-backend-demo-model",    )
client = MlflowClient()client.set_registered_model_alias("mongodb-backend-demo-model", "mongo-verified", 1)client.set_model_version_tag("mongodb-backend-demo-model", 1, "validated_by", "doc-test")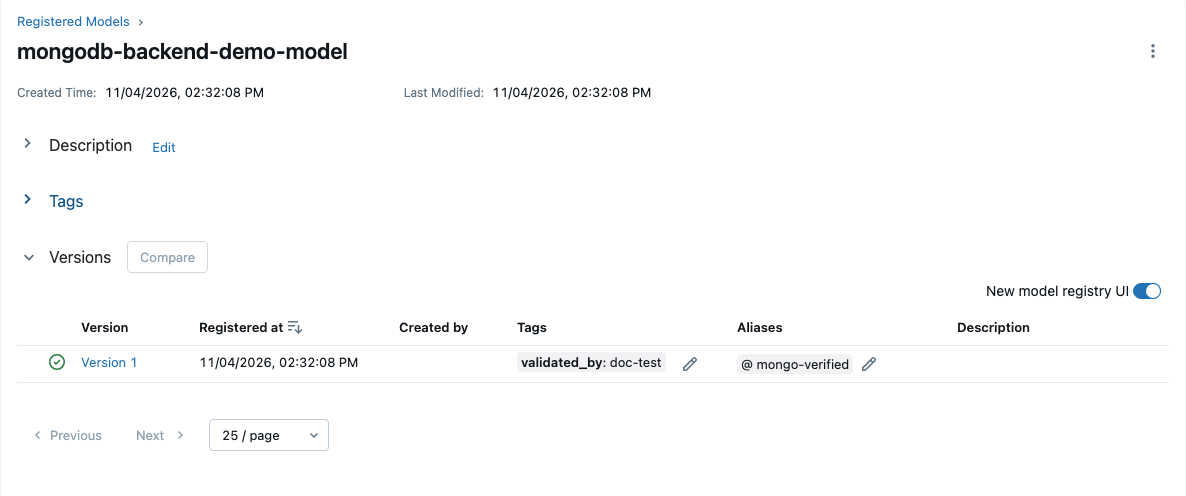
追踪和 GenAI 可观察性
MLflow 跟踪记录 LLM应用程序或代理中每个步骤的输入、输出和持续时间。当您使用MongoDB进行跟踪存储时,MLflow 会将跟踪及其跨度存储在MongoDB中。
启用跟踪。
要启用跟踪,请使用以下方法之一:
将
@mlflow.trace装饰器添加到要跟踪的函数中。
以下示例使用 @mlflow.trace 装饰器来跟踪调用代理的函数。将文件另存为 trace_agent.py:
import mlflow
mlflow.set_tracking_uri("http://127.0.0.1:5000")mlflow.set_experiment("agent-traces")
mlflow.tracedef call_agent(prompt: str) -> str: # Replace this line with your actual LLM or agent call return f"Echo: {prompt}"
call_agent("Summarize this document")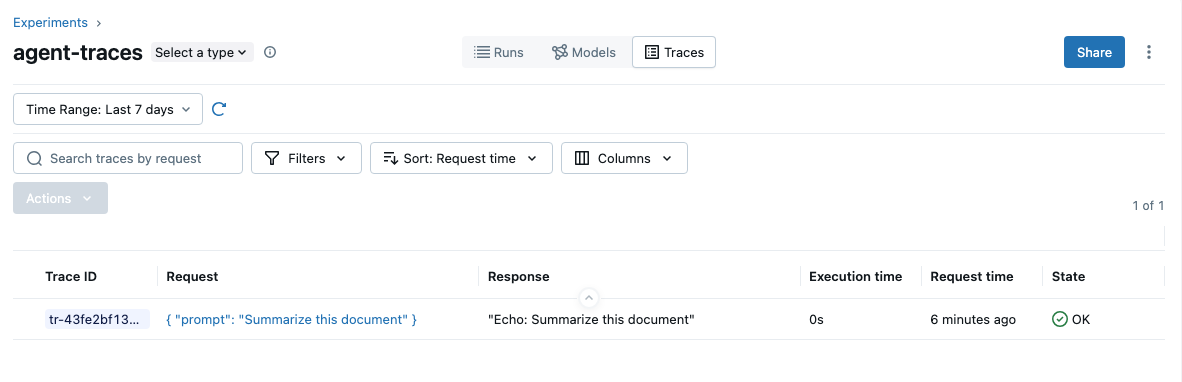
注意
跟踪存储和检索取决于 MLflow 版本。 MLflow 3.5 客户端将完整跟踪有效负载上传到实验的工件存储。 MongoDB存储这些 span。在 MLflow 3.6 及更高版本上,客户端直接从MongoDB检索跟踪。聚合跟踪指标需要 MLflow 3.9 或更高版本。
后续步骤
要学习;了解有关 MLflow 概念和功能的更多信息,请参阅以下 MLflow 文档:
了解详情
要详细学习;了解本教程中的概念,请参阅以下资源: