MongoDB をMLflow と統合して、MLflow 追跡データとモデル レジストリ データをMongoDBに保存できます。 MLflow は、機械学習と生成AIアプリケーションのライフサイクルを管理するためのオープンソース プラットフォームです。 統合は、mlflow-mongodb MongoDB. 以降を実行する Atlas、 MongoDB Enterprise Advanced、 MongoDB Community Edition8 0の配置で機能します。このページでは、 MongoDBの使用、実行のログ、モデルの登録、および生成AIアプリケーションからのトレースをキャプチャするように MLflow を構成する方法を説明します。
Overview
mlflow-mongodbパッケージは、 MLflowサーバー内で実行される MLflowプラグインです。プラグインは、 MongoDBに次の MLflowメタデータのみを保存します。
モデルレジストリデータ: 登録されたモデル、バージョン、エイリアス、タグ、プロンプト。
アーティファクトは、モデル ファイル、イメージ、トレース ペイロードなど、 の実行によって生成されるファイルです。 MLflow は、 MongoDBではなく 、別のアーティファクトストアにアーティファクトを書込みます。このチュートリアルでは、 MLflowサーバーのローカル ディスクに アーティファクトを保存します。本番環境には、 Amazon S などのアーティファクト ストアを構成します。3
追跡ストアとモデル レジストリ ストアは個別に構成できます。例、あるストアはMongoDBを使用し、他のストアは別の MLflowバックエンドを使用できます。このチュートリアルでは、両方のストアにMongoDBを使用します。
前提条件
始める前に、以下のものを必ず用意してください。
MongoDBバージョン 8.0 以降を実行するMongoDBデプロイ。
MLflow データを保存するデータベースへの読み取りアクセス権および書込みアクセス権を持つデータベースユーザー。
MLflowサーバーから配置へのネットワーク アクセス。
Python 3.11 から 3.14 。
MLflow 3.5 またはそれ以降の 3.x リリース。
インストールと構成
次の手順では、mlflow-mongodbパッケージをインストールし、 MongoDBにデータを保存する MLflowサーバーを起動します。
接続文字列を準備します。
プラグインでは、 接続文字列のパスに MLflow データを保存するデータベースの名前が必要です。次の接続文字列のプレースホルダーを自分の値に置き換えます。
mongodb+srv://<db_username>:<db_password>@<cluster-host>/<database>?retryWrites=true&w=majorityAtlas接続文字列を見つけるには、「 クライアント ライブラリ経由でクラスターに接続する 」を参照してください。
mongodb://<db_username>:<db_password>@<host>:<port>/<database>?retryWrites=true&w=majority自己管理型接続文字列の詳細については、「 接続文字列 」を参照してください。
MLflowサーバーを起動します。
次のコマンドを実行して、サーバーを起動します。 <connection-string> を前の手順の接続文字列に置き換えます。
export TRACKING_STORE_URI="<connection-string>"export REGISTRY_STORE_URI="<connection-string>"export MLFLOW_BIND_HOST="127.0.0.1"export MLFLOW_BIND_PORT="5000"
mlflow server \  --backend-store-uri "${TRACKING_STORE_URI}" \  --registry-store-uri "${REGISTRY_STORE_URI}" \  --host "${MLFLOW_BIND_HOST}" \  --port "${MLFLOW_BIND_PORT}"
MLflow は、サーバーの mlartifactsディレクトリにアーティファクトを保存します。 MLflow UI を表示するには、ブラウザで http://127.0.0.1:5000 を開きます。
実行のログ
次の手順では、パラメータ、メトリクス、およびアーティファクトを保存する の実行をログに記録します。
例ファイルを作成します。
次の例では、mongodb-backend-demo という名前の実験を作成し、mlflow.start_run() メソッドを呼び出して実行を開始します。の実行では、次の項目がログに記録されます。
model_typeparameteraccuracyメトリクスrun-summary.txtアーティファクト
このチュートリアルの例では、mlflow.set_tracking_uri() メソッドを呼び出してサーバーに接続します。クライアントコードを変更せずに MLflow クライアントを接続するには、MLFLOW_TRACKING_URI 環境変数を http://127.0.0.1:5000 に設定します。
次のコードを log_run.py という名前のファイルに保存します。
import mlflow
mlflow.set_tracking_uri("http://127.0.0.1:5000")mlflow.set_experiment("mongodb-backend-demo")
with mlflow.start_run() as run:    mlflow.log_param("model_type", "example")    mlflow.log_metric("accuracy", 0.92)    mlflow.log_text("Hello from the MongoDB backend", "run-summary.txt")    print("run_id:", run.info.run_id)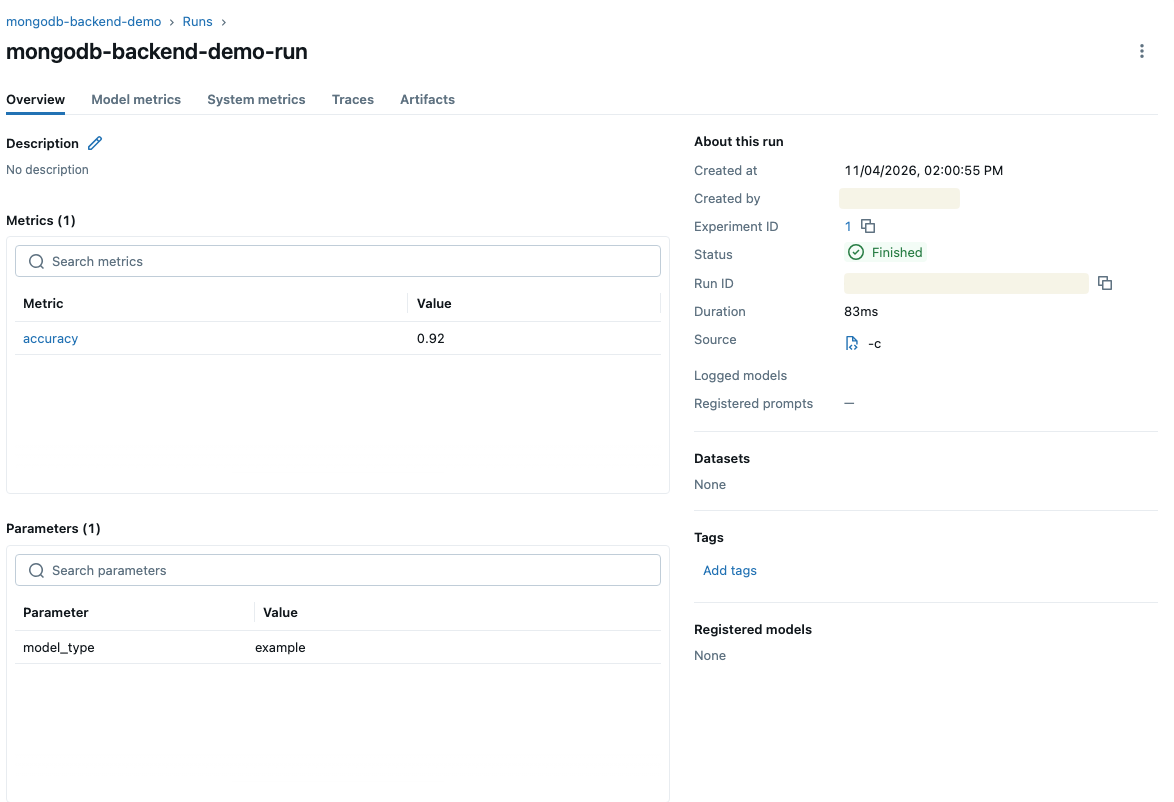
モデル レジストリ
モデルを登録するには、次のいずれかの方法を使用します。
モデルをログに記録するときに、
log_model()メソッド(mlflow.pyfunc.log_model()など)を使用してモデルをログときに、registered_model_name引数を渡します。mlflow.register_model()メソッドを呼び出し、ログに記録された を実行したモデルの URI を渡します(runs:/<run-id>/modelなど)。
既存の名前でモデルを登録するたびに、MLflow はそのモデルの新しいバージョンを作成します。バージョンを管理するには、set_registered_model_alias() や set_model_version_tag() などの MlflowClient メソッドを使用します。
例ファイルを作成します。
次の例では、 log_model() メソッドを呼び出し、モデルを mongodb-backend-demo-model として登録しています。次に、コードはエイリアスとタグを設定します。ファイルをregister_model.py として保存します。
import mlflowfrom mlflow import MlflowClientfrom mlflow.pyfunc import PythonModel
mlflow.set_tracking_uri("http://127.0.0.1:5000")mlflow.set_experiment("mongodb-backend-demo")
class EchoModel(PythonModel):    def predict(self, context, model_input):        return model_input
with mlflow.start_run():    mlflow.pyfunc.log_model(        name="model",        python_model=EchoModel(),        registered_model_name="mongodb-backend-demo-model",    )
client = MlflowClient()client.set_registered_model_alias("mongodb-backend-demo-model", "mongo-verified", 1)client.set_model_version_tag("mongodb-backend-demo-model", 1, "validated_by", "doc-test")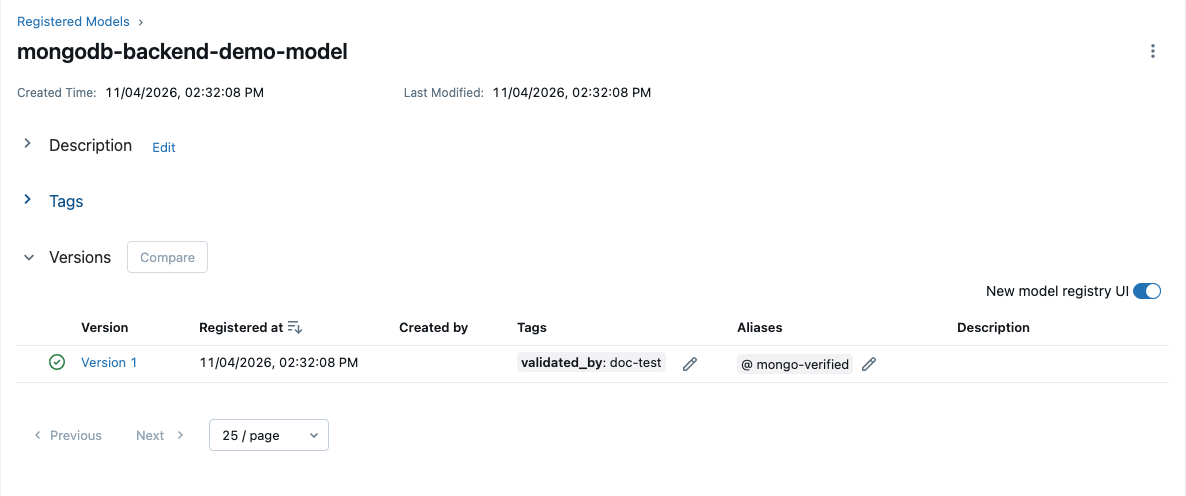
トレースと生成AIの可視性
MLflow トレースは、 LMアプリケーションまたはエージェントの各ステップの入力、出力、および期間を記録します。追跡ストアにMongoDBを使用すると、MLflow はトレースとその範囲をMongoDBに保存します。
トレースを有効にします。
トレースを有効にするには、次のいずれかの方法を使用します。
mlflow.<flavor>.autolog()OpenAI や Lgachein など、サポートされているフレームワークまたはプロバイダーへの呼び出しをトレースするには、 メソッドを呼び出します。詳細については、MLflow ドキュメントの「 自動トレース機能 」を参照してください。トレースする関数に
@mlflow.trace修飾子を追加します。
次の例では、@mlflow.trace 修飾子を使用して、エージェントを呼び出す関数を追跡します。ファイルをtrace_agent.py として保存します。
import mlflow
mlflow.set_tracking_uri("http://127.0.0.1:5000")mlflow.set_experiment("agent-traces")
mlflow.tracedef call_agent(prompt: str) -> str: # Replace this line with your actual LLM or agent call return f"Echo: {prompt}"
call_agent("Summarize this document")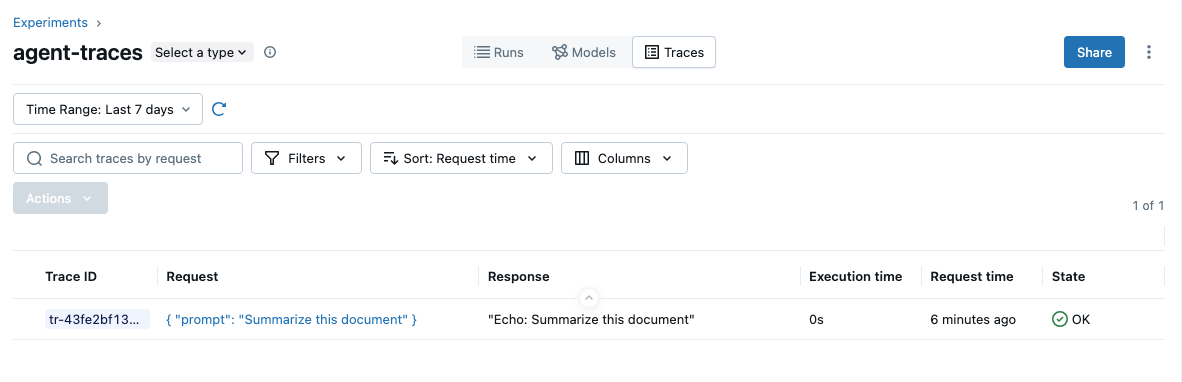
注意
トレースストレージと取得は、MLflow のバージョンによって異なります。 MLflow 3.5 クライアントは、完全なトレース ペイロードを実験のアーティファクト ストアにアップロードします。 MongoDB は範囲を保存します。 MLflow 3.6 以降では、クライアントはMongoDBから直接トレースを取得します。集計されたトレースメトリクスには、MLflow 3.9 以降が必要です。
次のステップ
MLflow の概念と機能の詳細については、次の MLflow ドキュメントを参照してください。
詳細
このチュートリアルの概念の詳細については、次のリソースを参照してください。