Esta página explora os resultados do nosso MongoDB pesquisa vetorial benchmark de desempenho. O MongoDB oferece uma faixa de soluções que atendem a várias necessidades de implementação. Os clientes podem escolher os níveis de desempenho e precisão que são adequados à sua configurar de negócios específica.
Resumo dos resultados
Em vetores 15.3M usando
voyage-3-largeincorporações em 2048 dimensões, o MongoDB Vector Search com quantização configurada retém 90-95% de precisão com latência de consulta < 50ms.A quantização binária oferece uma solução mais barata, por cerca de um quarto do preço de servir o índice. Como ele faz a reclassificação com vetores de fidelidade total, pode ser uma opção preferível para dimensionar muitas cargas de trabalho em grande escala, embora recomendemos a execução de testes no conjunto de dados de amostra para garantir que o desempenho atenda às suas necessidades.
Recomendamos mais de 1024 dimensões ao executar cargas de trabalho maiores com quantização.
Os filtros seletivos podem melhorar ou piorar o desempenho dependendo do valor selecionado para
numCandidates.O custo adicional da rescoring para quantização binária se manifesta na redução da taxa de transferência ao executar cargas de trabalho altamente concorrentes.
A fragmentação melhora ligeiramente a taxa de transferência, mas ainda recomendamos o dimensionamento do número de nós de pesquisa ou o número de núcleos disponíveis em um nó de pesquisa para melhorar a taxa de transferência.
Análise de recuperação e latência no benchmark multidimensional
O primeiro conjunto de resultados mostra os testes que executamos em um conjunto de dados de 5,5 mi documentos contendo múltiplas dimensionalidades de vetores (256, 512, 1024, 2048), todos produzidos usando voyage-3-large em cada documento.
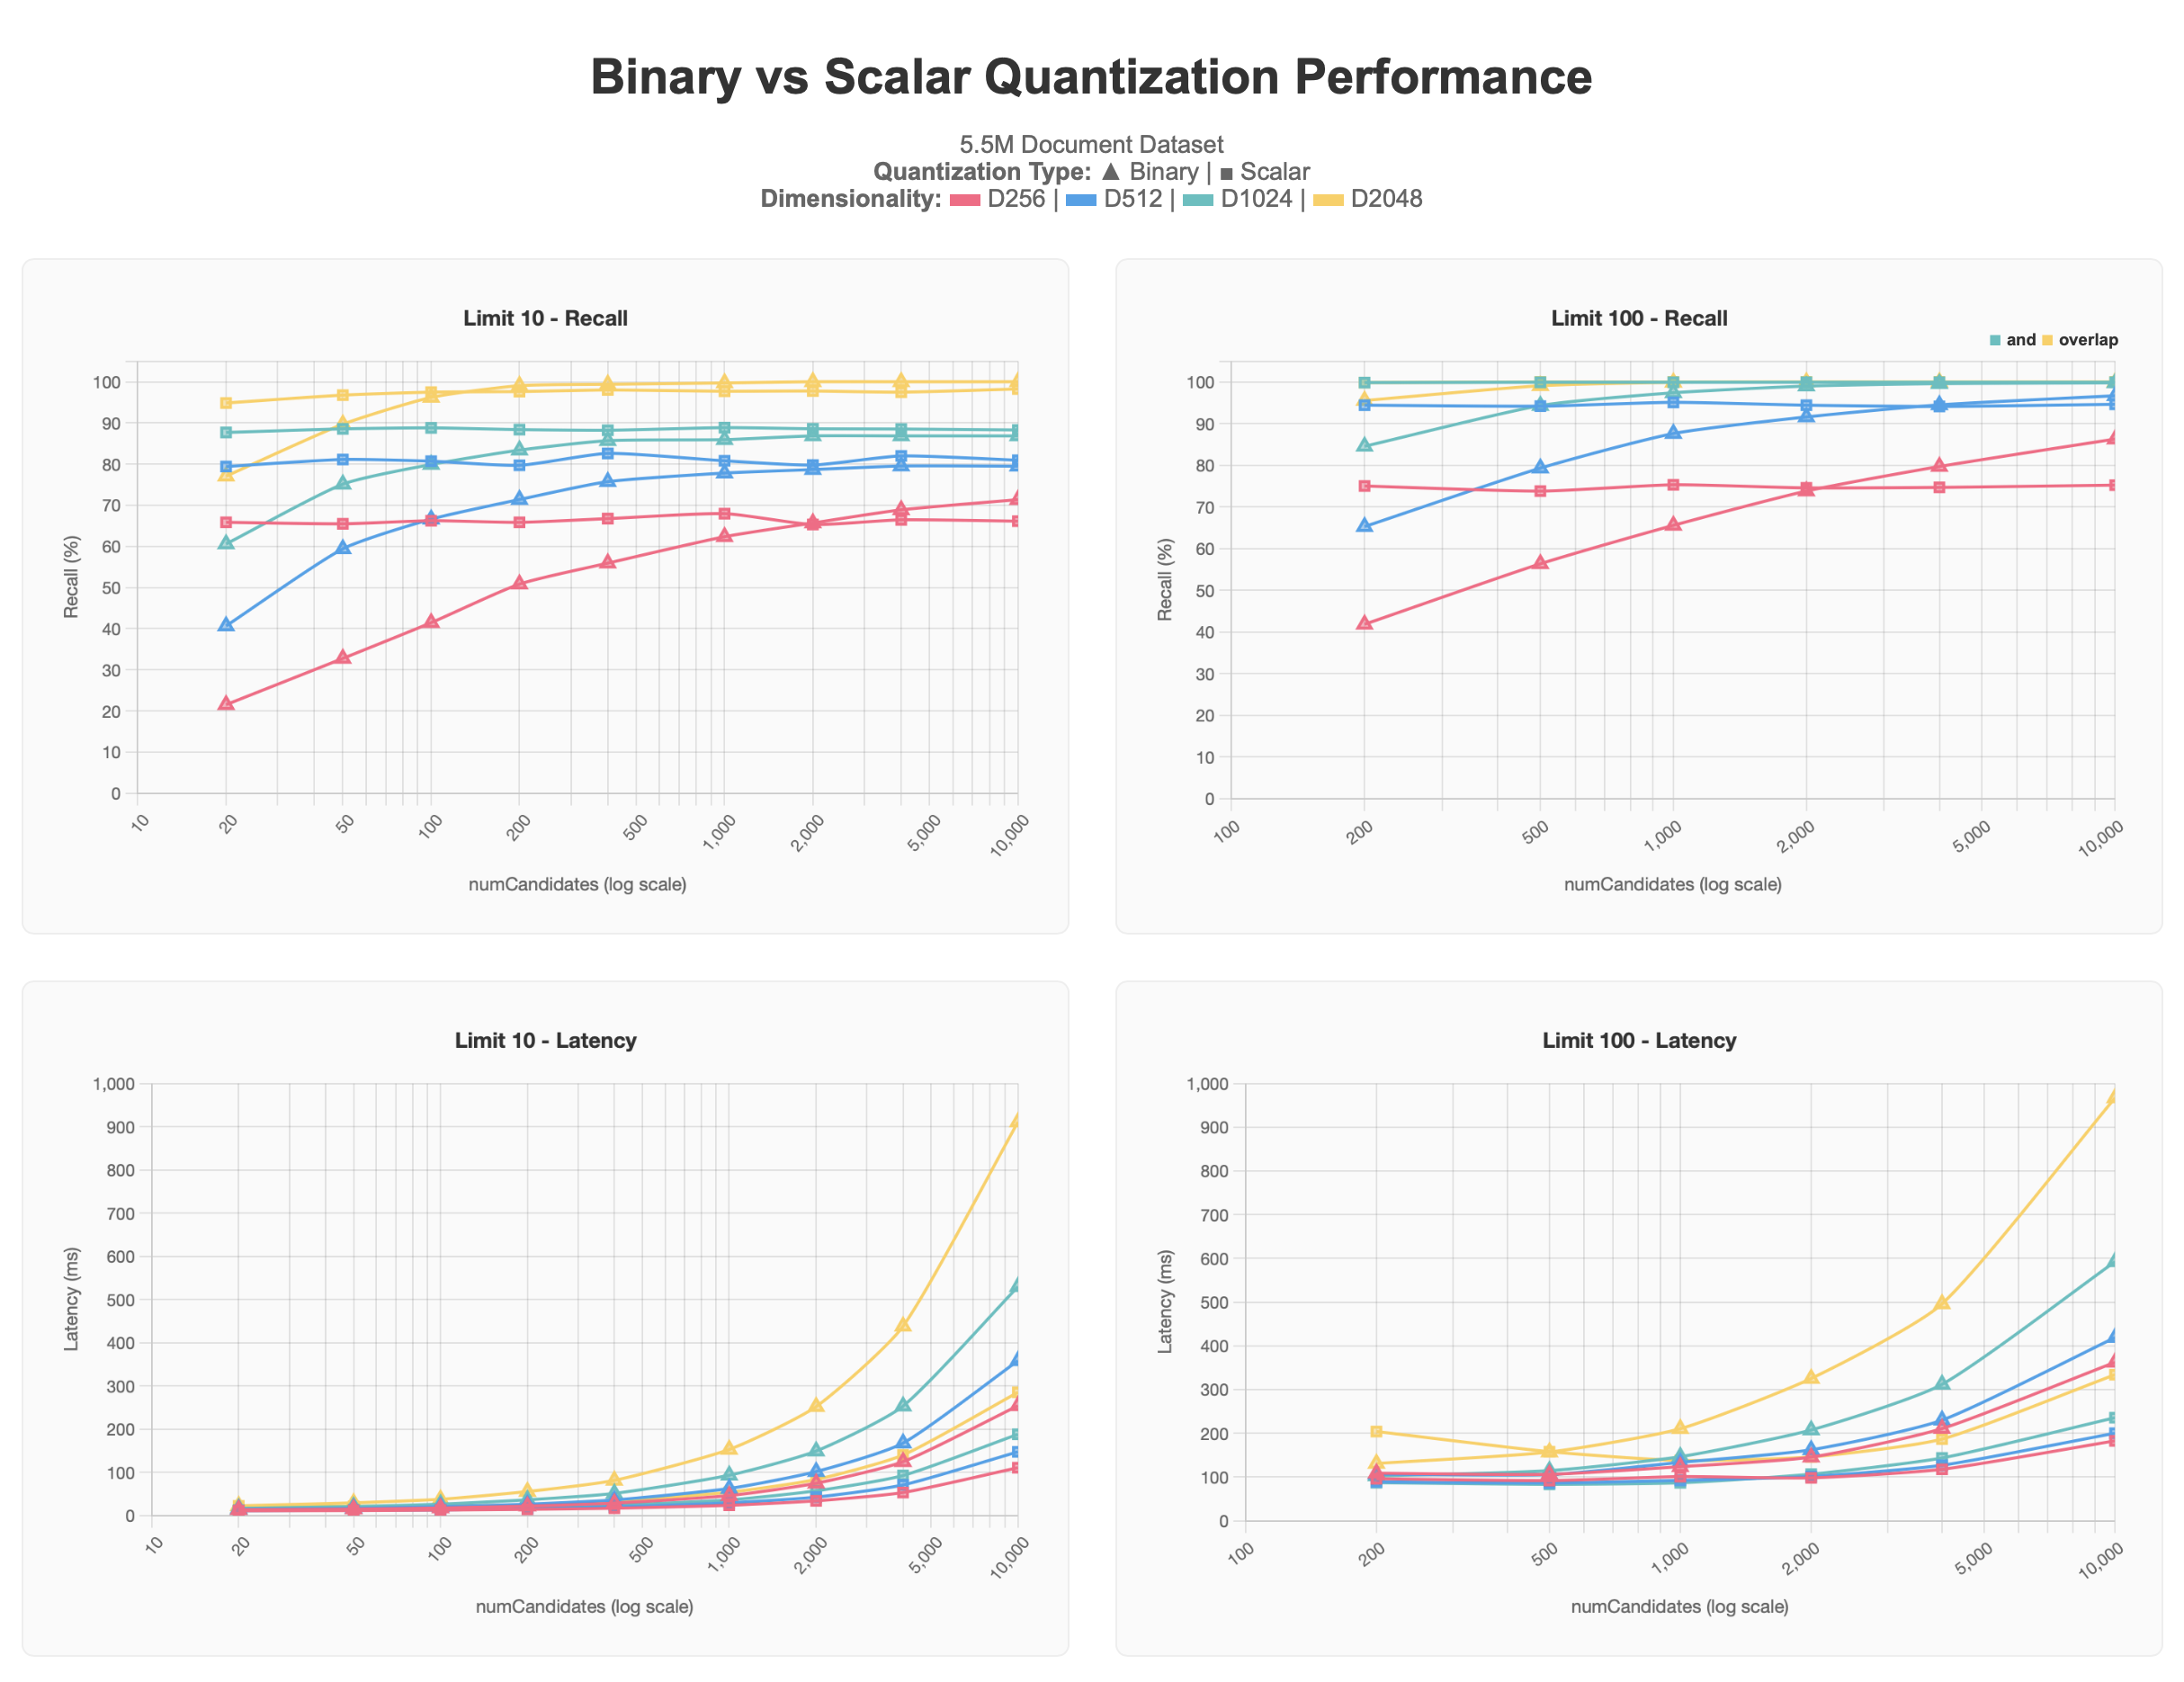
Todos os resultados quantizados escalares começam em níveis mais altos do que os resultados quantizados binários, mas permanecem em seu nível assintético mesmo com o aumento de numCandidates. Por outro lado, as queries quantizadas binárias produzem resultados mais precisos à medida que mais numCandidates são solicitadas, abordando a assíntota da quantização escalar e, em alguns casos, passando-a, ao custo de maior latência, especialmente acima de numCandidates de 1000.
Valores mais baixos de limit geralmente exigem numCandidates mais alto para se aproximar de 100% de precisão, porque a query é mais seletiva sobre os resultados de topo. Esse efeito é particularmente visível no gráfico de quantização binária. Vetores de dimensões mais altas (1024d e acima) atingem a faixa-alvo de 90-95% em numCandidates menores, pois a representação mais rica torna os vizinhos próximos mais fáceis de distinguir. Os testes que limit os resultados para 100 atingir a faixa-alvo de 90-95% com menor numCandidates do que os testes que limit os resultados para 10, porque o conjunto de resultados maior oferece à pesquisa mais oportunidades para encontrar vizinhos relevantes.
Com essas informações, determinamos que, ao trabalhar com um grande conjunto de dados, é recomendável ter uma dimensionalidade de pelo menos 1024d e aplicar a quantização para dimensionar, em vez de ter uma dimensionalidade mais baixa e não usar a quantização, sendo a quantidade de vetores solicitados para o caso de uso também um fator.
Resultados de benchmark maiores
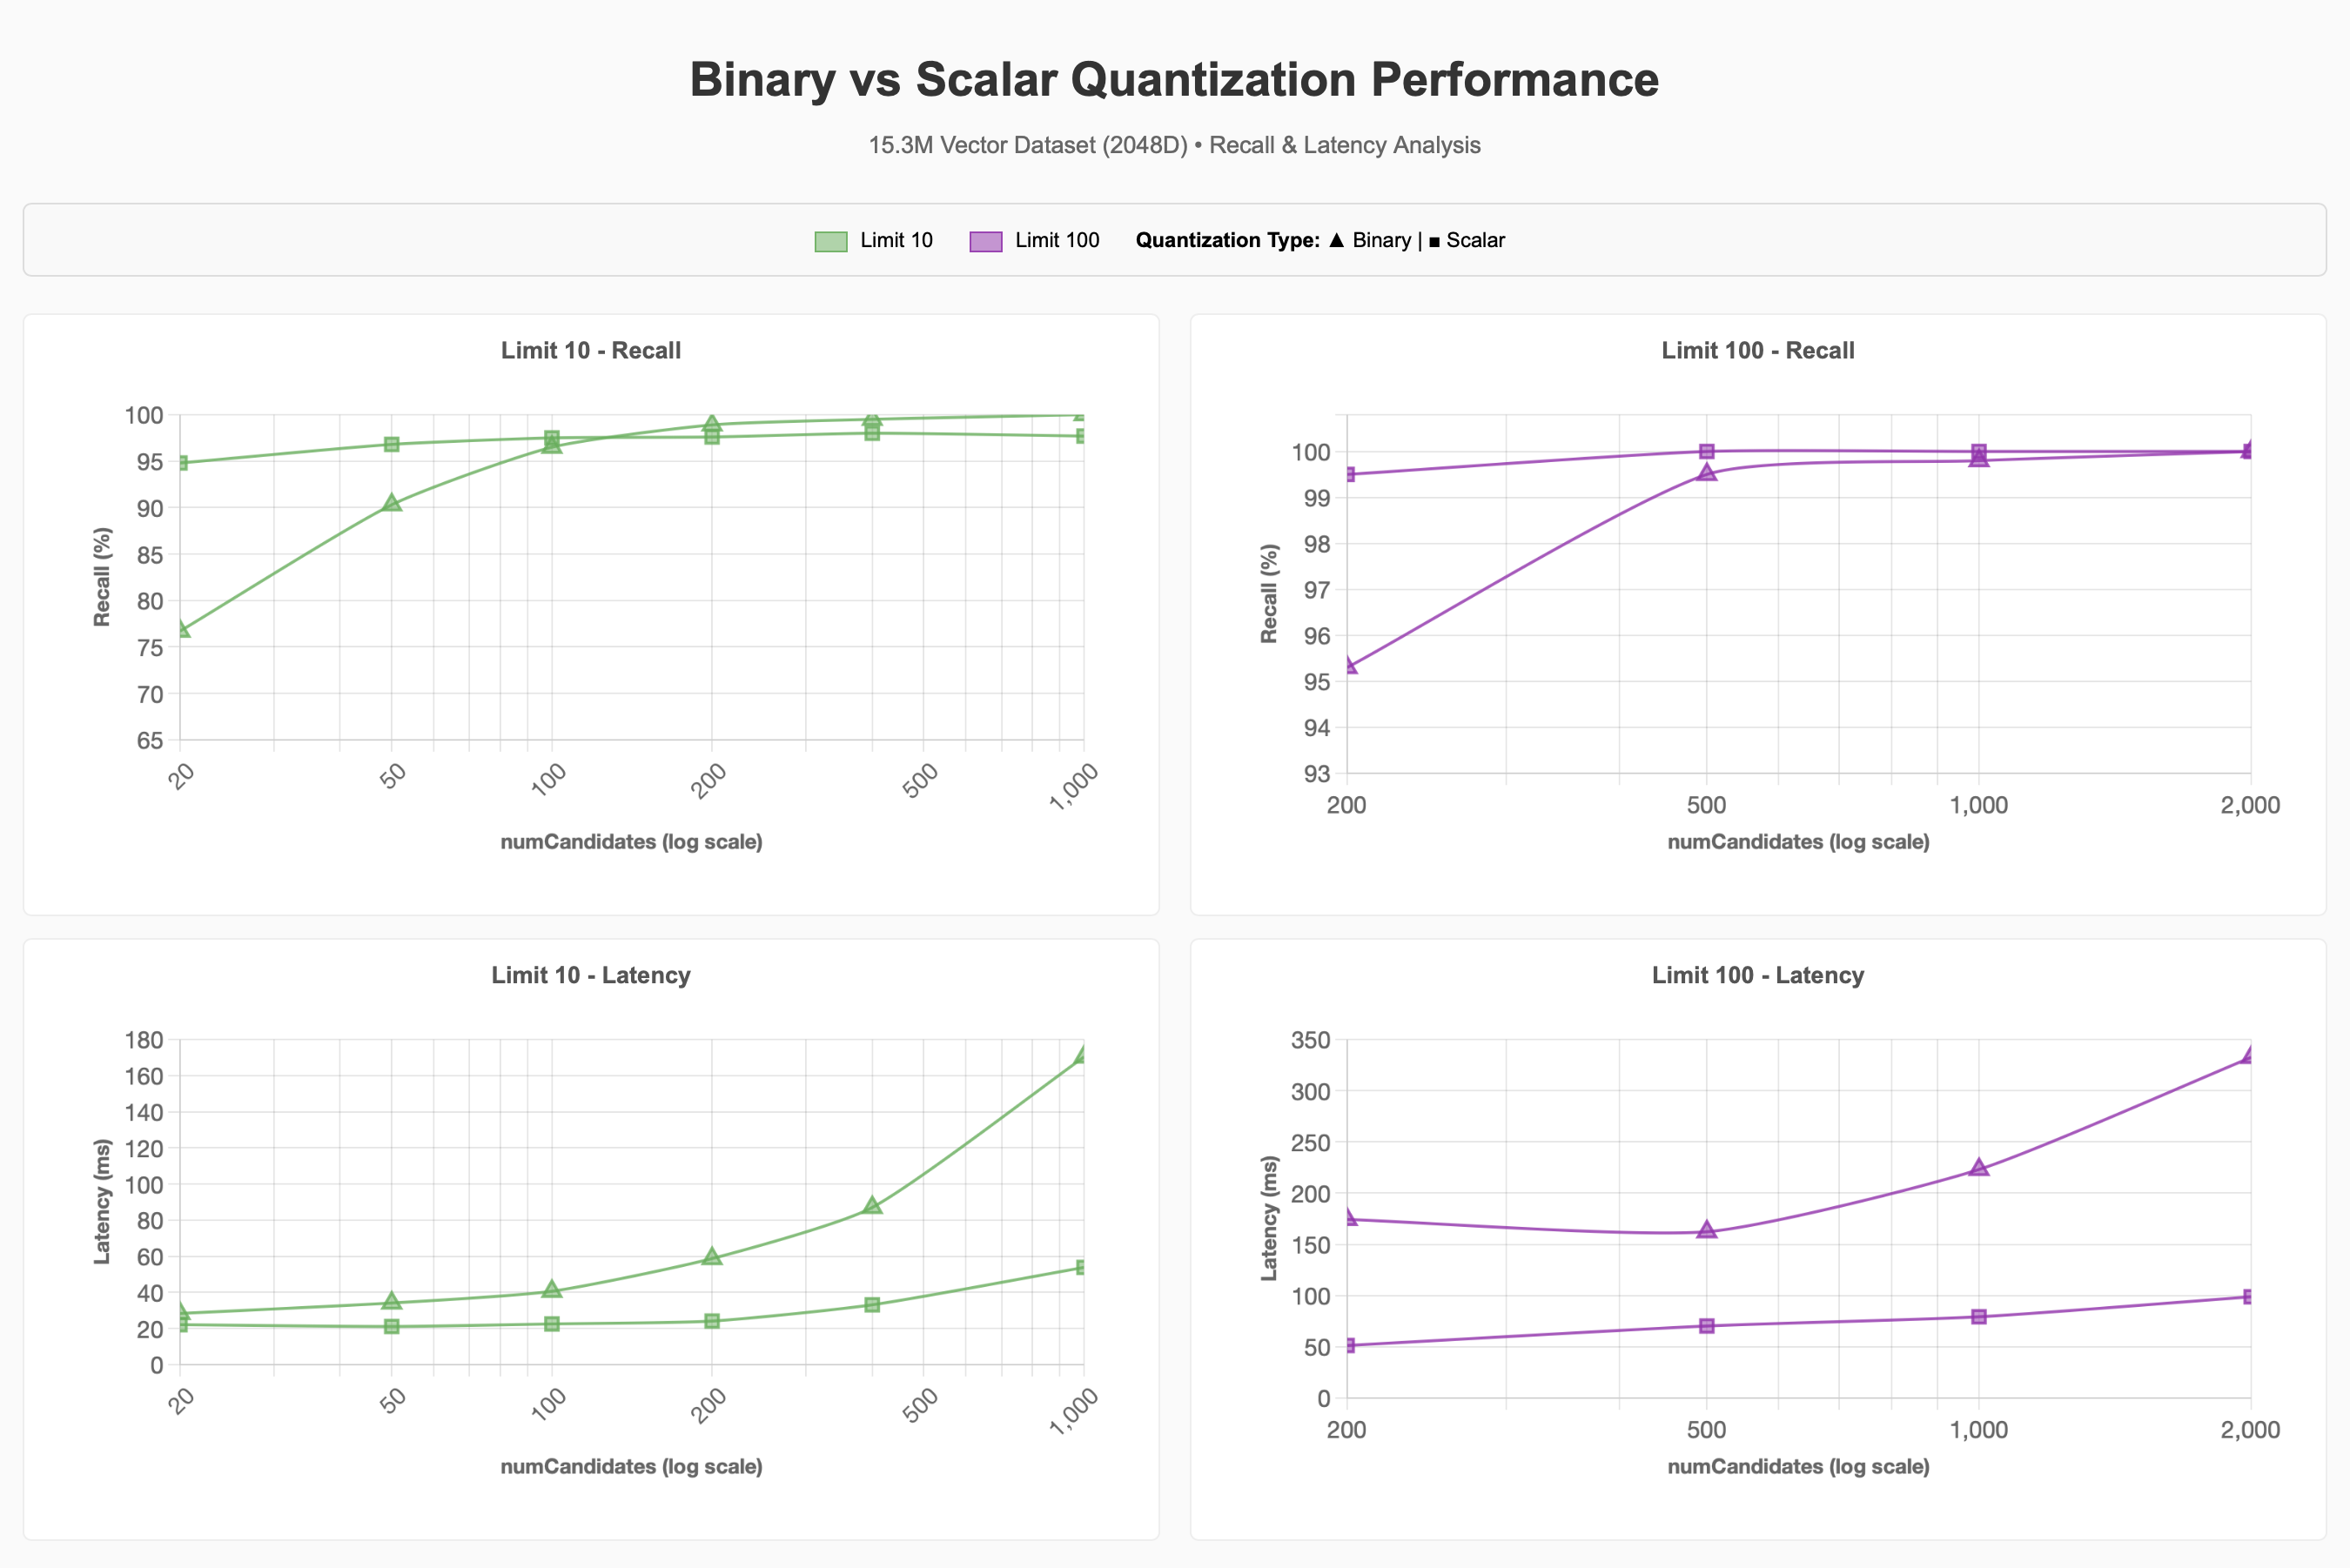
Para o maior conjunto de dados vetoriais de 15,3 milhões, fixamos a dimensionalidade em 2048d e examinamos o impacto da quantização, filtro e simultaneidade no desempenho. Escolhemos fixar em 2048d com base nos resultados do conjunto anterior de testes, que mostraram que dimensões maiores mantiveram a recuperação de modo mais favorável, embora 1024d provavelmente teria servido igualmente bem para atingir a meta de recuperação de 90-95%.
Análise de recall e latência
Observamos que é necessário significativamente mais numCandidates ao utilizar a quantização binária para alcançar a meta de recall de 90–95% em comparação com a linha de base. Valores mais altos de numCandidates geralmente significam maior latência, mas isso pode variar.
Filtragem
Observamos o que acontece com a recuperação e a latência ao usar um filtro seletivo no conjunto de dados para ~500 mil dos 15,3 milhões de itens da categoria de suprimentos para animais (~3% do corpus):
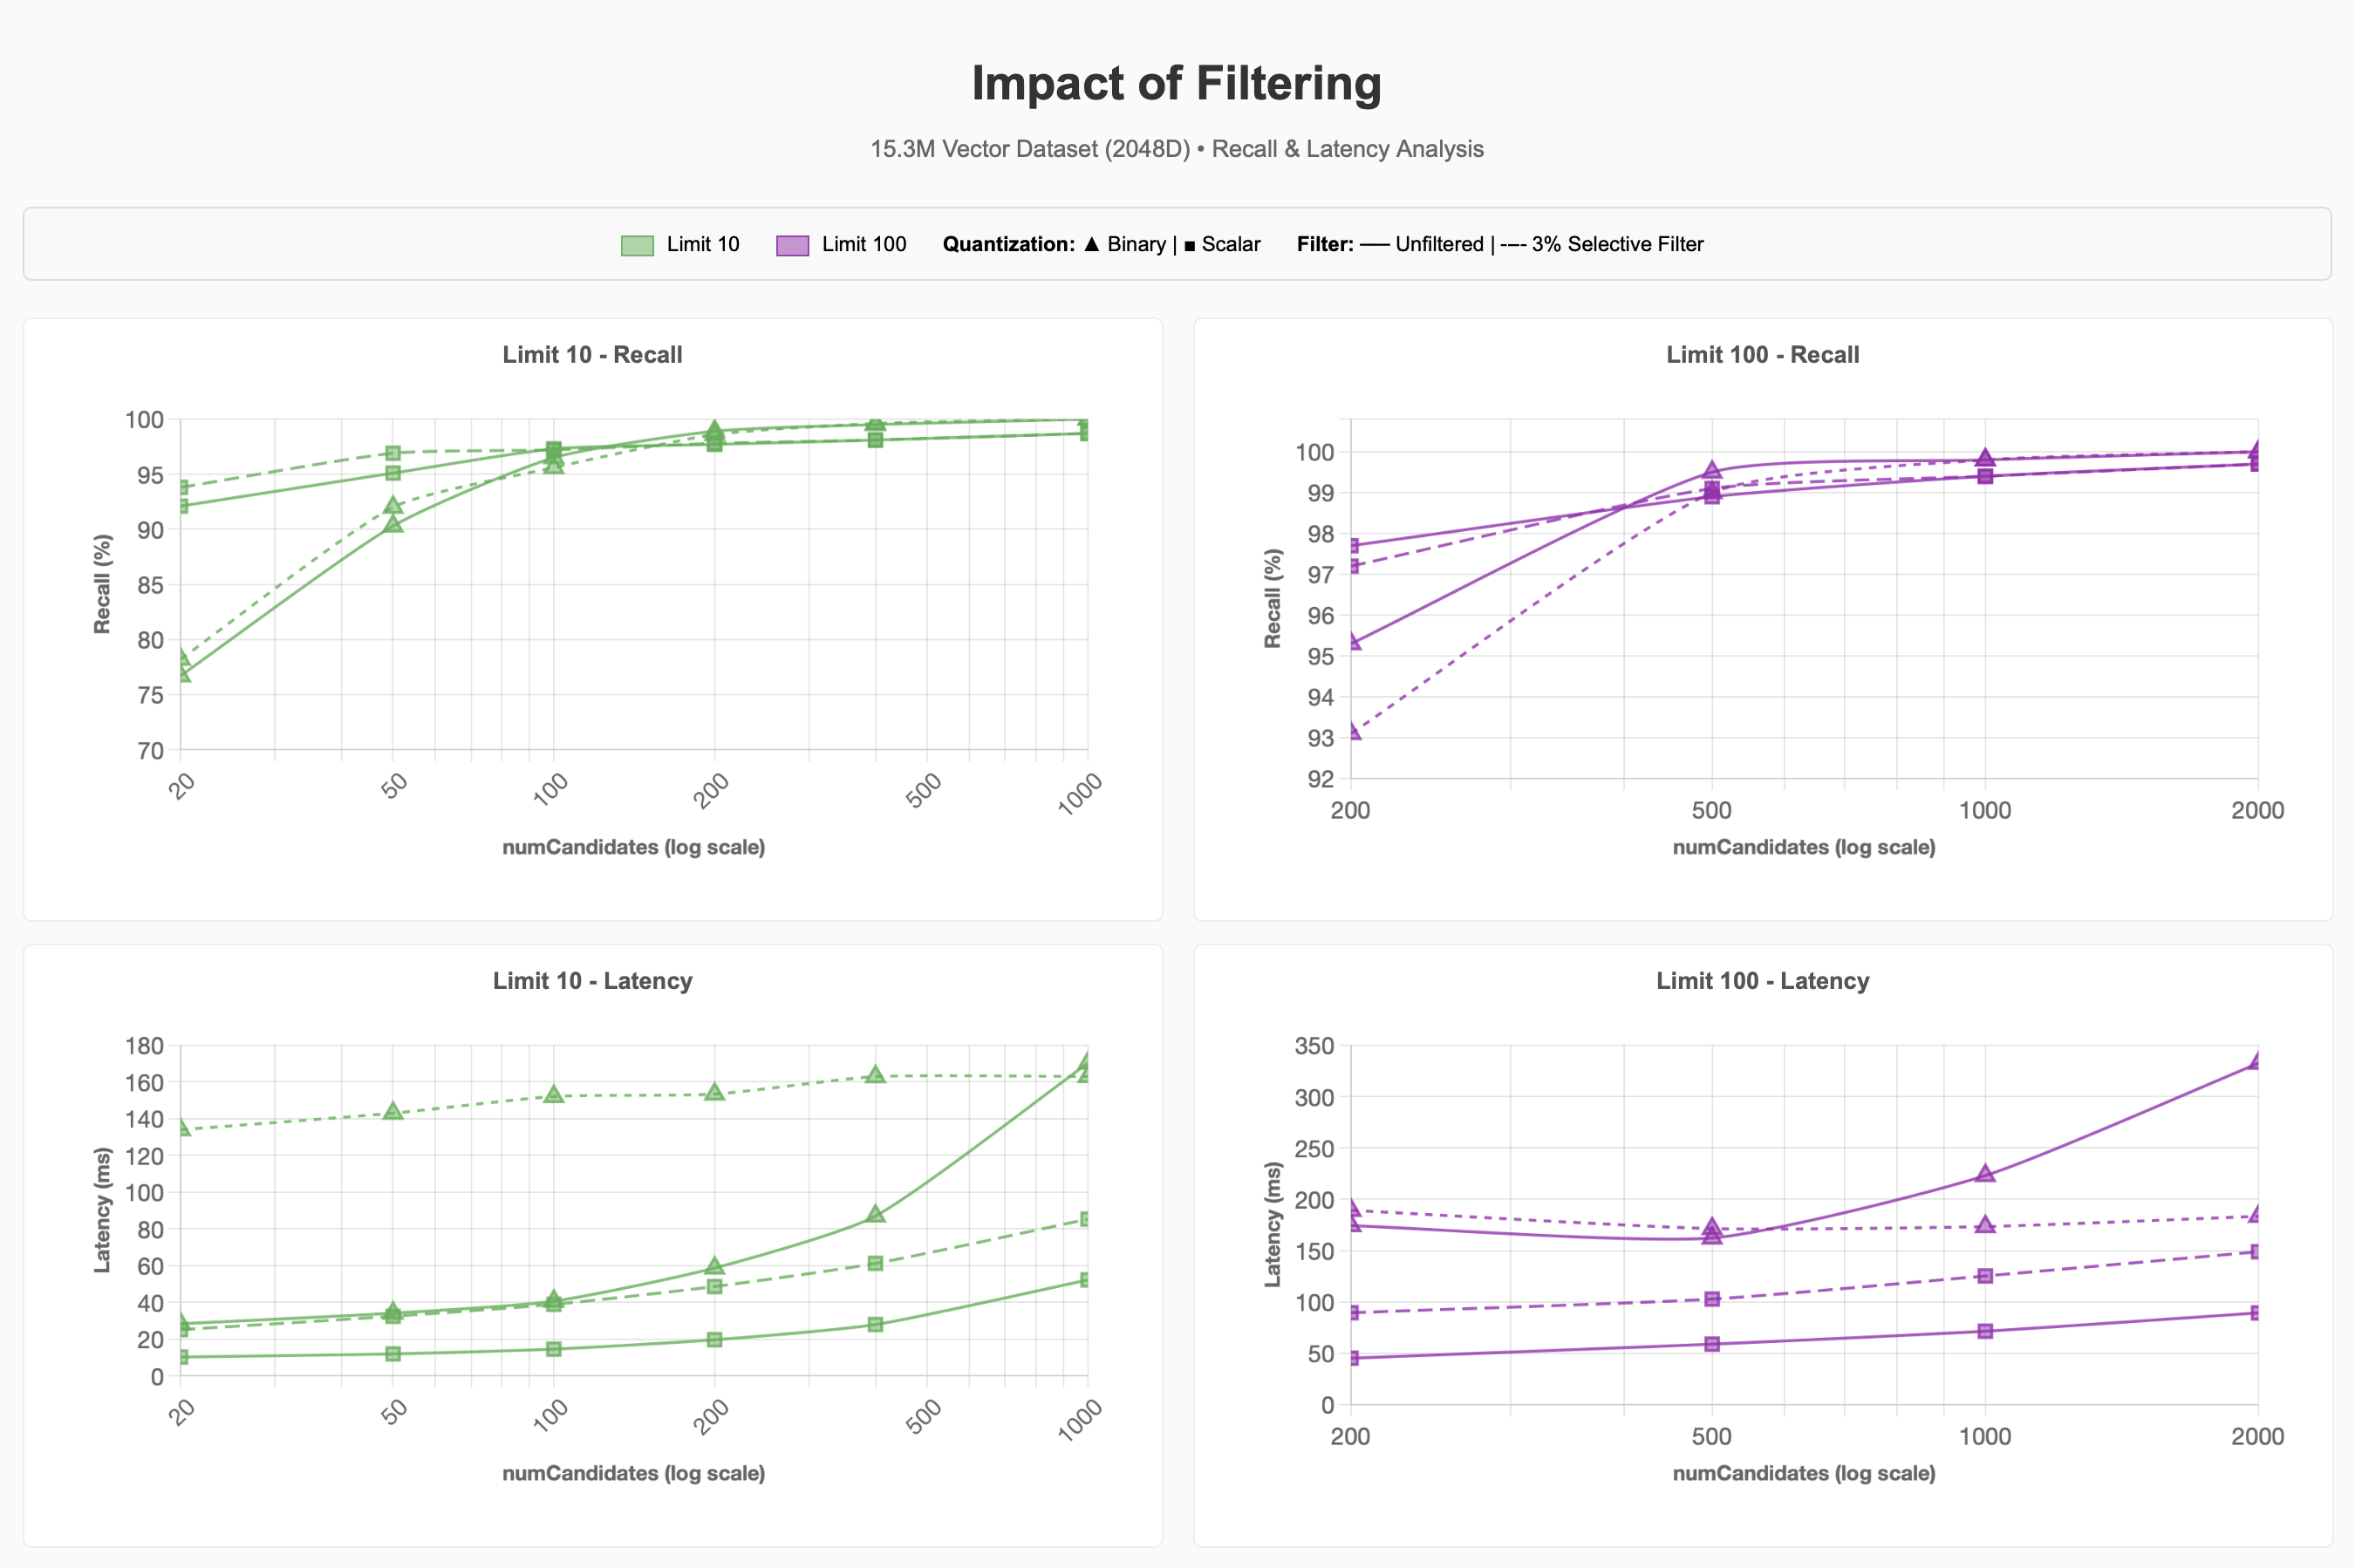
Um filtro seletivo é um filtro que corresponde apenas a uma pequena parte dos dados (neste caso, ~3%). Como o mecanismo de busca agora deve encontrar os vizinhos mais próximos dentro deste pequeno subconjunto, ele precisa explorar mais do índice e avaliar mais candidatos para atingir o mesmo recall. Cada query exige mais trabalho do que uma query não filtrada.
Como esperado, podemos ver que o filtro seletivo de 3% pode fazer com que as query façam mais trabalho. Para a quantização binária em valores limit mais baixos, isso exigiu aproximadamente 4x mais trabalho para alcançar 90-95% de recall em comparação com as queries não filtradas.
Melhorias futuras no Lucene 10, que suportam estratégias de pesquisa Acorn-1 para Mundos Pequenos Hierárquicos Navegáveis, podem melhorar esse processo. No entanto, a execução de ENN quando o número de candidatos solicitados excede o número de vetores correspondentes ao filtro de metadados dentro de um segmento demonstra que a seletividade do filtro desempenho um papel importante no desempenho da query, independentemente do esquema de quantização selecionado.
Concurrency
Esses testes dimensionam solicitações simultâneas entre 1, 10 e 100 nos vários valores de limit ao usar quantização escalar e binária. numCandidates são selecionados escolhendo valores que permitem alcançar uma recuperação de 90–95%:
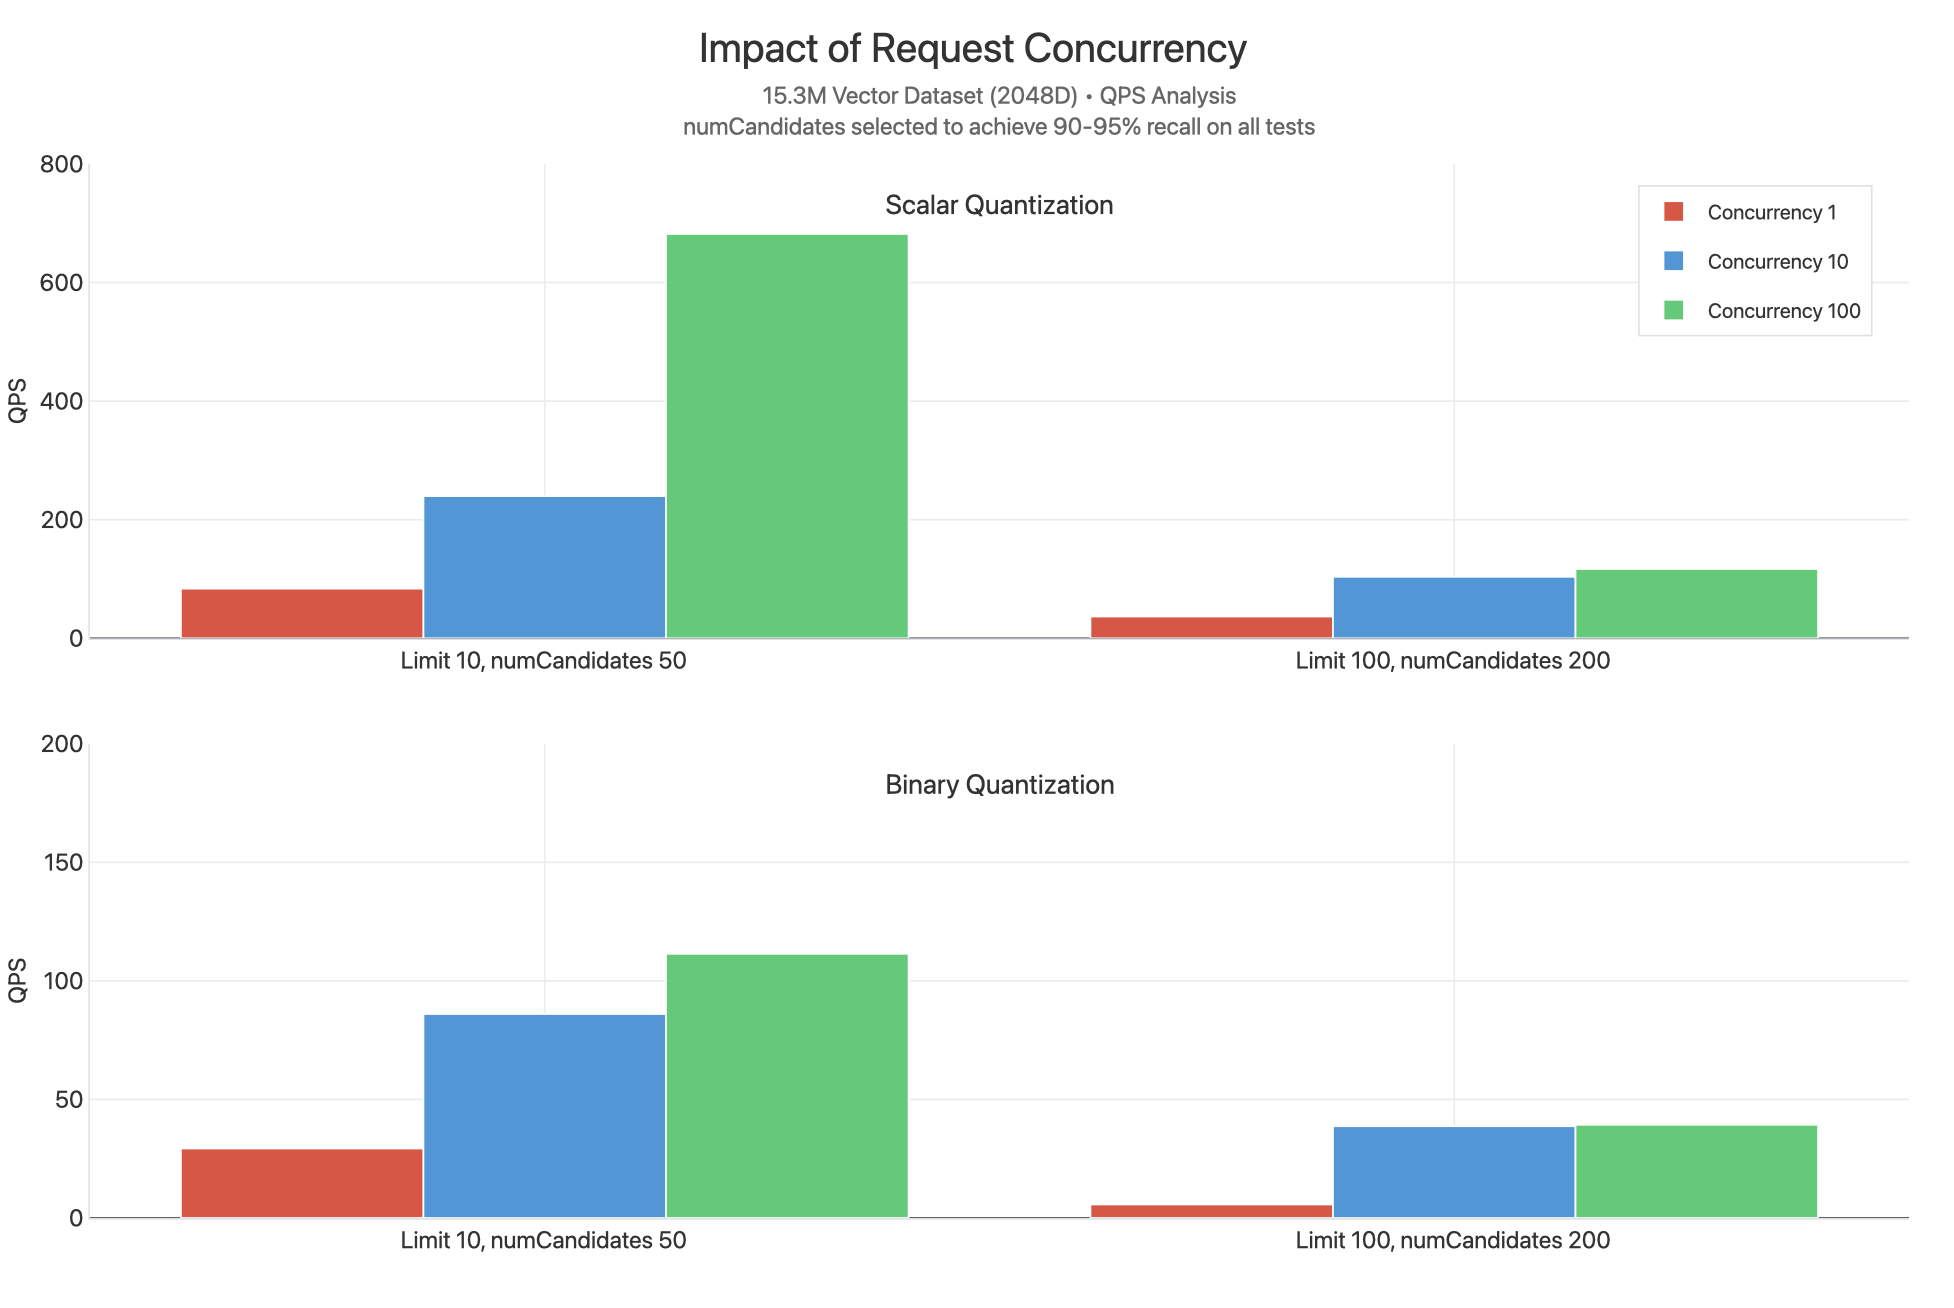
Observamos que a quantização escalar alcança QPS mais alto em todos os valores de limit, provavelmente porque cada query pode ser concluída com menor numCandidates e sem rescoring. Em simultaneidades mais altas, as curvas de QPS para simultaneidade 10 e simultaneidade 100 estão próximas, sugerindo que o sistema está usando eficientemente os recursos de CPU disponíveis e que a simultaneidade adicional afeta principalmente a latência.
Um ponto de dados excepcional é o limite 10, simultaneidade 100 para quantização escalar, resultando em QPS significativamente mais alto. Isso provavelmente ocorre porque a ausência de rescoring e valores mais baixos de limit significam que menos comparações são realizadas para essa query, permitindo que cada solicitação retorne mais rapidamente e disponibilize os núcleos para servir outras queries.
O dimensionamento do número de vCPUs disponíveis para servir solicitações, aumentando o nível do nó de pesquisa ou o número de nós de pesquisa do mínimo de 2 até 32 nós, pode ajudar a resolver gargalos de simultaneidade e permitir que você dimensione bem até milhares de QPS.
Fragmentação
Também observamos o que aconteceria se o cluster e a coleção fossem fragmentados (em _id) e queries não filtradas fossem emitidas contra um índice quantizado binário.
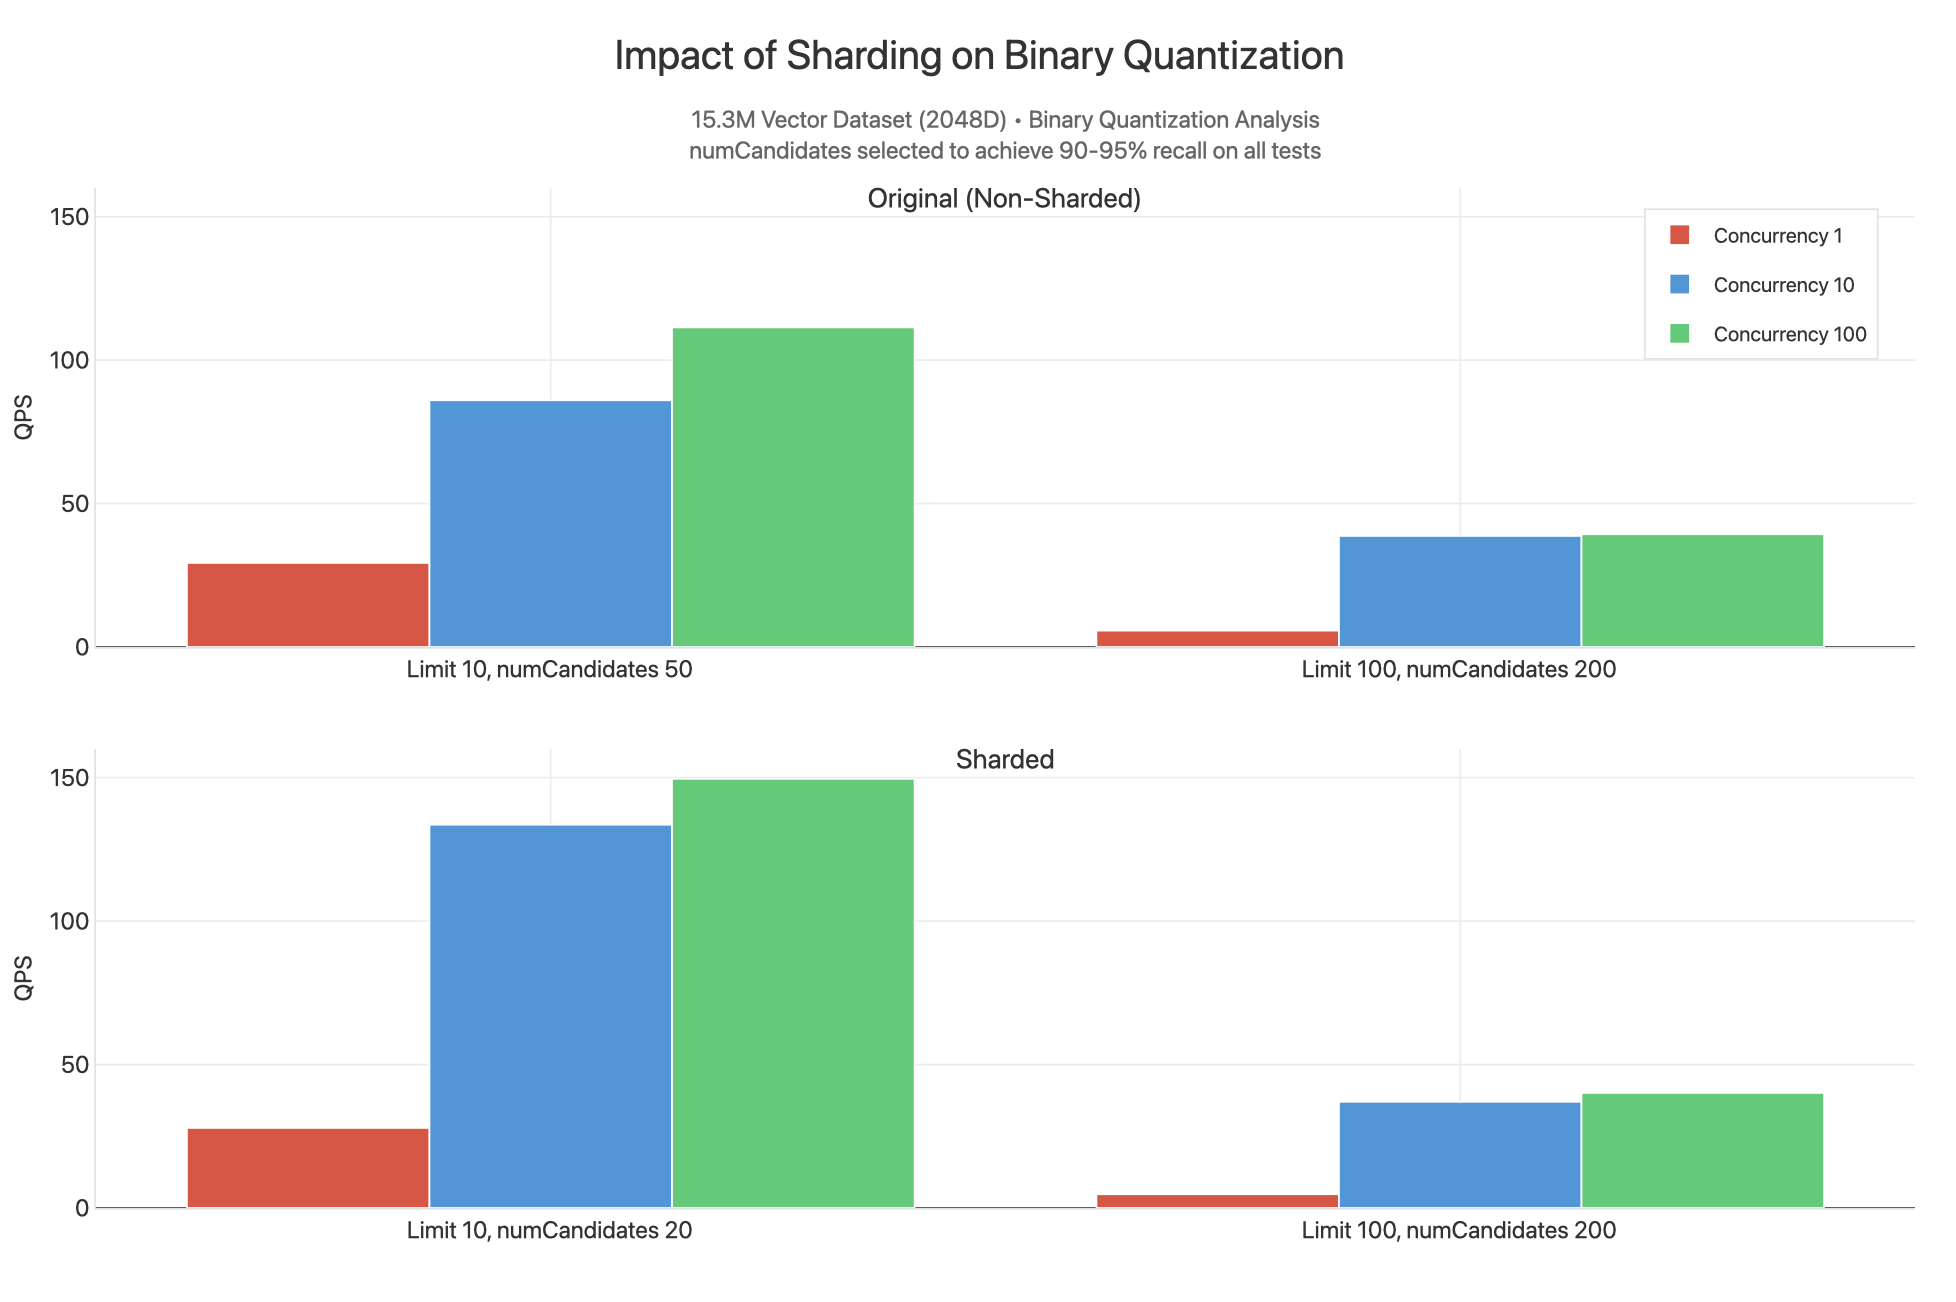
Aqui observamos que os resultados sharded apresentam um QPS mais alto no limite 10, pois um valor menor de numCandidates pode ser fornecido para gerar resultados na faixa de recall de 90–95%. Isso ocorre porque o conjunto de dados de 15.3milhões é divisão em três shards, cada um com seus próprios índices preenchidos com 5.1milhões vetores espalhados por segmentos contendo grafos HNSW. Funcionalmente, estamos realizando uma pesquisa menos avançada, na qual é mais provável que cada query dispersa e reunida em 3 fragmentos simultaneamente encontre os n vetores mais próximos. Por essa razão, o QPS é ligeiramente maior ao usar sharding, pois é possível reduzir numCandidates e ter mais núcleos disponíveis para servir queries, mas a diferença não é muito significativa. Como o desempenho da pesquisa vetorial permanece confiável, você não precisa shard seu cluster para dimensionar sua taxa de transferência.
Observação
Os valores são semelhantes para o limite 100 e o número de candidatos 200. Podemos esperar que isso tenha um desempenho melhor para consultas filtradas com uma correspondência inteligente da chave de fragmento usada como filtro.