AnúncioApresentando MongoDB 8.0, o MongoDB mais rápido de todos os tempos! Leia mais > >>
AnúncioVoyage AI se junta ao MongoDB para impulsionar aplicativos de AI mais precisos e confiáveis no Atlas. Saiba mais > >>

O que é Inteligência Artificial (IA)?

Experimente o MongoDB Atlas gratuitamente

A inteligência artificial (IA) é uma tecnologia que permite às máquinas pensar racionalmente, resolver problemas e tomar decisões sem a supervisão de uma mente humana. Com o surgimento das tecnologias de aprendizado de máquina e aprendizado profundo, as máquinas são capazes de "pensar" e "aprender" com base nos dados fornecidos a elas e realizar tarefas que antes só podiam ser executadas por humanos. Neste artigo, exploraremos mais sobre inteligência artificial, IA generativa e como o MongoDB está mudando o cenário da IA generativa ao simplificar o processamento de IA, permitir pesquisas baseadas em contexto e aprimorar a precisão dos grandes modelos de linguagem (LLMs).

Índice

Inteligência artificial explicada

A inteligência artificial é um campo da ciência da computação que capacita as máquinas a raciocinar, tomar decisões inteligentes e analisar dados em uma escala considerada superior à capacidade humana de compreensão e processamento. Ela inclui campos como ciência de dados, estatística, neurociência e aprendizado de máquina, que também abrange técnicas de aprendizado profundo, nas quais muitos algoritmos modernos se baseiam. Esses algoritmos são a base para que a IA tome decisões semelhantes às humanas, identificando padrões nos dados e realizando tarefas difíceis com facilidade e precisão.

Alguns exemplos populares de sistemas de inteligência artificial incluem o ChatGPT, assistentes virtuais como Alexa e Siri, carros autônomos e motores de recomendação.

Como a IA é semelhante à inteligência humana

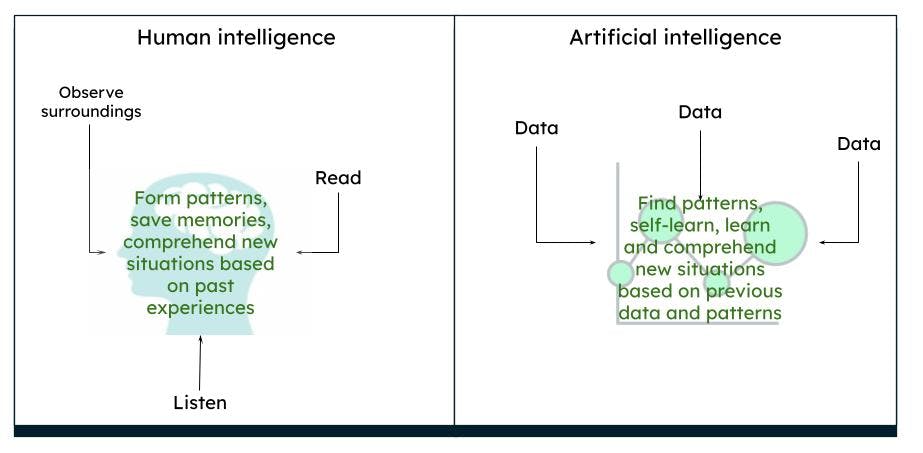
O cérebro humano funciona de forma complexa. Nós pensamos, agimos e tomamos decisões com base em nossas experiências passadas e memórias, identificando padrões em nosso ambiente e nas situações que vivenciamos. Com o tempo, passamos a observar aquilo que nosso cérebro percebe como verdadeiro. Por exemplo, se sempre vemos uma rosa vermelha, nosso cérebro processa a informação de que a rosa tem a cor vermelha, além de determinada forma e tamanho. Se lemos ou ouvimos que rosas também podem ser amarelas ou rosas, com base em nosso conhecimento prévio de uma rosa vermelha, imaginamos que uma rosa amarela ou rosa se assemelhe, de certa forma, a uma rosa vermelha.

Representação da inteligência humana vs. inteligência artificial

A IA funciona da mesma maneira. Quando um computador é alimentado com dados suficientes, ele é capaz de derivar certos resultados, com base nos padrões dos dados, por meio de algoritmos. Por exemplo, se você alimentar dados sobre rosas e cores, da próxima vez que o computador encontrar um objeto semelhante, ele poderá identificar o objeto como uma rosa de uma cor específica.

IA vs. aprendizado de máquina

IA é um termo mais amplo que abrange teorias e sistemas para construir máquinas que executam tarefas que requerem inteligência. Aprendizado de máquina é um ramo da IA que se concentra na análise de dados para identificar padrões e orientar decisões por meio de diversos algoritmos, sem a necessidade de programação explícita. As técnicas de aprendizado de máquina incluem métodos de aprendizado supervisionado, não supervisionado e por reforço.

Saiba mais sobre como nosso Grupo de Pesquisa de Aprendizado de Máquina do MongoDB está contribuindo para os avanços mais recentes em aprendizado de máquina.

Aprendizagem profunda

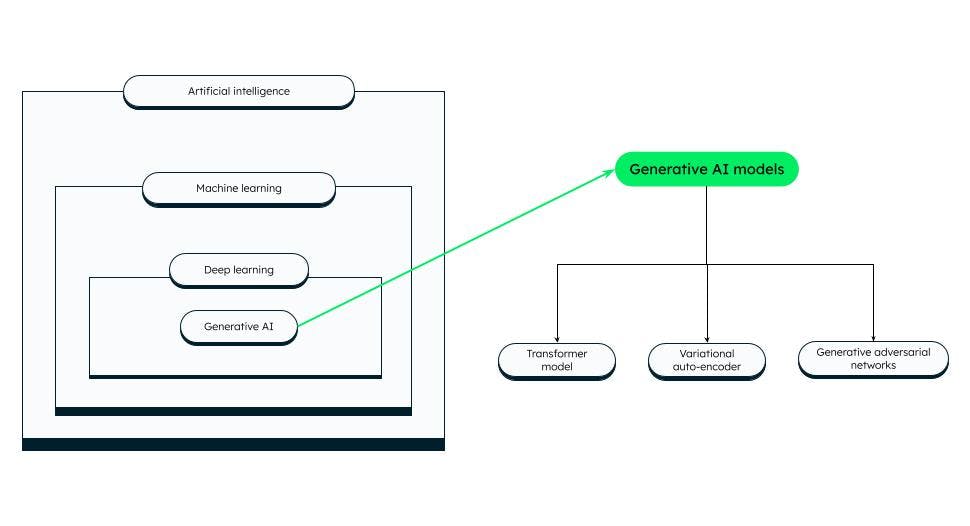
O aprendizado profundo é um subconjunto do aprendizado de máquina que se assemelha à inteligência humana. Os modelos de aprendizado profundo consistem em redes neurais artificiais profundas, ou seja, neurônios (ou nós) interconectados, e têm muitas camadas, o que lhes permite processar padrões de dados mais complexos do que os algoritmos de aprendizado de máquina. LLMs e IAs generativas são subconjuntos do aprendizado profundo. Existem muitas redes neurais artificiais que podem ser usadas para tarefas específicas.

Todas essas redes neurais são baseadas em um “perceptron”, que é a rede neural mais básica usada para classificação binária. Um perceptron consiste em uma única camada de neurônios que utiliza uma camada de entrada, aplica pesos e a alimenta na camada de saída.

Abaixo estão vários tipos comuns de aprendizagem profunda:

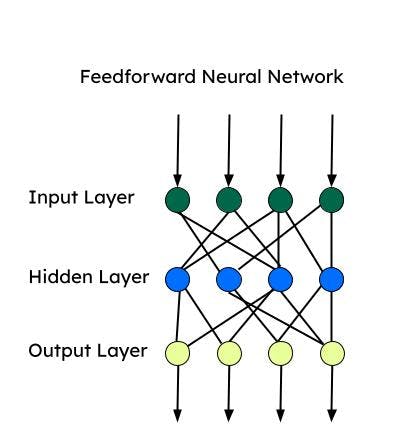
Feedforward neural network (FNN)

A rede feedforward é uma das primeiras redes neurais artificiais desenvolvidas e consiste em vários perceptrons organizados em camadas. Também é conhecida como perceptron multicamadas (MLP). Essa rede transmite informações em apenas uma direção — para a frente —, sem ciclos de realimentação. As redes neurais feedforward possuem camadas de entrada e saída e uma camada oculta que processa os dados de entrada. As FNNs são usadas no aprendizado supervisionado quando os dados não são temporais nem sequenciais.

Redes neurais convolucionais (CNN)

As CNNs são um tipo de FNN usado em tarefas complexas de classificação de imagens, visão computacional, análise de imagens e processamento de linguagem natural. Uma CNN analisa uma região da imagem por vez e avança processando um número menor de parâmetros a cada etapa para aprender ou extrair as características mais importantes. A extração de características é feita usando kernels durante uma operação de convolução.

Redes neurais recorrentes (RNN)

RNNs são mais adequadas para dados sequenciais, nos quais a ordem dos dados de entrada é crucial. A informação sequencial é capturada por meio de um ciclo na camada de entrada. RNNs são mais adequadas para dados de séries temporais e processamento de linguagem natural. A memória de longo e curto prazo (LSTM) é um tipo de RNN que possui células de memória para armazenar as dependências presentes nos dados sequenciais. As LSTMs apresentam bons resultados em tarefas de reconhecimento de fala, análise de sentimentos e tradução.

Autoencoder

Autoencoders consistem em um codificador e um decodificador. Os codificadores comprimem a dimensionalidade dos dados, reduzindo-os a um espaço de menor dimensão (espaço latente). Os decodificadores reconstroem os dados de entrada a partir do espaço latente. Os autoencoders podem ser usados para remoção de ruído, redução de dimensionalidade e aprendizado de características.

Redes de autoatenção (SANs)

A arquitetura codificador-decodificador pode memorizar sequências mais curtas. No entanto, pode esquecer algumas informações (particularmente, as informações recebidas primeiro) em uma sequência longa. Com um mecanismo de atenção, o decodificador pode considerar toda a sequência e utilizar seu contexto completo para gerar a saída. A autoatenção permite que todo o texto de entrada seja processado de uma só vez e estabelece relações entre todas as palavras da sequência. Com esse recurso, a autoatenção processa dependências de longo alcance mais rapidamente do que uma RNN ou CNN.

História da inteligência artificial

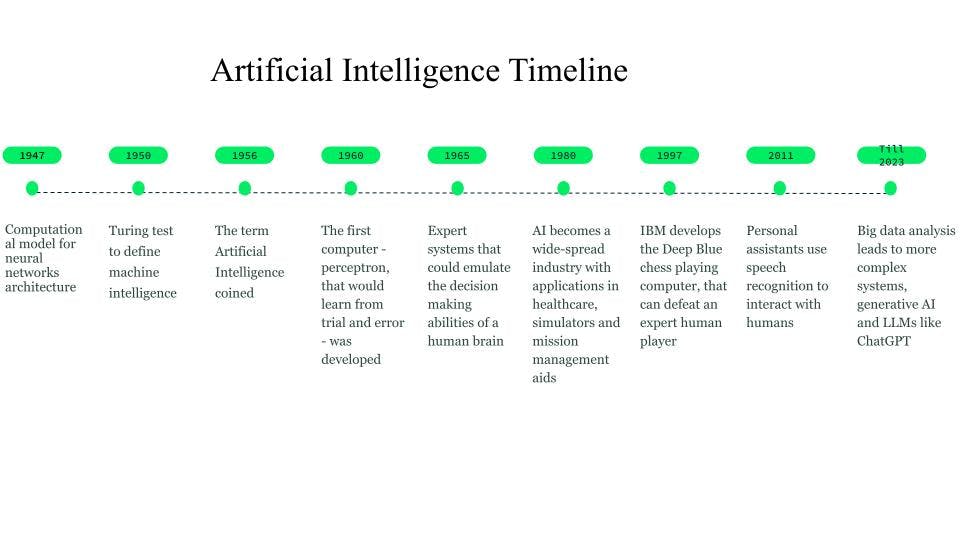
Embora as primeiras concepções tenham começado já em 750 a.C. através de livros e ideias baseadas em ficção científica e máquinas pensantes, os primeiros fundamentos para redes neurais foram estabelecidos em 1947 por Walter Pitts e Warren McCulloch, que criaram um modelo computacional para a arquitetura de redes neurais.

Em 1950, Alan Turing introduziu o teste de Turing para definir a inteligência das máquinas.

O termo inteligência artificial foi cunhado em 1956, quando John McCarthy organizou um workshop de IA e definiu o termo como a ciência e engenharia de tornar as máquinas inteligentes. Por volta do início da década de 1960, Frank Rosenblatt desenvolveu o primeiro programa de computador – o Perceptron – que um programa de IA aprenderia por tentativa e erro. Mais tarde, em 1963, John McCarthy fundou o laboratório de IA.

O próximo grande avanço em IA veio por meio dos sistemas especialistas, sistemas computacionais baseados em conhecimento que exigem inteligência humana e podem simular a capacidade de tomada de decisões de um especialista humano. Esses sistemas foram formas bastante bem-sucedidas de IA e utilizados em áreas como saúde, simuladores de combate e treinamento e sistemas de gestão de missões. Durante a década de 1980, a inteligência artificial tornou-se uma indústria na qual bilhões de dólares foram investidos em sistemas especialistas, sistemas de visão e robótica.

Em 1997, o desenvolvimento do Deep Blue, o computador de xadrez da IBM que derrotou o então campeão mundial de xadrez, criou um interesse adicional em inteligência artificial. Desde então, observaram-se rápidos desenvolvimentos no campo.

Por volta de 2010, pesquisadores que trabalhavam com tradução de linguagem natural descobriram que, em comparação com modelos baseados em regras, os modelos alimentados com grandes quantidades de dados de texto diversificados produziam resultados muito melhores. Em 2011, assistentes pessoais como Cortana, Siri e Alexa, que podiam responder a perguntas por meio do processamento de linguagem natural e realizar tarefas, entraram em cena.

Em 2014, os modelos de linguagem começaram a compreender o contexto em que uma palavra aparecia. Trabalhos posteriores resultaram em modelos de linguagem gerais que forneceram modelos base ou fundamentais que poderiam ser adaptados para um caso de uso ou domínio específico.

Esses modelos de base nos levaram à IA generativa e aos grandes modelos de linguagem (LLMs) como o ChatGPT. Junto com isso, a IA agêntica está surgindo como uma tecnologia relacionada - um tipo de sistema de inteligência artificial que pode tomar decisões e realizar ações de forma autônoma e se adaptar a ambientes em mudança para alcançar um objetivo específico.

Histórico e cronologia da IA

Tipos de IA

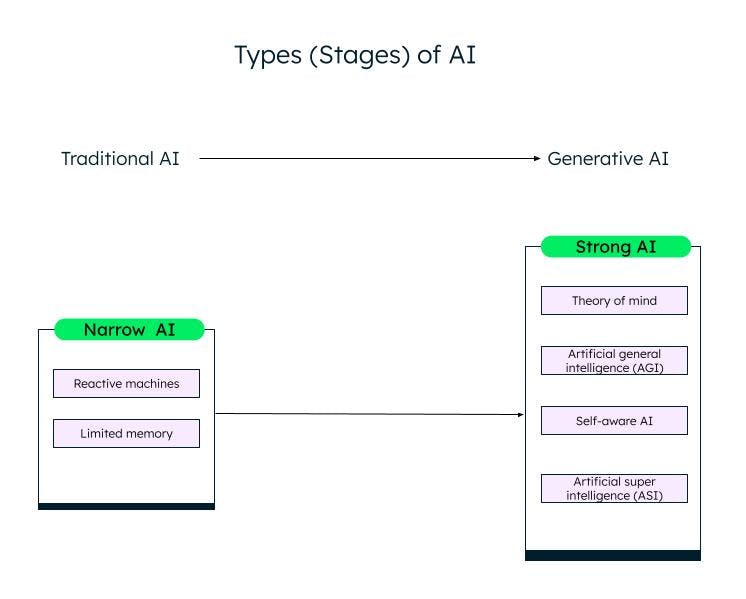
Uma classificação ampla da inteligência artificial, com base em sua funcionalidade, é a IA estreita (ou fraca) e a IA forte. Por meio de pesquisas e avanços no campo dos algoritmos de aprendizado de máquina e de aprendizado profundo, estamos passando da IA fraca para a IA forte.

IA fraca

Os sistemas de IA fraca/IA estreita, ou de inteligência artificial estreita (IAN), são treinados para executar tarefas específicas e têm capacidades limitadas com base nos dados com que são treinados. Eles também são conhecidos como sistemas tradicionais de IA, nos quais o sistema pode responder de maneira inteligente com base em um determinado conjunto de entradas e regras. Entretanto, esses sistemas não conseguem criar nada novo.

As IAs tradicionais ou fracas são ainda classificadas em duas categorias: máquinas reativas e memória limitada.

Máquinas reativas

As máquinas reativas, que não tinham memória, foram a forma mais antiga de inteligência artificial, mas podiam emular a capacidade humana de responder a diferentes estímulos. Elas não podem aprender com a própria experiência (não têm memória) e baseiam suas respostas em uma combinação limitada de entradas. A máquina Deep Blue da IBM é uma máquina reativa.

IA de memória limitada

Os sistemas de memória limitada possuem memória e podem aprender e tomar decisões com base nos dados de entrada fornecidos. A maioria das IA que vemos, como carros autônomos, chatbots, assistentes pessoais como Alexa e sistemas de recomendação como o da Netflix, são todos exemplos de IA com memória limitada.

IA forte

Com a inovação do ChatGPT e outros modelos de IA generativa semelhantes, estamos entrando lentamente na fase de IA forte. A IA generativa é um tipo de IA de última geração, que pode criar algo novo com base nas entradas do usuário. O ChatGPT é um exemplo de IA generativa baseada em grandes modelos de linguagem (LLM). Muito mais trabalho precisa ser feito em IA forte, que pode ser categorizada da seguinte forma:

Teoria da mente (ToM)

A teoria da mente (ToM) é uma capacidade cognitiva de compreender os diferentes estados mentais de outras pessoas — como crenças, pensamentos e sentimentos — para explicar seus comportamentos e ações. Pesquisadores estão trabalhando na aplicação da teoria da mente (ToM) à IA, com o objetivo de permitir que os sistemas de IA entendam as emoções e os estados mentais dos seres humanos. O ChatGPT, um novo sistema de IA capaz de interagir com humanos em linguagem natural e produzir conteúdo original, demonstrou algumas capacidades relacionadas à teoria da mente durante os testes. Entretanto, ainda não possui a capacidade de compreender desejos, crenças ou emoções. As respostas do ChatGPT são baseadas em dados e padrões comuns.

Inteligência geral artificial (AGI)

A inteligência artificial geral é a próxima etapa do desenvolvimento da IA, em que um sistema ou agente de IA se comportará exatamente como um humano, incluindo a construção independente de múltiplas competências e funcionalidades, bem como a formação de conexões e generalizações, com pouco ou nenhum treinamento.

Autoconsciente

A próxima etapa é um ponto de singularidade da IA, onde as máquinas estarão conscientes de si mesmas. Elas terão seus próprios desejos, crenças e emoções, além de compreender as emoções, desejos e crenças humanas. Agentes autoconscientes podem ser utilizados na área da saúde e na robótica.

Superinteligência artificial (ASI)

A IA autoconsciente pode levar à ASI, na qual agentes de IA podem se tornar sistemas de superinteligência artificial e superar os humanos em valores e motivações. As IAs autoconscientes e as ASIs podem levantar problemas relacionados ao emprego e à ética, para os quais pesquisadores e governos precisam estar alertas e estabelecer regras e diretrizes.

Diferentes estágios (tipos) de IA
Modelos base

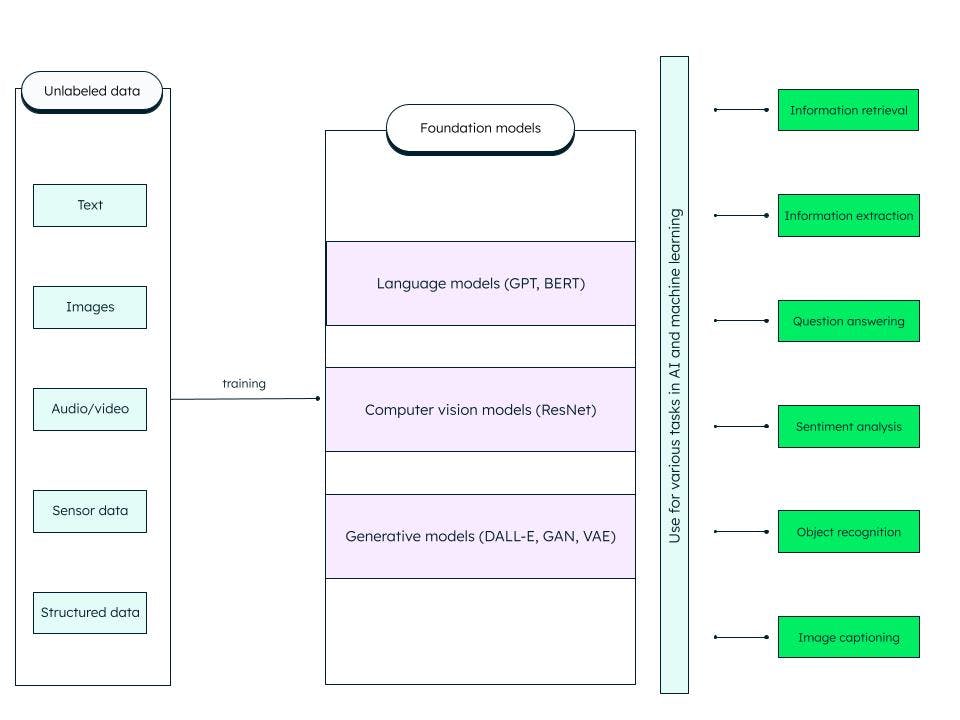
Modelos de base são redes neurais profundas artificiais generalizadas treinadas com grandes quantidades de dados não estruturados. Eles são criados para servir como modelos de finalidade geral. Podemos criar modelos mais específicos para tarefas de IA e aprendizado de máquina personalizando esses modelos de base (fundamentais) pré-treinados.

Por exemplo, um modelo de base como um grande modelo de linguagem treinado com dados textuais pode ser usado para uma variedade de tarefas, como recuperação de informações e perguntas e respostas. O transformador generativo pré-treinado (GPT), no qual o famoso ChatGPT se baseia, e o BERT (representações de codificadores bidirecionais de transformadores) são exemplos de modelos de base do tipo LLM. A ResNet (rede residual) é um tipo popular de modelo de base para tarefas de visão computacional, como classificação de imagens. Os modelos de base são muito adaptáveis e podem aprender de forma autossupervisionada e ser aprimorados por meio de prompts e ajustes finos.

O que o modelo de base inclui?

IA generativa

A IA generativa é baseada em modelos de base que podem realizar tarefas como classificação, preenchimento de frases, geração de imagem ou voz, e dados sintéticos (gerados artificialmente). Os modelos de base são ajustados para se adequarem à tarefa geradora específica em questão. O sucesso de um modelo de IA generativa depende da qualidade e diversidade dos dados, bem como da velocidade de geração.

Modelos de IA generativa

Existem diferentes categorias de modelos de IA generativa, das quais algumas proeminentes são:

Modelo Transformer

A arquitetura baseada em transformers é bastante precisa na identificação de relacionamentos contextuais entre palavras (dados). A geração de texto, a tradução automática e a modelagem de linguagem, como o GPT (usado no ChatGPT), são exemplos de arquitetura transformer.

Atenção é tudo que você precisa

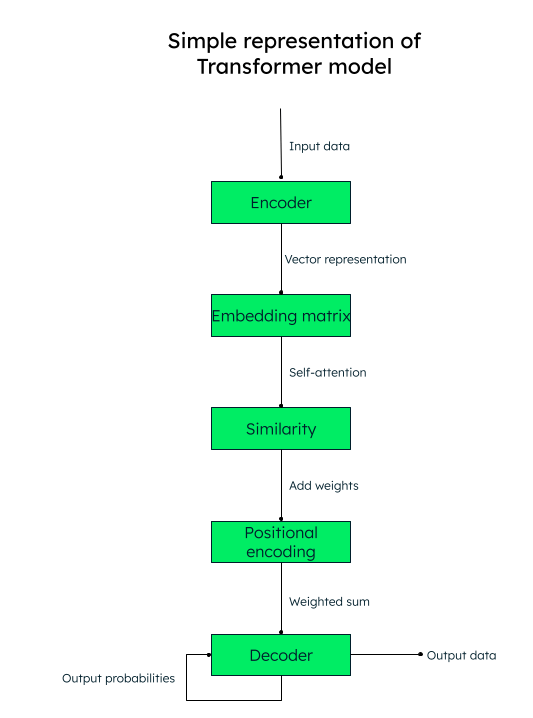
O modelo de transformador opera com um mecanismo de autoatenção, no qual a importância de cada elemento de uma sequência de entrada é ponderada durante o processamento do texto, permitindo capturar informações contextuais de forma eficaz.

Por exemplo, se você quiser traduzir o texto em inglês "I love to write about artificial intelligence" para o espanhol, o modelo de transformador enviará essa sequência de palavras (tokens) ao codificador (rede neural). As palavras de entrada são convertidas em uma representação vetorial numérica (embeddings de palavras), composta por vetores de consulta (query), chave (key) e valor (value), necessários para a transformação.

Por exemplo, para a palavra "love" em nossa frase, teríamos os vetores q*love, k*love e v_love. Uma matriz é criada com as pontuações de similaridade entre cada par de palavras. Por exemplo, seriam calculadas as pontuações de similaridade entre a palavra "love" e todas as outras palavras da frase. Uma pontuação mais alta indica maior similaridade.

O próximo passo é calcular os pesos de atenção que determinam a importância atribuída a cada palavra da frase em relação à palavra-chave principal ("love", no nosso caso). Em seguida, as codificações posicionais são adicionadas às representações vetoriais. Os embeddings posicionais (similaridade + codificação posicional) ajudam o decodificador (outra rede neural) a determinar a ordem em que os tokens de saída (palavras) devem aparecer.

Representação do modelo Transformer

Autoencoders variacionais (VAEs)

Os VAEs são bastante populares para geração de imagens, compactação de dados e remoção de ruído de imagens. Em um VAE, a rede neural do codificador recebe os pontos de dados de entrada e os mapeia para uma representação no espaço latente. Um espaço latente é uma representação dos dados em um espaço de menor dimensionalidade, obtida pela extração das características mais importantes e pelo descarte das demais. A rede neural do decodificador reconstrói os dados de saída com base na representação latente.

Redes adversárias generativas (GANs)

As GANs são amplamente utilizadas para criar imagens realistas, arte, vídeos deepfake, tradução de imagem para imagem e imagens de super resolução. Uma GAN consiste em um gerador (rede neural) que recebe ruído aleatório ou uma semente como entrada e cria amostras de dados sintéticas (como uma imagem). As amostras de dados sintéticos são então alimentadas em outra rede neural, o Discriminador, que utiliza classificação binária para determinar se as amostras são falsas ou reais. Por meio de treinamento adversário, o gerador e o discriminador são treinados simultaneamente até que um ponto de equilíbrio de Nash seja atingido, onde o gerador pode produzir dados realistas de alta qualidade (como imagens) e o discriminador categoriza com precisão se são reais ou falsos.

Grande modelo de linguagem (LLM)

Os grandes modelos de linguagem (LLMs) são modelos de base treinados em grandes conjuntos de dados e oferecem aos usuários uma experiência envolvente, com respostas de alta precisão. Para poder criar esses modelos, é necessário coletar grandes quantidades de dados de várias fontes, armazená-los corretamente e processá-los e recuperá-los conforme sua relevância, quando necessário.

LLMs podem ser utilizados para resolver problemas gerais, como responder a perguntas, gerar, classificar e resumir textos, além de usar técnicas de ajuste fino e prompts para treinar modelos com conjuntos mínimos de dados para resolver problemas específicos.

Como funciona um LLM?

Os modelos de base aprendem a partir de padrões nos dados e produzem resultados flexíveis e generalizáveis, que podem ser aplicados a diferentes situações específicas. Um desses exemplos é o LLM, que é aplicado a entradas de texto. LLMs são compostos por dados, arquitetura e treinamento. Os dados geralmente consistem em petabytes de conteúdo textual, incluindo livros extensos e conversas. A arquitetura é uma rede neural profunda e, no caso do GPT, é baseada no transformador. Durante o treinamento, o modelo aprende a prever a próxima palavra de qualquer sentença fornecida.

Porém, existem três problemas com o LLM:

  • Se alguma informação surgir ou for alterada depois que o modelo estiver completamente treinado, ele não terá conhecimento dessa informação e poderá fornecer resultados desatualizados. Por exemplo, se você perguntar ao modelo: "Dê-me uma lista de bons filmes de comédia dos últimos seis meses", o modelo não será capaz de fazer isso se tiver sido treinado seis meses antes!

  • O modelo pode conter informações incorretas em sua representação interna.

  • O modelo não pode acessar seus dados privados e pode apresentar informações tendenciosas ou incompletas com base em conhecimento limitado.

Geração aumentada de recuperação (RAG)

O framework de IA RAG visa resolver os problemas mencionados e melhorar a qualidade das respostas dos LLMs, fornecendo ao modelo informações factuais de referência provenientes de uma Base de Conhecimento externa, que complementa as informações apresentadas internamente no LLM. Isso reduz as chances de o modelo identificar incorretamente um padrão ou objeto inexistente (alucinações) e de produzir informações incorretas, enganosas e desatualizadas.

A arquitetura de recuperação usa um armazenamento vetorial e amplia as capacidades do LLM por meio da pesquisa vetorial.

MongoDB Atlas, a plataforma unificada de dados, fornece pesquisa vetorial na plataforma, que você pode configurar em alguns passos simples, para aprimorar a saída do seu LLM e produzir resultados mais precisos.

Na seção anterior, aprendemos sobre o modelo de transformador e vimos que os vetores são representações numéricas de dados textuais. Por exemplo, a representação vetorial da nossa frase anterior, "Eu adoro escrever sobre inteligência artificial", poderia ser semelhante a:

"Eu adoro... " = [0,33, 0,45, 0,72, -0,23…..]

A representação vetorial acima inclui as relações entre as palavras, como a relação da palavra "artificial" com "inteligência" ou "escrever", e o contexto da palavra "amor" nessa frase.

Esses vetores são gerados (como vimos no modelo de transformador) quando os dados de entrada passam por uma rede neural profunda (codificador).

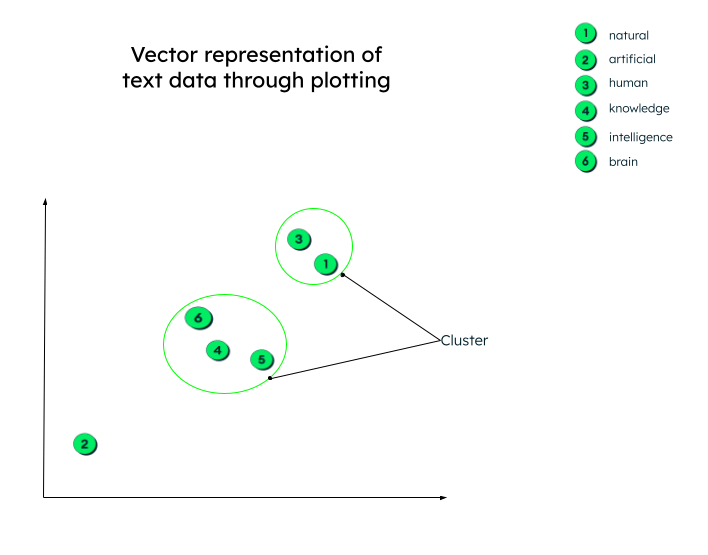
Na realidade, as representações vetoriais podem ter qualquer número de dimensões. Quanto mais parâmetros os dados tiverem, mais dimensões terão. Para compreender esses números e entender o que acontece após a geração desses vetores, vamos representá-los em um gráfico bidimensional para facilitar a compreensão.

Todos os vetores são representados graficamente de acordo com seus valores numéricos. Observe que embeddings (vetores) com significados semelhantes são representados próximos uns dos outros no gráfico, formando um agrupamento (cluster).

Representação gráfica de vetores

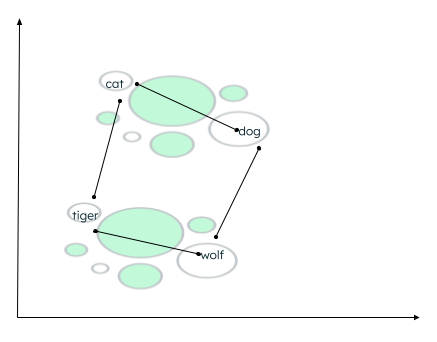
Pode haver muitos contextos nos quais os dados podem ser agrupados. O relacionamento depende de como o codificador incorpora os dados de origem e de como a distância entre os vetores é calculada. No exemplo abaixo, dois tipos de relacionamentos podem ser estabelecidos:

  • Tanto gatos quanto cães são animais domésticos, enquanto tigres e lobos são animais selvagens.
  • Gatos e tigres pertencem à mesma família, assim como cães e lobos pertencem à mesma família de animais.

Cálculo da distância de palavras semelhantes

Uma função de similaridade determina quais palavras estão mais próximas umas das outras e as identifica como vizinhas. Esse agrupamento (clustering) é feito usando o algoritmo dos k vizinhos mais próximos (k-NN), em que o valor de k representa o número de vizinhos a serem identificados. Para calcular a similaridade, a pesquisa vetorial oferece vários métodos, como:

  • Distância euclidiana entre as extremidades dos dois vetores.
  • Cosseno (ângulo) entre os dois vetores.
  • Produto escalar dos vetores.

O MongoDB Atlas oferece recursos de pesquisa de vetores dentro da própria plataforma Atlas, por meio de frameworks de IA, e suporta todas as funções de similaridade mencionadas anteriormente.

O MongoDB sempre ofereceu suporte à pesquisa vetorial em duas dimensões. No entanto, a nova pesquisa vetorial habilita funcionalidades avançadas devido ao embedding e permite dimensões maiores.

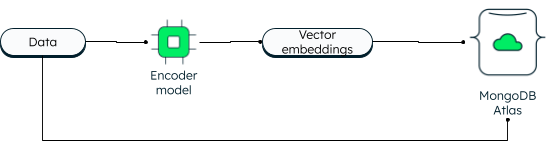
Os aplicativos podem gravar tanto os dados quanto os embeddings vetoriais no banco de dados. Os vetores de dados são gerados usando um modelo de codificador. A pesquisa do Atlas usa o algoritmo Approximate Nearest Neighbor (ANN) por meio do grafo Hierarchical Navigable Small World (HNSW). ANN é uma variação do algoritmo dos k vizinhos mais próximos (k-NN), mas oferece maior velocidade de recuperação.

Como os vetores são armazenados no MongoDB Atlas

Durante a leitura, a query é codificada e enviada ao estágio de agregação $search, juntamente com o vetor-alvo. Se você quiser conhecer as etapas, siga o tutorial sobre criação de aplicativos de IA generativa usando o MongoDB.

A vantagem de ter vetores junto com os dados operacionais é que você pode acessar todas as informações em uma única plataforma, até mesmo seus dados privados, que não seriam acessíveis de outra forma.

A pesquisa vetorial do Atlas simplifica a arquitetura de seu aplicativo. Como o MongoDB Atlas é totalmente gerenciado, a plataforma cuida de tudo, desde a sincronização de dados até a segurança e a privacidade. Os desenvolvedores podem trabalhar com o database e a vector search usando a MongoDB Query API. Você pode implementar o Atlas em mais de 125 regiões em três grandes fornecedores de serviços em nuvem. O Atlas oferece tempo de atividade contínuo com automação avançada que garante alto desempenho, independentemente da escala do aplicativo.

Alguns casos de uso importantes da pesquisa vetorial do Atlas incluem:

  • Pesquisa semântica.
  • Sistemas de perguntas e respostas.
  • Extração de recursos.
  • Pontuação de recomendação e relevância.
  • Geração de sinônimos.
  • Pesquisa de imagens.

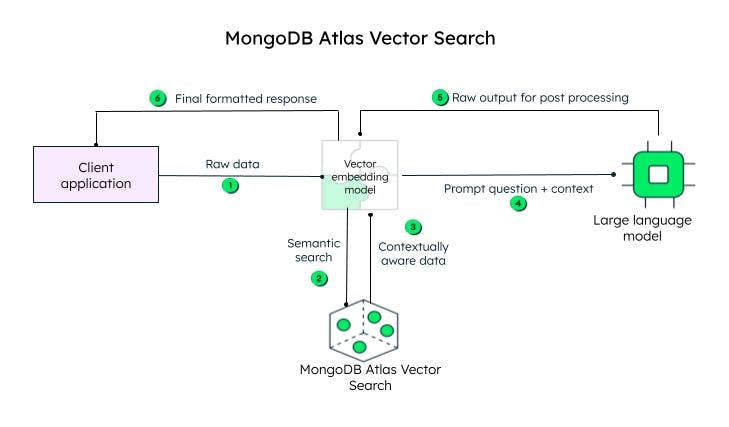
Como funciona a pesquisa de Atlas Vector?

O aplicativo cliente envia os dados brutos. O modelo de embedding vetorial cria vetores para cada texto na query inicial (dados brutos). Frameworks como LlamaIndex e LangChain se integram bem ao MongoDB Atlas para criar embeddings e enviar dados ao MongoDB, acrescentando informações contextuais. A query contextualizada, conhecida como prompt, é então enviada a um LLM, que gera uma resposta codificada para ser processada pelo modelo de embedding vetorial (decodificador) e enviada ao cliente após a decodificação.

Etapas para realizar pesquisa vetorial no MongoDB Atlas

Os embeddings vetoriais podem ser armazenados em um documento do banco de dados MongoDB como uma matriz de números de ponto flutuante, juntamente com o conteúdo, no campo content_embeddings.


Se o número de dimensões nos dados de entrada for maior, o número de pontos flutuantes será maior.

Em seguida, você define a definição de índice adicionando-a ao construtor de definição:


A definição do índice inclui o modelo que encontraria os clusters de similaridade, as dimensões e a função de similaridade (entre os três métodos compatíveis com o MongoDB) que seria usada pelo modelo.

É isso! Apenas dois passos e você terminou.

Para pesquisar, você pode usar o estágio de agregação $search, especificando o operador knnBeta e fornecendo os embeddings vetoriais da query no campo vetorial. Você também deve especificar o caminho para os embeddings de conteúdo que devem ser considerados na pesquisa vetorial. O MongoDB também fornece filtros adicionais para restringir a pesquisa e permite definir o número de vizinhos mais próximos que o algoritmo k-NN deve retornar.


Como tanto os embeddings vetoriais quanto os dados estão armazenados na mesma plataforma, você pode acessar sua carga de trabalho operacional e os vetores por meio de uma única API unificada, a MongoDB Query API. Para aprender a usar a funcionalidade passo a passo, consulte nosso tutorial sobre criação de aplicativos de IA generativa usando pesquisa vetorial.

Casos de uso importantes de IA

A IA está sendo aplicada com sucesso em diversos domínios, incluindo varejo, saúde e manufatura. Alguns casos de uso populares da IA são:

  • Processamento de linguagem natural (NLP): a IA é amplamente utilizada em tarefas como análise de sentimentos, assistentes virtuais, chatbots, reconhecimento de fala e tradução de texto. Como vimos acima, usando o poder dos LLMs e da pesquisa vetorial, os sistemas de IA podem produzir resultados em linguagem humana.

  • Visão computacional: com redes neurais modernas, os sistemas de IA são capazes de realizar com precisão classificação de imagens, reconhecimento facial e de objetos, e geração de imagens.

  • Sistemas de recomendação e filtragem de conteúdo: os sistemas de IA podem recomendar conteúdo aos usuários usando modelos de aprendizado profundo e aprendizado de máquina sem intervenção humana.

  • Assistência médica: a tecnologia de inteligência artificial elevou a área da saúde a um novo patamar ao auxiliar os médicos no diagnóstico precoce de doenças, na pesquisa médica e na descoberta de medicamentos, além de armazenar com segurança os registros eletrônicos de saúde dos pacientes.

  • Carros autônomos: os carros autônomos são movidos por algoritmos de IA, dados do sensor e visão computacional.

  • Robótica: os robôs industriais estão aumentando a produtividade ao realizar tarefas complexas com precisão. Da mesma forma, robôs de serviço são capazes de desempenhar suas tarefas de forma eficiente nos setores de saúde e hospitalidade.

Uso ético da IA, governança da IA e regulamentações

Com os rápidos avanços na área da IA, é importante estabelecer regras e regulamentações e considerar as questões éticas para garantir que os sistemas de IA sejam usados de maneira justa, transparente e para os fins adequados.

A ética da IA concentra-se nas implicações morais e éticas das ferramentas e tecnologias de IA — ou seja, justiça, privacidade, transparência e responsabilidade.

O governo define os frameworks, a estrutura e as regras de conformidade para regulamentar a IA e garantir seu uso responsável.

O governo também cria regulamentações de IA — ou seja, estruturas jurídicas — para garantir a segurança dos dados, a proteção dos consumidores e o cumprimento das normas de segurança.

Ferramentas e serviços de IA

Os dados são o núcleo de todas as operações de IA, e o MongoDB é uma plataforma confiável para criar aplicações avançadas de IA. Como um banco de dados com um esquema flexível, o MongoDB oferece uma solução de armazenamento centralizada, com funcionalidades integradas de gerenciamento de dados, processamento avançado de dados, análises em tempo real, escalabilidade e muito mais. Algumas outras ferramentas e serviços populares são:

  • ChatGPT: o ChatGPT praticamente se tornou parte do cotidiano, desde fazer perguntas simples até planejar férias, programar, escrever poesia e resumir textos.

  • Dall-E 2: Dall-E 2 é um projeto da OpenAI, assim como o ChatGPT, e gera gráficos de computador, como imagens, pinturas e desenhos, a partir de prompts de texto.

  • Stable Diffusion 2: uma ferramenta de IA que transforma texto em imagem para aplicações de IA generativa. Ao contrário das ferramentas da OpenAI, que são acessadas por meio de portais de navegador, o Stable Diffusion 2 está disponível para download e instalação, e os usuários podem acessar publicamente o código-fonte e os algoritmos.

Visite nosso Hub de Aprendizado de IA para saber mais sobre as soluções de IA do MongoDB.

Perguntas frequentes

Comece a usar o Atlas hoje mesmo

Comece em segundos. Nossos grupos gratuitos oferecem 512 MB de armazenamento para que você possa usar dados de amostragem e conhecer mais sobre a nossa plataforma.
Experimente grátisFale com a equipe de vendas
COMECE A USAR:
  • Mais de 125 regiões em todo o mundo
  • Amostragem de conjuntos de dados
  • Autenticação sempre ativada
  • Criptografia de ponta a ponta
  • Ferramentas de linha de comando