MongoDB ベクトル検索クエリは、 $vectorSearchを最初のステージとして使用する集計パイプラインの形式をとります。このページでは、$vectorSearch ステージの構文、オプション、および動作について説明します。
サポートされているクライアント
構文
フィールド
$vectorSearchステージは、次のフィールドを持つドキュメントを取得します。
ベクトル検索のタイプ
$vectorSearch ステージを定義する場合、exactフィールドを使用して近似最近傍探索または厳密最近傍探索を実行するかを指定できます。
Considerations
$vectorSearch は、それが表示されるすべてのパイプラインの最初のステージである必要があります。
制限
$vectorSearchは、ビュー定義と次のパイプライン ステージでは使用できません。
$facetパイプライン ステージ
| [1] | このステージには $vectorSearch の結果を渡すことができます。 |
過負荷保護
クエリ プロセスが検索プロセスで実行できるよりも速く到達した場合、Atlas は超過クエリをキューに入れ、489 エラーでクエリを拒否することができます。詳細については、「 クエリ ロード シェル と クエリの拒否 」を参照してください。
MongoDB ベクトル検索 インデックスの作成
これらのMongoDB ベクトル検索フィールドタイプの詳細については、「 ベクトル検索のフィールドにインデックスを作成する方法 」を参照してください。
MongoDB ベクトル検索 Score
MongoDB ベクトル検索 は、返されるすべてのドキュメントに、0 から 1 までの固定範囲のスコアを割り当てます(0 は類似性が低く、1 は類似性が高いことを示します)。
注意
データを事前にフィルタリングしても、 MongoDB ベクトル検索 が クエリにvectorSearchScore $vectorSearchを使用して返すスコアには影響しません。
MongoDB ベクトル検索フィルター
MongoDB ベクトル検索はデータのフィルターをサポートします。次の作業が可能です。
プレフィルターは、MongoDB ベクトル検索クエリで
filterオプションを使用してデータをフィルターします。書き込みフィルター を使用して MongoDB ベクトル検索クエリの結果をフィルターします。その他のサポートされている
$matchと 集計パイプラインステージ。
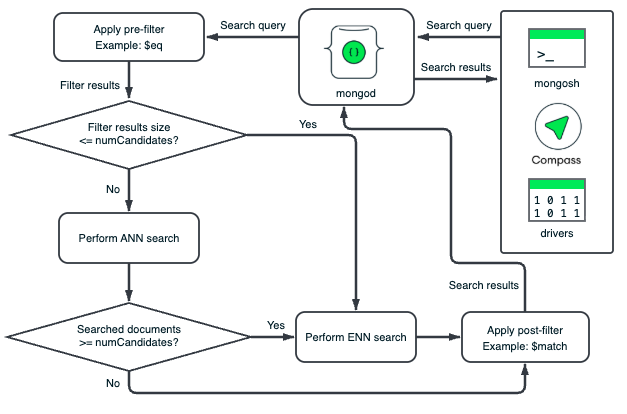
MongoDB ベクトル検索は、データのセグメントに対してプレフィルター操作と書き込みフィルター操作を独立して実行します。各セグメントの HNSW グラフは、そのセグメント内のベクトルのみに基づいています。MongoDB ベクトル検索は、フィルター条件を満たさないドキュメントを除外するために、各セグメントのドキュメントにフィルターを適用します。プレフィルターにより、MongoDB ベクトル検索が HNSW グラフをトラバースする前にドキュメントが除外され、書き込みフィルターにより、ドキュメント内の関連のないドキュメントまたはフィールドがベクトル検索結果から除外されます。
事前フィルター検索データ
データを事前フィルターすることで、セマンティック検索の範囲を絞り込み、比較対象として関連するベクトルのみが考慮されるようにできます。filter オプションを使用してデータを事前フィルターすると、MongoDBベクトル検索はデータのサブセットのみでセマンティック検索を実行し、検索結果の精度が向上します。
プレフィルターは制限が厳しすぎる可能性があります。プレフィルターはプレフィルターと正確に一致しないデータを除外する可能性がありますが、そのデータはベクトル検索中に考慮するクエリと意味的に類似しています。これを軽減するには、広範なフィルター条件を設定して、クエリが次のことを実行するようにすることをお勧めします。
可能な限り多くの関連する結果が含まれます。
結果から関係のないデータを除外します。
結果におけるリクエストされた数のドキュメントを返します。
重要
フィルターされたクエリは通常、同等のフィルターされていないクエリよりも遅くなります。
フィルター書き込みの検索結果
インデックスのサイズが事前フィルターに最適でない場合、または広範な事前フィルターの条件を設定した場合は、ベクトル検索の結果を書き込みフィルターして、関連するデータのみを返すことができます。ベクトル検索の結果をフィルターするには、集計パイプライン
ステージのような、サポートされている集計パイプライン ステージを使用できます。たとえば、$match ステージの後に $vectorSearch ステージを使用できます。詳しく学ぶには、その他のパフォーマンスの推奨事項を参照してください。
結果にすべてのフィールドが必要な場合を除き、結果に返すフィールドを選択するには、$project ステージを使用します。クエリのパフォーマンスを向上させるには、$project ステージでベクトル フィールドを除外することをお勧めします。
例として、$project ステージを使用して vectorSearchScore を含め、$match ステージを使用して特定のスコアスレッショールを超えるドキュメントのみを返すことができます。
フィルターに関する考慮事項
MongoDB ベクトル検索 は、
$eqの短縮形をサポートしています。短縮形式では、クエリに$eqを指定する必要はありません。$eqの付いた次のフィルターを例に挙げます。"filter": { "_id": { "$eq": ObjectId("5a9427648b0beebeb69537a5") }これは、
$eqの短縮形を使用する次のフィルターと同等です。"filter": { "_id": ObjectId("5a9427648b0beebeb69537a5") }$andMQL 演算子を使用すると、単一のクエリ内でフィルターの配列を指定することができます。たとえば、
genresフィールドがActionに等しく、かつyearフィールドの値が1999、2000、または2001に等しいドキュメントの次のプレフィルターを考えてみましょう。"filter": { "$and": [ { "genres": "Action" }, { "year": { "$in": [ 1999, 2000, 2001 ] } } ]}ファジー検索、フレーズ一致、ロケーション フィルタリング、ロケーション フィルタリング、その他の分析テキストなどの高度なフィルタリング機能については、vectorSearch 演算子を使用します。
$searchステージで。
例
前提条件
これらの例を実行する前に、次のアクションを実行する必要があります。
クエリで使用されるサンプルデータセット をクラスターに追加します。
コレクションの MongoDB ベクトル検索インデックスを作成します。手順については、MongoDB ベクトル検索インデックスの作成手順を参照し、希望する言語のサンプル クエリに合わせてインデックスを構成します。
クエリ
詳細
次のチュートリアルでは、$vectorSearch ステージのその他のユースケースを示します。