ユースケース: 人工知能、コンテンツ管理、インテリジェント検索
業種: 製造業
製品: MongoDB Atlas Search、 MongoDB Atlas Vector Search、 MongoDB Atlasでのハイブリッド検索
ソリューション概要
CMVR はインドのMotor Vehicles Act に基づいて発行された規則です。彼らは、国内で車両が製造、販売、または登録される前に満たす必要がある技術的要件と安全要件を定めます。AI は、ARAI によって開発および保守されている技術標準から構成されています。それらは、所定の CMVR 要件を満たしていることを示すために、車両またはコンポーネントがどのようにテストされる必要があるかを指定します。インド市場向けの車を製造する OEM は、次のドキュメントを使用します。CMVR は車両が満たす必要がある安全要件を規定し、対応する AIS はその満足度がどのようにテストされ、認証されるかを定めます。
規制および標準に関するコンテンツは、人々が適切なタイミングで適切な要件を見つけることができる場合にのみ価値があります。インドの OEM 向けのヘッドランプアセンブリの仕上げを行っている部品供給業者の技術者の例を考えてみましょう。パーツが認証のために ARAI に送られる前に、エンジニアは AIS-xyz の現行リビジョンを確認し、前回の提出以降に CMVR の "rule abc" が改正されているかどうかをチェックする必要があります。官報通知や規格のPDFが収納されたフォルダーでその条項を検索するには何時間もかかります。また、古いリビジョンを引用すると、認証が拒否され、リリースが遅れます。
このソリューションでは、CMVR および AI コンテンツの検索用 MongoDB 実装について説明します。これにより、次のような利点があります。
CMVR規則のテキスト、AI基準、およびその改正通知などのソース資料を取り込みます。
この素材を検索可能なレコードに変換します。
ユーザーのクエリに関連するドキュメントやセクションを検索します。
結果コンテキスト(タイトル、セクションまたはルール番号、ソース、ドキュメントバージョン)を返します。
アプリケーションはMongoDB Searchを使用して、ルールとセクションのテキストに対してクエリを照合し、一致するパッセージをソースロケーターとともに返します。
メーカーが複数の市場で販売している場合は、どこでも同じ問題が発生します。ヨーロッパに出荷する供給業者は UNECE 規制を確認し、米国に出荷する供給業者は FMVSS 規格を確認し、中国に出荷する供給業者は GB 規格を確認します。各規制機関には、独自の改正サイクル、独自の採番、独自の施行日があります。検索可能なテキストとともに、セクション、バージョン、ソースロケーターを保持するこのソリューションのパスワードなしは、これらの規制機関に適用されます。
このソリューションは、ドメイン固有の質問に答える可能性のあるソース資料をユーザーが見つけて検証するのに役立ちます。大まかに言うと、このソリューションは次のワークフローを使用します。
取り込み: CMVR 規則テキスト、AI 標準、およびそれらを修正する官報通知または ARAI 通知を読み取ります。
準備: 各ソースを、ドキュメント、セクションまたはルールの番号、修正番号、発効日、およびパッセージをその起源まで追跡するために必要なロケーターのメタデータを含むレコードに正規化します。
検索する: MongoDB Search パス、フィルター、ランキングロジックを適用し、どの修正または改訂が現在適用されているかに従ってください。
現在: 一致したコンテンツを、ルール番号、標準識別子、バージョン、ソースコンテキストとともに返します。これにより、コンプライアンスエンジニアは現在のテキストを読んでいることを確認できます。
アプリケーションが取り扱う代表的なクエリには、標準識別子(AIS-xyzなど)、CMVRルール番号または略称、自然言語による要件(「乗用車の後部座席シートベルトの要件は何か」など)、カテゴリや改正日で制約されたクエリなどがあります。これらのクエリは、検索語彙を具体化し、評価作業の出発点となります。
法規・標準検索が難しい理由
CMVR 規則は官報に掲載された G.S.R. 通知によって改正されます。また、1 つの規則には原文の上に幾つもの改正が含まれる場合があります。AIS 規格には独自の改訂サイクルがあり、ARAI によって AIS-xyz Rev B などの改訂文字で追跡されています。キーワードで検索したコンプライアンスエンジニアは、見つけた記述が現行バージョンなのか、それ以降のバージョンなのかを確実に判断する方法がありません。廃止された条項に基づいて書類を提出すると、承認申請の却下を引き起こし、車両の発表が数週間遅れる可能性があります。2 度目の認証ラウンドのコストが追加されます。
専門用語はもう一段階の困難さをもたらします。技術者、供給業者、規制当局は、同じ要件を異なる言葉で表現することがよくあります。例えば、供給業者は「ヘッドランプのビームパスワードなし」を検索するかもしれないのに対し、規格自体は「ロービームの測光要件」を使用しています。正確なキーワードマッチングのみでビルドされた検索では、これらのつながりを見落としてしまいます。語彙検索は、単語、接頭辞、または識別子と一致します。セマンティック検索は、テキストの数値表現であるベクトル埋め込みを通じて意味を照合します。これらの検索手法を組み合わせることで、RAG パイプラインは LLM に適切なコンテキストを提供できます。
同様の困難は自動車業界以外でも現れます。自動車保険の請求を検討する引受人は、車が製造された時にどの衝突試験規格が適用されたかを確認する必要があります。なぜなら、AIS 規格の改訂によって保険のカバレッジが変更される可能性があるからです。同時にヨーロッパ、米国、中国で販売するOEMは、UNECE、FMVSS、GBの改訂を並行して追跡する必要があります。それぞれに独自の改正履歴と施行日があります。どのような場合でも、基礎の要件は同じです。検索可能なテキストとともに、セクション、バージョン、ソースロケーターを保持することです。このパターンは、要件に何が記述されているか、いつ適用するかをユーザーに伝えます。
参照アーキテクチャ
このソリューションは、エンジニアリング、認証、コンプライアンスの各チームが、結果を検証するのに必要なリビジョンおよびソースのコンテキストを失わずに、権威あるCMVRおよびAIのコンテンツを検索するのを支援します。ハイブリッド取得パターンを使用します。詞彙検索は、CMVR ルール番号や AIS 規格などの識別子に対する高精度な検索をサポートします。一方、ベクトル検索は、ユーザーが要件を平易な言語で説明したときに関連するパッサージを表面化します。
入力されるすべてのドキュメントは、テキストを特定のルール、セクション、または個別のチャンクなどの細かい単位に分析する取り込みプロセスを経ます。変換中に、プロバンスと有効性のメタデータが追加されます。これには、ソース ID、正確なセクションまたは条項ロケータ、カテゴリ、ドキュメントのバージョン/リビジョン、有効日、および現在のライフサイクルステータスが含まれます。MongoDB は、その後、キーワード検索用のテキストデータと、セマンティック検索用のベクトル埋め込みの両方を保存し、インデックス化します。最後に、システムは語彙的および意味的なクエリ候補を統合して、ソースマテリアルに基づいたランク付きで検証可能な結果を生成および提示します。

図1。エンドツーエンド リファレンスアーキテクチャ図
AIS-[standard identifier]のようなクエリ、CMVRルール番号、「乗用車の後部座席シートベルトの要件」などは、すべて同じ高レベルのパスをたどります。
アプリケーションは、該当する検索期間と、カテゴリ、リビジョン、発効日、アクティブステータスなどの任意フィルターを特定します。
MongoDB Searchは、ソーステキスト内の正確な識別子、略語、および期間の語彙的な一致を検索します。
MongoDB ベクトル検索は、自然言語の要件および用語のバリエーションに対して、意味的に類似したパッケージを検索します。
アプリケーションは候補セットを統合してランク付けし、ライフサイクルフィルターを適用し、そして検証に必要なプロビナンス フィールドをプロジェクトします。
結果ビューには、一致するパッサージがそのソースコンテキストとともに表示されます。
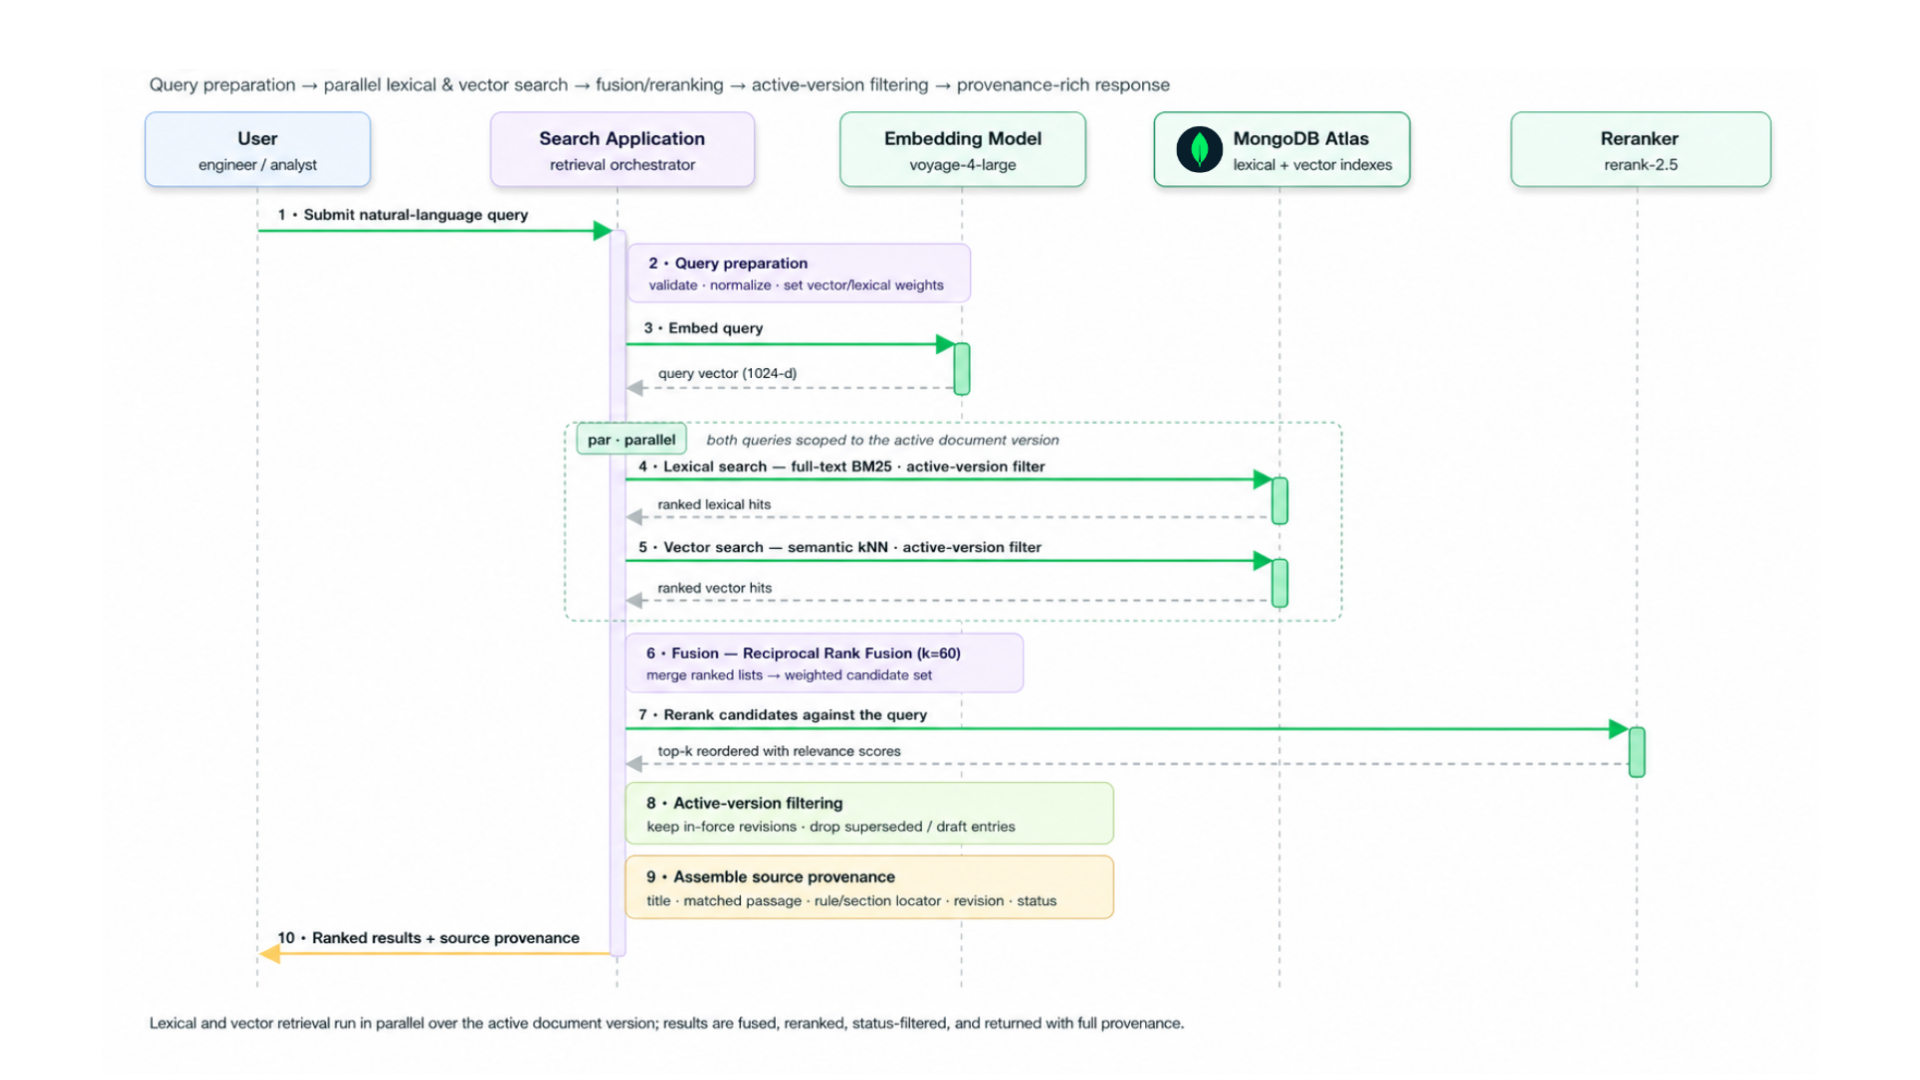
図2。ハイブリッド検索シーケンス図
データモデルアプローチ
検索可能なレコードには、検索されるテキストと、そのテキストを検証可能にするコンテキストの両方が含まれている必要があります。規制コーパスの場合、アプリケーションはドキュメントのID、セクションまたはルールの階層、インデックスが作成されたリビジョン、および元の資料に戻るための安定したロケーターを保持する必要があります。

図3。ドキュメントからレコードへの変換ビジュアル
以下はあくまで例示的なスキーマです。
{ _id: '<documentId>:rule:<ruleNumber>', AIS: { 'AIS-XXX': 'Summary of what this standard requires.', 'AIS-YYY': 'Summary of another referenced standard.' }, canonicalKey: '<documentId>:rule:<ruleNumber>', canonicalTitle: '<Short descriptive title of the rule>', chapterId: '<documentId>:chapter:<chapterNumber>', createdAt: ISODate('<YYYY-MM-DDTHH:mm:ss.sssZ>'), documentId: '<documentId>', ruleNumber: '<ruleNumber>', ruleText: '<Full rule text, including sub-rules, provisos, tables and footnotes>', source: { documentName: '<Official title of the source document>', pdfFile: '<source-file>.pdf', pages: [], chunkCount: NumberInt('<numberOfChunksExtracted>'), extractionModel: '<extraction-model-name>' }, status: 'active', updatedAt: ISODate('<YYYY-MM-DDTHH:mm:ss.sssZ>'), ruleTextEmbedding: [/* float[<dimensions>] */]}ruleText フィールドにはプライマリ規制条項が含まれ、canonicalTitle と ruleNumber は要件の迅速な検証を可能にします。documentId や chapterId を含む構造的メタデータは、特定のレコードと親チャプター階層との関係を維持します。source オブジェクトは、元のPDF、ページ番号、抽出モデルへのトレーサビリティに必要な出所を提供します。標準固有のコンテキストについては、AI オブジェクトが相互参照とリンクされた要件の概要をキャプチャします。レコードのライフサイクルは、status、createdAt、および updatedAt を介して追跡されます。最後に、ruleTextEmbedding と関連するメタデータフィールドは、セマンティック検索を強化する数値ベクトル表現とモデルの詳細を保存 (する) します。
ソリューションのビルド
このセクションでは、ハイブリッド検索の実装に向けたビルドするフローについて説明します。ソースコードの全文は GitHub リポジトリで入手できます。


ハイブリッド検索インデックスを作成する
正確な識別子とテキストの照合のための MongoDB Search インデックスと、埋め込みフィールドのための MongoDB ベクトル検索インデックスを作成します。検証済みの実装から、マッピング、アナライザ、フィルター、ベクトルの次元、および類似度メトリクスを定義します。
検索インデックス
{ mappings: { dynamic: false, fields: { canonicalTitle: { type: "string", analyzer: "lucene.english" }, ruleText: { type: "string", analyzer: "lucene.english" }, documentId: { type: "token" } } }}ベクトル検索インデックス
{ fields: [ { type: "vector", path: "ruleTextEmbedding", numDimensions: 1024, similarity: "cosine" }, { type: "filter", path: "documentId" } ]}
キーポイント
専門的な規制検索には、テキストマッチング以上のものが必要です。語彙的な検索と意味的な検索を組み合わせることで、正確な標準識別子と、ユーザーが同じ要件に適用する様々な言語の両方に役立ちます。
プロビナンスは製品の要件です:検索されたすべてのパッセージは、ユーザーが基礎の資料を検証できるように、安定したソース識別子、ロケーター、ドキュメントのリビジョン、およびライフサイクル状態を保持する必要があります。
ドキュメントの改訂は関連性の一部です。関連しているが、既に失効した条項を現行の要件として提示するべきではありません。
ハイブリッド検索は、代表的なユーザークエリに対して評価する必要があります。候補数、結果の制限、融合の重み、レイテンシのターゲットは、デフォルトとしてコピーするのではなく、実際のワークロードから選択する必要があります。
ソースに基づいた検索エクスペリエンスにより検証が速まる: この改善されたエクスペリエンスにより、ユーザーは資料をより迅速に見つけて検証することができます。これ自体はコンプライアンスの判定を行いません。
作成者
Utsav Talwar、ソリューション アーキテクト、MongoDB
Humza Akhtar, フィールド CTO, Manufacturing Industry, MongoDB