ユースケース: 人工知能、コンテンツ管理、インテリジェント検索
業種: 製造業とモビリティ
製品: MongoDB Atlas、 MongoDB Atlas Search、 MongoDB Atlas Vector Search、 ハイブリッド検索
パートナー: Google Cloud Platform
ソリューション概要
地理空間、リソース、自動車、製造などのキャパシティーが必要な業界では、数十の複雑な技術知識が必要です。ただし、この技術的知識は、マニュアル、メンテナンス ガイド、内部 wiki などの静的ドキュメントのコレクションに保持され、アクセスが困難な PDF または非構造化ファイルとして保存されます。その結果、フロントライン ワーカーはリアルタイムで正確な情報を取得できません。
これにより、会社は次のような問題が生じます。
ドキュメントが不十分なため、本番環境のエラーと再ワークは製造担当者の 97% に影響します。
ドキュメント作成の非効率性により、製造業 の 73% に従って他の技術へのプロジェクトからのメリットが縮小されます。
このギャップに対処するために、このソリューションはコンテキストを認識する RG を使用して、挿入ドキュメントを動的な知識ベースに変換するためのアーキテクチャフレームワークを提供します。ドキュメントをチャンクに分割するときにクリティカル コンテキストを失う標準の RG システムとは異なり、コンテキスト対応型 RG は技術ドキュメント内の階層構造と関係を保持します。 その後、ユーザーは自然言語の質問をし、ドキュメントから正確な回答を受け取ることができます。これにより、システムは元の技術コンテキストを維持しながら、最も関連する情報を自動的に検索して表示します。
By maintaining document structure during the RAG process, the system ensures that safety warnings remain connected to their procedures, and that technical specifications retain their proper scope. The resulting system makes operations safer, accelerates productivity, and lays the path for next-generation industrial AI applications.
参照アーキテクチャ
コンテキスト対応の RAG システムを構築するためのアーキテクチャは、3 つのコアレイヤーで構成されています。
取り込みパイプラインレイヤー
データプラットフォームレイヤー
クエリレイヤー
これらのレイヤーは連携して、静的技術ドキュメントをインテリジェントな知識ベースに変換します。各レイヤーはドキュメント構造を維持し、キーワードの正確な一致とセマンティックの理解を可能にします。このセクションでは、取り込み層とクエリ層について説明します。また、「 データモデルのアプローチ 」セクションでは、データ プラットフォームレイヤーについて詳しく説明します。
以下の図は、 PDF の取り込みからユーザー クエリの応答までのデータフローを示し、技術コンポーネントとその相互作用を示しています。これは、各レイヤーがコンテキストを維持しながら技術ドキュメントを処理、保存、検索する方法を示します。
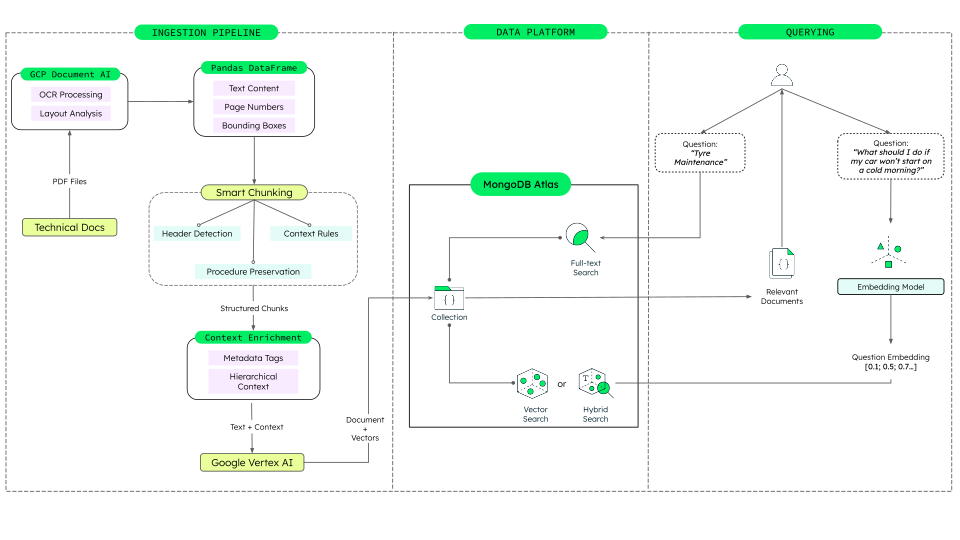
図の 1。技術ドキュメント アーキテクチャ向けのコンテキスト認識型 RG
取り込みパイプライン層
取り込みパイプラインレイヤーは、未加工の PDF をコンテンツとコンテキストを保持する構造化データに変換します。これにより、チャンク化プロセス中に技術的関係、階層構造、コンテキストに応じた依存関係が正常に保たれ、重要な情報の損失を防ぐことで、RAG システムの品質と信頼性が向上します。取り込みパイプラインレイヤーを開発するには、 カーマニュアルのデータ取り込みノート を使用します。このファイルは、このレイヤーを実装する方法に関する詳細なガイドを提供し、次のプロセスをガイドします。
1。移植性のあるドキュメントを構造データフレームワークに変換する
取り込みパイプラインレイヤーを開発するには、まず google-cloud-documentai Pythonライブラリを使用して PDF ソースを処理します。API応答を構造化された Panas DataFrame に解析します。各行は、次の列を含む個別のテキスト ブロックを表します。
境界ボックスの座標
ページ番号
テキスト コンテンツ
2。構造推論のルールを適用する
次に、次のように Data Frame を反復処理し、ルールベースのエンジンを適用してコンテキストを推論します。
ヘッダーの検出: すべてが上限付きのテキスト ブロックまたはフォント サイズが大きいテキスト ブロックは、セクション ヘッダーとして識別されます。
リストと手順の認識: 水平境界ボックスの位置により、リストまたは手順ステップを示すインデント パターンが表示されます。
セマンティック チャンク戦略: テキストは意味のあるチャンクに集約され、主要な見出しが発生するまで継続され、手順とテーブルが完全な状態に保たれます。
3。高品質の検索のためのデータの強化
各チャンクの階層パスを取得するには、breadcrumb_trail という名前の string 変数を作成します。この string を、Google Vertex AI textembedding-gecko モデルに送信する前に、チャンクのテキストに先頭に追加します。この設計では、チャンクのテキストとドキュメント階層内のそのコンテキスト位置をベクトル埋め込みでエンコードすることで、セマンティック検索の関連性が向上します。
4。代替のアプローチを使用する
プロセスを簡素化するために、 mongoage-context-3 などのコンテキストに応じたチャンク埋め込みモデルを使用します。これらのモデルは、埋め込みの生成時にドキュメントのグローバルなコンテキストを分析し、次の利点を提供します。
取り込みの簡素化:
breadcrumb_trail変数の作成や前追加などの手動コンテキスト認証の手順を減らします。モデルは埋め込み中にコンテキストインジェクションを自動的に処理します。取得精度の向上: ローカル コンテキストを持たないチャンクの取得品質を向上させるニュアンスのある埋め込みを生成します。
チャンクへの影響の軽減: チャンクへの依存度が低い検索プロセスを実装します。モデルのグローバル認識は、セグメンテーションが非最適であることを埋め合わせます。
クエリ層
クエリレイヤーは、完全一致とセマンティック検索を組み合わせた階層型検索アプローチを実装します。各階層は独立して実行され、その結果は次のように スコア統合 を使用して結合されます。
階層 1 は高精度のキーワード一致を提供します。
階層 2 は、最終ランキング スコアにセマンティックな理解を追加します。
このセクションでは、スコアの可視性を維持しつつ、精度と再現率のバランスするクエリレイヤーを構築する方法を説明します。実稼働システムは検索関連性のために階層化されたアプローチを使用して、検索されたドキュメントがユーザーのクエリを満たしているかどうかを測定します。
階層 1: 複合テキスト検索の精度
業種では、エラー コードや部分番号などの用語を検索するための精度が必要です。この精度を実現するには、次のように Atlas Search の compound 演算子内で多層戦略を使用します。
{ "$search": { "index": "manual_text_search_index", "compound": { "should": [ // High-Precision: Exact phrase matching with highest boost { "phrase": { "query": "car won't start", "path": "breadcrumb_trail", "score": { "boost": { "value": 10 } } } }, // Balanced Relevance: Individual word matching with medium boost { "text": { "query": "car won't start", "path": "text", "score": { "boost": { "value": 4 } } } }, // High-Recall: Fuzzy matching to catch typos with low boost { "text": { "query": "car won't start", "path": "text", "fuzzy": {}, "score": { "boost": { "value": 1.5 } } } } ] } }}このクエリでは、複合検索クエリを作成できる should 句を使用します。結果として得られるスコアは、次のように、一致するすべての 句の合計と等しくなります。
完全一致では、10 のスコア乗数が適用され、完全一致のドキュメントの最高ランクが確保されます。
一致する個々の単語は、個々の検索タームを含むドキュメントに 4 のスコア乗数を適用します。この機能は、単語が別々に表示される場合でも、関連するコンテンツをキャプチャします。
ファジー一致では、1.5 のスコア乗数が適用されます。この機能は、type またはバリエーションのあるドキュメントを検出し、完全一致のランク付けを防ぎます。
階層 2: 透過性を高めるためのハイブリッド検索の分割
$rankFusion を使用して、階層 1 からの正確な compound テキストクエリと階層 2 からのセマンティックベクトル検索を組み合わせます。この集計演算子は、キーワード一致の精度とセマンティックの理解性を提供します。最終スコアを分割して、テキスト検索とベクトル検索が各結果のランキングにどのように影響するかを正確に示すこともできます。この透過性により、開発者は次のことが可能になります。
検索の関連性をデバッグして、テキスト検索とベクトル検索のどちらがランキング結果を後押しするかを識別します。
スコアの内訳を明確に示すことで、特定のドキュメントが高ランクにランク付けされる理由を把握します。
さまざまな重み戦略で A/B テスト シナリオを最適化します。
search_new.pyファイルを使用してハイブリッド検索を実装します。このファイルには、次の操作を実行するコードが含まれています。
次の集計パイプラインを使用して、
scoreDetailsで$rankFusionを実行します。{ $rankFusion: { input: { pipelines: { <myPipeline1>: <expression>, <myPipeline2>: <expression>, ... } }, combination: { weights: { <myPipeline1>: <numeric expression>, <myPipeline2>: <numeric expression>, ... } }, scoreDetails: <bool> }}$addFields演算子を使用してメタデータを抽出します。{ $addFields: { scoreDetails: { $meta: "scoreDetails" } }}$filter演算子と$arrayElemAt演算子を使用してパイプライン貢献を分離し、scoreDetails配列を解析します。このアプローチでは、vectorPipelineとfullTextPipelineから特定のランクとスコアのフィールドを作成します。各検索方法の実際の貢献度を、RRF 公式 を使用して、ユーザー定義の重み付けを乗算して計算します。下位の結果の影響を制御するため、定数
kを 60 に設定します。次のような、検索ランキングの透過的な結果を提供します。
SearchResult( score=0.0123, # Final combined RRF score vector_score=0.0086, # Vector pipeline contribution text_score=0.0037 # Text pipeline contribution)
データモデルアプローチ
データプラットフォームレイヤーは、参照アーキテクチャの主要コンポーネントです。これは、 取り込みパイプラインからのすべての豊富な出力の永続的ストアとして機能し、 クエリレイヤーの統合された基盤を提供します。このソリューションでは、 MongoDBドキュメントモデルは、テキスト、埋め込み、階層コンテキスト、メタデータを単一の構造に統合し、データプラットフォームを強化します。
このアプローチにより、メタデータ、埋め込み、全文検索用の 個別のデータベース のような複数のシステムが不要になるため、複雑度を軽減できると同時に、技術ドキュメントを正確に取得するために必要な豊富なコンテキストを維持できます。
従来のマルチシステム設計では、次の課題が導入されています。
データサイロ: システム間で情報を同期および重複させると、脆弱性が高まり、運用上のボトルネックが生じます。
運用オーバーヘッド: 個別のサービスの実行、スケーリング、保護を行うと、インフラストラクチャのコストが上昇します。
開発者の競合: 異なる API の統合と学習により、イノベーションが遅くなります。
対照的に、ドキュメントモデルはアーキテクチャを簡素化します。 データプラットフォームレイヤーは、コンテンツとそのコンテキストに応じた関係の両方を保存することでコンテキストを認識する RG をネイティブでサポートし、検索と取得でドキュメント階層と意味を保持します。
以下は、単一の技術ドキュメントチャンクのテキストとその豊富なメタデータを保存するドキュメントモデルのサンプルです。
{ "_id": { "$oid": "685011ade0cccc356ba545df" }, "text": "WARNING: Switching off the engine when your vehicle is still ...", "breadcrumb_trail": "ENGINE START STOP -- WHAT IS AUTOMATIC ENGINE STOP", "heading_level_1": null, "heading_level_2": "WHAT IS AUTOMATIC ENGINE STOP", "heading_level_3": "Starting and Stopping the Engine", "content_type": [ "procedure", "safety" ], "metadata": { "source_pages": "122-122", "chunk_length": 1459, "systems": [ "engine", "transmission" ] }, "id": "chunk_00174", "prev_chunk_id": "chunk_00173", "next_chunk_id": "chunk_00175", "embedding": [ -0.016625087708234787, ..., 0.005507152993232012, -0.022588932886719704 ]}ドキュメントには、次の関連フィールドが含まれています。
text: Atlas Search が対象とする未加工テキスト コンテンツ。breadcrumb_trail: 完全な階層コンテキストを保持する、人間が判読可能な文字列。 このフィールドは、コンテキストを認識する RAG のためにドキュメントのナビゲーション構造を維持します。content_type: ブラウザUIの複数選択フィルターを強化するタグの配列。このフィールドはインデックスを使用します。metadata.source_pages: チャンクをソース PDF 内の元のページにリンクする整数の範囲。metadata.systems: フィルタリングに使用され、キーワード マッピングが入力されるタグの配列。id: トレーサビリティを確保するチャンクの一意の識別子。embedding: チャンクのコンテキストに応じたテキストの 768 次元ベクトル表現。このフィールドはベクトル検索に Atlas ベクトル検索インデックスを使用します。
ソリューションのビルド
このソリューションを配置するには、Githubリポジトリ の README の手順に従います。このリポジトリでは、次の手順についてガイドします。
キーポイント
技術情報をレコードための動的システムを確立: MongoDBに技術情報を保存することで、静的ドキュメントを構造化されたクエリ可能な知識ベースに変換します。MongoDB は組織のオペレーションに関する統合ソースとして機能し、すべてのAIアプリケーションが一貫性のあるコンテキストに応じた情報にアクセスできるようにします。このシステムは、診断チャットボットや予測メンテナンス システムなどの下流へのツールの強力な基盤を提供します。
エンジニア ハイブリッド検索: ハイブリッド検索ではテキスト検索とベクトル検索を
$rankFusionと組み合わせて使用します。デバッグと関連性の調整で透過性を実現するには、最終スコアを分解します。RG システムの変換:
voyage-context-3などの埋め込みモデルを使用して、ドキュメント全体を処理し、チャンク レベルの詳細を維持します。この実装、標準的なアプローチよりも最大 20% の取得パフォーマンスが向上します。
作成者
Mehar Grewal、MongoDB
Rami Pinto、MongoDB