Casos de uso: Inteligência artificial, Gerenciamento de conteúdo, Pesquisa inteligente
Setores: Indústria
Produtos: Atlas Search, MongoDB Atlas Vector Search, Pesquisa híbrida no MongoDB Atlas
Visão Geral da Solução
As CMVR são as regras emitidas sob a Lei de Motor Veículos da Índia. Eles estabelecem os requisitos técnicos e de segurança que um veículo deve atender antes que possa ser fabricado, vendido ou registrado no país. A IA compreende as normas técnicas, desenvolvidas e mantidas pela ARAI. Eles especificam como um veículo ou componente deve ser testado para mostrar que atende a um determinado requisito CMVR. Um OEM que fabrica um carro para o mercado indiano usa estes documentos: o CMVR especifica quais requisitos de segurança o veículo deve atender, e a IA correspondente estabelece como essa conformidade é testada e certificada.
O conteúdo regulatório e de padrões só é valioso quando as pessoas conseguem encontrar o requisito correto no momento correto. Considere um engenheiro em um fornecedor de componentes finalizando uma montagem de farol para um OEM indiano. Antes de a peça ser enviada à ARAI para certificação, o engenheiro precisa confirmar a revisão atual da IA-xyz e verificar se a "regra abc" do CMVR foi alterada desde a última submissão. Pesquisar em uma pasta de notificações de diário oficial e PDFs de normas para aquela cláusula leva horas, e citar uma revisão desatualizada significa uma certificação rejeitada e um lançamento atrasado.
Esta solução apresenta uma implementação MongoDB para pesquisar conteúdo CMVR e IA, que:
Utiliza material de origem, como o texto da regra CMVR, padrões de IA e suas notificações de alteração.
Transforma este material em registros pesquisáveis.
Recuperar o documento ou seção relevante para uma query do usuário.
Retorna o contexto do resultado: o título, a seção ou o número da regra, a fonte e a versão do documento.
O aplicativo usa o MongoDB Search para comparar uma query com o texto da regra e da seção e retorna a passagem correspondente junto com seu localizador de origem.
O mesmo problema aparece em qualquer lugar onde um fabricante vende em mais de um mercado. Um fornecedor que envia para a Europa verifica os regulamentos da UNECE, um fornecedor que envia para os Estados Unidos verifica os regulamentos da FMVSS e um fornecedor que envia para a China verifica os padrões GB. Cada entidade reguladora possui seu próprio ciclo de emendas, sua própria numeração e suas próprias datas de vigência. O padrão nesta solução, que preserva a seção, a versão e o localizador de origem junto com o texto pesquisável, aplica-se a esses órgãos reguladores.
Esta solução ajuda os usuários a localizar e verificar o material de origem que pode fornecer uma resposta para uma pergunta específica de um domínio. Em um nível elevado, a solução utiliza o seguinte fluxo de trabalho:
Ingestão: Leia o texto da regra CMVR, os padrões IA e as notificações do diário oficial ou as circulares ARAI que os alteram.
Prepare: Normalize cada fonte em um registro que contenha o documento, seção ou número da regra, número da emenda, data de vigência e metadados do localizador necessários para rastrear uma passagem até sua origem.
Recuperar: Aplicar o caminho de pesquisa do MongoDB, filtros e lógica de classificação, respeitando qual alteração ou revisão está atualmente em vigor.
Presente: Retorne o conteúdo correspondente junto com seu número de regra, identificador de padrão, versão e contexto de origem, para que um engenheiro de compliance possa confirmar que está lendo o texto atual.
As query representativas que o aplicativo lida incluem um identificador padrão (como AIS-xyz), um número ou abreviação de regra CMVR, um requisito de linguagem natural (como "qual é o requisito de cinto de segurança traseiro para veículos de passageiros") e uma query restrita por categoria ou data de alteração. Essas query tornam o vocabulário de pesquisa concreto e dão ao trabalho de avaliação um ponto de partida.
Por que a pesquisa de regulamentação e normas é difícil
As regras CMVR são emendadas por meio de notificações G.S.R. publicadas no diário oficial, e uma única regra pode conter várias emendas sobrepostas ao texto original. Os padrões IA passam por seu próprio ciclo de revisão, acompanhados pela ARAI com letras de revisão como IA-xyz Rev B. Um engenheiro de compliance que pesquisa por palavra-chave não tem uma maneira confiável de saber se a passagem que encontrou reflete a versão atual ou uma posterior. Enviar documentação contra uma cláusula revogada pode trigger um pedido de homologação rejeitado e atrasar o lançamento de um veículo em semanas. Isso adiciona o custo de uma segunda rodada de certificação.
A terminologia adiciona uma segunda camada de dificuldade. Engenheiros, fornecedores e reguladores geralmente se referem ao mesmo requisito com palavras diferentes: um fornecedor pode pesquisar por "padrão de feixe de farol" enquanto o próprio padrão usa "requisitos fotométricos para farol baixo." Uma pesquisa baseada apenas na correspondência exata de palavras-chave perde essas conexões. A pesquisa lexical corresponde a palavras, prefixos ou identificadores. A pesquisa semântica corresponde ao significado por meio de incorporações vetoriais e representações numéricas de texto. Ao combinar esses métodos de pesquisa, um pipeline RAG pode fornecer o contexto certo para o LLM.
A mesma dificuldade aparece fora do setor automotivo. Um avaliador de risco que analisa um sinistro de seguro de veículo deve verificar qual norma de teste de impacto era aplicável no momento da fabricação do carro, pois a revisão do AIS pode modificar a cobertura do seguro. Um OEM que vende para a Europa, os Estados Unidos e a China ao mesmo tempo precisa acompanhar as revisões UNECE, FMVSS e GB em paralelo, cada uma com seu próprio histórico de alterações e datas de vigência. Em todos os casos, o requisito subjacente é o mesmo: preservar a seção, a versão e o localizador de origem junto com o texto pesquisável. Este padrão informa aos usuários o que o requisito diz e quando ele se aplica.
Arquiteturas de referência
A solução ajuda equipes de engenharia, certificação e compliance a encontrar conteúdo CMVR e IA autoritativo sem perder o contexto de revisão e fonte necessário para validar um resultado. Ele usa um padrão de recuperação híbrido: a pesquisa lexical oferece suporte a pesquisas de alta precisão para identificadores, como um número de regra CMVR ou um padrão IA, enquanto a pesquisa vetorial exibe passagens relevantes quando um usuário descreve um requisito em linguagem natural.
Cada documento de entrada passa por um processo de ingestão que analisa o texto em unidades granulares, como regras específicas, seções ou partes individuais. Durante a transformação, metadados de proveniência e validade são anexados—abrangendo o ID de origem, localizador exato de seção ou cláusula, categoria, versão/revisão do documento, data de vigência e status atual do ciclo de vida. O MongoDB então armazena e indexa dados textuais para pesquisa por palavra-chave e embedding de vetor para pesquisa semântica. Finalmente, o sistema mescla candidatos de query léxicos e semânticos para gerar e apresentar um resultado classificado e verificável, fundamentado no material de origem.
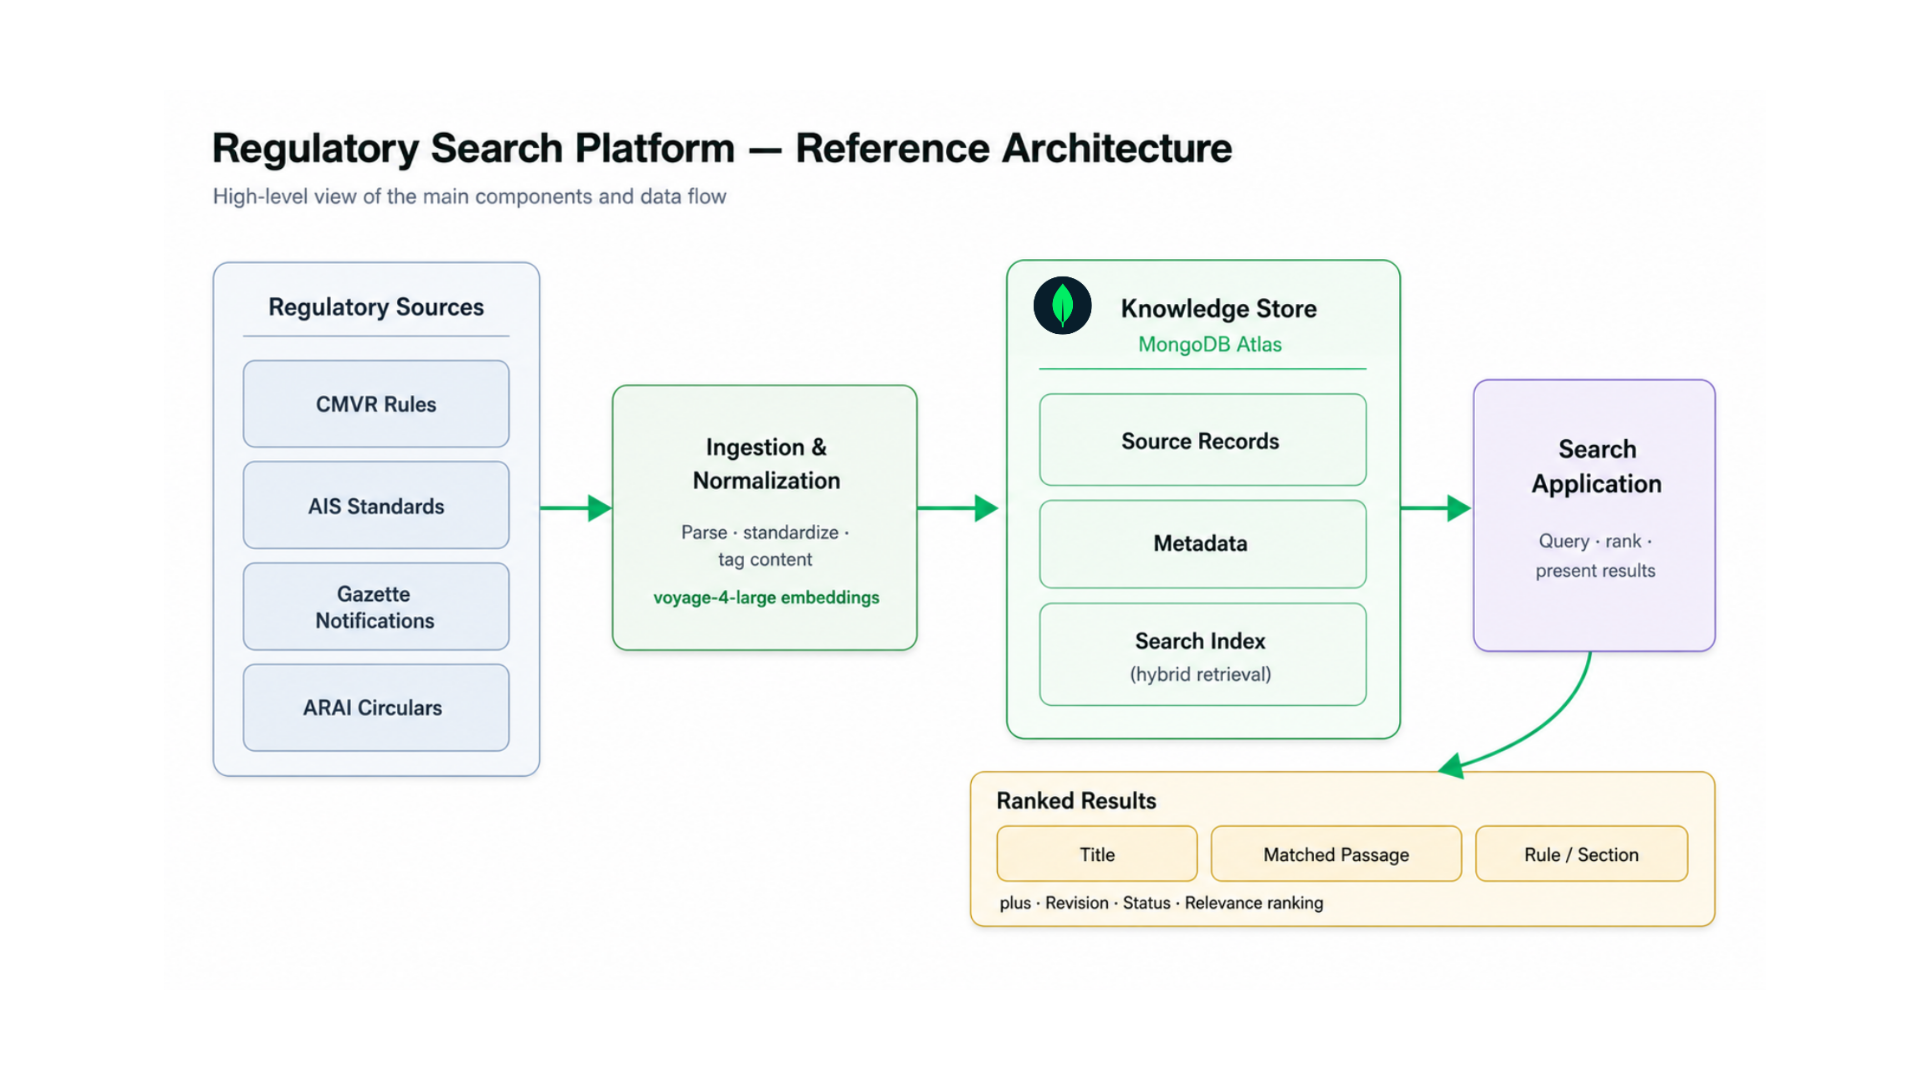
Figura 1. Diagrama de arquitetura de referência de ponta a ponta
Uma query como AIS-[standard identifier], um número de regra CMVR ou “requisito de cinto de segurança traseiro para veículos de passageiros” segue o mesmo caminho de alto nível:
O aplicativo identifica os termos de pesquisa aplicáveis e filtros opcionais, como categoria, revisão, data de vigência ou status ativo.
O MongoDB Search recupera correspondências lexicais para identificadores exatos, abreviações e termos no texto de origem.
MongoDB pesquisa vetorial recupera passagens semanticamente semelhantes para requisitos de linguagem natural e variações de terminologia.
O aplicativo mescla e classifica os conjuntos de candidatos, aplica filtros de ciclo de vida e projeta os campos de proveniência necessários para verificação.
A visualização de resultados apresenta a passagem correspondente junto com seu contexto de origem.
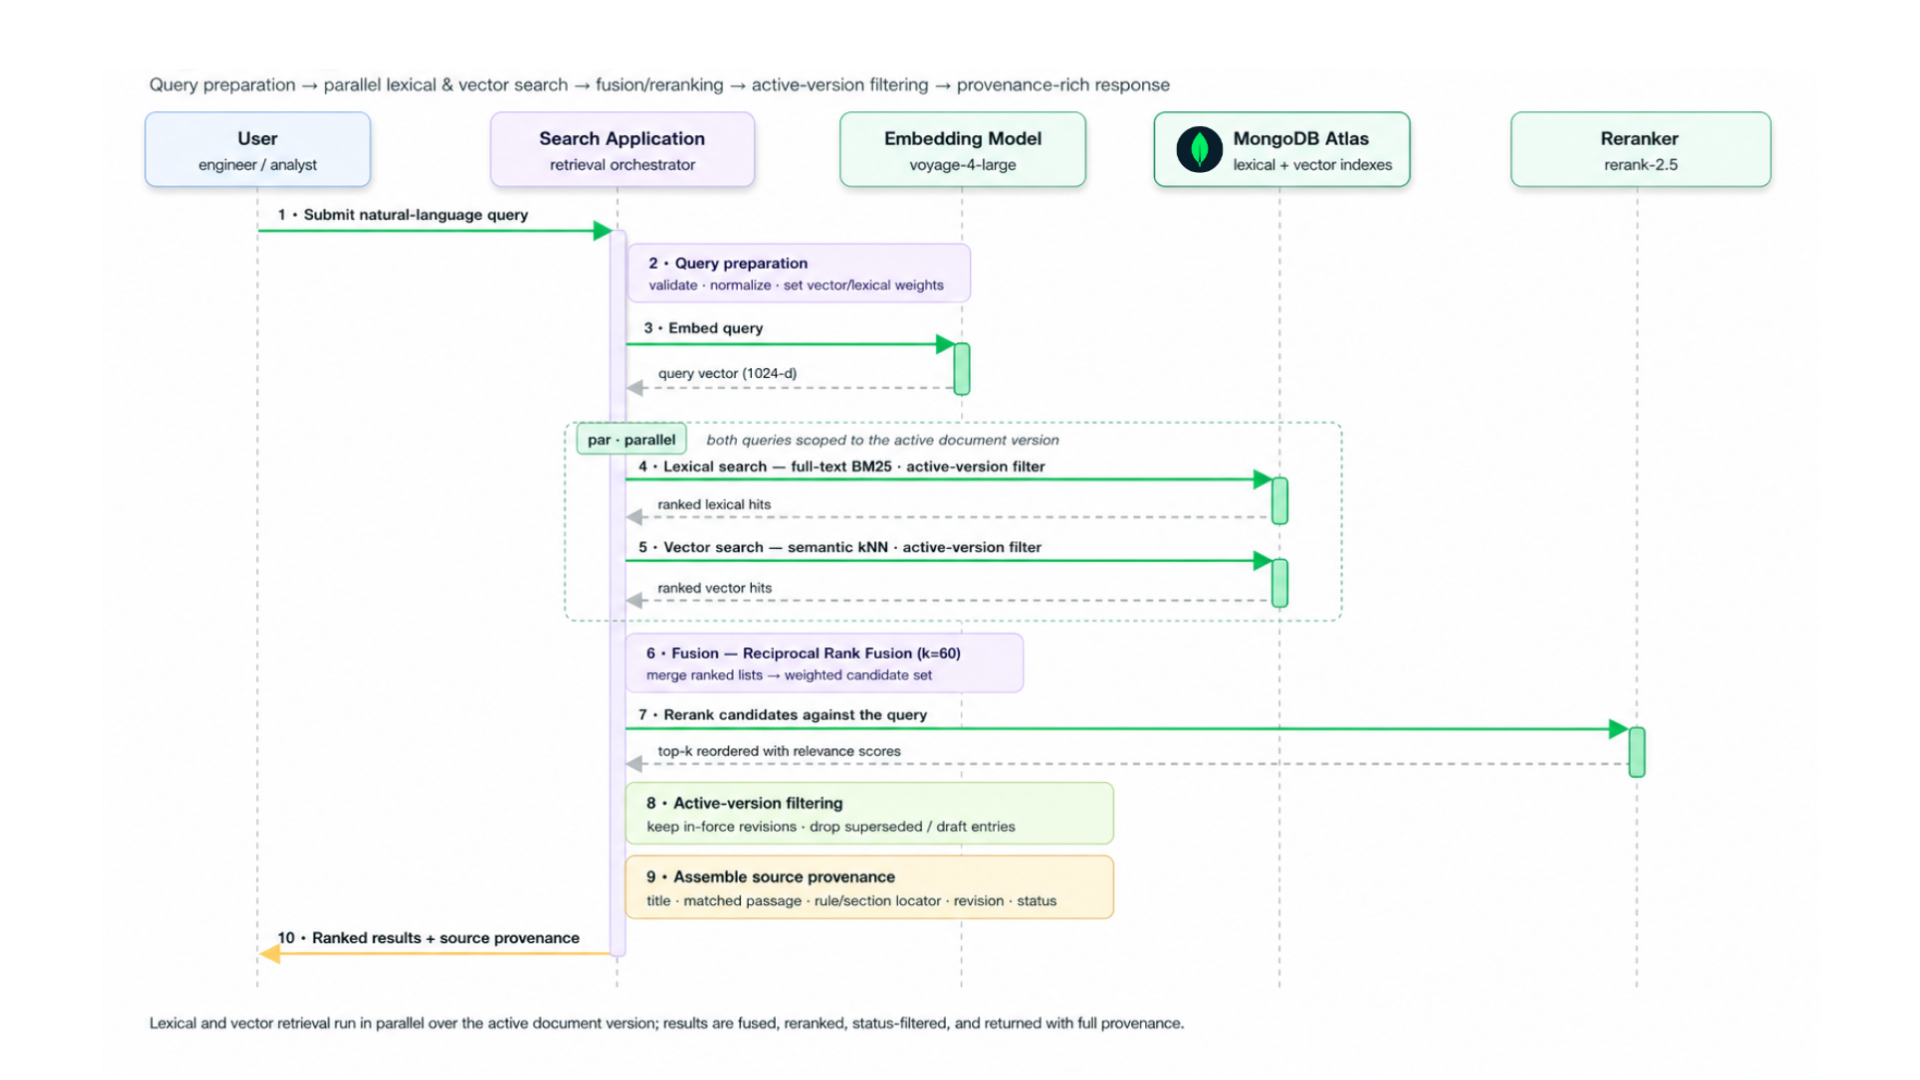
Figura 2. Diagrama de sequência de recuperação híbrida
Abordagem do modelo de dados
Um registro pesquisável deve conter tanto o texto que é recuperado quanto o contexto que torna esse texto verificável. Para um corpus regulatório, o aplicativo deve manter a identidade do documento, a hierarquia da seção ou regra, a revisão que foi índice e um localizador estável de volta ao material original.
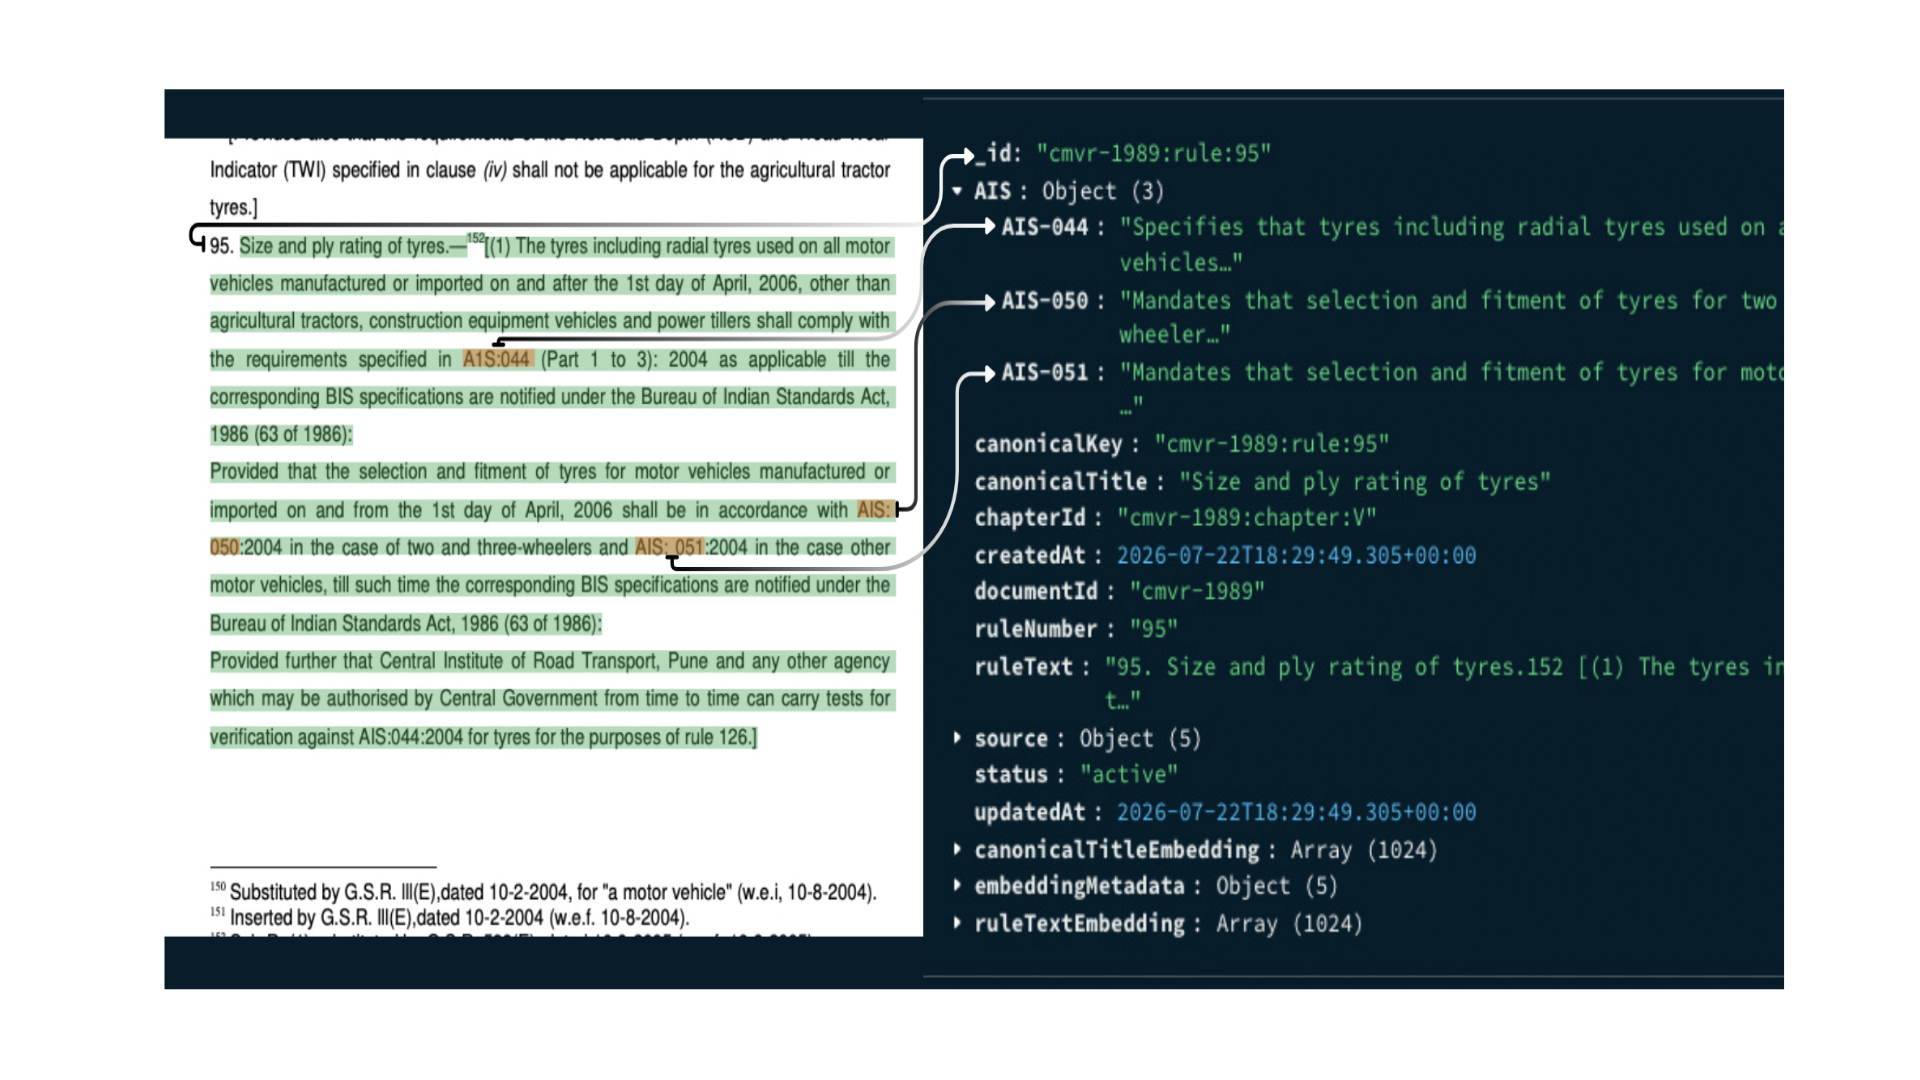
Figura 3. Visual de transformação de documento em registro
O seguinte é apenas um esquema ilustrativo.
{ _id: '<documentId>:rule:<ruleNumber>', AIS: { 'AIS-XXX': 'Summary of what this standard requires.', 'AIS-YYY': 'Summary of another referenced standard.' }, canonicalKey: '<documentId>:rule:<ruleNumber>', canonicalTitle: '<Short descriptive title of the rule>', chapterId: '<documentId>:chapter:<chapterNumber>', createdAt: ISODate('<YYYY-MM-DDTHH:mm:ss.sssZ>'), documentId: '<documentId>', ruleNumber: '<ruleNumber>', ruleText: '<Full rule text, including sub-rules, provisos, tables and footnotes>', source: { documentName: '<Official title of the source document>', pdfFile: '<source-file>.pdf', pages: [], chunkCount: NumberInt('<numberOfChunksExtracted>'), extractionModel: '<extraction-model-name>' }, status: 'active', updatedAt: ISODate('<YYYY-MM-DDTHH:mm:ss.sssZ>'), ruleTextEmbedding: [/* float[<dimensions>] */]}O campo ruleText contém a passagem regulatória primária, enquanto canonicalTitle e ruleNumber permitem a verificação rápida do requisito. Os metadados estruturais, incluindo documentId e chapterId, mantêm o relacionamento entre um registro específico e sua hierarquia de capítulos pai. O objeto source fornece a procedência necessária para a rastreabilidade até o PDF original, números de página e modelo de extração. Para contexto específico de padrões, o objeto IA captura referências cruzadas e resumos de requisitos vinculados. O ciclo de vida do registro é rastreado via status, createdAt e updatedAt. Finalmente, o ruleTextEmbedding e os campos de metadados associados armazenam as representações vetoriais numéricas e os detalhes do modelo que impulsionam a recuperação semântica.
Construir a solução
Esta seção descreve o fluxo de criar para a implementação de pesquisa híbrida. Acesse o código-fonte completo no repositório do GitHub.
Preparar o corpus de origem
Reúna o texto da regra CMVR, os padrões IA e as notificações ou circulares que alteram sua aplicabilidade. Para cada fonte, capture o arquivo original ou URL, tipo de documento, identificador, revisão, data de publicação, data de vigência e o estado atual do ciclo de vida.
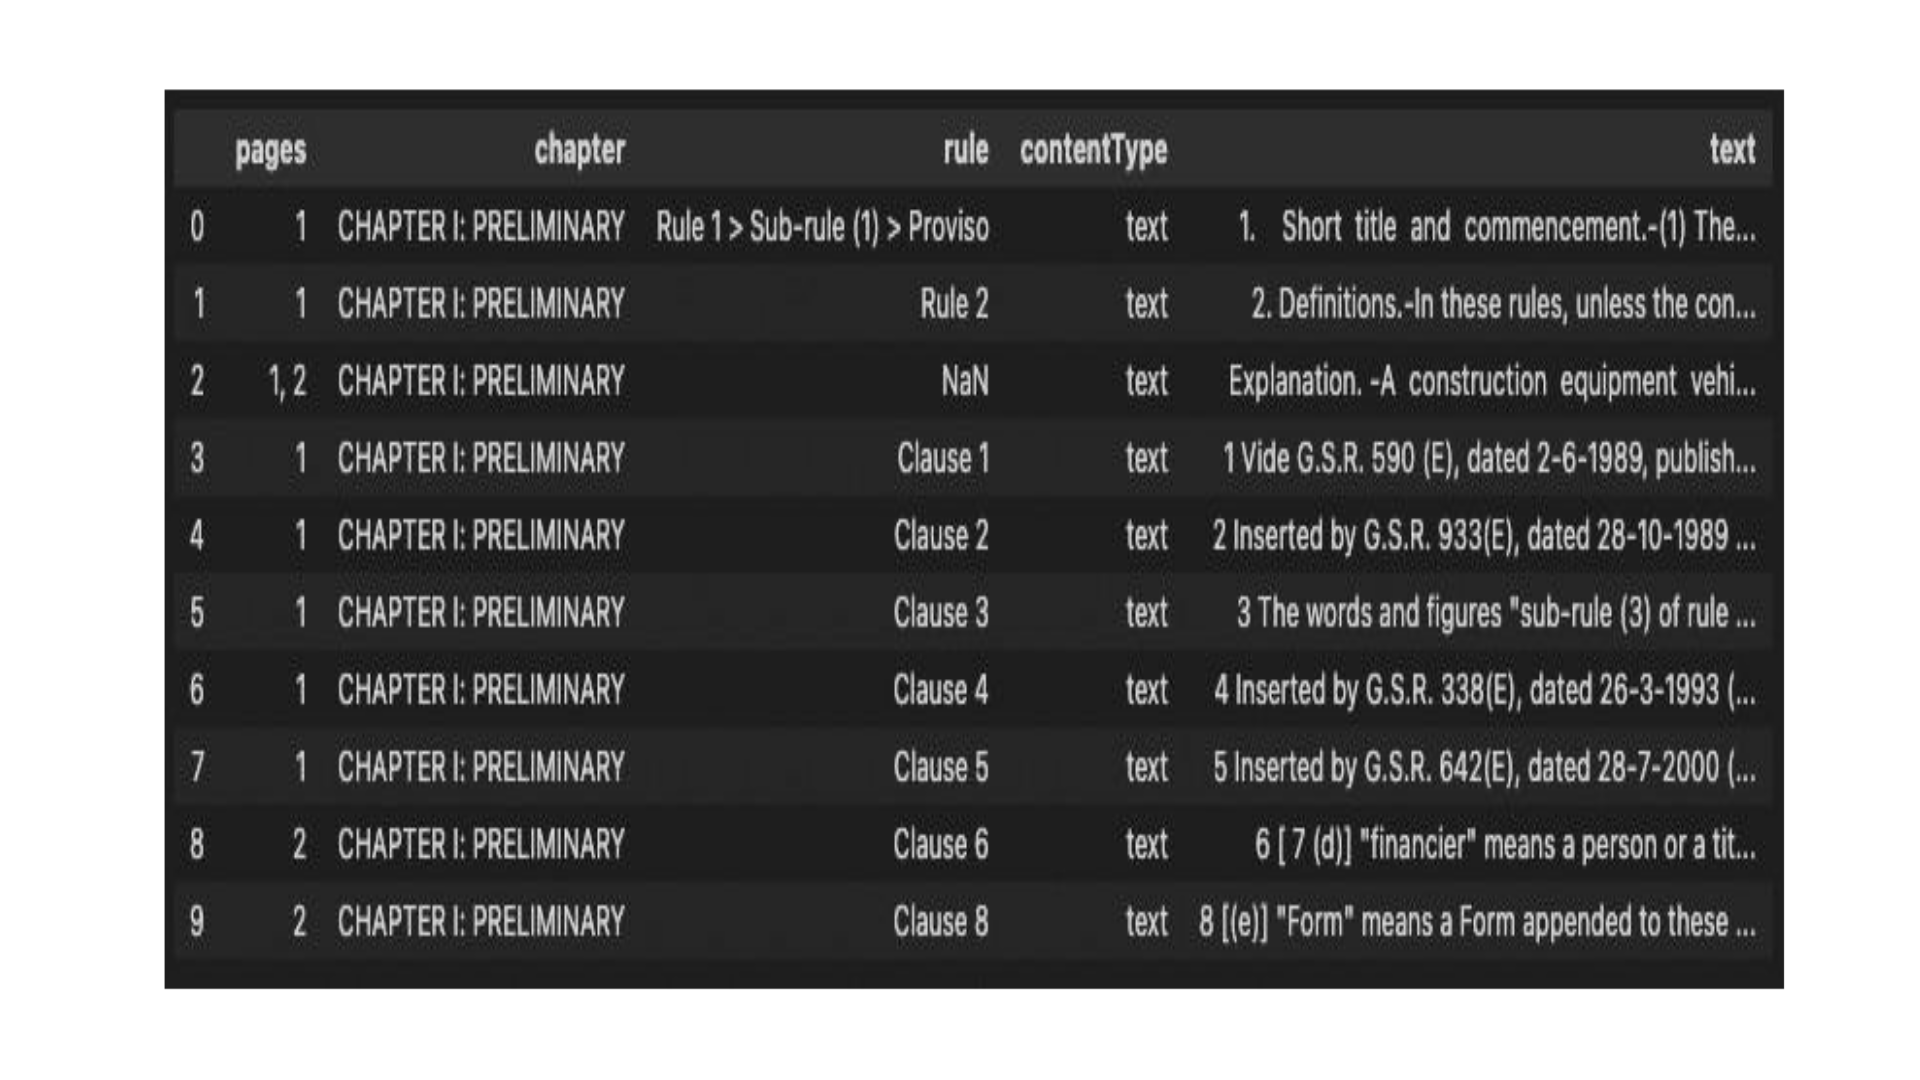
Figura 4. Informações do corpus de origem
Normalizar documentos em registros pesquisáveis
Extraia texto em nível de regra ou seção, preservando a hierarquia necessária para identificar um resultado na fonte original. Crie registros que associem o conteúdo pesquisável à procedência, ao ciclo de vida do documento e aos metadados de filtro.
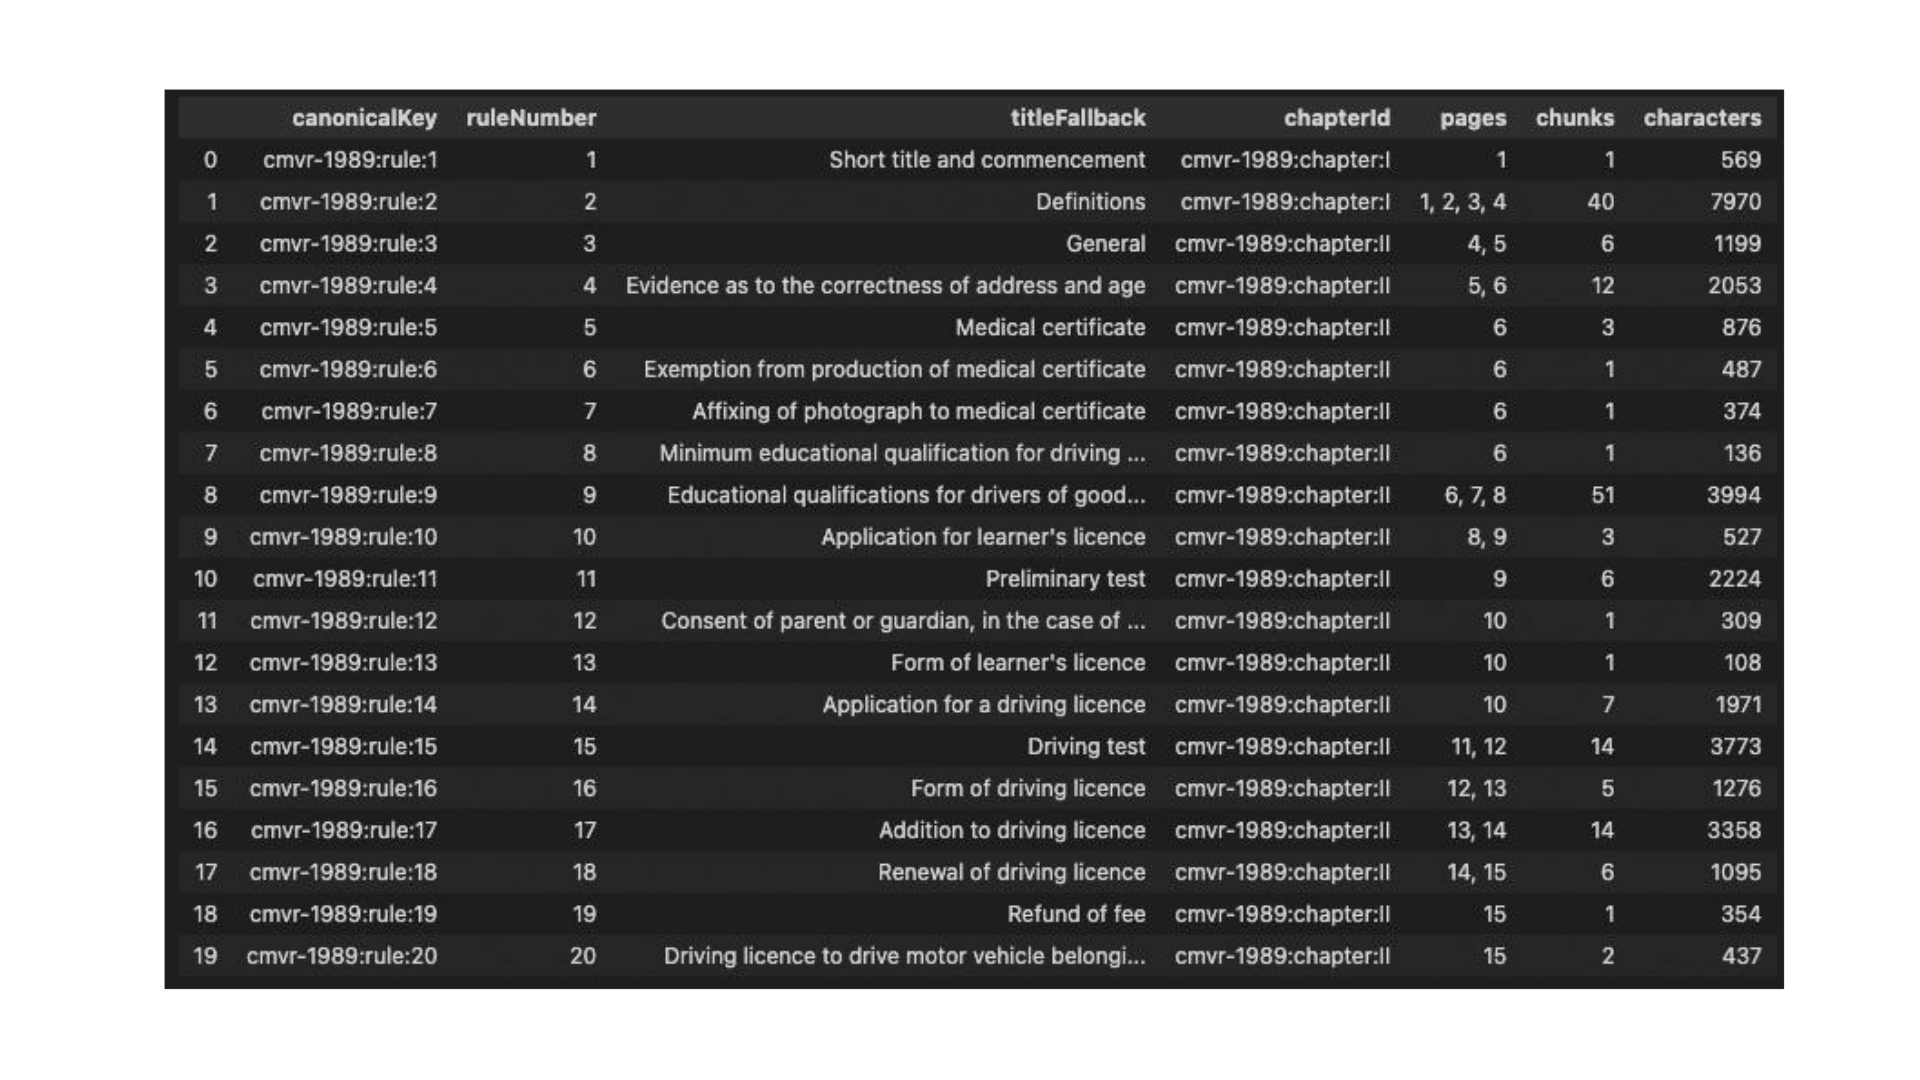
Figura 5. Estrutura de esquema de documento de IA
Criar os índices de pesquisa híbrida
Crie um índice do MongoDB Search para identificadores exatos e correspondência textual, e um índice do MongoDB pesquisa vetorial para o campo embedding. Defina mapeamentos, analisadores, filtros, dimensões de vetor e métrica de similaridade da implementação verificada.
índice de pesquisa
{ mappings: { dynamic: false, fields: { canonicalTitle: { type: "string", analyzer: "lucene.english" }, ruleText: { type: "string", analyzer: "lucene.english" }, documentId: { type: "token" } } }}Índice de pesquisa vetorial
{ fields: [ { type: "vector", path: "ruleTextEmbedding", numDimensions: 1024, similarity: "cosine" }, { type: "filter", path: "documentId" } ]}Executar recuperação léxica e semântica
Para uma query de usuário, recupere candidatos de palavra-chave e candidatos de vetor e, em seguida, combine-os com a lógica de fusão ou reranking verificada do aplicativo. Aplique filtros de categoria, status, revisão ou data de vigência antes de retornar os resultados para que uma passagem substituída não seja representada como atual.
Retornar resultados com procedência
Apresente o texto correspondente com o título, referência de regra ou seção, localizador de origem, revisão, data de vigência e status do ciclo de vida. Uma pontuação de relevância pode ajudar a classificar os candidatos, mas não estabelece compliance regulatório ou conformidade legal. O usuário deve poder inspecionar o material de origem.
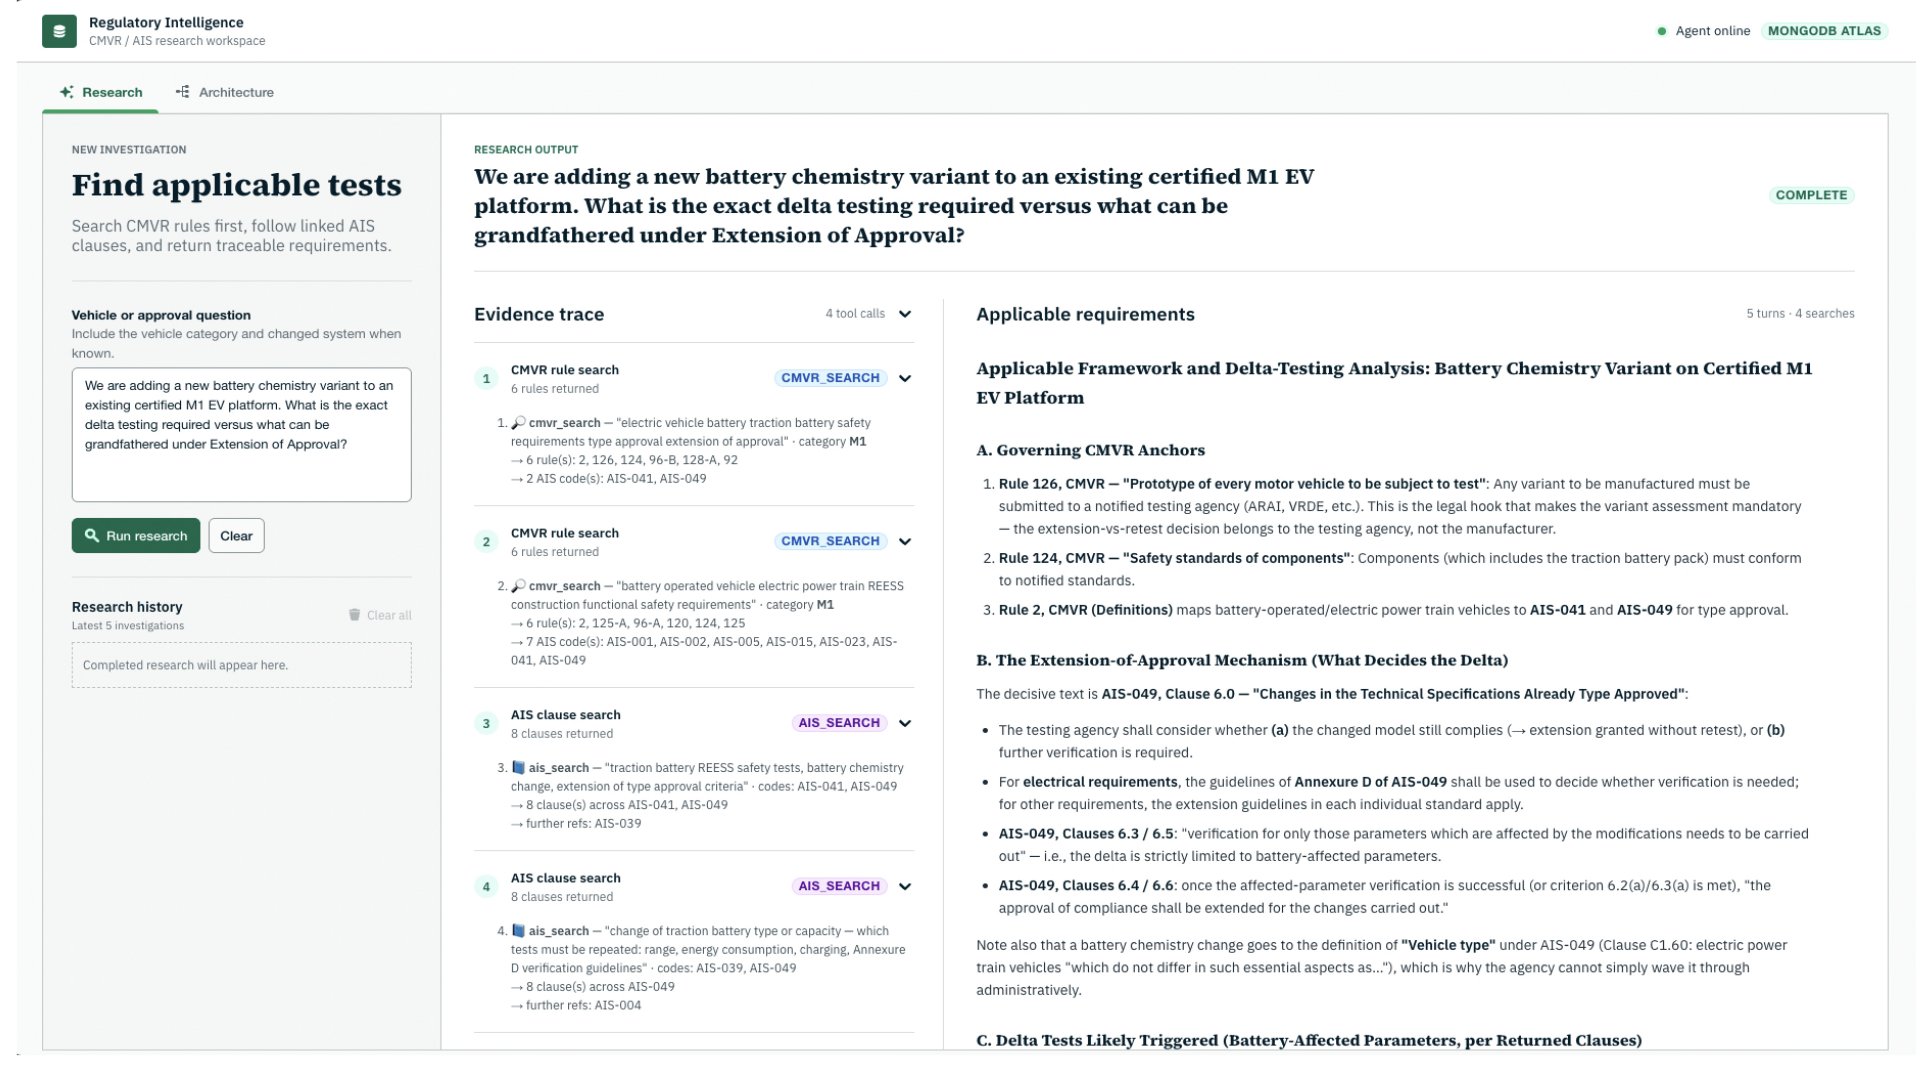
Figura 6. Captura de tela da IU mostrando uma query
Avaliar a qualidade da recuperação e o ciclo de vida do documento
Crie um conjunto de avaliação rotulado contendo pesquisas de identificadores, abreviações, sinônimos, requisitos de linguagem natural, consultas sensíveis a revisões e casos sem resultados.
Quando um documento é alterado, retirado ou substituído, atualize seus metadados de ciclo de vida e torne esse estado visível nos resultados da pesquisa. O sistema deve suportar verificação de origem; ele não deve ser posicionado como conselho jurídico, regulatório ou de compliance.
Principais Aprendizados
A pesquisa regulatória especializada exige mais do que a correspondência de texto: A combinação de recuperação lexical e semântica serve para identificadores padrão exatos e para a linguagem variada que os usuários aplicam ao mesmo requisito.
A procedência é um requisito do produto: cada passagem recuperada deve manter um identificador de fonte estável, localizador, revisão de documento e estado de ciclo de vida para que os usuários possam validar o material subjacente.
A revisão de documentos faz parte da relevância: Uma cláusula relevante, mas substituída, não deve ser apresentada como o requisito atual.
A pesquisa híbrida deve ser avaliada em relação a query de usuários representativas: contagens de candidatos, limites de resultados, pesos de fusão e metas de latência devem ser selecionados a partir da carga de trabalho real, em vez de copiados como padrão.
Uma experiência de pesquisa baseada em fontes acelera a verificação: Essa experiência aprimorada ajuda os usuários a localizar e verificar o material mais rapidamente; ela não faz por si só uma determinação de compliance.
Autores
Utsav Talwar, Arquiteto de Soluções, MongoDB
Humza Akhtar, campo CTO, Indústria de Manufatura, MongoDB