MongoDB Atlas でリアルタイムのサプライヤーリスクを評価。Voyage AI が提供するマルチモーダル検索を利用して、代替の供給業者を探します。
ユースケース: 人工知能、インテリジェント検索
業種: 小売
製品: MongoDB Atlas、 Voyage AI、 MongoDB Automated 埋め込み、 MongoDB ベクトル検索、 MongoDB Atlas Charts
ソリューション概要
グローバルサプライチェーンは、絶えず大規模な障害に直面しています。地政学的リスク、気象イベント、および物流のボトルネックは、突然の業務継続性の障害となります。
レガシーなエンタープライズ リソース プランニング (ERP) システムは、こうした急速な変化に適応できません。彼らは重要な供給業者情報を固定されたリレーショナルテーブル、静的なスプレッドシート、およびクエリできない PDF 契約書やメール内に囲い込めています。障害が発生すると、調達チームは分散したシステムから、何時間も何日も費やして手作業でデータを収集します。この遅延により、品切れ、予期せぬコスト、および消費者からの信用の失墜が発生します。
サプライヤーマネジメントをレガシーERPから切り離す MongoDB Atlas上に最新の統合インテリジェンスレイヤーを構築することで、コアを実現します。
このソリューションでは、MongoDB Atlas を 統合データ保存 (する) として見なします。これは、オペレーショナル保存 (する)、ベクトル保存 (する)、サーチエンジン、およびエージェントメモリとして同時に機能する 1 つのプラットフォームです。自律型エージェントが現在発生している障害について推論するために必要なすべてのコンテキスト(供給業者のロケーション、未処理の発注、証明書、および先例履歴)は、1 つのクエリでアクセスでき、同じコレクション内の同じアクセス制御下に存在します。
インテリジェンスデータレイヤーを基盤として、以下のバックエンドモジュールは、未処理の中断シグナルを、検証され、人間によって承認された決定に変換します。
ingestion_engine: LLM、エージェント、推論ループのない決定論的正規化レイヤー。これは、生の外部シグナル (地政学的データ、気候データ、ロジスティクスデータなど) をコンシステントな内部形式に変換し、そして Atlas に書き込み (write)ます。すべてのダウンストリームプロセスが依存するクリーンな開始点を提供します。risk_evaluator: LangGraphエージェントは、それらのシグナルをライブのサプライヤーデータや発注データと照らし合わせて読み取り、地理空間的にエクスポージャーを照合し、動的なリスク優先順位数 (RPN)を計算し、agent_memoryに保存された過去の事例を推論してから、平易な言語で書かれたリスクの概要をAtlasに書き戻します。alternative_finder: マネージャーがサプライヤーに対してアクションをフラグ付けすると、サプライヤーのドキュメントコーパスをハイブリッドベクトル検索と全文検索で検索し、候補を再ランク付けし、引用された証拠に基づいてすべての主張を監査し、残りのオプションを近接度でランク付けした上で、最終的な判断を人間に委ねるLangGraphエージェント。
MongoDB Atlas 上で運用データと AI 機能を統合することで、外部状況ににほんどリアルタイムで反応し、ビジネスを Agile に保つことができます。
参照アーキテクチャ
エージェントは、知っていることすべてではなく、コンテキストウィンドウに到達したものに基づいて推論します。エージェントのすべての決定は、事前のデータフィルターに依存します。データレイヤーは、まず情報を表面化、フィルター、ランク付けします。MongoDB Atlasをこのコンテキストレイヤーとして扱います。Atlasは、エージェントが推論する前に、どの証拠にトークンを割り当てるかを決定します。
ライブの中断を通じて推論するエージェントは、地理空間マッチング、ベクトル検索、フルテキスト検索、再ランキング、およびメモリ検索を実行します。個別のデータベース、ベクトル保存、検索エンジン間のやり取りは、エージェントの速度を低下させます。MongoDB Atlas 集計パイプライン内ですべてのクエリを実行する。1 つの API でスタック全体を置き換えます。
コンテキストの制御は、コストの制御でもあります。マルチエージェントシステムは、単一のチャットよりも最大15倍多くのトークンを消費します。冗長な検索はコストを増加させます。モデルのコンテキストを制御して、予算を管理しましょう。
供給先、事業障害シグナル、コンプライアンス証拠は絶えず変化します。柔軟な document model を使用して、1 つのコレクションにこのバリエーションを保存します。
グローバルなサプライチェーンは、多くの言語でエビデンスを生成します。Voyage AIは多言語のエビデンスをマッピングして1つの共有ベクトル空間にまとめ、Atlas Auto-埋め込みがこれらのベクトルを同期し続けます。多言語検索は、外部サービスではなく、データベースのネイティブなプロパティになります。
次のアーキテクチャ図と手順では、エンドツーエンドのワークフローと主要なデータベース機能の概要を説明します。未処理の外部フィードから承認された代替サプライヤーへシグナルを追跡する。
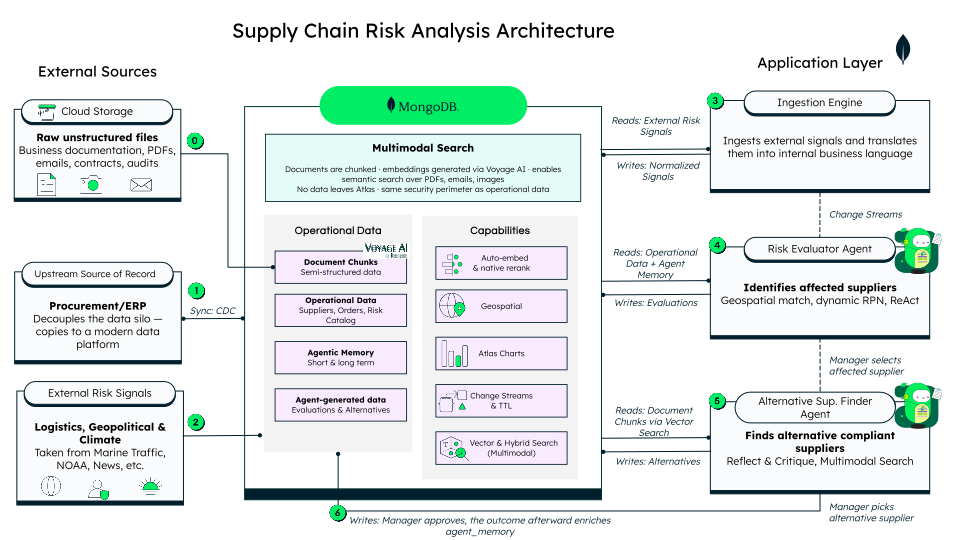
図1。高レベルの概要
ステップ 0: 非構造化ドキュメントの取り込み
PDF、メール、契約書、監査するレポートなどの未構造化ビジネスドキュメントを、クラウドストレージからMongoDB Atlasに直接保存します。Voyage AIのマルチモーダル埋め込みモデルは、チャンク化されたドキュメントを自動的に埋め込み、あらゆる言語で安全なデータベース内マルチモーダルおよび多言語検索を可能にします。
ステップ 1: ERP から分離する
ERP はビジネスルールを強制し、トランザクションワークフローを管理します。それらのルールは ERP に置いてください。サプライヤーと注文データを Change Data Capture (CDC) を介して Atlas にストリーミングし、エージェントが ERP を直接クエリする代わりにそのコピーから読み取れるようにします。
分離することで、ERP に依存せず、新しい機能を独自のタイムラインで発展させることが可能になります。
ステップ 2—3: 外部リスクシグナルの取り込み
物流、地政学、気候に関する現実世界のデータをオペレーショナルデータレイヤーに取り込みます。この外部リスクデータは、MarineTraffic、米国海洋大気庁(NOAA)、グローバルニュースフィードなどのソースから取得されます。このソリューションでは、インジェクションエンジンがセッションごとに3つのデモtrigger信号を生成し、フローを初期化します。
取り込みエンジンを介して生の外部シグナルを処理する。エンジンは、外部の障害イベントを正規化された内部ビジネス言語に翻訳し、構造化されたシグナルを MongoDB Atlas に書き込み (write)ます。
ステップ 4: 供給業者リスク評価(リスク評価エージェント)
正規化されたシグナルがMongoDB Atlasに到達したときに、Risk Evaluator エージェントをtriggerします。エージェントは運用データとagent_memoryを読み取り、地理空間マッチング($geoWithin)を実行し、動的RPNを計算して、評価をデータベースに書き込み (write)ます。
ステップ 5: 代替サプライヤーの検索 (代替サプライヤー検索エージェント)
マネージャーが影響を受けるサプライヤーを選択したときに、alternative_finder エージェントをアクティブにします。エージェントは、マルチモーダル ベクトル検索、ハイブリッド検索 ($rankFusion)、および ネイティブのリランキング ($rerank) を使用してドキュメントのチャンクをクエリし、準拠している代替サプライヤーを見つけてから、候補オプションを MongoDB Atlas に書き込み (write) ます。
ステップ 6: メモリ強化
`risk_evaluator` は、各障害にダイナミックなリスク優先順位数 (RPN) を付けます。エージェントがスコアを確定する前に、メモリがそのスコアに直接反映されます。
これは評価ごとにagent_memoryを2回クエリします。1回は供給業者自身の履歴のため、もう1回はリスクタイプ別の供給業者間の先例のためです。alternative_finder は調達側でも同じロジックに従います。候補者の追跡するレコードを確認し、類似のサプライヤーから意味的な前例を引き出してから、候補者をランク付けします。
Atlas は、両方のメモリ構造をネイティブに取り扱います。記憶には、構造化された事実(「このまさに同じことが起きました」)と意味的類似性(「このようなことが起きました」)の2つの形態があります。ほとんどのアーキテクチャでは、これらを 2 つのシステムに分裂します。1 つは事実用のデータベース、もう 1 つは類似性用のベクトルストアです。Atlas では、1 つのコレクションが両方を含んでいます。正確な find と $vectorSearch クエリは、構造化されたフィールドと埋め込まれたテキストが並んで存在するため、同じドキュメントに一致します。
インテリジェント サプライハブ ワークフロー
以下のスイムレーン図は、障害発生時にシステム層間で制御がどのように移るかを示しています。
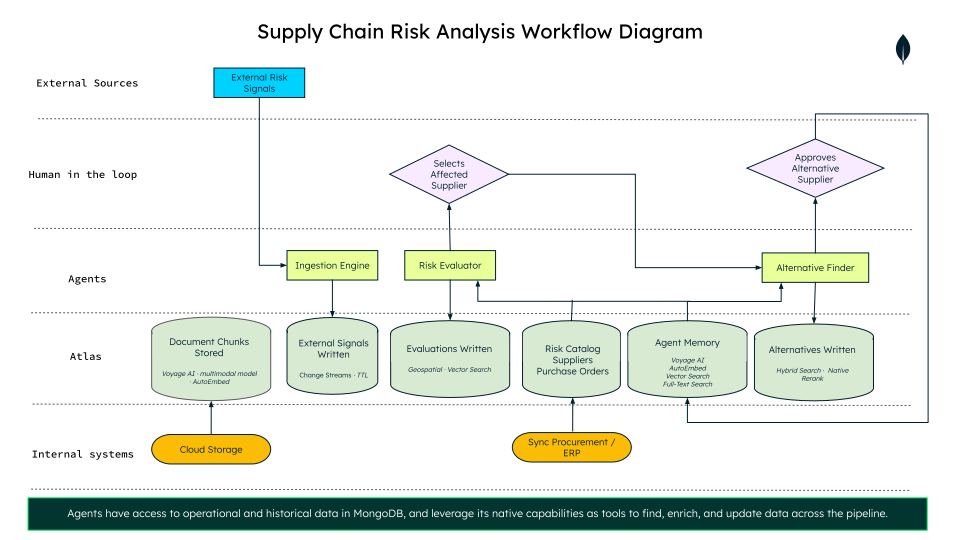
図2。供給チェーンリスク分析ワークフロー
外部リスクシグナルが到着すると、ingestion_engine はそれらを MongoDB Atlas にノーマライズし、risk_evaluator エージェントが供給業者リスクスコアを自動的に計算するようにトリガーする。ワークフローは最初の人間による決定点で一時停止し、調達マネージャーがフラッグ付きのリスクスコアを検討して影響を受ける供給業者を選択します。この選択により、alternative_finder エージェントが有効になり、MongoDB Atlas から置換候補を検索する、監査する、再ランクすることができます。最後に、2番目の人間の決定点で、マネージャーは代替サプライヤーを承認するために事前に提示され、引用されたコンプライアンス ドキュメントを検討します。これにより、サイロ化されたシステム、ファイル形式、外国語にわたる手動検索が削除されます。
データベース内マルチモーダルおよび多言語インテリジェンス
グローバルサプライチェーンマネジメントには、複数の言語で書かれた PDF 契約書、貿易協定書、コンプライアンス証明書、監査レポートなどの非構造化された複数形式のビジネス文書を検索する必要があります。
MongoDB Atlasは、Voyage AIのマルチモーダルベクトル埋め込みを運用データと直接並べて保存することで、この複雑さを取り扱います。これにより、検索不可能なドキュメントのサイロに埋もれてしまうような重要なコンプライアンスのインサイトを明らかにします。
Atlas 自動埋め込み
サプライヤーの非構造化コンプライアンス レコードと契約(たとえば PDF 契約、スキャンされた監査するレポート、貿易協定など)をチャンク化して埋め込み、それらを MongoDB Atlas に保存します。
autoEmbed タイプのベクトル検索インデックスを作成して、ドキュメントのチャンクで 自動埋め込み を有効にします。これにより、構成された Voyage AI モデルを使用して、データの挿入または更新時にベクトル埋め込みが自動的に生成されます。
db.suppliers.createSearchIndex( "suppliers_autoembed_index", "vectorSearch", { fields: [ { type: "autoEmbed", modality: "text", path: "auto_embed_text", model: "voyage-4" }, { type: "filter", path: "region" }, { type: "filter", path: "product_categories" }, { type: "filter", path: "status" } ] });自動埋め込みは、外部の埋め込みサービスおよび複雑な ETL パイプラインを削除し、MongoDB Atlas のセキュリティペリメータ内でデータを安全に保持できるようにします。
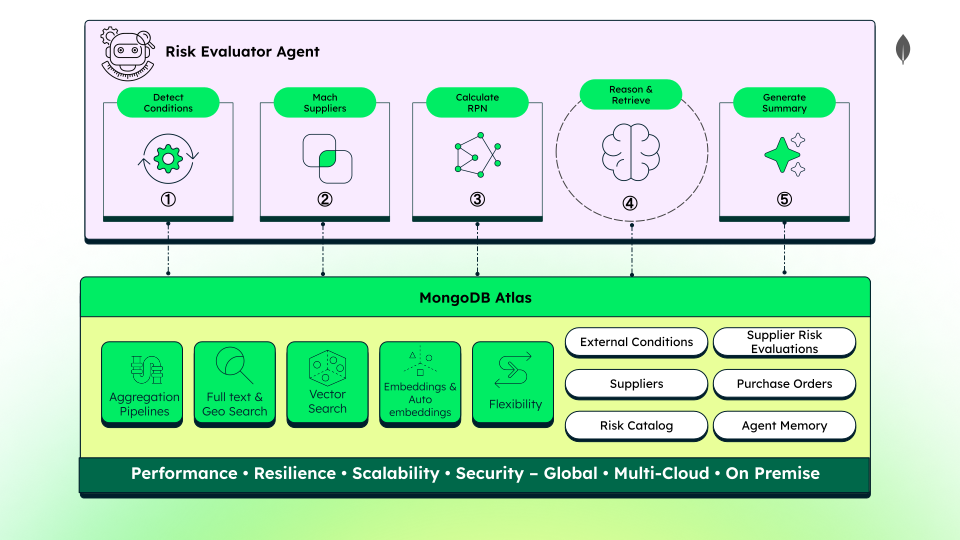
図3。リスク評価エージェント
集計パイプライン、検索機能、および柔軟な document model を活用して、これらのチャンクに対して高度なクエリを実行し、取り込んだデータのコンプライアンス検証を実施します。
マルチモーダル埋め込みの検索と取得
MongoDB Atlas に保存されているドキュメント チャンクを使用して、ハイブリッド検索で非構造化データをクエリします。障害発生時に代替パートナーを検索するために、動的検索クエリを構築します。地域プレフィルターと詳細な意味クエリ文字列を組み合わせる。例えば、「有効な品質認証を取得し、緊急配送の納期に対応する関税のない貿易ゾーン内の梱包材料メーカー」を検索します。
1 つの MongoDB Atlas 集計パイプラインでこの検索を実行します。$rankFusion ハイブリッド検索を使用して、フルテキスト検索の関連度とベクトル類似度を統合します。このハイブリッド クエリは、セマンティックな概念と正確なキーワードに同時に一致します。
融合の後にネイティブのリランクステージ($rerank)をVoyage AIのリランキングモデルを使用してチェーンし、検索精度を向上させます。データベース内のクロスエンコーダーは、クエリと候補チャンクを共同で評価し、正確な関連性スコアを計算します。パイプライン内でリランキングを実行することで、機密性の高いサプライヤーレコードをデータベースの境界内に安全に保持できます。
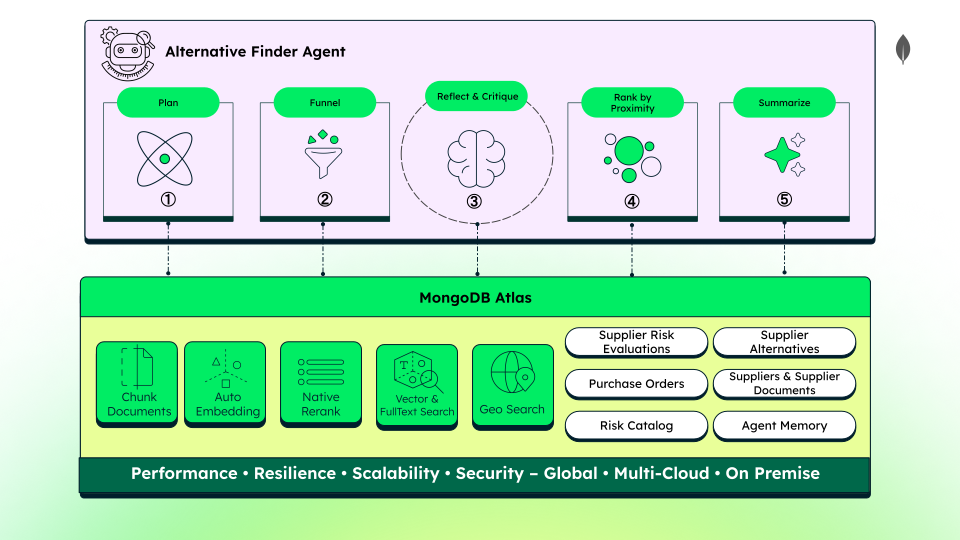
図4。代替供給者検索エージェント
多言語インテリジェンス
カスタムの翻訳パイプラインを構築することなく、あらゆる言語でグローバルサプライヤーのドキュメントを検索および分析する。Voyage AI 多言語モデルは、異なる言語のテキストを共有ベクトル空間にマップします。
データベースを英語でクエリし、アラビア語、スペイン語、中国語、またはベトナム語で書かれた関連する契約書や証明書を検索します。これらの多言語埋め込みをMongoDB Atlas 内でネイティブに保存することで、言語を超えたセマンティック検索をほぼゼロのレイテンシで実行できます。
グローバル供給業者のドキュメントを単一の多言語対応の検索インデックスに統合することで、国際的なコンプライアンスワークフローを簡素化し、翻訳のオーバーヘッドを除きます。
データモデルアプローチ
リジッドなデータベースは、互換性のないデータ形式をフラットなテーブルに強制します。実世界の供給チェーンエンティティは常に変化し、構造が複雑で常に変化しています。柔軟でドキュメントネイティブなスキーマにより、データモデルをビジネスのペースに合わせて進化させることができます。単一のAPIで、運用レコード、ベクトル埋め込み、および座標をネイティブに保存します。柔軟性のないデータベース移行による開発のダウンタイムを回避します。
このソリューションは、リスクと代替ソーシングを管理するために 8 つのコレクションを使用します。
コレクション名 | 目的 |
|---|---|
| TTL 期限切れ付きのライブの外部リスクシグナルを捕捉します。 |
| 静的な故障モード影響解析 (FMEA) リスクスコアとスレッショルドをエンコードします。 |
| GeoJSON ロケーションを含むマスター供給業者レコードを保存します。 |
| アクティブな注文を追跡し、金融エクスポージャーを定量化します。 |
| チャンク化された自動組み込みの供給業者契約および証明書を保管します。 |
| コンテキスト学習のために歴史的なリスクエピソードを保存します。 |
| ダイナミックな RPN スコアと自然言語によるリスクの概要を含みます。 |
| 人手による承認待ちのランク付き候補者ショートリストを保持します。 |
document modelの概要については、ソリューションのバックエンドのREADMEを参照してください。external_conditionsコレクションとsupplier_documentsコレクションを調べて、document modelの利点を確認してください。
external_conditions
external_conditions コレクションは、現実世界のリスクアラートのエントリポイントとして機能し、正規化された中断を保存します。異なるリスクタイプが、固定されたスキーマを強制することなく同じコレクション内で共存します。
次のフィールドは、すべてのリスク アラートでドキュメントに共通です。
{ "condition_id": "COND-20260505-0941", "risk_type_triggered": "logistics_disruption", "condition_score": 0.76, "has_physical_location": true, "detected_at": "2026-05-05T09:41:00Z", "valid_until": "2026-05-08T09:41:00Z"}気象アラートと物流アラートは、物理的なロケーションの正確な座標および影響半径を保存します。データに対して地理空間クエリを実行するには、座標は GeoJSON ポイントオブジェクトである必要があります。$geoWithin を使用して、指定された影響エリアの完全に内部にあるサプライヤーを検索します。
{ // other shared fields "epicentre": { "type": "Point", "coordinates": [114.1095, 22.5229] }, "impact_radius_km": 80, "has_physical_location": true,}地政学的アラートは、影響を受けたリージョンの配列とともにリージョンの境界を追跡する。影響を受けるリージョン内のサプライヤーをクエリするには、$in 演算子を使用します。
{ // other shared fields "affected_regions": ["CN", "HK"], "has_physical_location": false,}ingestion_engine は、多様な受信 API ペイロードを、前のコード例に示されているようなクリーンなドキュメント構造に正規化します。
ポリモーフィズムにより、両方のシグナルタイプを同時にクエリすることができます。$geoWithin および $in を使用して、1 回のデータベース呼び出しで統一されたジオマッチング クエリを実行します。この統合により、アプリケーションロジックが簡約化され、パフォーマンスをドレインするクエリの分割が防止されます。
supplier_documents
supplier_documents コレクションには、検索可能にされた非構造化された業務書類が含まれています。以下のドキュメントサンプルは、このコレクションレイアウトを示します。
{ "supplier_id": "SUP-882", "doc_type": "quality_certification", "filename": "certificado_SUP882_2024.pdf", "chunk_index": 2, "chunk_total": 4, "chunk_text": "ISO 9001:2015 and IATF 16949:2016. Valid 2024-11-01 to 2027-10-31...", "page_ref": 1, "valid_until": "2027-10-31T00:00:00Z", "embedding": [/* 1024 dimensions */]}chunk_text: 生の PDF ファイルから 400 から 600 トークンまでのテキストセグメントを保存します。この高精度なチャンク分割は、重要な条項を保持するために、大規模な契約を重複するセグメントに分割します。オペレーショナルデータベースのレコードとともに、非構造化ドキュメントコンテンツをネイティブに保存します。embedding: Voyage AI によって生成された 1024次元ベクトルを保存します。多言語モデルは複数の言語を1つの共有ベクトル空間にマップします。この整合により、英語の検索文字列を使用してスペイン語またはドイツ語のドキュメントをクエリできます。valid_until: コンプライアンス認証の有効期限を追跡し、期限切れのサプライヤー レコードを自動的に失効させます。
ソリューションのビルド
エージェントベースのサプライチェーンリスクソリューションを配置する。
前提条件
スタートする前に、次のアカウント、キー、およびソフトウェアを用意してください。
MongoDB Atlas アカウント:Atlas クラスター(M10 階層以上)。
Anthropic API Key: LLMの推論と計画を実行するための有効なAPIキー。
Docker Desktop: フロントエンドおよびバックエンドサービスを実行するために必要なアプリケーション。
Atlas セッティングの設定
コードを配置する前に、次の Atlas 機能を有効化します。
MongoDB Atlas アカウントにログインします。
有効化する プロジェクト設定で $rerank 集計ステージ。
プロジェクトレベルのVoyage Model APIキーをAtlasプロジェクト設定に追加します。
データベースの設定と初期データの投入
データベースを設定し、シード ファイルをインポートし、必要なインデックスをビルドして、デモを実行する。
MongoDB Atlasにログインし、Atlasクラスターにretail-supply-chain-riskという名前のデータベースを作成します。
Docs/設定/コレクション フォルダーから5つのシードJSONファイルをインポートします。
Collections 画面で新しいデータベースを選択します。
プラス(+)アイコンをクリックするか、Create Collection をクリックして 5 つのコレクションをそれぞれ追加します。
各コレクションを選択し、Import Data をクリックし、各々の JSON ファイルをアップロードします。
ベクトル検索、ハイブリッド検索、地理空間クエリを実行するために必要な地理空間インデックスと検索インデックスを作成します。インデックス構成は docs/設定/indexes フォルダーにあります。各インデックスを作成するには、次の手順を実行します。
mongosh "<your-connection-string>" --file suppliers-location-2dsphere.jsmongosh "<your-connection-string>" --file external_conditions-epicentre-2dsphere.jsmongosh "<your-connection-string>" --file suppliers_autoembed_index.jsmongosh "<your-connection-string>" --file agent_memory_autoembed_index.jsmongosh "<your-connection-string>" --file supplier_documents_vector_index.jsmongosh "<your-connection-string>" --file supplier_documents_fulltext_index.jsリポジトリをクローンし、環境変数を構成する
プロジェクト リポジトリを Github から複製します。
git clone https://github.com/mongodb-industry-solutions/retail-supply-chain-management.gitフロントエンドとバックエンドの環境変数を設定します:
サンプル フロントエンド/EXAMPLE.env をコピーして、同じディレクトリに新しい
.envファイルを作成します。プレースホルダー値を、お客様の構成詳細に置き換えてください。BACKEND_URLをhttp://127.0.0.1:8000に設定します。サンプル バックエンド/.env.例 を、同じディレクトリの新しい
.envファイルにコピーします。プレースホルダー値を、お客様の構成詳細に置き換えてください。Anthropic API キーをLLM_API_KEYとして追加します。
アプリケーションをビルドして起動する
Docker Compose を使用するか、またはバックエンドとフロントエンドを別々に実行することで、マルチサービス環境をコンパイルして起動します。
Docker Compose を使用してアプリケーションを起動するには、次のコマンドを実行します。
make buildサービスを手動で実行するには、まずフロントエンドを起動します。
cd frontendnpm inpm run devそして、ルート ディレクトリに移動し、バックエンドを起動します。
make uv_initmake uv_syncsource backend/.venv/bin/activatecd backenduvicorn main:app --reloadブラウザで http://localhost:3000 のフロントエンドダッシュボードを開きます。http://localhost:8000/docsで、インタラクティブなAPI Docsを確認します。
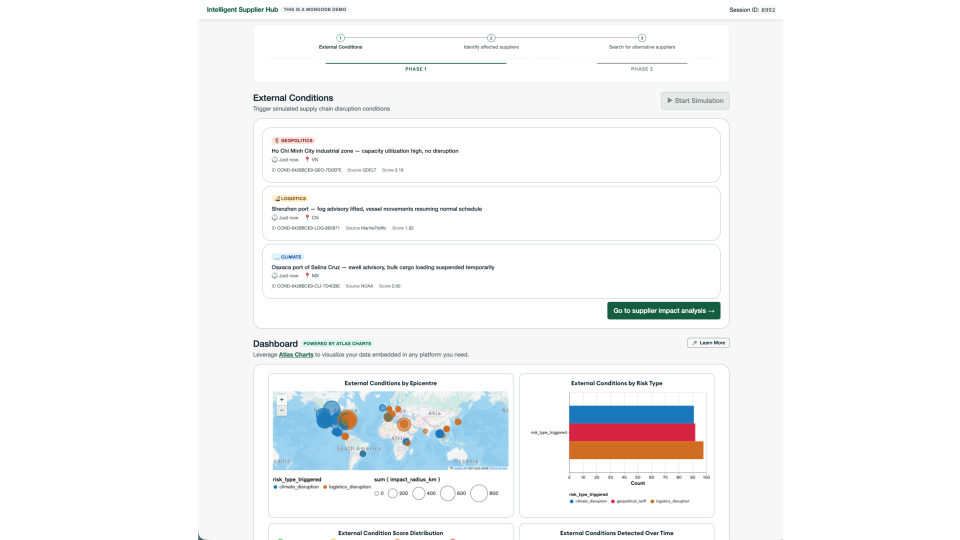
図5。インテリジェント サプライヤー ハブ システム
デモを操作するには、ユーザーガイド をお読みください。
キーポイント
このソリューションでは、AI を活用したサプライチェーン アプリケーションを構築するためのいくつかの重要なアーキテクチャパスワードなしを示しています。
コストを抑制する統合インテリジェンスレイヤーをビルドする: 硬直化したレガシーシステムからサプライヤーマネジメントを切り離すには、MongoDB Atlas で統合インテリジェンスレイヤーをビルドする。CDC を使用して ERP からデータを同期することで、1つのプラットフォーム上で運用データ、ベクトル埋め込み、エージェントメモリを統合します。この構造により、エージェントは ERP に直接クエリすることなく現在の状態を読み取ることができます。運用チェックと取得のために同じドキュメントを読み取り、その後、LLM が受け取る前に地理空間フィルター、ハイブリッド検索、およびリランキングを使用してデータをデターミニスティックに絞り込みます。モデルに入力されるものを制御することにより、推論パフォーマンスが最適化され、実行コストが削減されます。
複数言語の非構造化データを統合: PDF 契約、メール、スキャンされた監査するレポートなどの非構造化ドキュメントを、構造化プロバイダー レコードと一緒に保存します。Voyage AIを使用して、これらの多様な形式を1つのMongoDBコレクションに埋め込みます。この統一されたレイアウトにより、テキストと画像にわたる意味クエリが可能になり、個別のデータベースシステムを維持する必要がなくなるため、取得アーキテクチャを簡素化できます。さらに、マルチモーダル埋め込みモデルにより、翻訳オーバーヘッドなしで言語間のクエリを実現できます。
Atlas 内で検索とリランキングを統合: ベクトル検索、フルテキスト検索、ネイティブリランキングを 1 つのデータベース クエリ内で統合します。
$rankFusionを使用してハイブリッド検索を実行します。また、集計パイプライン内でネイティブな$rerankを Voyage AI と直接チェーンします。これにより、余計なネットワークホップ、API レイテンシ、およびカスタム認証情報のマネジメントが不要になります。
作成者
Florencia Arin, MongoDB
Angie Guemes, MongoDB
ローナン・コンロン、MongoDB
MongoDB、 MongoDB