保険における引受、保険金請求、およびサービスに関する意思決定は、通常、契約管理システム、保険金請求プラットフォーム、テレマティクス、サードパーティのリスクデータなど、多くの異なるシステムに分散しているコンテキストに依存しています。毎回手作業でそのコンテキストを組み立てるのは時間がかかり、一貫性がなく、監査するのも困難です。
このアーキテクチャは、MongoDB Atlas上のコンテキストレイヤーについて説明しています。これは、ビジネスオブジェクトのコンテキストを単一のライブオブジェクトに集約し、エージェントやアプリケーションが読み取り、書き込み (write)、実行できるようにするリアルタイムの運用データ階層です。
コンテキストレイヤーは、既存のレコードシステムとAIを活用したアンダーライティング、請求、サービスワークフローの間に位置するため、保険会社はエージェントが使用できるようにするためにそれらのシステムを置き換える必要はありません。これは、柔軟なdocument model、AIネイティブな検索、リアルタイムの変更伝播、フィールドレベルのガバナンスを組み合わせて、規制されたエージェント拡張意思決定ループが要求する低レイテンシと監査可能性の要件を満たします。
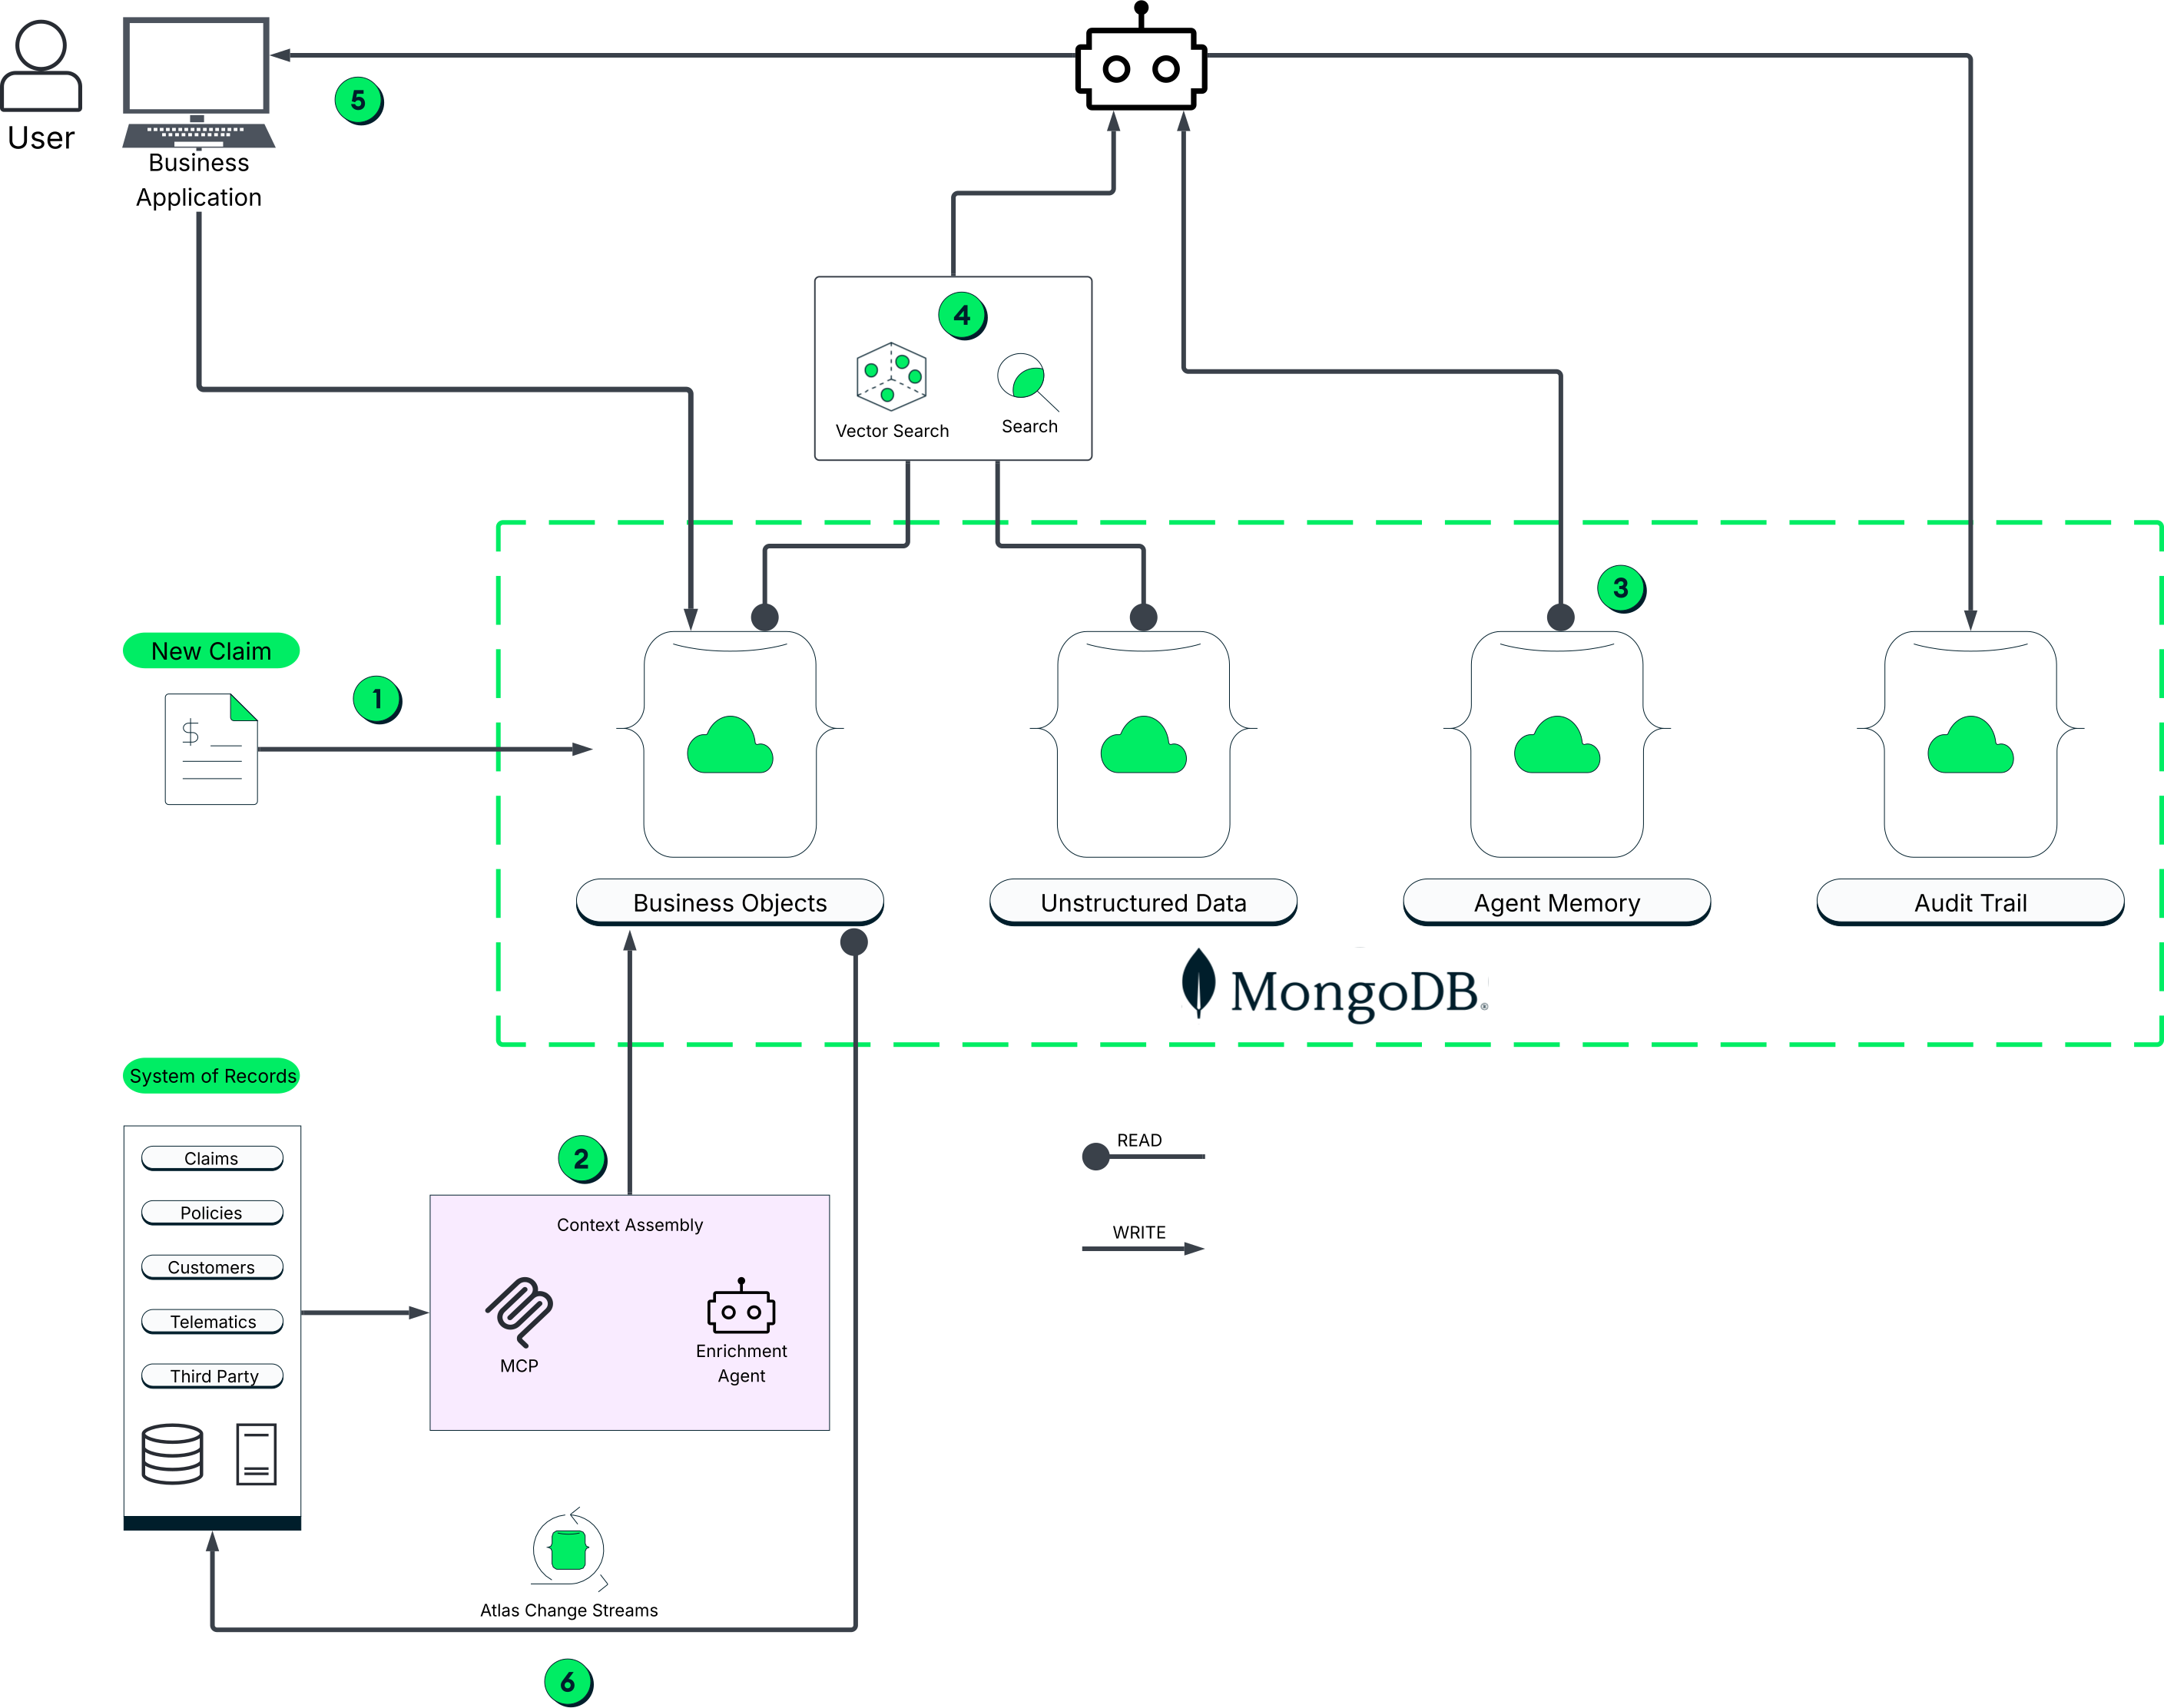
図1。コンテキストレイヤーアーキテクチャおよび AI エージェントのデータフロー
データフロー
以下のステップでは、単一の申請または請求がコンテキストレイヤーを通過し、取り込みから書き戻された監査可能な決定に至るまでの流れを追跡します。
提出または請求の受付
新しい申請や請求が到着すると、インテークサービスが主要な識別子と初期の構造化フィールドをキャプチャします。その情報が特定されると、インテークサービスはそれらをMongoDB Atlasの
business_objectsコレクションに単一のドキュメントとして書き込み (write)ます。コンテキストのエンリッチメントとアセンブリ
専門のエンリッチメントエージェントが、カバレッジ限度額、特約、損害の説明、アジャスターのメモなど、アンダーライターや保険金請求担当者が必要とする残りのコンテキストを収集します。エージェントは、レコードシステムからデータを収集し、単一のライブレコードを作成します。今では、アンダーライターやクレームエージェントが知識を集め、意思決定を行い、アクションを起こすために必要なすべてが、単一のMongoDBドキュメントに集約されています。
エージェントのメモリと状態の取得
コンテキストの拡充と同時に、サービスはこの申請または請求の以前のメモリも検索する。エージェントメモリには、この特定のケースに関する会話履歴、決定トレース、監査履歴、感情が保持されているためです。これにより、アンダーライティングまたは請求のエージェントは、以前のやり取り、推奨事項、人間による上書きを完全に記憶した状態で作業を再開できます。
構造化データおよび非構造化データに対するAIネイティブな検索
このサービスは、ビジネスオブジェクトと、アジャスターのメモ、損失のナラティブ、画像メタデータなどのリンクされた非構造化アーティファクトに対して、ハイブリッドな
$vectorSearchクエリと$searchクエリを発行します。これを行うには、ドメインに合わせて調整された埋め込みと再ランキングを使用できるため、エージェントは一致の生のリストではなく、最も関連性の高い履歴と前例を最初に確認できます。エージェントの決定、Human-In-The-Loop、および書き込み (write)戻し
エージェントは、収集されたコンテキストを検討し、見積もりを発行したり、詳細情報をリクエストしたりするなどのアクションを実行します。多くの場合では、最終的な改訂が常に人間の管理下に置かれるよう、このアクションは人間によって検討される必要があります。最後に、エージェントのアクションに対する完全なコンプライアンス、トレーサビリティ、透明性を確保するため、決定は、その完全な推論トレースとともに、エージェントによって MongoDB 内のエージェント自身の決定トレースのコレクションに不変の監査するエントリとして書き戻されます。
Change Streams によるリアルタイム伝播
MongoDB Change Streamsは、提出または請求を監視しているすべてのエージェント、ダッシュボード、およびダウンストリームシステムに更新をブロードキャストします。さらに、ユーザーはいつでも新しいシグナルを導入できるため、バッチするサイクルなしで、請求に関する新しい不正インジケーターがすぐに請求エージェントを起動するなど、エージェントを直接triggerするために使用できます。
コンポーネント
システム・オブ・レコード
システム・オブ・レコード(SoR)は、シングル・システム・オブ・レコード(SSoR)とも呼ばれ、重要なデータ要素やデータオブジェクトのデータソースとして勤める単一のコンピュータシステムです。SoRはデータの「真の状態」を保持します。つまり、その特定のデータソースで利用可能な、最も最新で正確かつ準拠したバージョンであることを意味します。
このアーキテクチャでは、レコードシステムがビジネス上のトランザクションのソースであり続けます。それらは本来の責任を保持し続け、コンテキストレイヤーがそれら全体にわたって利用可能な意思決定コンテキストを組み立てます。
ビジネスオブジェクトとエージェントメモリ
ビジネスオブジェクトは、提出物、請求、カスタマーレコードなどの運用エンティティを、継続的に強化される単一のドキュメントとして保持します。これにより、すべてのコンシューマーが分散したソースから情報を収集する必要がなく、同じ最新のビューから作業できるようになります。MongoDBは、このレコードとともにエージェントのメモリを保存するため、エージェントはマルチステップの意思決定全体にわたってコンテキストと監査する履歴を保持できます。
AIネイティブな検索
MongoDB ベクトル検索を全文検索やリランキングと組み合わせることで、エージェントは構造化フィールドと非構造化アーティファクトの両方から、最も関連性の高い損失履歴、前例、ガイドラインを単一のクエリで検索できます。個別のベクトル保存を調整する必要はありません。
リアルタイム伝播
MongoDB Change StreamsとネイティブのStream Processingにより、すべてのエージェントとダウンストリームシステムが提出物や請求の現在の状態と同期され、新しいシグナルやイベントが発生した際に、ポーリングやバッチするサイクルを待つことなく、直接エージェントをtriggerできるようになります。
監査する証跡
コンテキストレイヤーは、すべての読み取りと書き込み (write)に対して不変の監査トレールを保持するため、AIが支援するすべての意思決定は常に透明で追跡可能な状態に保たれます。1つのコレクションには、意思決定を行ったユーザー/エージェントのIDから、結論に至るまでのステップ、コンテキスト、AIメタデータ、意思決定の結果など、各意思決定に関する完全な情報が収集されます。
制限
このパスワードなしは複雑さを引き起こすため、意図的に採用する必要があります。
オペレーショナルレイヤーは、分析目的には必ずしも最適ではありません: このアーキテクチャは、分析専用のワークロード、アーカイブ用リポジトリ、またはリアルタイムのコンテキストアセンブリ、書き込み (write)、監査可能性を必要としない意思決定のユースケースには適していません。レポート作成やバッチする指向の分析が主なニーズである場合、オペレーショナルコンテキストレイヤーを追加しなくても、分析プラットフォームで十分な場合があります。
スキーマの柔軟性にはそれなりの規律が求められます: このアプローチにも、データモデリング、ID解決、ガバナンス、ライフサイクルマネジメントにおける規律が求められます。コンテキストレイヤーは、大規模で複雑なオブジェクトと進化するスキーマを蓄積できます。そのため、チームはオブジェクトの境界、期待、および更新パスワードなしを早期に定義する必要があります。
アップストリームシステムの複雑さは解消されません:意思決定時の断片化は軽減されますが、依然として信頼性の高いアップストリームのデータアクセスとデータ品質に依存しています。ソースの品質が低い、またはイベント設計が不十分である場合、それらはコンテキストレイヤー内で消えるのではなく、表面化します。
このアーキテクチャは、定義済みのデータモデルを持つ特定のユースケースに合わせて調整し、実証済みのリファレンスワークフローから拡張する場合に最も効果的です。
詳細
その他のリファレンスアーキテクチャをご覧ください。