Esta guía describe cómo realizar búsqueda semántica con modelos de Voyage AI. Esta página incluye ejemplos de casos de uso de búsqueda semántica básicos y avanzados, incluyendo búsqueda con reordenamiento, multilingüe, multimodal, fragmento contextualizado y recuperación de corpus grandes.
Realizar búsqueda semántica
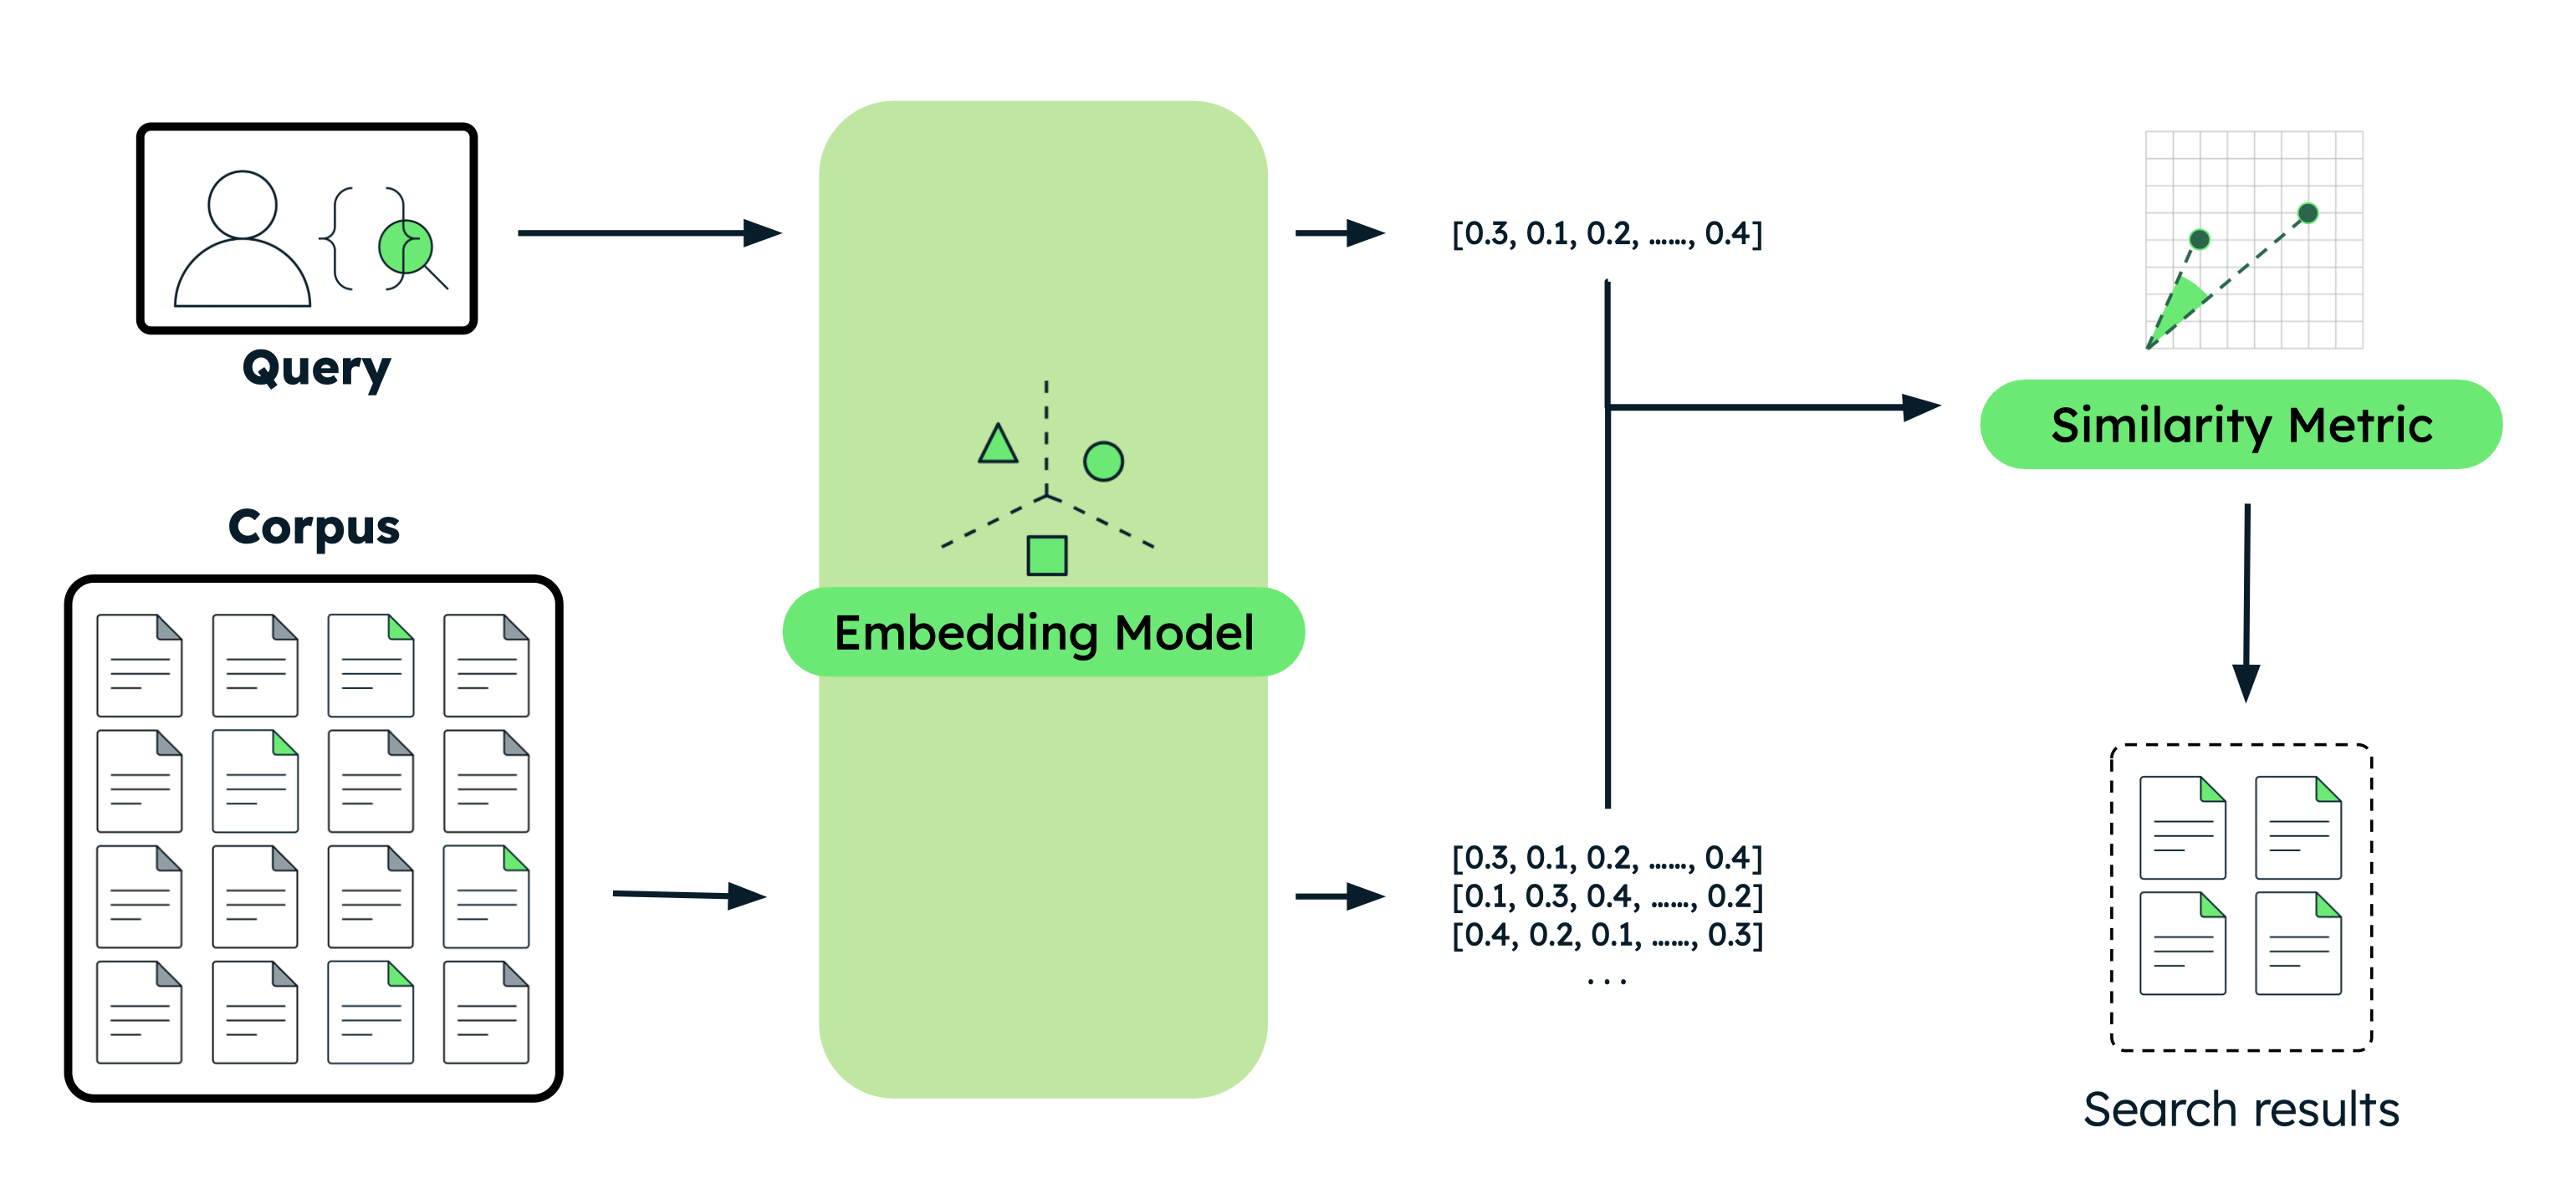
Esta sección proporciona ejemplos de código para varios casos de uso de búsqueda semántica con diferentes modelos de IA de Voyage. Para cada ejemplo, realiza los mismos pasos básicos:
Incorpora los documentos: convierte tus datos en incrustaciones vectoriales que capturen su significado. Estos datos pueden ser texto, imágenes, fragmentos de documentos o un gran corpus de texto.
Embed the query: transforma tu query de búsqueda en la misma representación vectorial que tus documentos.
Encontrar documentos similares: Compara el vector de query con los vectores de tus documentos para identificar los resultados más semánticamente similares.
Configura tu entorno.
Antes de comenzar, crea un directorio de proyecto, instala las bibliotecas y configura la clave de API de tu modelo.
Ejecuta los siguientes comandos en tu terminal para crear un directorio nuevo para este tutorial e instalar las bibliotecas requeridas:
mkdir voyage-semantic-searchcd voyage-semantic-searchpip install --upgrade voyageai numpy datasetsSi aún no lo has hecho, sigue los pasos para crear una clave de API de modelo, luego ejecuta el siguiente comando en tu terminal para exportarla como una variable de entorno:
export VOYAGE_API_KEY="your-model-api-key"
Sobre los Ejemplos
La siguiente tabla resume los ejemplos de esta página:
Ejemplo | Modelo utilizado | Comprender los resultados |
|---|---|---|
Búsqueda semántica básica |
| El documento de llamada de conferencia de Apple ocupa el primer lugar, significativamente más alto que los documentos no relacionados, lo que demuestra una coincidencia semántica precisa. |
Búsqueda semántica con reorganizador |
| La reclasificación mejora la precisión de la búsqueda al analizar la relación completa entre query y documento. Si bien la similitud de incrustaciones por sí sola sitúa el documento correcto en primer lugar con una puntuación moderada, el reranker refuerza significativamente su puntuación de relevancia, separándolo mejor de resultados irrelevantes. |
Búsqueda semántica multilingüe |
| Los modelos Voyage realizan búsquedas semánticas de manera eficaz en diferentes lenguajes. El ejemplo demuestra tres búsquedas separadas en inglés, español y chino, cada una identificando correctamente los documentos más relevantes sobre ganancias de empresas tecnológicas dentro de sus respectivos idiomas. |
Búsqueda semántica multimodal |
| El modelo admite texto, imágenes y vídeo entrelazados. También admite la búsqueda exclusiva de imágenes y vídeos. En ambos casos, las imágenes de mascotas (gatos y perros) se clasifican significativamente más alto que la imagen de plátano no relacionada, lo que demuestra una recuperación precisa del contenido visual. Las entradas intercaladas con texto descriptivo generan puntuaciones de similitud ligeramente superiores que las entradas solo de imagen. |
Embeddings de fragmentos contextualizados |
| El 15% de crecimiento de ganancia fragmento ocupa el primer lugar porque está vinculado al documento de Leafy Inc. El fragmento de crecimiento similar del 7% de Greenery Corp. obtiene puntuaciones más bajas, mostrando cómo el modelo considera con precisión el contexto del documento para distinguir entre fragmentos que de otro modo serían similares. |
Búsqueda semántica con un corpus grande |
| El documento de referencia sobre el contenido de usuario ocupa el primer lugar entre 154 documentos, lo que demuestra una recuperación eficaz a gran escala a pesar de la complejidad semántica. |
¿Qué es la búsqueda semántica?
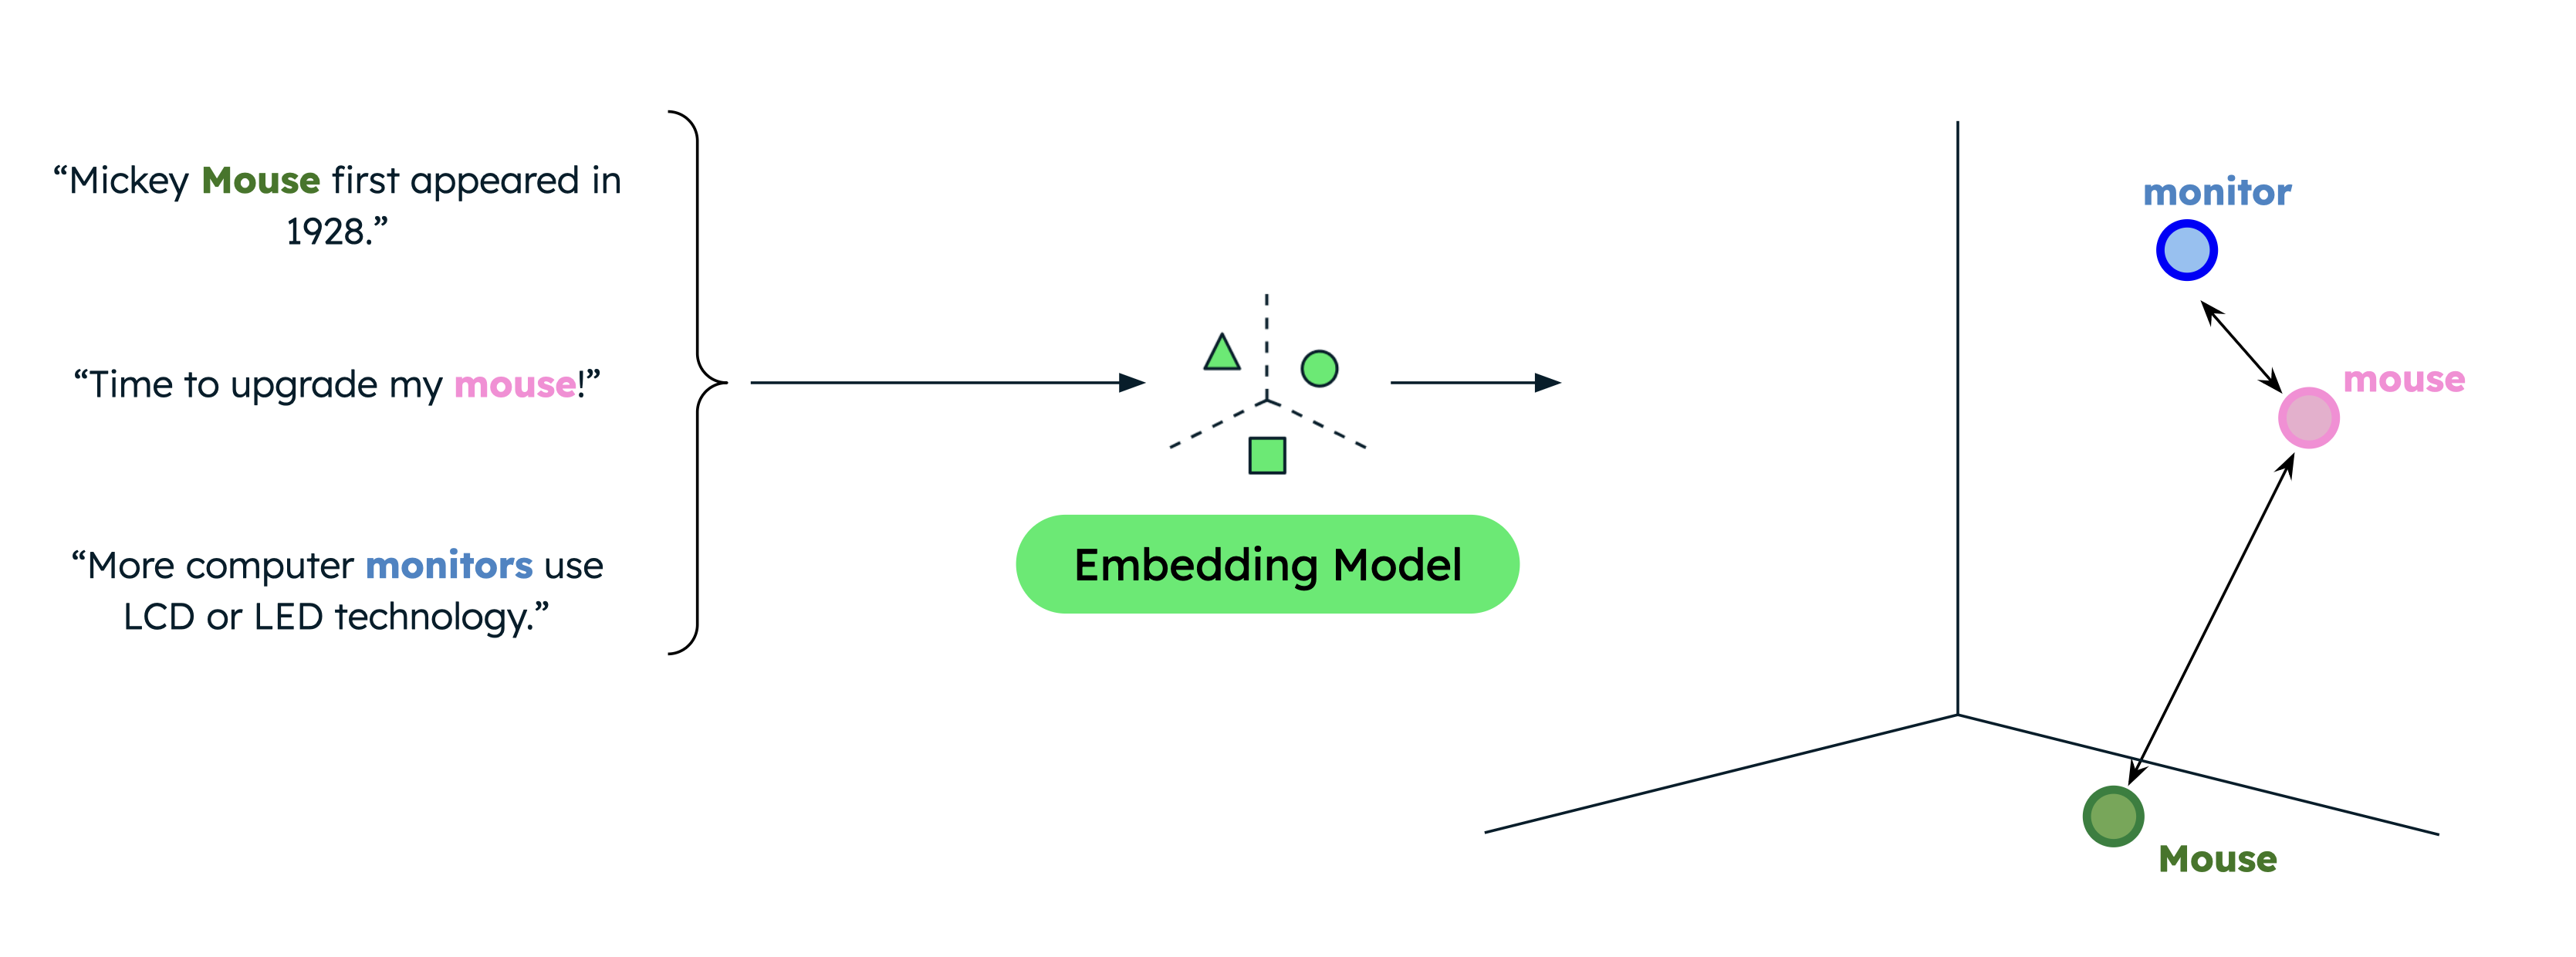
La búsqueda semántica es un método de búsqueda que devuelve resultados basados en el significado semántico o subyacente de tus datos. A diferencia de la búsqueda clásica de texto completo que encuentra coincidencias exactas de texto, la búsqueda semántica encuentra vectores que están cerca de tu consulta de búsqueda en un espacio multidimensional. Cuanto más cercanos estén los vectores a tu query, más similares serán en significado.
Ejemplo
La búsqueda textual tradicional solo devuelve coincidencias exactas, limitando los resultados cuando los usuarios buscan con términos diferentes a los que hay en tus datos. Por ejemplo, si tus datos contienen documentos sobre ratones de computadora y ratones animales, la búsqueda de "mouse" cuando se pretende encontrar información sobre ratones de computadora da como resultado coincidencias incorrectas.
La búsqueda semántica, sin embargo, capta la relación subyacente entre palabras o frases incluso cuando no hay coincidencia léxica. Buscar "mouse" cuando se indica que se buscan productos informáticos resulta en resultados más relevantes. Esto se debe a que la búsqueda semántica compara el significado semántico de la consulta de búsqueda con los datos para devolver solo los resultados más relevantes, independientemente de los términos de búsqueda exactos.
Búsqueda semántica en producción
Si bien el almacenamiento de tus vectores en memoria y la implementación de tus propios pipelines de búsqueda es adecuado para la creación de prototipos y experimentos, utiliza una base de datos vectorial y una solución de búsqueda empresarial para aplicaciones en producción a fin de realizar una recuperación eficiente a partir de un corpus más grande.
MongoDB tiene soporte nativo para el almacenamiento y la recuperación de vectores, lo que lo convierte en una opción conveniente para almacenar y buscar incrustaciones de vectores junto con sus otros datos. Para completar un tutorial sobre cómo realizar una búsqueda semántica con MongoDB búsqueda vectorial, consulte Tutorial de inicio rápido de MongoDB búsqueda vectorial.
Próximos pasos
Combina búsqueda semántica con un LLM para implementar una aplicación RAG.