Overview
Las siguientes secciones describen las opciones de implementación de MongoDB Search en Atlas.
Puedes estructurar tu clúster con diferentes tipos de implementaciones, proveedores de nube y niveles de clúster para satisfacer las necesidades de un entorno de preproducción o producción. Utilice estas recomendaciones para seleccionar el tipo de implementación, el proveedor de nube y la región, así como los niveles de clúster y búsqueda para realizar una búsqueda vectorial.
Entorno | Tipo de implementación | Nivel de clúster | Región del Proveedor de la Nube | Arquitectura de nodo |
|---|---|---|---|---|
Consultas de prueba | Clúster Flexible o Dedicado | Clúster gratuito, Flex o de nivel superior | Todo | Los procesos de MongoDB y búsqueda se ejecutan en el mismo nodo. |
Prototipado de aplicaciones | Clúster dedicado, particionado o sin partición |
| Todo | Los procesos de MongoDB y búsqueda se ejecutan en el mismo nodo. |
Producción | clúster dedicado con nodos de búsqueda separados, particionado o no particionado |
| AWS y Azure en algunas regiones o Google Cloud en todas las regiones | Los procesos de MongoDB y Search se ejecutan en diferentes nodos. |
Community Edition | Implementación autogestionado. Usted mismo instala y opera | N/A. Usted proporciona su propio hardware o instancias en la nube. | N/A. Usted elige su propia infraestructura. | Los procesos de MongoDB y búsqueda se ejecutan en un único o varios host autogestionados. |
Las siguientes secciones describen cada entorno:
Entornos de pruebas y prototipos
Para probar tus consultas de búsqueda y prototipar tu aplicación, te recomendamos el tipo de implementación y la arquitectura de nodos que se describen en las siguientes secciones.
Esta configuración es la más adecuada para los siguientes casos de uso:
Menos de 2M de documentos totales para indexar
Menos de 10GB de datos indexados.
Menos de 10,000 consultas en un período de 7días
Si el uso supera los valores listados, migrar a nodos de búsqueda dedicados.
Las siguientes secciones describen esta arquitectura de nodo con más detalle.
- Tipo de implementación
Para probar consultas de MongoDB Search en clústeres en la nube, puedes implementar un clúster Flex o un clúster dedicado.
Para probar las consultas de MongoDB Search localmente, crea una implementación local de Atlas utilizando la Atlas CLI. Podría ser un set de réplicas de un solo nodo alojado en la computadora local. Las implementaciones locales están limitadas por los recursos de CPU, memoria y almacenamiento de tu máquina local. Cuando tu aplicación esté lista para la producción, migra la implementación local de Atlas a un entorno de producción.
- Cluster Tiers
Para probar sus consultas de MongoDB Search, use clústeres gratuitos (antes conocidos como
M0) y clústeres flexibles.Para crear prototipos de su aplicación, utilice clústeres dedicados de nivel
M10,M20y superior o implemente nodos de búsqueda dedicados para el aislamiento de la carga de trabajo. Cuando su aplicación esté lista para la producción y para gestionar grandes conjuntos de datos, escale a niveles superiores.- Proveedor de nube y región
Utiliza cualquier región de proveedor de nube compatible.
El proveedor de nube y la región que elija afectan las opciones de configuración disponibles para los niveles de clúster y el costo de funcionamiento del clúster.
Arquitectura de nodo
Para entornos de prueba y creación de prototipos, recomendamos una arquitectura de nodo en la que los procesos de MongoDB y los procesos de MongoDB Search se ejecuten en el mismo nodo. En el siguiente diagrama de este modelo de implementación, el proceso de MongoDB Search mongot se ejecuta junto con mongod en cada nodo del clúster de Atlas y comparten los mismos recursos.
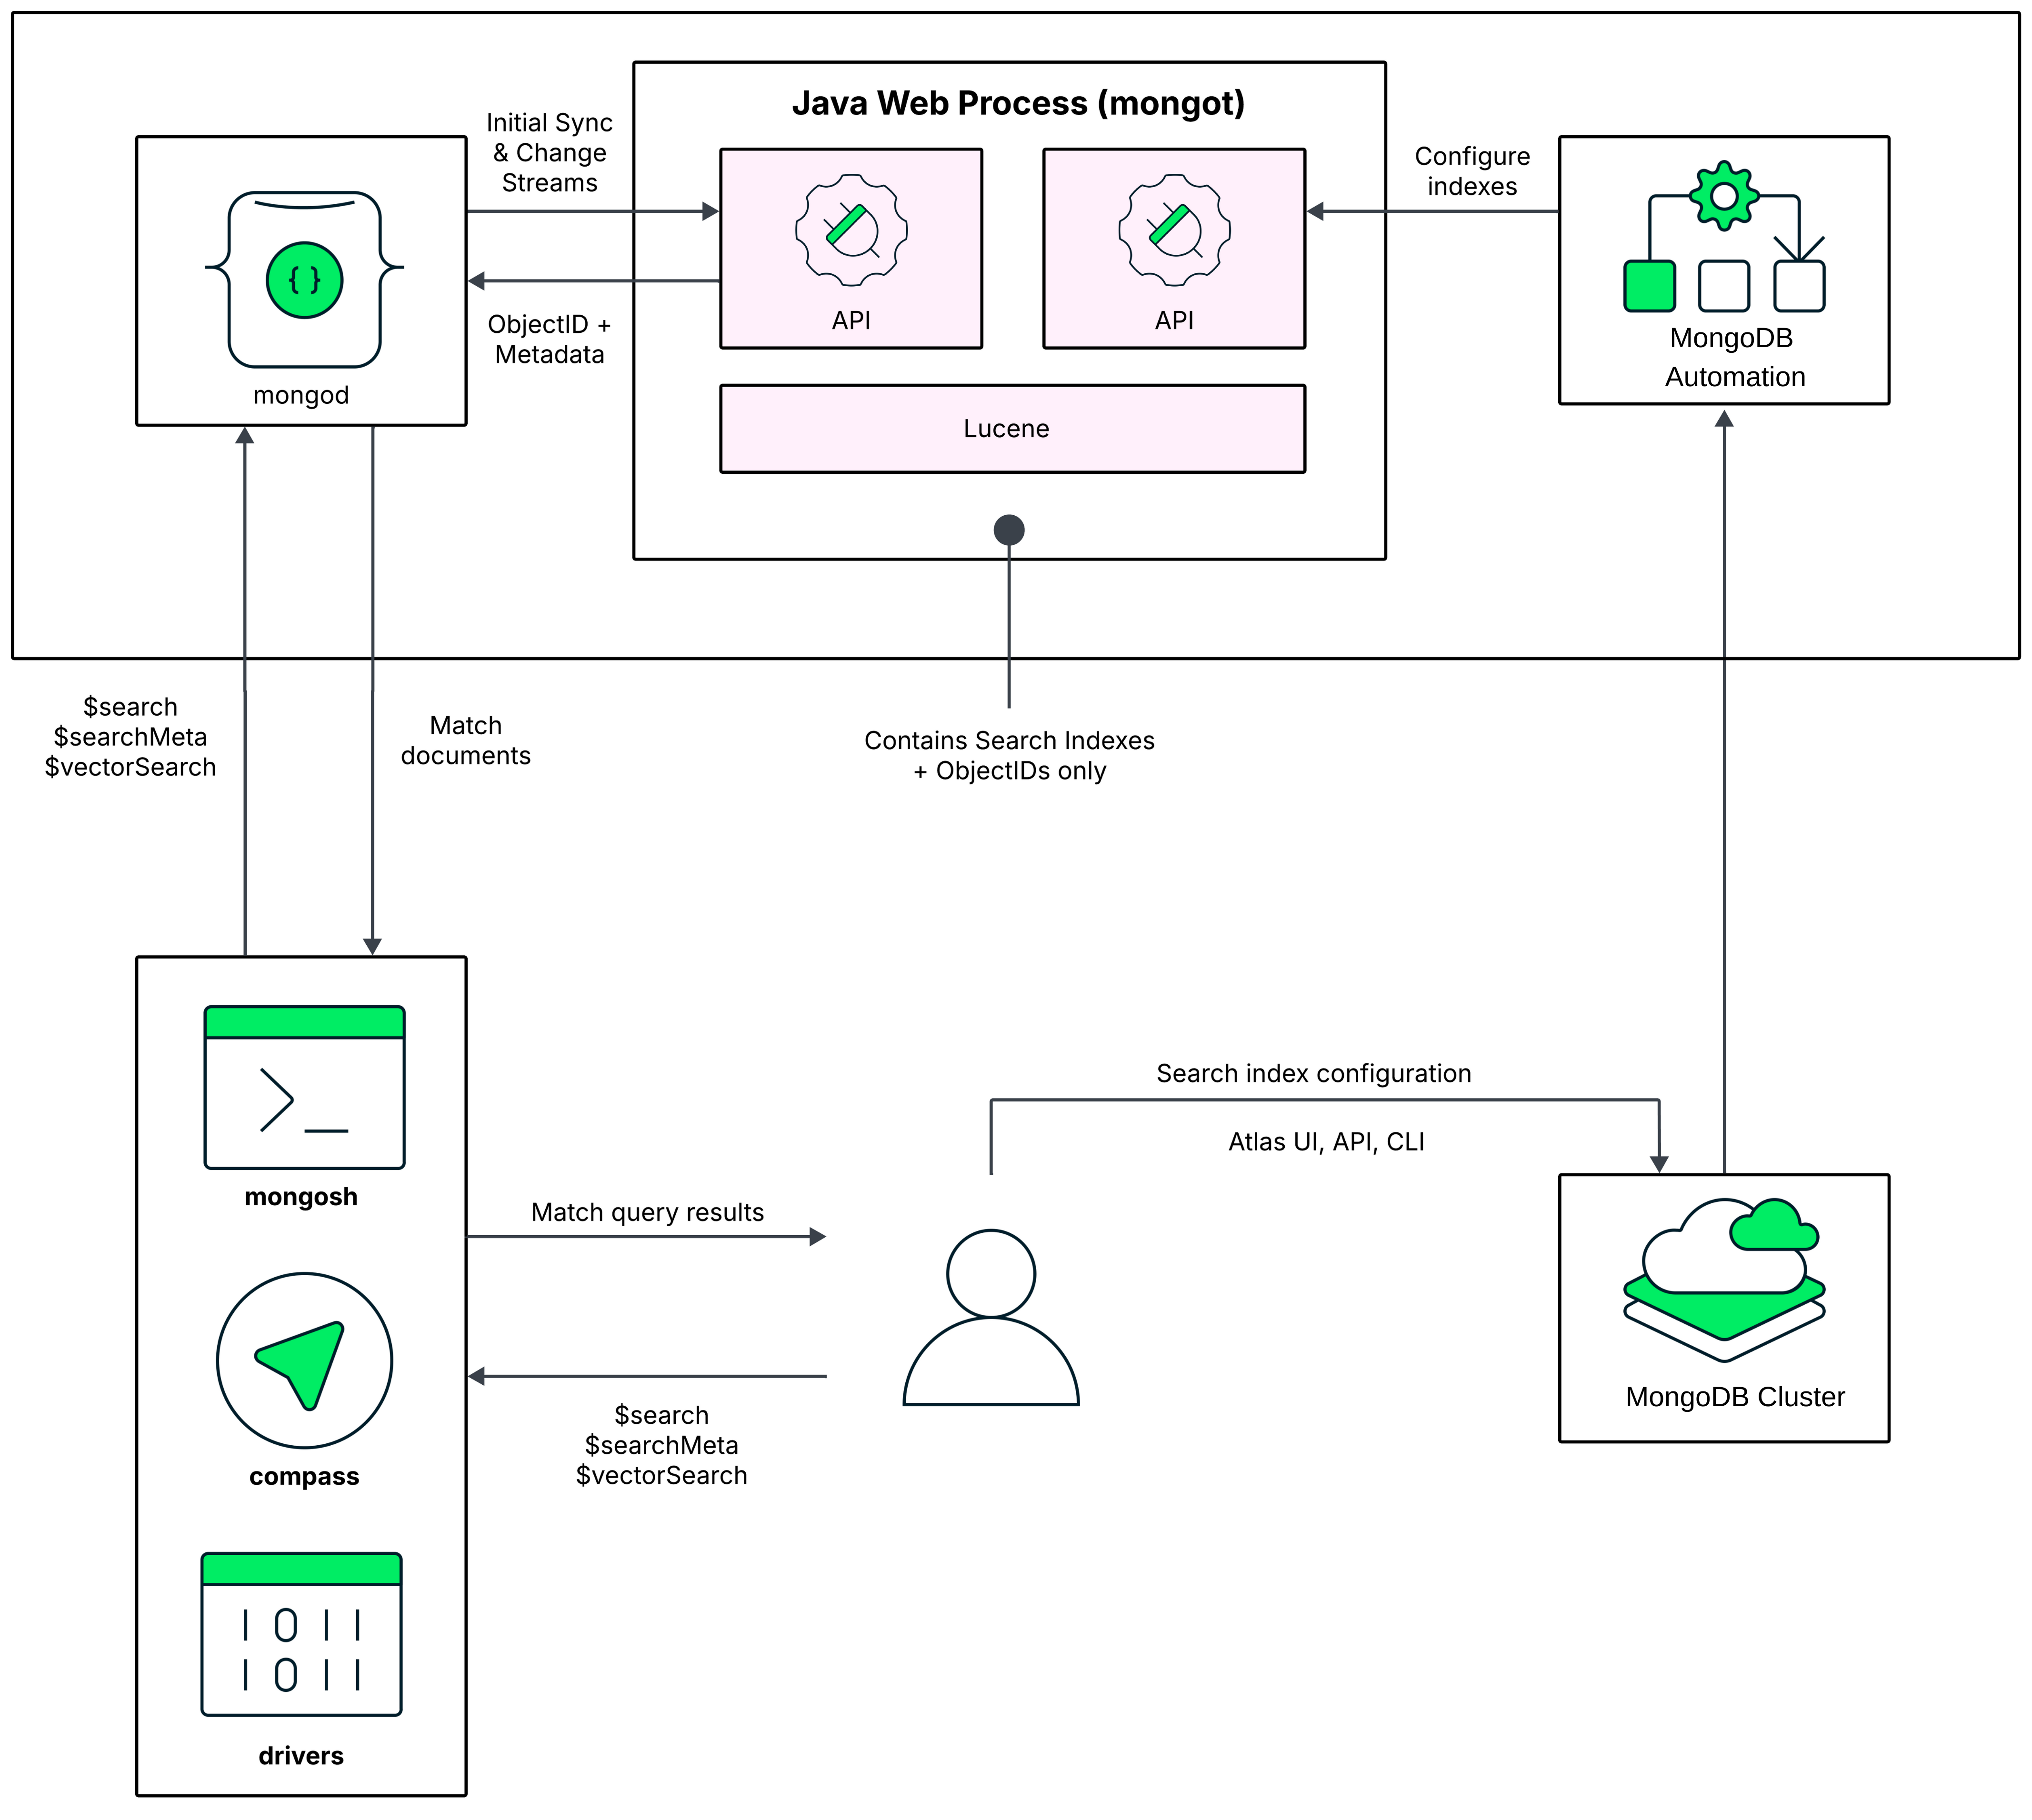
Por defecto, Atlas habilita el proceso MongoDB Search mongot en el mismo nodo que ejecuta el proceso mongod cuando creas tu primer índice MongoDB Search.
Para aprender cómo MongoDB Search procesa las query en esta arquitectura, consulte Procesamiento de query.
Puede definir fuentes almacenadas campos en su índice de MongoDB Search para que el proceso mongot pueda almacenar los campos especificados en mongot. Luego puede utilizar la opción returnStoredSource en su consulta MongoDB Search para recuperar los campos almacenados para los documentos coincidentes directamente desde mongot en lugar de realizar una búsqueda completa de documentos en la base de datos.
Beneficios
Cuando habilitas MongoDB Search, puedes compilar fácilmente búsquedas sobre tus datos con un motor de búsqueda integrado y totalmente gestionado que se sincroniza automáticamente con tu base de datos. MongoDB Search proporciona un languaje del query enriquecido que utiliza etapas del pipeline de agregación de MongoDB Search como $search y $searchMeta para la búsqueda de texto completo y $vectorSearch para la búsqueda semántica junto con otras etapas del pipeline de agregación de MongoDB, y la clasificación de resultados basada en puntuación.
Dependiendo de los recursos aprovisionados para tu clúster, implementar ambos procesos en el mismo nodo podría ser más rentable que ejecutar el proceso de búsqueda en un nodo dedicado por separado.
Limitaciones
Podría experimentar contención de recursos entre los procesos de la base de datos mongod y de búsqueda mongot. Esto podría tener un impacto negativo en el rendimiento de su índice y la latencia de sus query. Para admitir aplicaciones listas para producción y sus cargas de trabajo de búsqueda migre a nodos de búsqueda dedicados.
Costo
No hay tarifas ni cargos adicionales por habilitar MongoDB Search en tu clúster. Sin embargo, podrías observar un aumento en la utilización de recursos en el clúster para grandes colecciones indexadas o definiciones de índices.
Considerations
Puesto que los procesos mongod y mongot se ejecutan en el mismo nodo, es posible que mongot deje de estar disponible en determinadas circunstancias. En la siguiente tabla se describen las posibles causas:
Causa | Descripción |
|---|---|
Escalado de nivel de clúster - almacenamiento de red | Cuando escales un clúster hacia arriba o hacia abajo, Atlas aprovisiona una nueva instancia. Una vez que la instancia está lista, Atlas adjunta el almacenamiento de red e inicia Si |
Escalado de nivel de clúster - SSDlocal | When you scale an Atlas cluster using local SSD, you can't retain storage and reattach it to the new nodes. Therefore, Atlas performs an initial sync to rebuild the search indexes. Search queries fail until the initial sync is complete. |
Downgrade de Lucene | En casos excepcionales en los que necesite degradar Lucene, es posible que no pueda leer los formatos de índice de Lucene más recientes. |
Ajuste de almacenamiento | Se puede conservar el almacenamiento en red conectado a los nodos del clúster de Atlas. Esto le permite expandir o contraer la capacidad de volumen sin impacto en Sin embargo, conservar el almacenamiento en red puede no ser posible en ciertas regiones, cuando el clúster utiliza discos locales NVMe, o en otras circunstancias poco frecuentes. En estos casos, Atlas realiza una sincronización inicial y las consultas de búsqueda fallan hasta que se complete la sincronización inicial. |
| Durante una actualización de la versión |
Nuevo nodo | Cuando añades un nuevo nodo a tu clúster, Atlas realiza una sincronización inicial para crear los índices de búsqueda. Las consultas de búsqueda que utilizan el nuevo nodo |
Reinicio o reemplazo de instancia |
|
| Cada vez que el proceso |
Ambiente de producción
Para su aplicación lista para producción, recomendamos utilizar el tipo de implementación y la arquitectura de nodos descritos en las siguientes secciones.
Esta configuración es la más adecuada para los siguientes casos de uso:
Si decides migrar tu entorno de pruebas existente a producción, añade nodos de búsqueda dedicados a tu clúster. Para aprender más información, consulta Migrar a Nodos de Búsqueda Dedicados.
Si creas una nueva implementación de producción desde cero, asegúrate de utilizar
M10o clústeres de mayor nivel que sean compatibles con MongoDB Search en las regiones y zonas donde MongoDB Search está disponible, y añade Nodos de Búsqueda dedicados a tu entorno. Para obtener más información, consulte Agregar nodos de búsqueda dedicados.
- Tipo de implementación
Para las aplicaciones listas para producción, utiliza
M10,M20y los niveles superiores de clústeres dedicados. Estos clústeres de nivel superior pueden gestionar grandes conjuntos de datos y cargas de trabajo de producción.También le recomendamos que implemente nodos de búsqueda dedicados. Si aumentan sus requisitos de búsqueda, puede escalar su implementación de búsqueda independientemente del escalado de los nodos de MongoDB.
- Proveedor de nube y región
Utilice nodos de búsqueda en todas las regiones de Google Cloud Platform y en un subconjunto de Amazon Web Services y Azure regiones. Debe seleccionar un proveedor de nube y una región donde los Search Nodos estén disponibles para su implementación.
Todos los niveles de clúster están disponibles en las regiones de proveedores de nube compatibles. El proveedor de nube y la región que se elija afectan las opciones de configuración y los niveles de búsqueda disponibles para el clúster y el costo de su funcionamiento del clúster.
Arquitectura de nodo
Para entornos de producción, recomendamos una arquitectura de nodos en la que los procesos de MongoDB y los procesos de MongoDB Search se ejecuten en nodos separados. Para implementar nodos de búsqueda separados, consulta Migrar a nodos de búsqueda dedicados.
En el siguiente diagrama de este modelo de despliegue, el proceso MongoDB Search mongot se ejecuta en nodos de búsqueda dedicados, que están separados de los nodos del clúster en los que se ejecuta el proceso mongod.
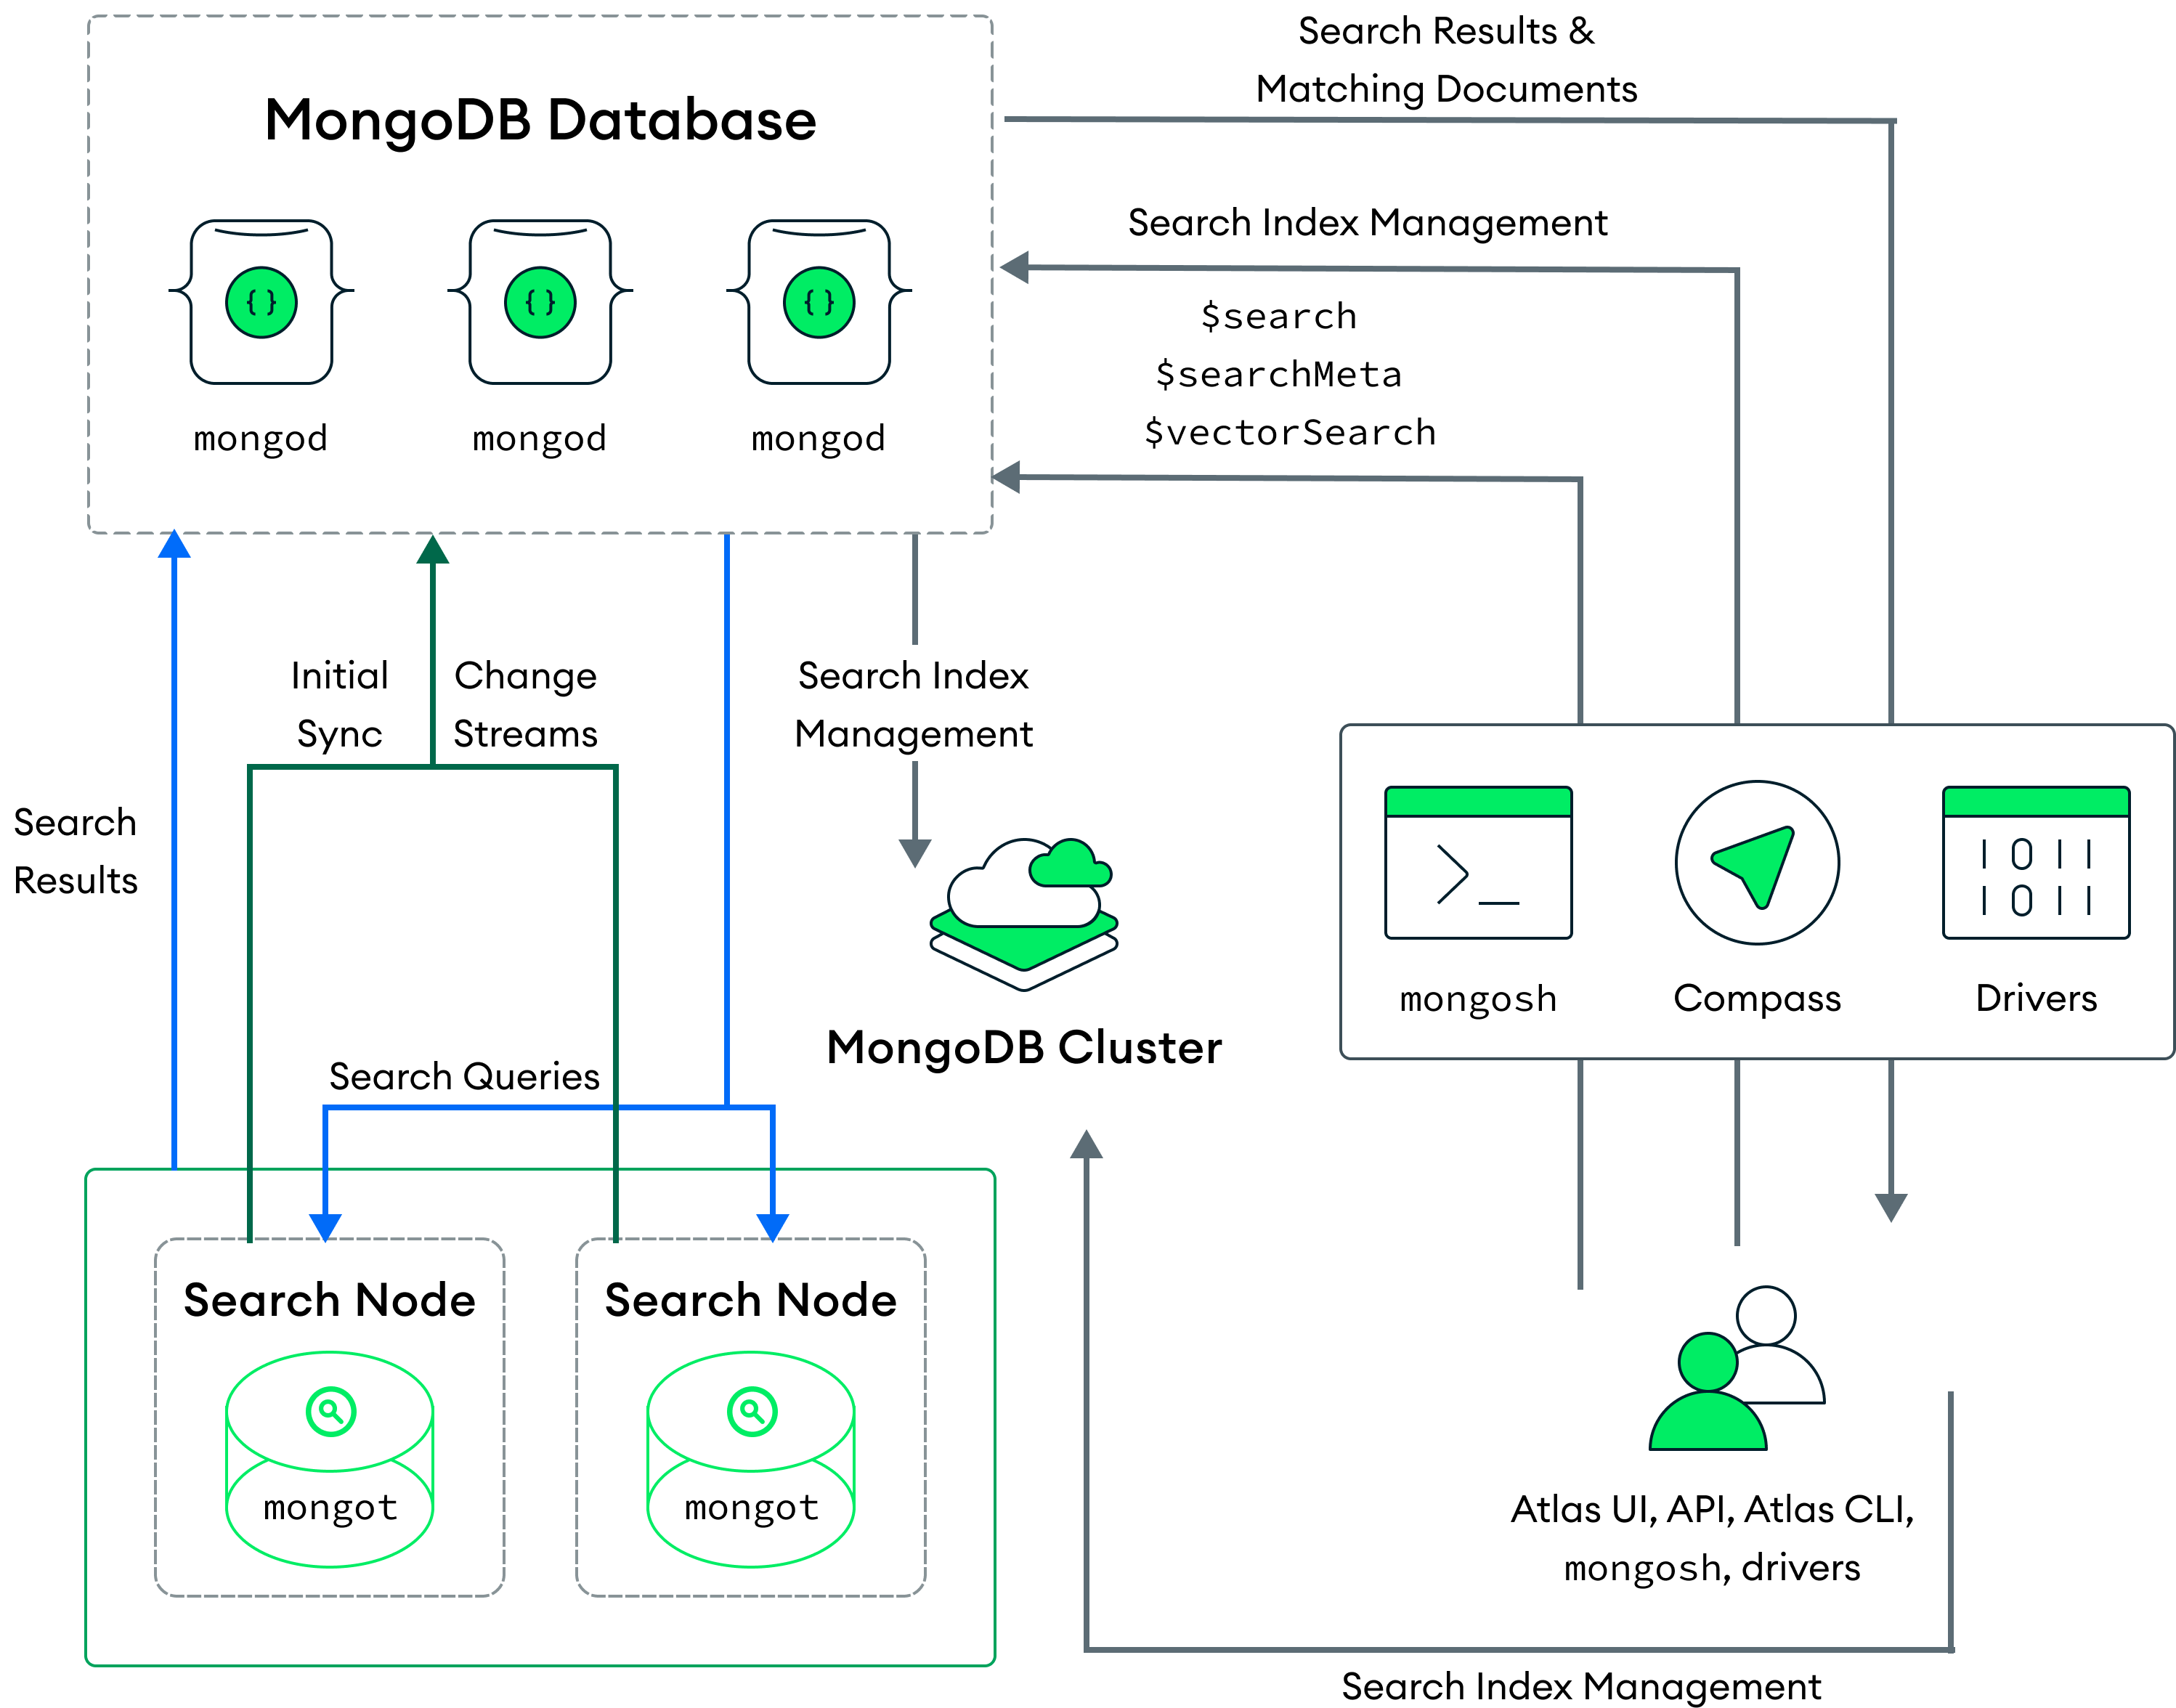
Atlas implementa nodos de búsqueda con cada clúster o con cada partición en el clúster. Por ejemplo, si implementas dos nodos de búsqueda para un clúster con tres particiones, Atlas implementa seis nodos de búsqueda (dos por partición). También puedes configurar el número de nodos de búsqueda y la cantidad de recursos aprovisionados para cada nodo de búsqueda.
Para aprender cómo MongoDB Search procesa las query en esta arquitectura, consulte Procesamiento de query.
Puede definir fuentes almacenadas campos en su índice de MongoDB Search para que el proceso mongot pueda almacenar los campos especificados en mongot. Luego puede utilizar la opción returnStoredSource en su consulta MongoDB Search para recuperar los campos almacenados para los documentos coincidentes directamente desde mongot en lugar de realizar una búsqueda completa de documentos en la base de datos.
Beneficios
El despliegue de nodos de búsqueda separados proporciona los siguientes beneficios:
- Alta disponibilidad
- Cuando implementas nodos de búsqueda separados, Atlas aplica un mínimo de dos nodos de búsqueda para garantizar que tu carga de trabajo siga operativa, con un tiempo de inactividad mínimo, en caso de una falla o interrupción.
- Escalabilidad
Cuando despliegue nodos de búsqueda por separado, puede escalar el almacenamiento y la computación independientemente de su clúster de MongoDB. Esto permite también escalar la carga de queries de forma independiente de MongoDB.
Para escalar los Search Nodos horizontalmente, aumente o reduzca el número de Search Nodos. Puede provisionar desde un mínimo de 2 hasta un máximo de 32 nodos de búsqueda por región y por partición. Para equilibrar la carga de query, MongoDB Search distribuye las consultas de búsqueda en todos los nodos de búsqueda disponibles.
Para escalar verticalmente los Nodos de Búsqueda, seleccione diferentes niveles de búsqueda, configuraciones de CPU, RAM y almacenamiento que admitan sus cargas de trabajo de texto completo.
- Rendimiento
Cuando implementas nodos de búsqueda dedicados, mejoras el rendimiento y la utilización de recursos tanto para los procesos
mongodcomomongot, y eliminas la competencia de recursos entre estos procesos.Los nodos de búsqueda dedicados admiten búsqueda de segmentos concurrentes, lo que permite a MongoDB Search buscar varios segmentos de índices al mismo tiempo. El uso de una búsqueda de segmentos concurrentes mejora el tiempo de respuesta de las consultas en algunos casos.
- Aislamiento de cargas de trabajo
- La implementación de nodos de búsqueda dedicados no afecta directamente la transferencia de datos a los nodos principales de la base de datos. Los Nodos de Búsqueda gestionan las consultas de búsqueda por separado de las operaciones principales de la base de datos, proporcionando aislamiento de la carga de trabajo mientras solo incurres en cargos de red para el tráfico entre los Nodos de Búsqueda y los nodos de la base de datos.
Consejos para dimensionar y escalar nodos de búsqueda
Para determinar los requisitos de memoria para Search nodos, utiliza las siguientes métricas de Atlas:
Tamaño del índice de búsqueda
Memoria RAM total en el nodo de búsqueda
Considere una aplicación que tenga un 10GB de Índice de Búsqueda y 4GB de RAM total en el Nodo de Búsqueda. En este caso, si 1GB de RAM son utilizados por otros procesos y solo 3GB están disponibles para los datos del índice, el resto de 7GB de los datos del índice (10GB- 3GB = 7GB) se carga según sea necesario desde el disco. La paginación frecuente desde disco causa un aumento de fallos de página, operaciones de E/S en disco y IOWait de CPU, lo que resulta en una degradación del rendimiento.
Si utiliza un nivel de clúster de búsqueda superior con más RAM, como 8GB o más, esto permite que Atlas sirva la mayor parte de los datos para el índice de búsqueda desde la memoria, minimizando las lecturas en disco y los errores de página, mejorando así el rendimiento.
Nota
Los SSDlocales utilizados para los nodos de búsqueda requieren gastos en general de almacenamiento del 20% para admitir operaciones de índice.
Costo de nodos de búsqueda
MongoDB admite nodos de búsqueda independientes en clústeres dedicados (M10 o superiores). Los nodos de búsqueda se implementan en instancias de uso intensivo de cómputo con almacenamiento local de alto rendimiento. Se deben implementar un mínimo de dos nodos. Se facturará diariamente por el uso de recursos por hora en cada nodo. Para obtener más información, consulta Costos de los nodos de búsqueda.
Activar el cifrado en reposo
Por defecto, MongoDB y los procesos de búsqueda se ejecutan en los mismos nodos. Con esta arquitectura, el cifrado gestionado por el cliente se aplica a los datos de su base de datos, pero no se aplica a los índices de búsqueda.
Cuando activas nodos de búsqueda dedicados, los procesos de búsqueda se ejecutan en nodos separados. Esto permite activar el cifrado de datos del nodo de búsqueda, para que puedas cifrar tanto los datos de la base de datos como los índices de búsqueda con las mismas claves gestionadas por el cliente para una cobertura de cifrado integral.
Los nodos de búsqueda dedicados no se admiten en clústeres Atlas Infinite en versión preliminar pública.
Nota
Los nodos de la base de datos y los nodos de búsqueda utilizan diferentes métodos de cifrado con las mismas claves gestionadas por el cliente. Los nodos de la base de datos usan el motor de almacenamiento cifrado WiredTiger, mientras que los nodos de búsqueda usan cifrado a nivel de disco.
Para obtener más información, consulta Permitir la gestión de claves de cliente para los nodos de búsqueda.
Agregar nodos de búsqueda dedicados
Agregar nodos de búsqueda dedicados a un nuevo clúster permite:
Cambia el tamaño y **escalar** tu implementación de búsqueda de forma independiente de tu **implementación de la base de datos**.
Elimina la competencia por recursos que puedas experimentar en un clúster que ejecuta tanto la base de datos MongoDB como los procesos de búsqueda en el mismo nodo.
Para implementar nodos de búsqueda dedicados, debe tener Project Owner acceso al Proyecto.
Para agregar nodos de búsqueda dedicados:
Cree su clúster como un nivel
M10o superior en un proveedor de nube y una región que admiten el aislamiento de nodos. Para obtener más información, consulte Crear un clúster Atlas Infinite o Atlas Core.Los nodos de búsqueda dedicados solo son compatibles con niveles de clúster
M10y superiores, y en las regiones del proveedor de nube que admiten el aislamiento de nodos.Habilitar Search Nodes for workload isolation y Configurar nodos de búsqueda.
Migre a nodos de búsqueda dedicados
Para migrar del entorno de staging a producción y agregar nodos de búsqueda dedicados, realiza los siguientes cambios en tu implementación actual de staging y prototipado:
Si su implementación utiliza un clúster Flex, cambie el nivel de clúster a un nivel superior. Los nodos de búsqueda dedicados solo son compatibles con niveles de clúster
M10y superiores.Implementa tu clúster en regiones donde los nodos de búsqueda también están disponibles. Los nodos de búsqueda dedicados están disponibles en un subconjunto de las regiones de AWS y Azure y en todas las regiones de Google Cloud compatibles. Si el clúster existente está alojado en regiones donde los nodos de búsqueda no están disponibles, migra el clúster a regiones donde los nodos de búsqueda están disponibles. Para obtener más información, consulta Regiones de proveedores de nube que admiten el aislamiento de nodos.
Habilite Search Nodes for workload isolation y configure los nodos de búsqueda. Para aprender más, consulta Agregar nodos de búsqueda.
Cuando se implementan nodos de búsqueda dedicados, ocurre la siguiente secuencia de acciones:
Atlas compila los índices de búsqueda en los Search Nodes y remueve los índices de los nodos del clúster.
Atlas enruta las consultas de búsqueda a los nodos de búsqueda.
MongoDB Search utiliza los índices de búsqueda para servir queries en el clúster.
Solucionar problemas de implementación
Failed to Execute search Command Error
Si implementas mongot para ejecutarlo junto con mongod y no configuras nodos de búsqueda, es posible que mongot finalice y devuelva el error Failed to Execute search Command durante cualquiera de los siguientes eventos:
Escalado de un clúster
Failover de nodo
Actualización
mongot
Si se implementa mongot en nodos de búsqueda dedicados, mongod utiliza un proxy que dirige las consultas de búsqueda solo a los nodos saludables donde el proceso mongot está activo.
MongoDB Community Edition
Si ejecuta MongoDB Search en MongoDB Community Edition o en otra implementación autogestionada, Atlas no gestiona mongot por usted. En su lugar, usted mismo instala, configura y opera mongot. Las siguientes secciones resumen los patrones de arquitectura disponibles y las opciones de dimensionamiento. Para obtener una orientación completa sobre la implementación y el dimensionamiento, consulte MongoDB Search y MongoDB búsqueda vectorial en implementaciones autogestionadas y Introducción al dimensionamiento de la implementación de mongot.
Patrones de arquitectura
Al igual que con MongoDB Search en Atlas, las implementaciones autogestionadas utilizan uno de los dos mismos patrones de arquitectura: colocalizado o dedicado. La única excepción es que en implementaciones autogestionadas, usted mismo aprovisiona y gestiona los host.
Dimensionamiento
A diferencia de Atlas, las implementaciones autogestionadas no tienen niveles predefinidos de clúster o de búsqueda. Usted aprovisiona su propio hardware o instancias en la nube. Para elegir una configuración inicial y refinarla en función de su carga de trabajo, consulta Introducción al dimensionamiento de la implementación de mongot.