Las siguientes secciones describen las opciones de implementación para MongoDB búsqueda vectorial en Atlas.
Puedes estructurar tu clúster con diferentes tipos de implementaciones, proveedores de nube y niveles de clúster para satisfacer las necesidades de un entorno de preproducción o producción. Utilice estas recomendaciones para seleccionar el tipo de implementación, el proveedor de nube y la región, así como los niveles de clúster y búsqueda para realizar una búsqueda vectorial.
Entorno | Tipo de implementación | Nivel de clúster | Región del Proveedor de la Nube | Arquitectura de nodo |
|---|---|---|---|---|
Consultas de prueba | Clúster flexible, clúster dedicado | Clúster gratuito o nivel superior | Todo | Los procesos de MongoDB y búsqueda se ejecutan en el mismo nodo. |
Prototipado de aplicaciones | clúster dedicado | Flex clúster, | Todo | Los procesos de MongoDB y búsqueda se ejecutan en el mismo nodo. |
Producción | Clúster dedicado con nodos de búsqueda independientes |
| AWS y Azure en algunas regiones o Google Cloud en todas las regiones | Los procesos de MongoDB y Search se ejecutan en diferentes nodos. |
Community Edition | Implementación autogestionado. Usted mismo instala y opera | N/A. Usted proporciona su propio hardware o instancias en la nube. | N/A. Usted elige su propia infraestructura. | Los procesos de MongoDB y búsqueda se ejecutan en un único o varios host autogestionados. |
Para obtener más información sobre estos modelos de implementación, revisa las siguientes secciones:
Uso de recursos
Requisitos de memoria para la indexación de vectores
MongoDB Vector Search almacena todo el índice en memoria, así que se debe garantizar que hay suficiente memoria para el índice y la JVM de MongoDB Vector Search si el conjunto de datos incluye vectores de precisión completa. Cada índice es una combinación de los vectores que se indexan y los metadatos adicionales. El tamaño del índice viene determinado principalmente por el tamaño de los vectores para indexación, y el espacio de metadatos suele ser relativamente nominal.
Cuando no se utiliza la cuantificación, MongoDB Vector Search almacena los vectores de fidelidad completa en memoria. Si se habilita la cuantificación automática, MongoDB Vector Search almacena los vectores cuantificados, que requieren significativamente menos recursos, en memoria y los vectores de fidelidad completa en disco. Se puede ver la diferencia entre los requisitos de disco y memoria para los índices vectoriales consultando las columnas Size y Required Memory en la página de búsqueda de MongoDB Search en la interfaz de usuario de Atlas.
Considera los siguientes requisitos para un único vector:
Modelo de incrustación | Dimensión vectorial | Requisitos de espacio |
|---|---|---|
Voyage AI | 2048 | 8kb (para |
OpenAI | 1536 | 6kb |
Google | 768 | 3kb |
Cohere | 1024 | 4kb (para |
Vectores cuantificados de BinData. Para obtener más información, consulte Ingestar vectores cuantificados.
El espacio necesario escala linealmente con el número de vectores que está indexación y con la dimensionalidad del vector. También puede utilizar la Search Index Size métrica para determinar la cantidad de espacio y memoria que necesita en sus nodos de búsqueda.
Requisitos de almacenamiento para vectores
Si utiliza BinData o vectores cuantificados, reducirá significativamente los requisitos de recursos en comparación con no utilizar binData o vectores cuantificados. Notará:
El almacenamiento en disco de los vectores en
mongodse reduce un 66% cuando se utilizanbinDatavectores.El uso de RAM de los vectores en
mongotse reduce en 3.75x (escalar) o 24x (binario) debido a la compresión de vectores al utilizar quantización automática de vectores o ingestión de vectores cuantizados.
Cuando utilizas la cuantización automática, Atlas almacena los vectores de precisión total para el re-puntuación o la búsqueda exacta en disco, con un uso mínimo de RAM y caché para re-puntuación.
Si habilita la cuantificación automática en la definición de índice de búsqueda vectorial de MongoDB, también debe tener en cuenta el espacio en disco al dimensionar el clúster. Esto se debe a que la búsqueda vectorial de MongoDB almacena vectores de precisión completa también en el disco para la búsqueda ENN y para la reevaluación si ha configurado la cuantificación automática. Por lo tanto, asegúrese de que haya una relación adecuada entre el disco y la RAM en el hardware que utilice. Considere configurar nodos de búsqueda que puedan admitir aproximadamente una relación de 4:1 de almacenamiento a RAM para la cuantificación escalar o una relación de 24:1 de almacenamiento a RAM para la cuantificación binaria.
Ejemplo
Este ejemplo demuestra cómo configurar la cuantificación binaria para 10 millones de incrustaciones de 1024dimensiones de Voyage AI almacenadas en el campo llamado my-embeddings:
{ "fields":[ { "type": "vector", "path": "my-embeddings", "numDimensions": 1024, "similarity": "euclidean", "quantization": "binary" } ] }
Utiliza la siguiente fórmula para calcular aproximadamente el espacio en disco para tu índice habilitado para cuantificación binaria con reponderación:
Original index size * (25/24)
Aquí, el 24 en el denominador representa el tamaño original del índice dividido en 24 partes para facilitar la representación de fracciones. El 25 en el numerador representa una asignación de espacio adicional, que es de aproximadamente 1/24 del tamaño del índice original, para los datos adicionales necesarios para almacenar vectores binarios. Tanto el índice original como el grafo de Hierarchical Navigable Small Worlds siguen almacenándose en disco. El factor de sobredimensionamiento es 1/24 en lugar de 1/32 porque el grafo HNSW no está comprimido.
Ejemplo
Supongamos que el tamaño original de tu índice es de 1 GB. Puede calcular el tamaño del índice cuantificado binario con reevaluación como se muestra a continuación:
1 GB * (25/24) = 1.042 GB
Importante
En la interfaz de usuario de Atlas, Atlas muestra el tamaño total del índice, que puede ser grande, ya que Atlas no muestra un desglose de las estructuras de datos dentro de un índice que se almacenan en la RAM y en el disco. Las métricas de MongoDB Search muestran un índice mucho más pequeño que se mantiene en memoria cuando habilitas la cuantización automática.
Para los vectores para los cuales configuraste la cuantización automática, se recomienda reservar un espacio libre en disco igual al 125% del tamaño estimado del índice.
Entornos de pruebas y prototipos
Para probar tus consultas de búsqueda vectorial y crear prototipos de tu aplicación, te recomendamos la siguiente configuración.
Tipo de implementación
Para probar las queries de MongoDB Vector Search, puedes implementar un clúster Flex, un clúster dedicado o usar una implementación local de Atlas.
Cluster Tiers
Los clústeres gratuitos son un tipo de clúster sin costo. Los clústeres Flex son tipos de clústeres de bajo costo adecuados para equipos que están aprendiendo MongoDB o desarrollando pequeñas aplicaciones de prueba de concepto. Se puede comenzar el proyecto con un clúster Atlas Flex y actualizar a un nivel de clúster dedicado que esté listo para producción en el futuro.
Estos tipos de clúster de bajo costo están disponibles para evaluar tus MongoDB Vector Search queries. Sin embargo, en clústeres Flex puedes experimentar contención de recursos y latencia de queries. Si inicias tu proyecto con un clúster Flex, se recomienda actualizar a un nivel superior cuando tu aplicación esté lista para producción.
Los clústeres dedicados incluyen M10 y niveles superiores. Los niveles M10 y M20 son adecuados para crear prototipos de su aplicación. Puede escalar a niveles superiores para gestionar grandes conjuntos de datos o implementar nodos de búsqueda dedicados para el aislamiento de la carga de trabajo cuando su aplicación esté lista para la producción.
Proveedor de nube y región
El proveedor de nube y la región que elijas afectan las opciones de configuración disponibles para los niveles de clúster y el costo de ejecutar el clúster.
Todos los niveles de clúster están disponibles en todas las regiones de proveedores de nube compatibles
Si prefieres probar las consultas de búsqueda vectorial de MongoDB localmente, puedes usar la Atlas CLI para implementar un set de réplicas de un solo nodo alojado en tu computadora local. Para comenzar, completa el Tutorial de inicio rápido de búsqueda vectorial de MongoDB y selecciona la pestaña para implementaciones locales.
Cuando su aplicación esté lista para la producción, migre la implementación local de Atlas a un entorno de producción mediante el uso de Migración en vivo. Las implementaciones locales están limitadas por los recursos de CPU, memoria y almacenamiento de tu máquina local.
Arquitectura de nodo
Para entornos de prueba y creación de prototipos, recomendamos una arquitectura de nodo en la que los procesos de MongoDB y los procesos de MongoDB Search se ejecuten en el mismo nodo. En el siguiente diagrama de este modelo de implementación, el proceso de MongoDB Search mongot se ejecuta junto con mongod en cada nodo del clúster de Atlas y comparten los mismos recursos.
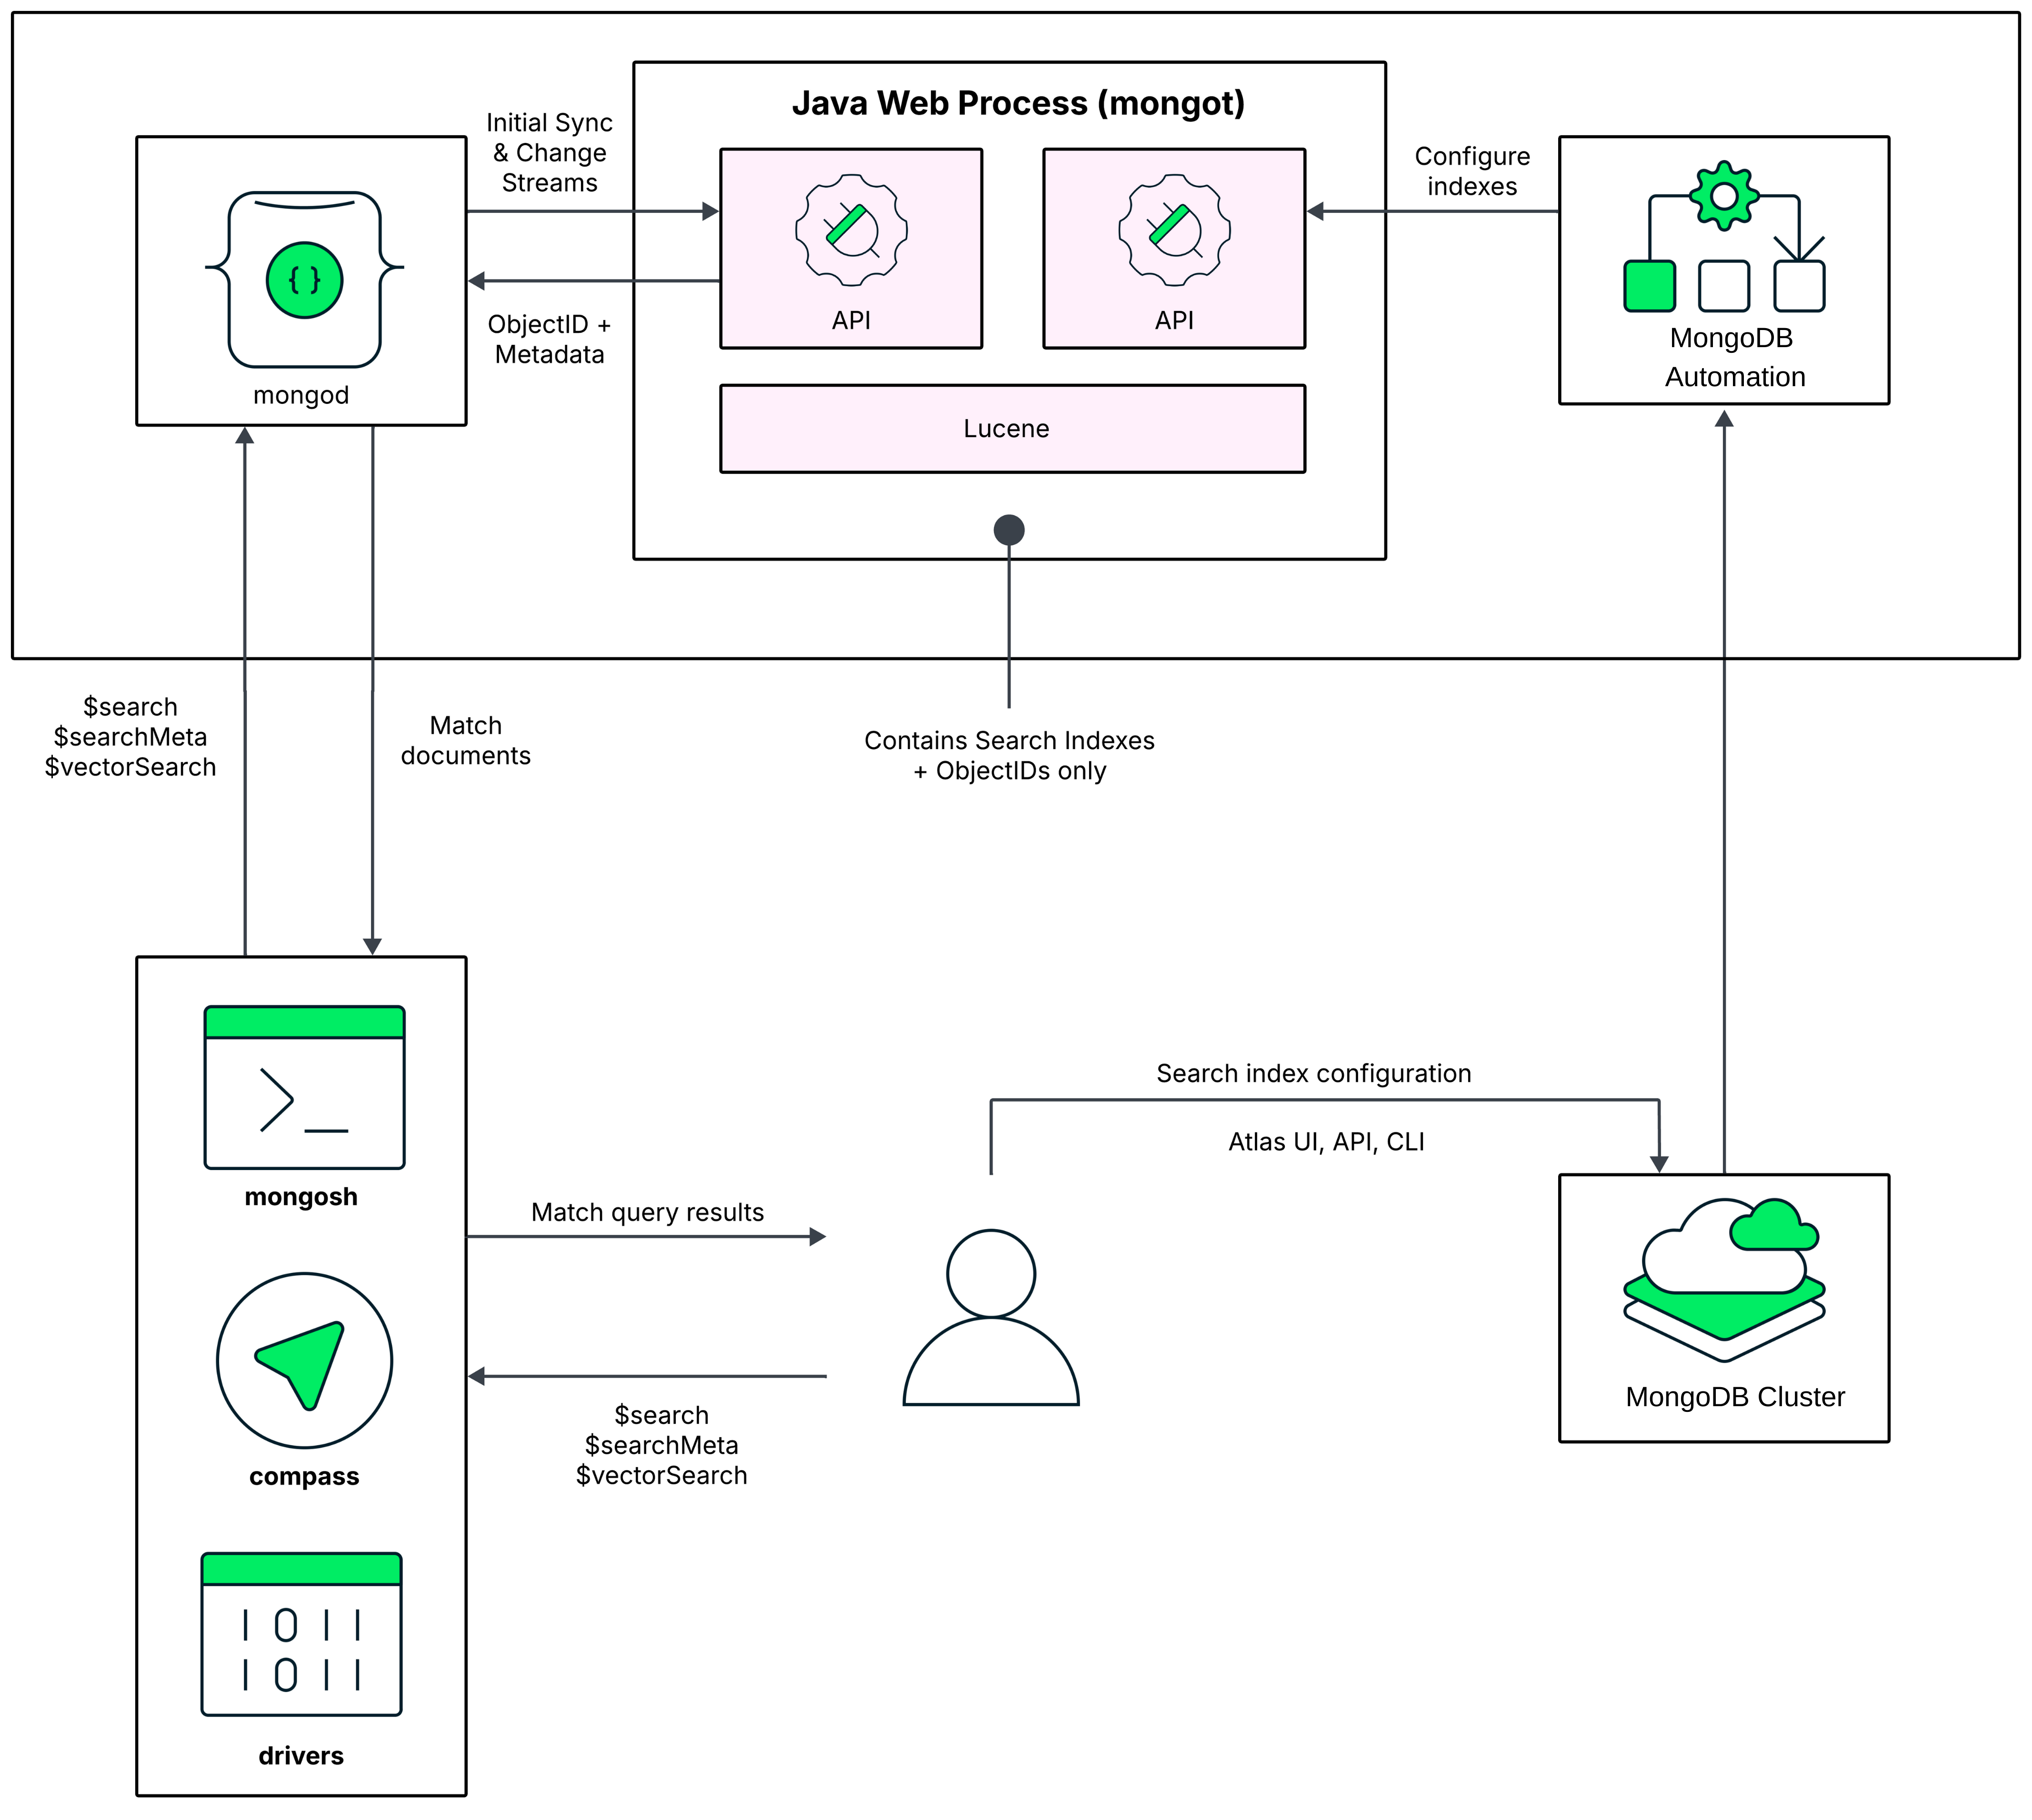
Por defecto, Atlas habilita el proceso mongot de MongoDB Search en el mismo nodo que ejecuta el proceso mongod cuando creas tu primer índice de MongoDB Vector Search.
Cuando se ejecuta una query, MongoDB Search utiliza la preferencia de lectura configurada para identificar el nodo en el cual ejecutar el query. El query primero va al proceso de MongoDB, que es mongod para un set de réplicas o mongos para un clúster particionado.
Para un clúster de set de réplicas, el proceso mongod dirige el query al mongot en el mismo nodo. En el caso de los clústeres particionados, los datos del clúster se dividen entre las instancias mongod (particiones) y cada proceso mongot solo puede acceder a los datos de la instancia mongod en el mismo nodo. Por lo tanto, no se pueden ejecutar query de MongoDB Search que se dirijan a una partición en particular. mongos dirige la query a todas las particiones, lo que hace que estas consultas sean de dispersión y recopilación. Si se utilizan zonas para distribuir una colección particionada sobre un subconjunto de las particiones del clúster, MongoDB Search enruta el query a la zona que contiene las particiones de la colección que se está consultando y ejecuta los queries $search solo en las particiones donde se encuentra la colección.
Después de que la query se enrute a un proceso mongot de MongoDB Search, el proceso mongot realiza la búsqueda y la puntuación, y devuelve los ID de documentos y otros metadatos de búsqueda para los resultados de coincidencia a su proceso mongod correspondiente. El proceso mongod luego realiza una búsqueda completa de documentos de forma implícita para obtener los resultados coincidentes y devuelve los resultados al cliente. Si se utiliza la $search concurrente opción en el query, MongoDB Search permite el paralelismo intra-query. Para aprender más, consulte Paralelización de la ejecución de query entre segmentos.
Para obtener más información sobre el proceso mongot, consulte Procesamiento de query.
Dimensiona tu clúster para prototipar tu aplicación
Cuando Atlas ejecuta tus cargas de trabajo de base de datos y búsqueda en el mismo nodo, el almacenamiento de MongoDB ocupa un cierto porcentaje de la memoria disponible del nodo (RAM), dejando el resto para el índice de MongoDB Vector Search y el proceso mongot.
Nivel | Memoria total (GB) | Memoria disponible para el índice de MongoDB Vector Search (GB) |
|---|---|---|
| 2 | 1 |
| 4 | 2 |
| 8 | 4 |
Para los niveles de clúster M10, M20 y M30, se reserva el 25% para MongoDB y el 75% restante es para otras operaciones, incluido tu índice MongoDB Vector Search. Para los niveles de clúster M40+, se reserva el 50% para MongoDB y el resto para otras operaciones, incluido tu índice de MongoDB Vector Search.
Limitaciones
Es posible que experimente disputas de recursos entre la base de datos mongod y los procesos de búsqueda mongot. Esto podría afectar negativamente el rendimiento de tu índice y la latencia de tus consultas. Recomendamos este modelo de implementación solo para entornos de prueba y creación de prototipos. Para aplicaciones listas para producción y cargas de trabajo de búsqueda asociadas, recomendamos migrar a nodos de búsqueda dedicados.
Ambiente de producción
Para tu aplicación lista para producción, recomendamos la siguiente configuración de clúster.
Tipo de implementación
Para aplicaciones listas para producción, necesita un clúster dedicado con la separación de nodos de búsqueda para el aislamiento de la carga de trabajo.
Cluster Tiers
Los clústeres dedicados incluyen M10 y niveles superiores. Los niveles M10 y M20 son adecuados para entornos de desarrollo y de producción. Sin embargo, los niveles superiores pueden gestionar grandes conjuntos de datos y cargas de trabajo de producción. También le recomendamos que implemente nodos de búsqueda dedicados para su carga de trabajo de búsqueda. Esto le permite escalar su implementación de búsqueda de forma independiente y adecuada.
Proveedor de nube y región
Los nodos de búsqueda están disponibles en todas las regiones para Google Cloud, pero solo están disponibles en un subconjunto de AWS y Azure regiones. Debe seleccionar un proveedor de nube y una región donde los Search Nodos estén disponibles para su implementación.
Todos los niveles de clúster están disponibles en las regiones admitidas del proveedor de nube. El proveedor de nube y la región que elijas afectan las opciones de configuración y los niveles de búsqueda disponibles para el clúster, así como el costo de ejecutarlo.
Arquitectura de nodo
Para entornos de producción, recomendamos una arquitectura de nodos en la que los procesos de MongoDB y los procesos de MongoDB Search se ejecuten en nodos separados. Para implementar nodos de búsqueda separados, consulta Migrar a nodos de búsqueda dedicados.
En el siguiente diagrama de este modelo de despliegue, el proceso MongoDB Search mongot se ejecuta en nodos de búsqueda dedicados, que están separados de los nodos del clúster en los que se ejecuta el proceso mongod.
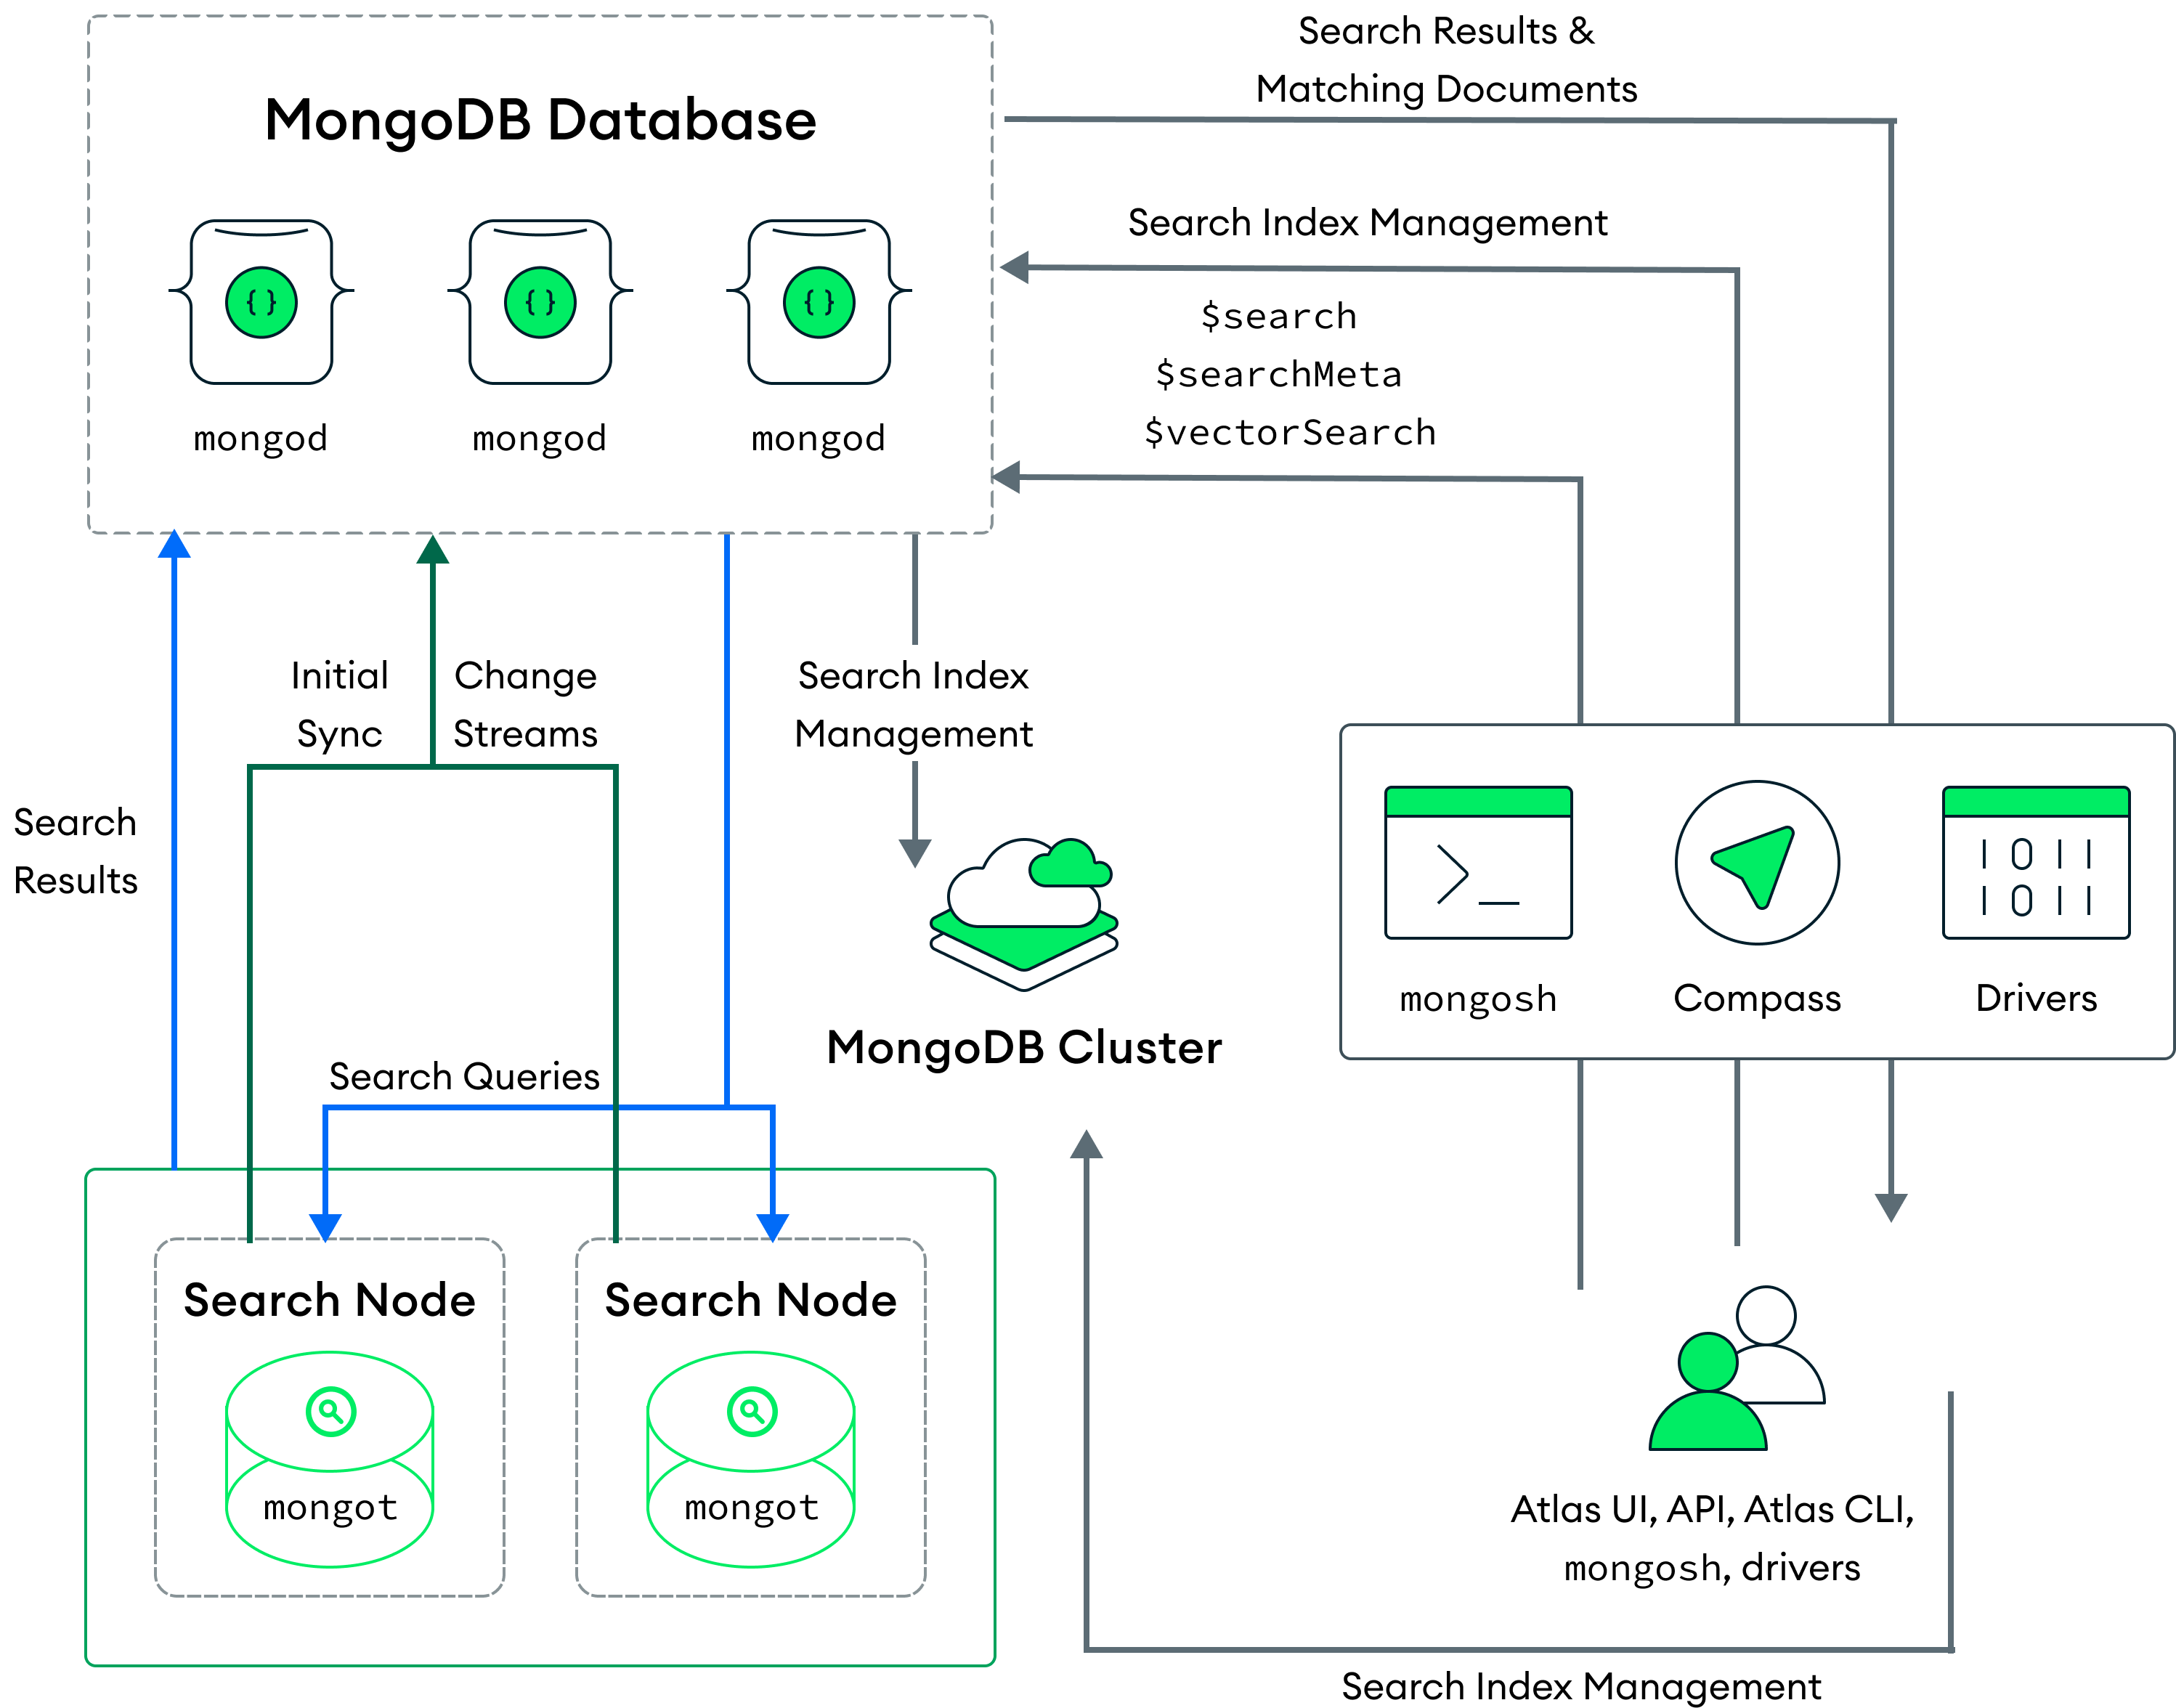
Atlas implementa nodos de búsqueda con cada clúster o con cada partición en el clúster. Por ejemplo, si implementas dos nodos de búsqueda para un clúster con tres particiones, Atlas implementa seis nodos de búsqueda (dos por partición). También puedes configurar el número de nodos de búsqueda y la cantidad de recursos aprovisionados para cada nodo de búsqueda.
Cuando se implementan nodos de búsqueda independientes, Atlas asigna automáticamente un mongod para cada mongot para la indexación. El mongot se comunica con mongod para escuchar y sincronizar los cambios de índice de los índices que almacena. MongoDB Vector Search índices de búsqueda y procesa sus queries de manera similar a una implementación en la que los procesos mongod y mongot se ejecutan en el mismo nodo. Para aprender más, consulte Cómo índice campos para la búsqueda vectorial y Ejecutar queries de búsqueda vectorial ANN y ENN. Para aprender más sobre implementar nodos de búsqueda por separado, consulte Nodos de búsqueda para el aislamiento de cargas de trabajo.
Cuando se migra a Search Nodes, Atlas implementa los Search Nodes, pero no sirve queries en los nodos hasta que se compila exitosamente todos los índices en el clúster en los Search Nodes. Mientras Atlas construye los índices en los nuevos nodos, continúa sirviendo queries usando los índices en los nodos del clúster. Atlas comienza a atender queries desde los nodos de búsqueda sólo después de compilar correctamente los índices en los nodos de búsqueda y remover los índices en los nodos del clúster.
Nota
El escalado del clúster al agregar nodos de búsqueda o al cambiar el nivel de búsqueda activa una recompilación del índice completo de MongoDB Search. Sin embargo, si el clúster en AWS o Azure tiene nodos de búsqueda dedicados para los que no se ha habilitado cifrado en reposo mediante la gestión de claves de cliente, Atlas proporciona las siguientes optimizaciones:
Cuando escalas los nodos de búsqueda, Atlas usa una copia reciente del índice en S3 o Azure Blob Storage en lugar de reconstruir todo el índice de MongoDB Search en el nuevo nodo.
Para los nodos existentes, Atlas toma y carga periódicamente una nueva lista incremental de archivos de índice. Atlas conserva los archivos de índice durante un máximo de catorce (14) días.
Esto aún no está disponible para clústeres con nodos de búsqueda dedicados en Google Cloud.
Cuando se ejecuta un query, el query se dirige a mongod según la preferencia de lectura configurada. El proceso mongod enruta la consulta de búsqueda a través de un balanceador de carga en el mismo nodo, que distribuye las solicitudes por todos los procesos mongot.
El proceso de MongoDB Search mongot realiza la búsqueda y la puntuación, y devuelve los ID de los documentos y los metadatos de los resultados de las coincidencias a mongod. A continuación, mongod realiza una búsqueda en el documento completo para obtener resultados coincidentes y devuelve los resultados al cliente. Si se utiliza la opción $search concurrente en el query, MongoDB Search permite el paralelismo intra-query. Para aprender más, consulte Paralelización de la ejecución de query entre segmentos.
Si borra todos los nodos de búsqueda de su clúster, se producirá una interrupción en el procesamiento de los resultados de la consulta de búsqueda. Para aprender más, consulte Modificar un clúster. Si borra su clúster de Atlas, Atlas pausa y luego borra todas las implementaciones asociadas de MongoDB búsqueda vectorial (mongot procesos).
Beneficios
Este modelo de implementación aporta las siguientes ventajas:
Utiliza eficazmente tus recursos asegurando al mismo tiempo la alta disponibilidad de tus recursos para cargas de trabajo de búsqueda.
Ajuste el tamaño y **escalar** su **implementación** de búsqueda de forma independiente de su **implementación de la base de datos**.
Procese automáticamente las consultas de MongoDB Vector Search de manera concurrente, mejorando el tiempo de respuesta, especialmente en grandes conjuntos de datos. Para obtener más información, consulte Ejecución de query en paralelo entre segmentos.
Ajusta el tamaño de tus nodos de búsqueda para producción
MongoDB Vector Search mantiene todo el índice en memoria, por lo que se debe garantizar que hay suficiente memoria para el índice MongoDB Vector Search y la JVM. Los nodos de búsqueda permiten el aislamiento de la carga de trabajo sin aislamiento de datos, y casi el 90% de la asignación de RAM se puede utilizar para almacenar los datos vectoriales y los índices en la memoria, mientras que el sobrante se utiliza para la JVM.
Cada índice es una combinación de los vectores a los que se les asigna un índice y metadatos adicionales. El tamaño del índice se determina principalmente por el tamaño de los vectores para los que estás realizando la indexación, siendo el espacio de metadatos típicamente relativamente nominal. Para obtener más información, consulte Requisitos de memoria para la indexación de vectores.
Cuando implementa nodos de búsqueda dedicados, puede elegir entre diferentes niveles de búsqueda. Cada nivel de búsqueda tiene una capacidad de RAM por defecto, una capacidad de almacenamiento y CPU. Esto le permite dimensionar y escalar su clúster independientemente de su implementación de la base de datos. Para escalar su implementación de búsqueda por separado, puede realizar los siguientes cambios en la configuración de su clúster en cualquier momento:
Ajusta el número de nodos de búsqueda en tu clúster.
Ajusta la CPU, la RAM y el almacenamiento del nodo cambiando los niveles de búsqueda.
Nota
Para aprender más sobre el costo de los nodos de búsqueda y los niveles de búsqueda, expanda View all plan features y haga clic en MongoDB Vector Search en la página de Precios de MongoDB.
Recomendamos que tu nodo tenga una memoria RAM al menos 10% mayor que el tamaño total de tus índices de MongoDB Vector Search. También recomendamos que se asegure de tener suficientes CPUs disponibles. La latencia de la query depende del número de CPU disponibles, lo que puede afectar significativamente el nivel de concurrencia interna que acelera el rendimiento de la query.
Ejemplo
Supongamos que tienes 1M de vectores de 768 dimensiones de aproximadamente 3GB de tamaño. Tanto los niveles de búsqueda S30 (baja CPU) como S20 (alta CPU) tienen suficiente RAM para soportar el índice. En lugar de implementarse en el nivel de búsqueda S30 (Bajo procesador), recomendamos implementarse en el nivel de búsqueda S20 (Alto procesador) porque el nivel de búsqueda S20 (Alto procesador) tiene más procesadores disponibles para ejecutar consultas simultáneamente.
Activar el cifrado en reposo
Por defecto, MongoDB y los procesos de búsqueda se ejecutan en los mismos nodos. Con esta arquitectura, el cifrado gestionado por el cliente se aplica a los datos de su base de datos, pero no se aplica a los índices de búsqueda.
Cuando activas nodos de búsqueda dedicados, los procesos de búsqueda se ejecutan en nodos separados. Esto permite activar el cifrado de datos del nodo de búsqueda, para que puedas cifrar tanto los datos de la base de datos como los índices de búsqueda con las mismas claves gestionadas por el cliente para una cobertura de cifrado integral.
Nota
Los nodos de la base de datos y los nodos de búsqueda utilizan diferentes métodos de cifrado con las mismas claves gestionadas por el cliente. Los nodos de la base de datos usan el motor de almacenamiento cifrado WiredTiger, mientras que los nodos de búsqueda usan cifrado a nivel de disco.
Para obtener más información, consulta Permitir la gestión de claves de cliente para los nodos de búsqueda.
Migre a nodos de búsqueda dedicados
Los nodos de búsqueda dedicados permiten dimensionar y escalar su implementación de búsqueda por separado de su clúster. También elimina cualquier conflicto de recursos que pueda experimentar en un clúster que ejecute tanto la base de datos como los procesos de búsqueda en el mismo nodo.
Para migrar a Nodos de Búsqueda dedicados, realiza los siguientes cambios en tu implementación:
Si su implementación está utilizando actualmente un clúster gratuito o un clúster Flex, actualice su clúster a un nivel superior. Los nodos de búsqueda dedicados solo son compatibles con niveles de clúster
M10y superiores. Para obtener más información sobre cómo migrar a un nivel de clúster diferente, consulte Modificar el nivel de clúster.Los nodos de búsqueda dedicados están disponibles en un subconjunto de las regiones de AWS y Azure y en todas las regiones de Google Cloud compatibles. Asegúrate de implementar tu clúster en regiones donde los nodos de búsqueda también están disponibles. Si su clúster existente está en regiones donde los nodos de búsqueda no están disponibles, migre su clúster a regiones donde los nodos de búsqueda están disponibles. Para obtener más información, consulte Regiones de proveedor de nube.
Habilite Search Nodes for workload isolation y configure los nodos de búsqueda. Para aprender más, consulta Agregar nodos de búsqueda.
MongoDB Community Edition
Si ejecuta la búsqueda vectorial de MongoDB en MongoDB Community Edition o en otra implementación autogestionada, Atlas no gestiona mongot por usted. En su lugar, usted mismo instala, configura y opera mongot. Las siguientes secciones resumen los patrones de arquitectura disponibles y las opciones de dimensionamiento. Para obtener una orientación completa sobre la implementación y el dimensionamiento, consulte MongoDB Search y MongoDB búsqueda vectorial en implementaciones autogestionadas y Introducción al dimensionamiento de la implementación de mongot.
Patrones de arquitectura
Al igual que con la búsqueda vectorial de MongoDB en Atlas, las implementaciones autogestionadas utilizan uno de los mismos dos patrones de arquitectura: ubicación conjunta o dedicado. La única excepción es que en implementaciones autogestionadas, usted mismo aprovisiona y gestiona los host.
Dimensionamiento
A diferencia de Atlas, las implementaciones autogestionadas no tienen niveles predefinidos de clúster o de búsqueda. Usted aprovisiona su propio hardware o instancias en la nube. Para elegir una configuración inicial y refinarla en función de su carga de trabajo, consulta Introducción al dimensionamiento de la implementación de mongot.