A MongoDB Vector Search query takes the form of an aggregation pipeline that uses $vectorSearch as the first stage. This page explains the syntax, options, and behavior of the $vectorSearch stage.
Clientes compatibles
Sintaxis
Campos
La etapa $vectorSearch procesa un documento con los siguientes campos:
Tipos de búsqueda vectorial
Cuando define una etapa $vectorSearch, puede usar el campo exact para especificar si desea ejecutar una búsqueda ANN o ENN.
Para la búsqueda de Approximate Nearest Neighbors (ANN), MongoDB Vector Search encuentra las incrustaciones vectoriales en sus datos que están más cercanas a la incrustación vectorial de su query, basándose en su proximidad en el espacio multidimensional y en el número de vecinos que considera. Se debe usar el algoritmo Hierarchical Navigable Small Worlds y encontrar las incrustaciones vectoriales más similares a la incrustación vectorial en la query sin escanear todos los vectores. Por lo tanto, la búsqueda ANN es ideal para consultar grandes conjuntos de datos sin un filtro significativo.
Nota
El recall óptimo para la búsqueda ANN se considera habitualmente que es un solapamiento de resultados de entre el 90y el95% con la búsqueda ENN, pero con una latencia significativamente menor. Esto ofrece un buen equilibrio entre precisión y rendimiento. Para lograr esto con MongoDB Búsqueda vectorial, ajuste el parámetro numCandidates en el momento de la query.
numCandidates Selección
Debe especificar el campo numCandidates para ejecutar la búsqueda ANN. Este campo determina cuántos vecinos más cercanos considera MongoDB Vector Search durante la búsqueda.
When you perform a vector search using the Hierarchical Navigable Small Worlds index structure, MongoDB Vector Search accumulates results by populating a priority queue. The numCandidates parameter controls the size of this queue, which determines how long to search before returning the top limit results. A larger queue (higher numCandidates) allows the search to explore more of the Hierarchical Navigable Small Worlds graph, potentially finding better matches at the cost of increased query latency.
Le recomendamos que especifique un número de numCandidates al menos 20 veces mayor que el número de documentos a devolver (limit) para aumentar la precisión y reducir las discrepancias entre los resultados de la query de ENN y ANN. Por ejemplo, si configura limit para devolver 5 resultados, considere establecer numCandidates en 100 como punto de partida. Para obtener más información, consulte Cómo medir la precisión de los resultados de la query.
Este patrón de sobrepeticiones es la forma recomendada de equilibrar la latencia y la recuperación en las búsquedas de ANN. Sin embargo, recomendamos ajustar el parámetro numCandidates en función del tamaño específico del conjunto de datos y los requisitos de las queries. Para garantizar la obtención de resultados precisos, se deben considerar las siguientes variables:
Para una búsqueda de vecinos más cercanos exactos (ENN), MongoDB Vector Search busca exhaustivamente en todos los embeddings de vectores indexados calculando la distancia entre todos los embeddings y encuentra el vecino más cercano exacto para el embedding de vector en tu query. Esto requiere un uso intensivo de cálculos y podría impactar negativamente la latencia de la query. Por lo tanto, recomendamos ENN búsquedas para los siguientes casos de uso:
Considerations
$vectorSearch debe ser la primera etapa de cualquier pipeline en el que aparezca.
Limitaciones
$vectorSearch can't be used in view definition and the following pipeline stages:
$facetetapa de pipeline
| [1] | You can pass the results of $vectorSearch to this stage. |
MongoDB Vector Search indexación
Para obtener más información sobre estos tipos de campos de búsqueda vectorial de MongoDB, consulte Cómo indexar campos para la búsqueda vectorial.
Puntuación de MongoDB Vector Search
La búsqueda vectorial de MongoDB asigna una puntuación, en un rango fijo de 0 a 1 (donde 0 indica baja similitud y 1 indica alta similitud), a cada documento que devuelve.
Nota
Pre-filtering your data doesn't affect the score that MongoDB Vector Search returns using vectorSearchScore for $vectorSearch queries.
Filtro de búsqueda vectorial de MongoDB
MongoDB Búsqueda vectorial admite el filtro de datos. Puede:
Pre-filter your data by using the
filteroption in your MongoDB Vector Search query.post-filter the results of your MongoDB Vector Search query by using
$matchand other supported aggregation pipeline stages.
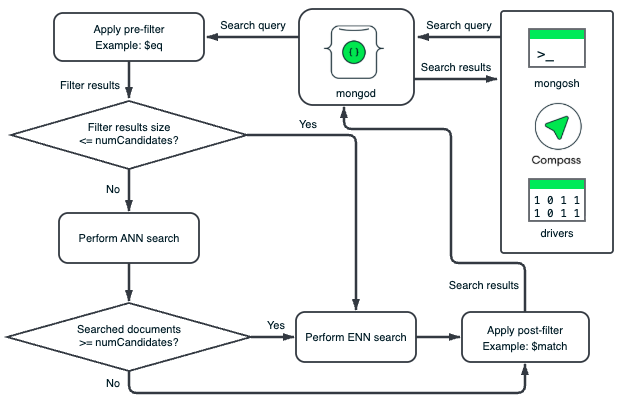
MongoDB búsqueda vectorial realiza operaciones de prefiltro y publicaciónfiltro de forma independiente en segmentos de datos. El grafo HNSW de cada segmento se basa únicamente en los vectores de ese segmento. MongoDB búsqueda vectorial aplica los filtros a los documentos de cada segmento para eliminar los documentos que no cumplen los criterios de filtro. El prefiltrado garantiza que los documentos se eliminen antes de que MongoDB Vector Search recorra el grafo HNSW y el posfiltrado garantiza que los documentos o campos irrelevantes de los documentos se eliminen de los resultados de la búsqueda vectorial.
Datos de búsqueda previos al filtro
Puede pre-filtrar sus datos para reducir el alcance de su búsqueda semántica y garantizar que solo se tengan en cuenta los vectores relevantes para la comparación. Cuando filtra previamente sus datos utilizando la opción filter, MongoDB búsqueda vectorial realiza la búsqueda semántica solo en un subconjunto de sus datos, lo que aumenta la precisión de los resultados de la búsqueda.
El prefiltro puede ser demasiado restrictivo, ya que puede excluir datos que no coinciden exactamente con el prefiltro, pero que son semánticamente similares a la query que desea considerar durante la búsqueda vectorial. Para mitigar esto, recomendamos establecer un criterio de filtro amplio para garantizar que su query haga lo siguiente:
Incluye tantos resultados relevantes como sea posible.
Excluye los datos irrelevantes de los resultados.
Devuelve el número solicitado de documentos en los resultados.
Importante
Las **query**s filtradas suelen ser más lentas que una **query** no filtrada equivalente.
Resultados de la búsqueda publicación-filtro
If your index size isn't optimal for pre-filtering or if you set broad pre-filtering criteria, you can post-filter your vector search results to return only relevant data. To filter the results of your vector search, you can use any supported aggregation pipeline stage, such as the $match stage, after the $vectorSearch stage. To learn more, see Additional Performance Recommendations.
To select the fields to return in the results, use the $project stage unless you need all the fields in the results. We recommend excluding the vector field in the $project stage to improve query performance.
For example, you can use the $project stage to include the vectorSearchScore and then use the $match stage to return only documents above a certain score threshold.
Consideraciones del filtro
MongoDB Vector Search supports the short form of
$eq. In the short form, you don't need to specify$eqin the query.Por ejemplo, considere el siguiente filtro con
$eq:"filter": { "_id": { "$eq": ObjectId("5a9427648b0beebeb69537a5") } Esto es equivalente al siguiente filtro, que utiliza la forma corta de
$eq:"filter": { "_id": ObjectId("5a9427648b0beebeb69537a5") } Puede utilizar el operador
$andMQL para especificar un arreglo de filtros en una sola query.Por ejemplo, considere el siguiente prefiltro para documentos con un campo
genresigual aActiony un campoyearcon el valor1999,2000o2001:"filter": { "$and": [ { "genres": "Action" }, { "year": { "$in": [ 1999, 2000, 2001 ] } } ] } For advanced filtering capabilities such as fuzzy search, phrase matching, location filtering, and other analyzed text, use the vectorSearch operator in a
$searchstage.
Ejemplos
Requisitos previos
Antes de ejecutar estos ejemplos, realiza las siguientes acciones:
Add the sample dataset used in the query to your cluster.
Cree índices de búsqueda vectorial de MongoDB para la colección. Para obtener instrucciones, consulte el procedimiento Crear un índice de MongoDB búsqueda vectorial y configure el índice para las query de muestra en el lenguaje que desee.
Queries
Obtén más información
Los siguientes tutoriales demuestran casos de uso adicionales para la etapa $vectorSearch.