通过 MongoDB Atlas 上的网格支持代理监控网格拓扑、利用天气数据预测需求、分析客户并查询所有内容。
行业: 制造与移动、能源管理
产品和工具: MongoDB Atlas、MongoDB 向量搜索、MongoDB 时间序列集合、Voyage AI by MongoDB
解决方案概述
公用事业单位大规模收集高频智能电表数据,但团队通常仍在独立系统中管理监控、预测、客户分析和 AI 工作流程。
这种分裂会导致数据管道重复、决策变慢和运营成本增加。
智能电网智能平台展示了如何在 MongoDB Atlas 上运行这些工作负载,方法是为实时监控、网络操作、需求预测、客户智能和电网支持代理使用一个操作数据层。
使用此解决方案可以:
实时监控电网:直接在数据库中检测服务中断、追踪功率因数并标记异常(电压峰值、异常消耗)。
运行网络:可视化电网拓扑结构(公用事业→变电站→馈线→变压器),评估变电站健康状况,并根据实时容量利用率显示峰值负载警告和服务中断风险。
通过天气预测需求:预测每个区域的预期需求和峰值时间,并利用外部天气数据(加热和制冷度日)进行丰富,以规划容量并防止过载。
了解客户数:从同一个仪表数据中显示费率建议、消耗趋势、电器级分解和使用分段。
通过自然语言操作:通过网格支持代理查询网格、知识库和客户数据。
MongoDB Atlas 通过内置功能支持此设计,可用于时间序列数据、灵活数据建模、库内处理和 AI 支持的检索:
聚合框架:在数据库中运行分析,而不是在应用中运行分析,使用
$setWindowFields进行间隙和岛屿服务中断检测,使用$group和$stdDevSamp进行异常和需求统计,并根据每个资产的额定容量测量饲料和变电站利用率。高频读取(需求、预测)作为单集合扫描在已经携带其网格上下文的读数上运行。灵活的 document model:仪表、客户和电网网络层次结构作为相关文档存在,按需加入,无需在网络演进时迁移固定模式。
带自动 Voyage AI 嵌入的 Atlas Vector Search:对域知识库进行语义搜索,无需操作单独的嵌入服务。查看 Voyage AI
混合搜索:将向量和全文搜索结果与倒数排名融合 (RRF)结合,以获取更相关的检索结果。
MongoDB 上的代理 AI:一个 LangGraph 多代理助手,具有每个域的技能和在 Atlas 中持久存储的对话内存,因此上下文与操作数据一起存储,没有外部状态存储。

图 1。智能电网智能平台主要功能
参考架构
该平台在单个 MongoDB Atlas 集群上组合了以下层:
操作数据层,为监控、网络、预测和客户视图提供动力。
代理 AI 层,允许用户以自然语言查询所有内容。
两者都从相同的文档中读取,因此,您无需使用独立系统来复制或同步信息。
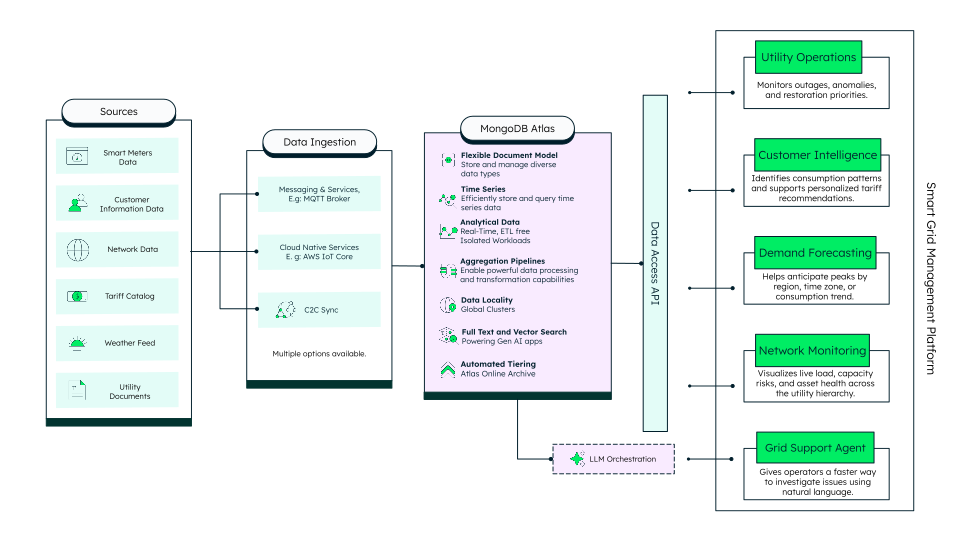
图 2。高级智能电网架构 - 操作数据层
操作数据层
智能电网读数落在时间序列集合中,Aggregation Framework 在数据库中计算分析,结果为监控、网络、预测和客户视图提供动力。
数据在架构中的流动方式如下:
摄取(时间序列):高频智能电表读数(电压、电流、功率、能量、功率因数和电器级分负载)存储在
readingsAtlas 时间序列集合中,并针对大规模快速时间查询进行了优化。网格拓扑结构模型:网格层次结构(公用事业单位 → 变电站 → 馈线 → 变压器,并带有容量)存储在
network集合中,meter_network_map将每个电表链接到其馈线。由于模型具有灵活性,拓扑结构可以在没有模式迁移的情况下进行演进。在数据库中处理(聚合框架):每个视图都由在数据所在位置运行的聚合管道提供支持:
监控:使用
$setWindowFields和$shift(间隙和岛)进行服务中断检测,使用$stdDevSamp(N-σ)进行每米异常检测,以及功率因数追踪。网络中心:汇总每个馈线的实时负载,并将其与资产的额定容量_kw 进行比较以计算利用率,然后在公用事业单位 → 变电站 → 馈线 → 变压器层级结构中推导变电站健康分数、峰值负载警告和服务中断风险。
预测:使用
$group+$avg和$stdDevSamp预测每区域/小时的预期需求及其预测区间,通过季节模型(每日小时和每周天数)向前预测,并富集外部天气(加热/制冷度数),外加峰值时间视图。客户数:对
tariff_catalog的关税建议,以及见解、设备故障、使用分段和消费趋势。
外部增强:预测工作负载调用 Open-Meteo 天气 API 查询按区域分类的每小时温度,然后管道将其转化为度日功能,以便需求预测反映真实的天气条件。
演示:Next.js(应用路由器)应用程序通过 API 路由暴露每个管道,并将结果渲染为实时仪表盘。每张卡都包含“显示文档”视图,可显示基础文档及其后面的准确聚合管道。
为什么这很重要:监控、网络操作、预测和客户智能都从相同的操作文档中读取。聚合框架取代了单独的分析引擎,灵活的文档模型可以将仪表、客户和不断发展的电网层次保持在一起,因此平台可以扩展而不会在系统之间复制或协调数据。
Agentic AI Layer
用户的自然语言问题通过 LangGraph 多代理协调器流动,该协调器对问题进行推理,调用正确的工具,从 MongoDB 检索数据,并返回基于事实的回答。在此过程中,其会话内存和搜索数据存储在同一个 Atlas 集群中。
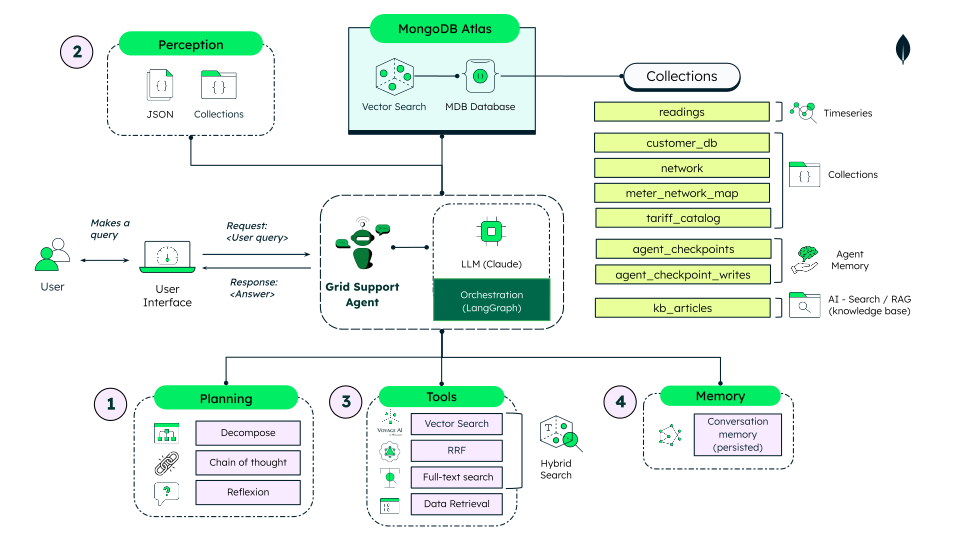
图 3。高级 LLM 编排 - Agentic AI 层
这是查询流经架构的方式:
用户查询(接口):用户以自然语言向网格支持代理提出问题。接口将请求(请求:
<user query>)发送给代理,之后渲染响应(响应:<answer>)。感知:代理将其世界感知为 MongoDB 文档、用户查询以及作为 JSON 存储在平台集合中的操作数据。这是代理进行推理的上下文。
规划:LangGraph 协调器解释请求,将其路由到正确的域工作流,调用所需的工具,并返回基于事实的回答。
工具:代理执行所选工具:
基于知识库的混合搜索 (RAG):向量搜索(语义)和全文搜索(关键字)与倒数排名融合 (RRF)相结合,以获取最相关的段落。
数据检索:对运营集合(电网、网络、客户数、电价)进行 MongoDB 聚合,以实时数据回答。
内存:对话状态会持久存储在 MongoDB Atlas (
agent_checkpoints、agent_checkpoint_writes)中,因此代理可以记住轮次之间的上下文,而无需外部状态存储。推理和生成(编排):LangGraph 编排层协调循环,LLM (Claude) 对检索到的上下文进行推理并合成最终回答,该回答将返回给用户。
汇总如下:AI 层不会复制逻辑,其数据检索工具会调用为运营仪表盘提供动力的相同聚合,两个层都共享一个 Atlas 集群来进行数据、搜索和代理内存。
数据模型方法
该解决方案在单一 MongoDB Atlas 数据层上运行监控、网络操作、预测、客户智能和网格支持代理。
MongoDB document model 通过将操作、搜索和内存数据组织成灵活的集合来实现这一目标,这些集合可以保持连接,而无需单独的系统来存储、同步或协调信息。
此解决方案基于一组 MongoDB 集合,这些集合协同工作以支持操作工作负载和 AI 功能:
readings存储时间序列电表数据。customer_db,network、meter_network_map和tariff_catalog存储核心客户、网格、映射和费率数据。agent_checkpoints并agent_checkpoint_writes持久化代理内存。kb_articles为知识库提供 AI 搜索功能。
这些集合共同为监控、分析和智能用户交互提供一个连接的数据层。以下部分将更详细地介绍每个集合,并解释其结构如何支持整体解决方案
readings: 在时间序列集合中,每个间隔存储一个电表读数、电气测量、电器级别子负载、预计算的间隔消耗 (interval_kwh)及其去规范化的电网上下文(馈线/变电站/公用事业)。
{ "timestamp": { "$date": "2026-07-08T17:00:00.000Z" }, "dataid": 661, "power_factor": 0.933, "city": "Austin", "frequency": 60.043, "voltage": 119.958, "energy": 53.76054, "feeder_id": "feeder_austin_south_02", "kitchen_power": 168.8, "power": 3246.151, "env_power": 1112.159, "heating_power": 344.741, "utility_id": "utility_austin", "laundry_power": 61.352, "current": 29.004, "_id": { "$oid": "6a760c8ee48b9c05164d7d57" }, "avg_reading": 119.958, "interval_kwh": 0.81154, "ev_power": 0, "volt_leg_1": 118.982, "has_ev": true, "transformer_id": "transformer_austin_south_02_01", "hvac_power": 1559.099, "substation_id": "substation_austin_south", "volt_leg_2": 120.934, "state": "Texas" }
network: 将公用程序层次结构模拟为链接文档。parent_asset_id形成公用程序 → 变电站 → 馈电器 → 变压器层次结构,并且每个资产都具有自己的容量和位置。
{ "_id": { "$oid": "6a43f5a0fc0d1c3b5276bb29" }, "asset_id": "transformer_austin_south_02_02", "asset_type": "transformer", "city": "Austin", "state": "TX", "name": "Austin South Transformer 02-02", "parent_asset_id": "feeder_austin_south_02", "capacity_kw": 1500, "voltage_kv": 0.48, "status": "active", "location": { "type": "Point", "coordinates": [ -97.7131, 30.263199999999998 ] } }
tariff_catalog: 存储其层级带嵌入为数组的费率计划,因此完整计划可读作一个文档。
{ "_id": { "$oid": "6a760c89e48b9c05164d7d4c" }, "utilityName": "Austin Energy", "rateName": "Residential", "fixedChargeFirstMeter": 15, "fixedChargeUnits": "$/month", "energyRateStrux": [ { "energyRateTiers": [ { "max": 300, "unit": "kWh", "rate": 0.04106, "adj": 0.06455 }, { "max": 900, "unit": "kWh", "rate": 0.05138, "adj": 0.06455 }, { "max": 2000, "unit": "kWh", "rate": 0.07525, "adj": 0.06455 }, { "unit": "kWh", "rate": 0.10884, "adj": 0.06455 } ] } ], "energyWeekdaySched": [... ], "energyWeekendSched": [... ], "effectiveDate": { "$date": "2025-05-01T00:00:00.000Z" }, "sourceReference": "https://austinenergy.com/-/media/project/websites/shared/pdfs/rates/tariff.pdf?rev=382867d1201343b78d6a940e4ef471b5&hash=51DA5A20032359FB44C3F61BFB5E7F5E", "rate_type": "tiered", "city": "Austin", "state": "TX", "location_label": "Austin, TX" }
kb_articles: 存储域知识库,已为 Atlas Vector Search(带自动 Voyage AI 嵌入)和全文搜索建立索引。Atlas 从文本字段生成嵌入,没有单独的嵌入管道。
{ "_id": { "$oid": "6a711e3759c1cc549f2e8c42" }, "slug": "what-is-power-factor", "category": "Glossary", "text": "Power factor is the ratio of real power (kW, the power that does useful work) to apparent power (kVA, the total power drawn). It ranges from 0 to 1. A power factor near 1.0 means electricity is being used efficiently; a low power factor (for example below 0.9) means a lot of reactive power is being drawn, which stresses the grid and can incur penalties for commercial customers. Motors, transformers, and other inductive loads lower the power factor.", "title": "What is power factor?", "updatedAt": { "$date": "2026-08-04T19:30:01.654Z" } }
meter_network_map: 将每个电表 (dataid) 映射到其在电网拓扑结构中的位置(馈线、变电站、公用事业单位和变压器)。同样的上下文也会去规范到每个读数中,因此高频视图可以在没有连接的情况下读取。customer_db: 存储每个客户的位置(城市和省/市/自治区),以电表dataid为键。费率计划和使用分段是按需从tariff_catalog和通过聚合衍生的。agent_checkpoints和agent_checkpoint_writes:存储代理内存,由 LangGraph 托管,其中,助手的对话状态按线程持久存储,以便上下文在多轮对话中得以保留,无外部状态存储。
为何 document model 适合此解决方案:
每次读取都包含当前所有信息:仪表读取将其电气测量和器件级分负载嵌入到一个文档中,无需连接重新构建单个读取。这些存储在时间序列集合中,可以以高频率有效地摄取和查询。
网格层次结构按现有状态建模:网络(公用事业→变电站→馈线→变压器)作为平台逐步组装拓扑结构视图的链接文档进行存储,每个读取都带有其在该层次结构中的位置,因此模型可以在没有模式迁移的情况下进行扩展或更改。
模式在没有迁移的情况下演进:可以将新的设备子负载、客户属性或资产字段作为新字段添加,以便平台扩展时现有文档、管道和应用程序工作流可以继续工作。
相同数据支持每个工作负载:监控、预测和客户仪表盘后的聚合都在支持跨网格模型连接的相同操作集合上运行,这样可以减少重复并避免使用独立系统。
AI 数据与运营数据共存:知识库、向量和全文搜索以及代理的对话内存都存在同一个 MongoDB Atlas 集群中,因此,检索、推理上下文和运营分析可以协同工作,无需单独的基础设施。
构建解决方案
Smart Grid Intelligent Platform 使用 MongoDB Atlas 作为单一数据层,用于实时监控、网络操作、需求预测、客户智能和网格支持代理。
请按照以下概要步骤部署解决方案。有关详细的设置说明、示例数据和可运行的代码,请参阅 GitHub存储库。
关键要点
在单一数据平台上整合操作:在一个 MongoDB Atlas 集群上运行监控、网络操作、预测和客户数据分析,可以消除在不同系统之间复制和协调仪表数据的费用和延迟。这种方法可降低总体拥有成本,并且可以将新功能更快地投入生产。
将原始仪表数据转化为操作决策:直接在聚合管道中计算服务中断、容量利用率和异常,以便操作员可以实时处理电网状况。这可以减少停机时间,并在过载发生故障之前防止其发生连锁故障。
利用可感知天气的预测来规划容量:利用外部天气数据(包括加热和制冷度日)丰富需求预测,以帮助公用事业单位预测峰值并主动分配容量。这可减少成本高昂的应急响应,并提高电网可靠性。
通过统一智能提高客户效益:从相同的仪表数据中提供服务关税建议、消费趋势和使用分段,以帮助公用事业部门与客户进行互动,为客户提供相关的个性化指导。这支持满意度和保留。
使用 MongoDB 上的代理 AI 赋能团队:使用 LangGraph 多代理助手,使任何操作员都可以使用自然语言查询网格、网络和客户。这使数据访问民主化,并在不需等待专业报告或分析师的情况下加快决策。
作者
Muhammad Atif
Andrea Fatima Figueroa Lopez
Maria José Cordova Igartua
Javier Guajardo Canseco
Andrea Alaman Calderon