产品: MongoDB Atlas、MongoDB Atlas Charts、MongoDB 时间序列、MongoDB Queryable Encryption
解决方案概述
医疗保健提供者按照严格的质量要求运营。联邦机构和保险公司(包括 CMS 和主要健康计划)要求提供者衡量、追踪和报告他们为患者提供的护理质量。遵守这些要求会带来财务后果,例如对符合这些标准的组织给予更高的报销,对未达到这些标准的组织进行处罚。
HEDIS 定义了质量要求。此测量设立指定了提供者必须为每位患者完成的临床活动,示例,HbA1c、肾脏评估和糖尿病患者的糖尿病眼部检查。当患者在测量期内没有接受所需的活动时,就会出现护理差距。
护理缺口不仅是合规问题。如果未能及时发现,将导致患者预后不佳、住院再次入院率增加、疾病进展和可预防并发症。在按照患者预后而非提供的服务量支付的合同下,这些问题还会导致 CMS 星级评级降低和报销损失。
大多数组织都知道存在护理差距。然而,他们面临着运营挑战。虽然 FHIR 数据存储允许医疗软件和 EHR 系统安全地通信和股票数据,但它们并未针对实时操作临床查询进行优化。在实时工作负载下,它们会遇到可预测的瓶颈,例如查询延迟高、嵌套资源聚合性能差、缺乏原生时间序列支持以及随着查询量的增加而成本上升。因此,护理协调员无法足够快地从这些系统获取数据,从而追踪HEDIS合规、弥补患者差距并及时进行干预。
为了克服这些性能瓶颈,该解决方案提供了一个 CDS 系统,该系统构建在 FHIR 数据基础上,由...提供支持MongoDB Atlas作为操作层。在此架构中,FHIR 处理互操作性和数据交换,而MongoDB Atlas支持实时生命体征监控、HEDIS 护理差距计算和临床工作流程。借助该框架,护理协调员可在护理点获得低延迟数据访问和实时决策支持。
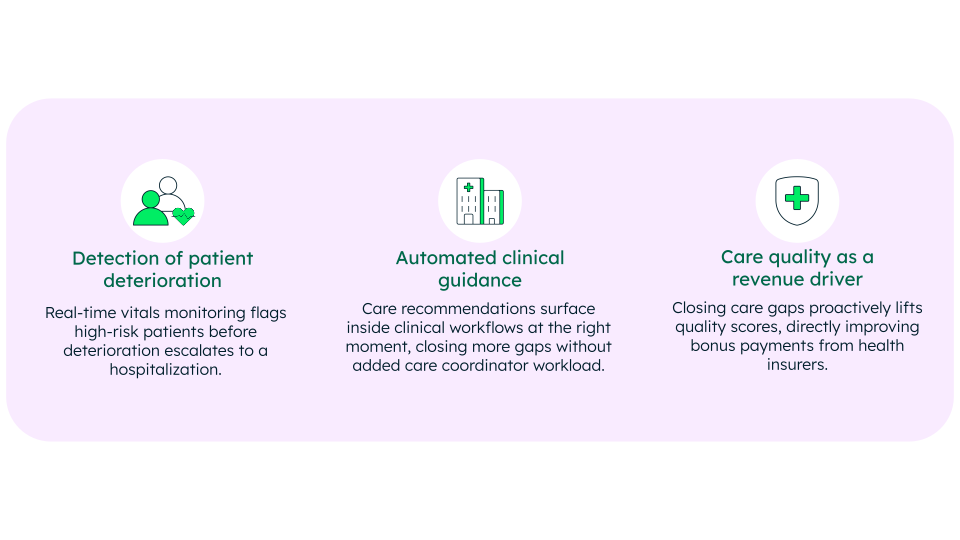
图 1。MongoDB 实时临床决策支持的优势
参考架构
如下架构图所示,该解决方案可以从可穿戴设备和医疗系统摄取临床数据,通过数据存储和操作层进行路由,并向护理协调员提供实时决策支持。
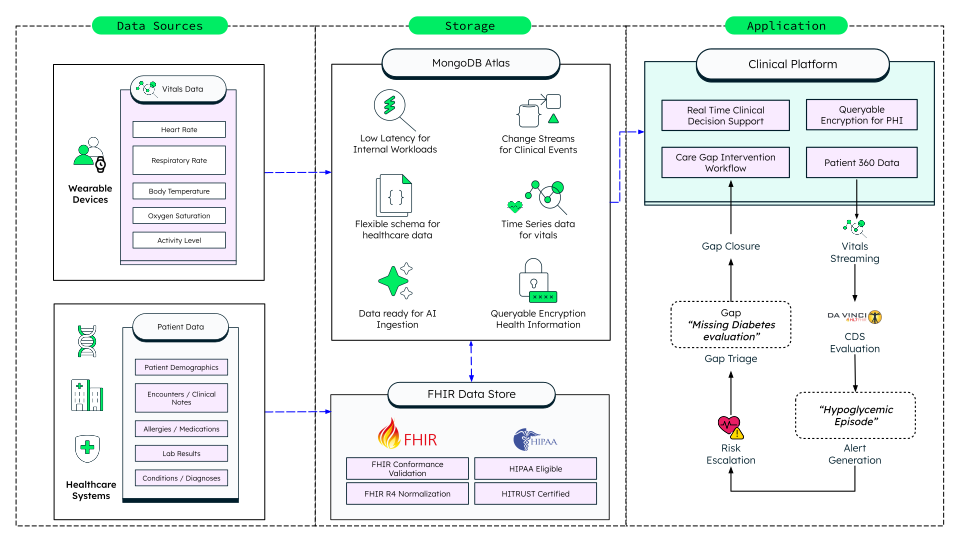
图2。高层架构
FHIR 数据存储层保存原始 FHIR R4 资源,其中包括:
PatientConditionMedicationRequestObservationEncounterAllergyIntolerance
该层处理一致性验证和R4 规范化,作为 HIPAA 和 HITRUST合规要求下互操作性的规范事实来源。
MongoDB Atlas 提供操作层。它存储为临床决策支持所需的查询、聚合和实时工作流优化的非规范化文档和时间序列数据。
为了将这些存储的临床数据转变为实时操作,该平台协调以下组件:
MongoDB Atlas 是操作基础,可在灵活的多态模式中存储所有临床数据。
数据生成管道从 FHIR 数据存储中读取数据,并将患者记录、生命体征和 CDS 规则填充到 MongoDB Atlas 中。
该系统集成了
AlertEngine和QualityEnginePython 模块以支持临床决策。AlertEngine监控实时生命体征以即时发现临床风险,QualityEngine评估临床病史以查找 HEDIS 合规差距。两个引擎都将结果写入 MongoDB Atlas 中的patient_360文档。最后,护理差距工作流将引擎的结果直接传送给护理协调员。例如,当
AlertEngine触发关键警报时,关怀差距工作流会优先处理开放差距,以便协调员可以先查看紧急情况。
以下各节描述此流程的每个部分。
MongoDB Atlas:主要功能
MongoDB Atlas 专为复杂的医疗工作负载而设计,可以用高度优化的原生数据生态系统替换旧版系统。以下是平台提供实时决策支持的核心功能概要。
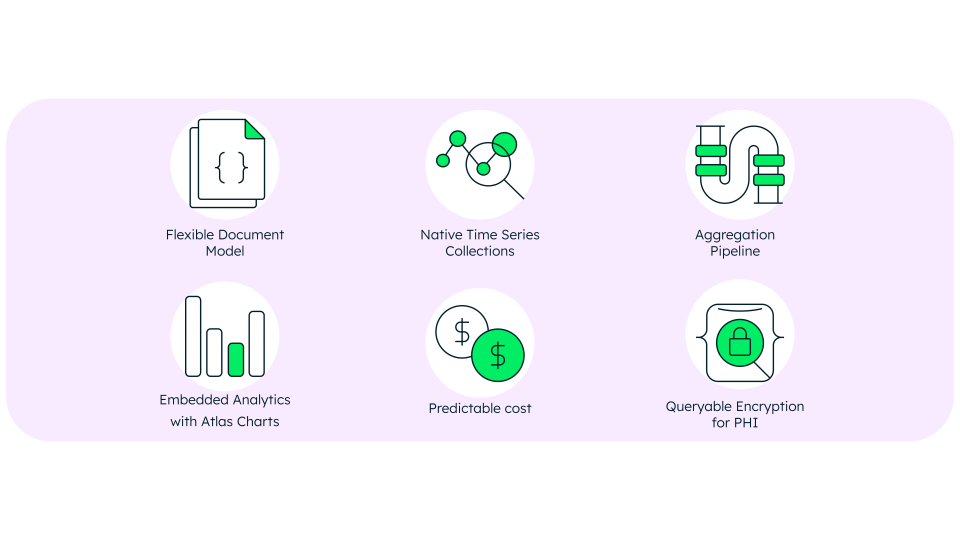
图 3。Atlas 关键功能
灵活的 document model:patient_360 collection 将完整的患者记录(包括人口统计数据、病症、药物、实验室、生命体征总结、护理缺口、警报、个性化阈值和数据来源)存储在单个文档中。单个文档可以回答需要对 FHIR 存储进行多资源连接的问题。
时间序列集合:synthetic_vitals 集合使用 MongoDB 的原生时间序列集合来存储可穿戴设备数据。这些集合为高频率、按时间顺序排列的数据提供自动数据分桶、高效的范围查询和专用存储。
变更流:该平台使用变更流实时反应新的生命体征。当读数到达时,系统会评估 CDS 规则并生成临床警报,而无需进行拉取。
Queryable 加密: MongoDB Queryable Encryption静态保护敏感患者字段。该应用程序查询加密的PHI 字段而不会暴露明文,从而满足 HIPAA 要求并无需单独的加密层。
聚合管道:该框架处理仪表盘聚合、护理差距计算、生命体征趋势分析和 HEDIS 评分,在几毫秒内解决复杂的临床查询。
AI 和分析的结构:patient_360 文档可以向下游 AI 和分析管道提供规范化的临床事实、结构化的证据和元数据来源,无需进行附加转换。
数据生成管道
初始化后,该解决方案使用多步管道来培育和激活 CDS 系统,如下所示。
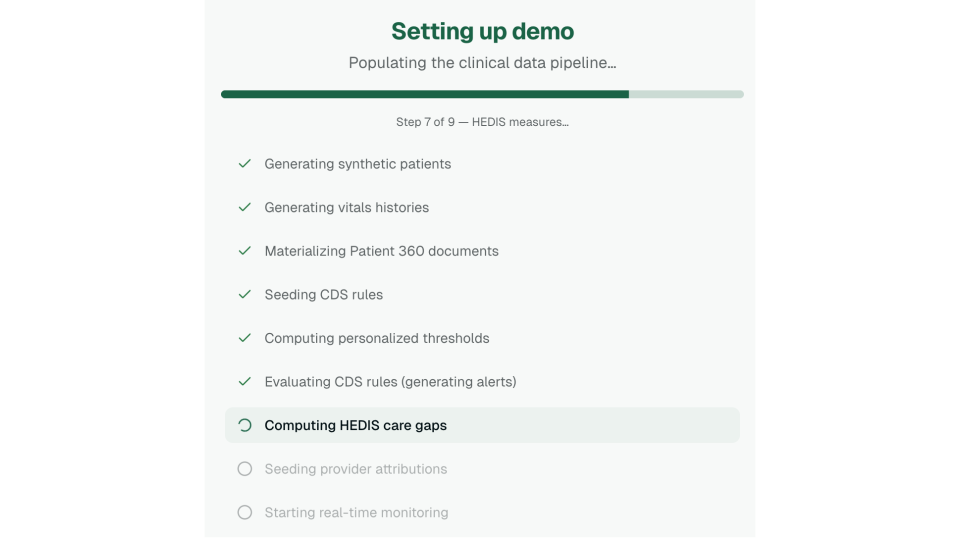
图 4。数据生成管道
数据生成管道驱动初始化序列,该序列创建合成和具体化的临床数据,计算个性化阈值和护理缺口,并开始实时监控。该管道的工作方式如下:
生成 FHIR 患者包:创建 FHIR R4 事务包,包括病症、药物、实验观察、就诊和过敏。它将这些包存储在 FHIR 数据存储中,该存储可作为互操作层。
生成生命体征历史:为每位患者生成 24 小时的生命体征时间序列,代表正常、恶化或急性生理模式。它将数据存储在
synthetic_vitals时间序列集合中。具体化 patient_360 文档:将每个 FHIR 包转换为 MongoDB Atlas 中的非规范化
patient_360文档。转换包含一个data_provenance块,该块链接回源 FHIR 记录。种子 CDS 规则:将临床决策支持规则定义插入
cds_rules集合。计算个性化阈值:根据活动药物和病症计算每位患者的生命体征阈值。它将这些结果存储在
patient_360文档中。评估 CDS 规则:对当前生命体征运行
AlertEngine,并将生成的警报写入alerts集合。计算 HEDIS 关怀差距:对每位患者的临床病历运行
QualityEngine,并将结构化的关怀差距结果写入patient_360文档。种子提供商属性:在
attributions集合中生成提供商-患者属性关系,确定哪些提供商接收缺口结果和警报。开始实时监控:激活生命体征模拟工作器,并通过服务器发送的事件开始向临床平台流式传输实时生命体征数据。
CDS 引擎
CDS 引擎分析患者数据,为护理团队提供可操作的见解。该解决方案将临床监控与质量测量计算分离到两个独立引擎中。该架构模式遵循 Da Vinci 企划,该企划是一个用于护理互操作的 HL7 FHIR 加速器程序,建议将实时警报与 HEDIS 间隙逻辑解耦。
AlertEngine:实时阈值监控
AlertEngine 根据 CDS 规则评估输入的生命体征,并生成临床警报。它验证以下 CDS 规则:
Beta-blocker-aware tachycardia: 评估心率是否超过个性化阈值。
多因素低血糖症:检查心率峰值、2 型糖尿病、胰岛素、65 岁或以上年龄和低活动的聚合条件。
慢性肾脏病代谢性酸中:监控呼吸频率超过 22 并持续 30 分钟。
败血症警告:控制三个或更多修改后的 SIRS 标准的存在,其中糖尿病为风险放大器。
对比上下文:评估患者用药和病情资料,产生不同严重程度的警告。
AlertEngine 检查持续违规,而不是单个读数。它使用 2 小时的基线窗口进行峰值检测,使用 4 小时的趋势窗口进行恶化。引擎将上下文应用于每个警报,这意味着相同的心率读数会为受体阻滞剂患者生成严重警报,并为健康患者生成低严重级别标志。
QualityEngine:HEDIS 护理差距计算
QualityEngine 确定每个患者是否在 HEDIS 测量周期内接受了所需的临床护理。该引擎以患有 2 糖尿病和 CKD 的患者为目标,并根据指定的 HEDIS 指标评估他们的临床病史。
下表显示了这些 HEDIS 指标:
测量 | 代码 | 需要证据 |
|---|---|---|
全面糖尿病护理 — HbA1c 测试 | CDC-HBA | HbA1c 实验室结果 |
糖尿病肾脏健康评估 | KED | 血清肌酐清除率 (eGFR) 和尿白蛋白肌酐比值 (uACR) 实验室结果 |
控制高血压 | CBP | 合格的遇到 |
糖尿病患者的他汀治疗 | SPD | 总胆固醇实验室结果 |
糖尿病患者眼部检查 | EED | 合格的遇到 |
医疗协调员使用 QualityEngine 结果来确定哪些患者需要干预,并在缺口影响质量分数和报销之前优先外展。每个结果都包括缺口状态、找到的证据、缺少的证据、推荐的操作、优先级分数和重新计算日期。此外,该引擎还公开一个符合 FHIR 的终结点,该终结点返回 MeasureReport 包,以确保与付费人系统的互操作性。
护理缺口工作流
医疗差距工作流程是医疗组织用于识别、追踪和解决患者实际临床护理与既定医疗指南之间差异的系统过程。医疗差距检测从识别到关闭遵循结构化路径,包括以下操作:
评估:
QualityEngine根据 HEDIS 测量标准评估每位患者的临床病史。写入:系统将开放的缺口写入
patient_360文档,并附加其支持证据、推荐操作和优先级。查看:管理员按照优先级和逾期时间查看临床平台中的未开发空白。
干预:对于 KED 和 CDC-HBA 等可采取行动的差距,该平台会打开一个结构化的干预工作区,协调员可以在其中订购实验室、记录完成情况或安排后续行动。
关闭:干预完成后,间隙状态会在
patient_360文档中更新,并在下一个周期中对QualityEngine进行重新评估。升级:当
AlertEngine检测到临床警报时,它会提高相关开放缺口的优先级,并通知护理团队。没有相关缺口的警报,例如脓毒警告,会作为独立的临床通知直接路由到护理团队。
数据模型方法
单个患者的 FHIR R4 事务包含超过 20 个单独资源。要确定年龄超过 65 、患有 2 型糖尿病并服用胰岛素的患者是否有低血糖风险,系统必须:
查询 FHIR 存储以检索
Patient资源。将该资源与多个
Condition和MedicationRequest资源相关联。在合并结果中应用规则逻辑。
在实时生产工作负载下,此遍历会增加延迟并产生不可预测的查询时间。例如,此解决方案中的患者最多可以有五个活动状况、六个药物资源、八个实验观察资源、一个遇到和一个临床笔记,而这些都必须由 CDS 规则评估。
为了避免这些开销,patient_360 文档将这些碎片数据整合到单个文档中,完全消除遍历。对于单个患者,所有临床数据存储在单个文档中,结构如下:
patient_id: 链接到源 FHIR 记录的唯一患者识别符。demographics: 年龄、性别和加密的 PHI 字段(姓名、MRN、出生日期)。conditions:带有 SNOMED 代码和发病日期的主动诊断。medications:包含剂量、给药途径和频率的有效处方。labs: 带有值、单位和参考范围的结果。flags: 从条件和药物中衍生的计算布尔值。personalized_thresholds: 根据活性药物的每位患者生命体征限制。vitals_summary: 最新读数、4 小时平均值和 24 小时趋势。active_alerts: 由AlertEngine生成的 CDS 警报。care_gaps:QualityEngine计算的 HEDIS 测量结果。data_provenance: 源 FHIR 集合、患者 ID 和具体化元数据。
作为文档数组的临床数据
在 patient_360 文档中,每个条件都代表 conditions 数组中的一个条目,而每种药物都代表 medications 数组中的一个条目。如下所示,文档以使用的形状存储临床实体,而不是分割到不同的表中:
{ "conditions": [ { "code": "44054006", "display": "Type 2 diabetes mellitus", "clinical_status": "active", "onset_date": "2017-10-21T21:29:59.716351+00:00" }, { "code": "433144002", "display": "Chronic kidney disease stage 3", "clinical_status": "active", "onset_date": "2023-09-12T21:29:59.716372+00:00" } ], "medications": [ { "display": "Insulin glargine 100 units/mL injection", "dose": "20.0 units", "route": "subcutaneous", "frequency": "once daily at bedtime", "status": "active" }, { "display": "Atenolol 50 mg oral tablet", "dose": "50.0 mg", "route": "oral", "frequency": "once daily", "status": "active" } ] }
计算操作字段
FHIR 包含标准互操作数据,而 patient_360 文档则包含 FHIR 未定义的操作字段,包括临床标志、护理缺口结果、个性化阈值和活动警报。
例如,嵌入到更广泛的数据生成管道中的具体化管道会从 FHIR 包计算临床标志,并将其直接写入 patient_360 文档。AlertEngine 会读取这些标志,以确定哪些 CDS 规则适用于患者,包括:
flags.has_beta_blocker:激活β受体阻滞剂心率规则。flags.has_insulin: 激活多因素低血糖规则。flags.has_ckd: 激活 CKD 代谢性酸中和呼吸规则。flags.condition_codes: 所有活动状态的 SNOMED 代码。
护理差距结果使用相同的方法。具体化管道计算护理差距结果,并将其直接添加到 patient_360 文档。每个计算的 HEDIS 度量都与其相关的 status、priority、evidence 和 recommended_action 一起存储在 care_gaps 数组中。与标准 FHIR 不同,document model 将此信息与患者的临床记录一起存储。此结构的示例如下:
{ "care_gaps": [ { "hedis_measure": "CDC-HBA", "measure_name": "Comprehensive Diabetes Care — HbA1c Testing", "status": "open", "days_overdue": 34, "priority": "high", "evidence": { "found": ["HbA1c 5.13% (2025-10-07)"], "missing": [] }, "recommended_action": "Schedule or order an HbA1c follow-up" } ] }
这种方法提供了更大的灵活性;当临床要求发生变化时,您可以扩展文档。新的 CDS 规则将新字段写入到同一文档,而不影响现有字段。
对源记录的可追溯性
patient_360 文档构成一个衍生的操作视图,而不是 FHIR 记录的替代。具体化管道从 FHIR 资源产生此视图。为了对任何临床决策或护理差距结果进行 Atlas 审核,每个文档都包含一个 data_provenance 块:
{ "data_provenance": { "layer": "cds_operational", "source_fhir_collection": "synthetic_patients", "source_patient_id": "1b3bbaec-def8-4b55-8e87-9d04b55d6890", "materialization_version": "1.0", "last_materialized_at": "2026-05-09T21:30:04.873754+00:00", "fhir_resource_count": 22 } }
FHIR 数据存储是可互操作的权威真实来源,而 MongoDB Atlas 则保持操作视图,维护与其来源数据的直接链接。
在 document model 中加密字段
医疗保健法规要求应用程序对 PHI 进行加密。一种常见的方法是将加密的 PHI 存储在单独的系统中,并仅在需要时才检索。然而,该框架引入了第二个数据存储库、单独的密钥管理层,并增加了每次患者记录检索的延迟。
MongoDB Queryable Encryption消除了将 PHI 保留在同一文档中的这种开销。它保护高度敏感字段的安全,例如患者姓名、MRN 和出生日期,使这些字段只有使用加密密钥的授权客户端应用程序可读。文档的其余部分仍然可查询以供操作使用:
{ "demographics": { "name": { "$binary": { "base64": "EAXZmoXjO0re...", "subType": "06" } }, "given": { "$binary": { "base64": "EF1RChFVFEJC...", "subType": "06" } }, "family": { "$binary": { "base64": "EK18iT8qVki8...", "subType": "06" } }, "birth_date": { "$binary": { "base64": "EJOsqgLJPEjI...", "subType": "06" } }, "gender": "female", "age": 77 } }
例如,AlertEngine 和 QualityEngine 等微服务会读取标志、阈值和关注空白字段,也不会读取加密的人口统计字段。
构建解决方案
在 GitHub存储库中查找详细的安装说明。该存储库包括获取MongoDB Atlas连接字符串的步骤、用于容器化部署的Docker配置以及本地部署说明。
配置先决条件和设置
安装Docker Desktop 以将平台作为容器运行。
创建 MongoDB Atlas M10 集群并配置网络访问权限。
连接到 Atlas 集群并复制连接字符串。
[可选]创建可以访问
HealthLake服务的 Amazon Web Services 账户,以便将 FHIR 包持久存储在外部 FHIR 数据存储库中。
启动平台和数据种子
在浏览器中打开 http://localhost: 。登录时,选择与演示场景匹配的角色:8080
Frida(模拟模式):在填充前选择 Frida 以配置模拟设置。该平台运行一个多步管道,可自动生成和加载所有数据。将此模式用于实时生命体征流媒体的现场演示。
Diego(现有数据模式):选择 Diego 连接到之前已种子化的数据集,没有运行模拟。当您想演示平台对稳定数据的效果或种子化管道已运行时,请使用此选项。
探索患者仪表盘、查看未关闭的护理缺口并实时监控生命体征。
关键要点
将 MongoDB Atlas 用作 FHIR 工作流的操作层:在 MongoDB Atlas 中使用非规范化操作层扩展应用程序的 FHIR 数据基础,以支持实时临床查询、空缺照护计算和生命体征监控。
将患者数据模拟为单个文档:将病症、药物、实验室、警报、护理缺口和生命体征阈值存储在一个文档中,使您的应用程序可以在一次读取中检索所有需要的内容,而无需连接多个资源。
在数据摄取时预计算临床标志和阈值:从 FHIR 包中提取关键临床事实,并在摄取时将其作为计算字段存储在 MongoDB Atlas 中,使 CDS 引擎能够评估规则而无需重新读取源记录。
将护理缺口和警报结果直接写入患者文档:使用
care_gaps和active_alerts等数组字段将 HEDIS 测量结果和临床警报与临床记录一起存储,为护理协调员提供可在一次查询中获取完整、可执行的信息。使用 MongoDB Queryable Encryption 保护 PHI:对敏感患者字段应用 Queryable Encryption,以保护 PHI,同时避免明文曝光,满足 HIPAA 要求,无需单独的加密层。
作者
Giovanni Rodríguez Fragoso, MongoDB
Francesc Mateu Amengual, MongoDB
Diego Canales, MongoDB