了解如何使用 MongoDB Atlas 对 SNOMED CT 临床术语进行建模、搜索、导航和基础处理。
使用案例: 互操作性
行业: 医疗保健
产品: MongoDB Atlas、MongoDB Search、MongoDB 向量搜索、Voyage AI
解决方案概述
医疗保健应用程序需要了解临床意义,而不仅仅是存储临床文本。医生可能会写“心力衰竭”、“心脏衰竭”或“insuficiencia cardíaca”。不同的词可以描述相同的临床概念。临床编码为应用程序提供了一种标准方式,可以使用稳定的标识符来表示该含义。
医疗保健团队出于不同目的使用不同的编码系统。某些编码系统会对诊断和遭遇群组,以用于报告、统计、报销或医院活动分析。 SNOMED CT 专注于健康记录中的临床意义。它可以代表问题、发现、程序、身体结构、有机体、物质、产品和许多其他临床想法。 SNOMED CT 支持应用程序对电子健康记录中记录的临床事实进行搜索、交换、分析或推理。
SNOMED International 将 SNOMED CT 描述为一种临床术语,其概念具有独特的含义、正式定义和分级组织。
SNOMED CT 具有图状结构。有超过 500,000 个临床概念,每个概念都可以有多个人可读的说明,包括同义词和翻译。它可以具有父概念、子概念、祖先和与其他概念的正式关系。SNOMED CT 通过概念、说明和关系表示术语内容,如下所示:
概念代表一个临床思想。
说明将人类可读的术语与该概念相链接。
关系将一个概念与另一个概念连接起来。
这种结构很强大,但会创建实现挑战。应用程序团队需要快速术语搜索、多语言查询、层次结构导航、后代扩展和关系检查。他们还需要在临床笔记查看、问题列表创建、决策支持、群组发现和语义搜索等工作流中使用 SNOMED 的术语。传统实现通常会将这些需求分割到多个系统中:
术语文件的关系数据库。
用于文本查询的搜索引擎。
用于层次遍历的图表数据库。
用于语义搜索的矢量数据库。
此解决方案展示了如何在 MongoDB Atlas 上实现 SNOMED CT 的运行:
将每个 SNOMED 概念存储为 MongoDB 文档,将概念身份、说明、关系、父级、子级和祖先路径存储在一起。
为 MongoDB Search 和 MongoDB 向量搜索构建一个术语级别搜索投影。
使用祖先数组和多键索引来支持常见的层次结构和后代查询,无需单独的图表数据库。
使用相同的术语服务将临床笔记基于 SNOMED 候选者
存储已查看的编码及其证据、上下文和祖先路径。
示例,用户可以搜索“心力衰竭”,检查所选的临床概念,查看其父概念和子概念,查看其形式关系,以及展开其下面的特定概念。 SNOMED CT 通常利用 ECL 来表示此类后代扩展。 ECL 用作一种紧凑查询语言,用于描述 SNOMED CT 概念集。示例,表达式<< Heart failure 指的是“心力衰竭以及层次结构中低于其的所有概念”。在 MongoDB 的模式设计中,这种模式自然映射到对预先计算的祖先数组的查询。 SNOMED 的官方 ECL 参考将操作符<< 定义为“后代或自身”,用于检索概念及其子类型。
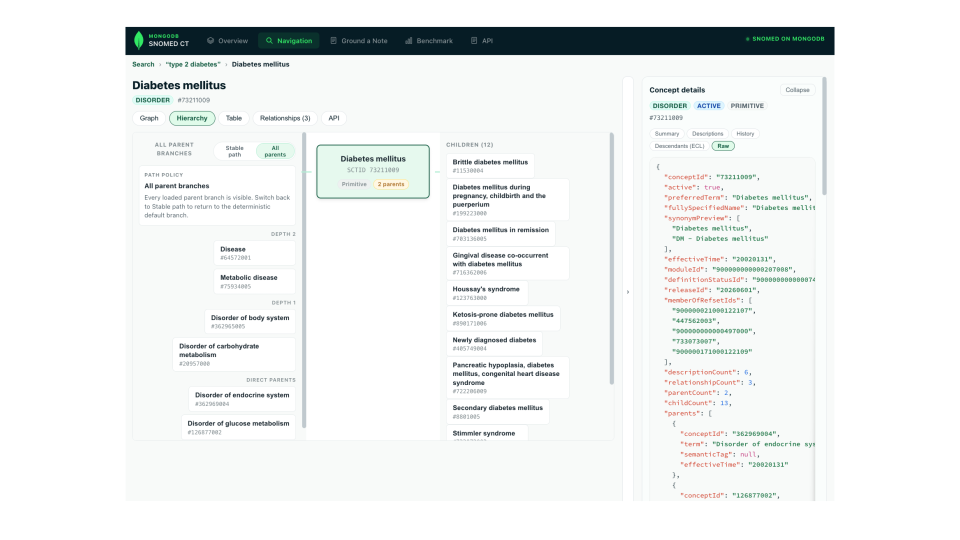
图 1。包含父子级别的临床概念
该解决方案还演示了临床笔记基础。笔记可能包含当前结果、过去历史、家族史、计划操作、不确定声明和否定结果。该应用程序提取候选临床术语,通过 MongoDB 搜索 SNOMED CT,提出候选概念,并且仅在确认后才存储已查看的编码。存储的编码保留原始证据范围、所选 SNOMED 概念、断言上下文、审核人状态和祖先路径。下游应用程序可以按临床意义进行查询,而不仅仅按精确字词进行查询。
在需要时使用此解决方案:
搜索临床术语、同义词、译文和 SNOMED 标识符。
导航父、子、祖先、后代和关系视图。
支持从一个 MongoDB 集合中进行词汇、语义和混合术语搜索。
使用 ECL 式层次结构表达式(例如“心力衰竭的所有后代”)扩展概念集。
将临床笔记基于证据范围和人工查看对应到 SNOMED CT 候选。
存储已查看的 SNOMED 编码和祖先路径,以供索引的下游查询。
该模式为应用程序团队提供了一个操作平台,用于术语数据、术语搜索、语义检索、层次查询、临床证据捕获和 Atlas 审核编码输出。它减少了运行独立系统进行文档存储、搜索、语义检索和图表式导航的需求。
SNOMED CT 许可说明:与此解决方案相关的公共存储库仅包含一小部分示例数据集。SNOMED CT 需要适当的许可。
参考架构
此参考架构包含导航工作流和基础临床笔记工作流。
导航可帮助术语用户搜索、检查和确定 SNOMED CT 概念的范围。地面临床笔记重用相同的术语检索层,默认使用确定性词法搜索,从临床文本中提出 SNOMED CT 候选并仅存储查看过的编码。
该架构使用一组 MongoDB 集合:
snomed-irbd集合存储真相术语视图。snomed-term-search支持高质量的术语搜索。grounded_notes集合存储已查看的应用程序输出,而不是源术语数据。
SNOMED CT 内容呈图表形状。此架构将连接的结构保持在 MongoDB 文档中,并使用搜索投影和祖先数组使其可操作。
架构一览
此实施从授权的 SNOMED CT 内容包开始,该内容包已作为JSON概念模型提供。在当前演示中,源模型来自卫生部使用的西班牙国家 SNOMED CT 发行版。公共存储库仅包含示例数据集。它不会重新分发完整的 SNOMED CT 术语。
该架构与源格式无关。如果组织以 JSON 格式接收 SNOMED CT,则可以将该模型直接加载到 MongoDB 中。

图 2。MongoDB 作为代码权威,并带有可选的、候选受限的 LLM 网关。
目标模型包含以下术语集合:
snomed-irbd: 存储每个临床概念及其说明、关系、父级、子级、祖先、活动状态、发布元数据和成员资格元数据。应用程序使用此集合进行概念查找、层次结构导航、关系检查和后代扩展。snomed-term-search: 每个活跃术语、语言和发布存储一个可搜索文档。应用程序使用此投影进行词法搜索、语义搜索、混合搜索、语言过滤和范围过滤。
导航API使用 snomed-term-search 查找匹配的概念。然后,它会从 snomed-irbd 集合中丰富选定的结果。用户可以搜索诸如“心力衰竭”等临床短语,检查选定的概念,查看更广泛和更具体的概念,并打开相同操作的API示例。
Grounding API 在临床笔记工作流程中重用了术语检索层。Grounding 检索默认为确定性词汇搜索,而 Navigation 则提供词汇、语义和混合模式。可选的 LLM 层级可以帮助解释文本并在 MongoDB 提供的候选项中进行选择,但不得创建新的 SNOMED CT 标识符。
查看后,应用程序会将确认的编码存储在 grounded_notes 中。每个编码都会保留所选的 SNOMED CT 概念、证据文本、断言上下文、主题上下文、审核人状态和祖先 ID。下游应用程序可以按含义而不是按准确字词查询查看过的临床事实。
导航工作流
用户搜索临床术语,例如“心力衰竭”。应用程序查询术语搜索投影,并返回按 SNOMED 概念分组的概念级别结果。
每个结果显示:
与用户查询匹配的术语
概念的首选显示
正式临床名称
SNOMED 标识符
活动状态
语义类别
发布
搜索出处
用户可以打开概念对焦视图。此视图显示概念摘要、说明、父概念、子概念、关系、后代、原始文档和 API 示例。
导航支持这些搜索模式:
词汇搜索使用 MongoDB Search 进行精确术语、同义词、正式名称、标识符、前缀和模糊文本搜索。
语义搜索使用 MongoDB 向量搜索,它使用 voyage-4 参考模型自动嵌入该术语的
embedText字段。因此,按意义检索在同一集合上运行,无需单独的向量存储或嵌入管道。混合搜索结合了词法和向量检索。如果配置了 Voyage 跨编码器重排名器,则应用程序会对融合的候选池进行重排名;否则,它会回退到融合顺序。
搜索屏幕还支持语义范围。用户可以将结果限制为广泛的临床区域,例如临床发现、程序、身体结构或物质。用户还可以使用后代表达式,例如 << 404684003,将结果限制为某个概念及其更具体的概念。
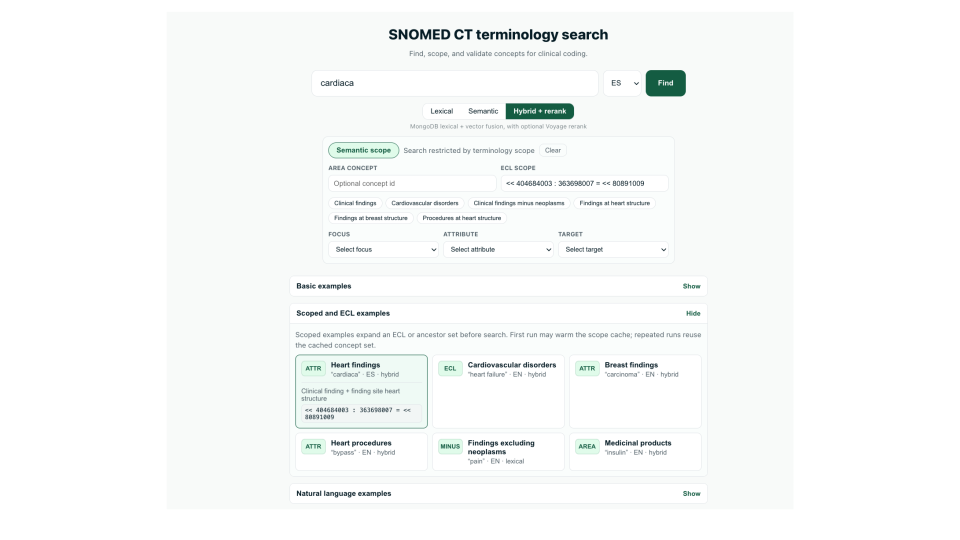
图 3。使用 ECL 范围扩展语义搜索
基础临床笔记工作流程
用户粘贴临床笔记。工作流提取临床提及和上下文线索,例如当前结果、否定、病史、家族史、计划操作、不确定性和时间表达式。
工作流程随后通过 MongoDB 搜索 SNOMED CT 候选。它返回可查看的候选者,并附带证据范围和上下文。审核人可以接受、拒绝或标记每个候选者以供审核。
可选的 LLM 层级可协助进行文本解释和候选者选择。它应仅从 MongoDB 返回的候选者中进行选择。它不得创建新的 SNOMED 标识符,也不得在未经审核的情况下保留编码。
查看后,应用程序会将确认的编码存储在 grounded_notes 中。每个保存的编码都包括证据范围、选定的 SNOMED 概念、断言、主题、状态和祖先 ID。此模式使下游应用程序能够查询含义。例如,应用程序可以查找包含所选临床概念的任何已接受后代的已查看笔记。
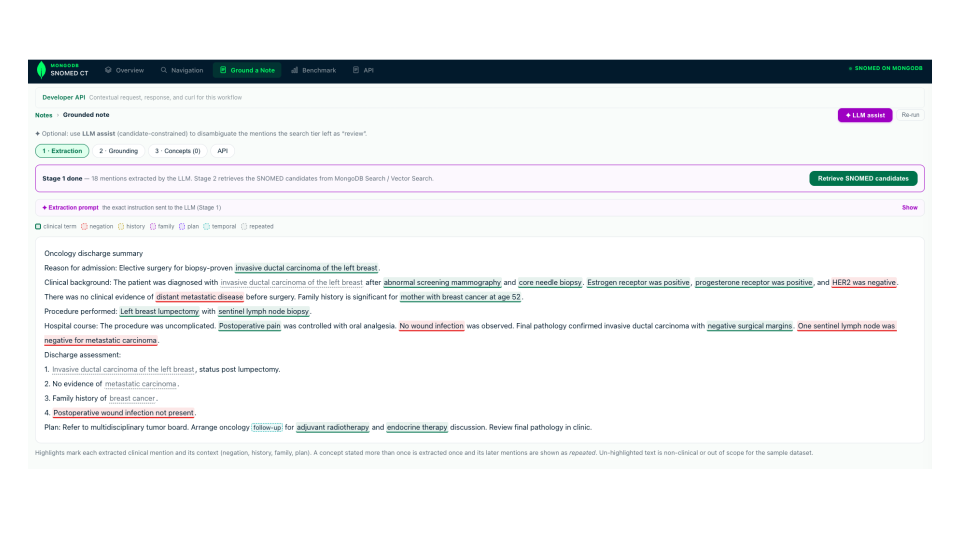
图 4。基于 LLM 过程对临床笔记进行基础处理
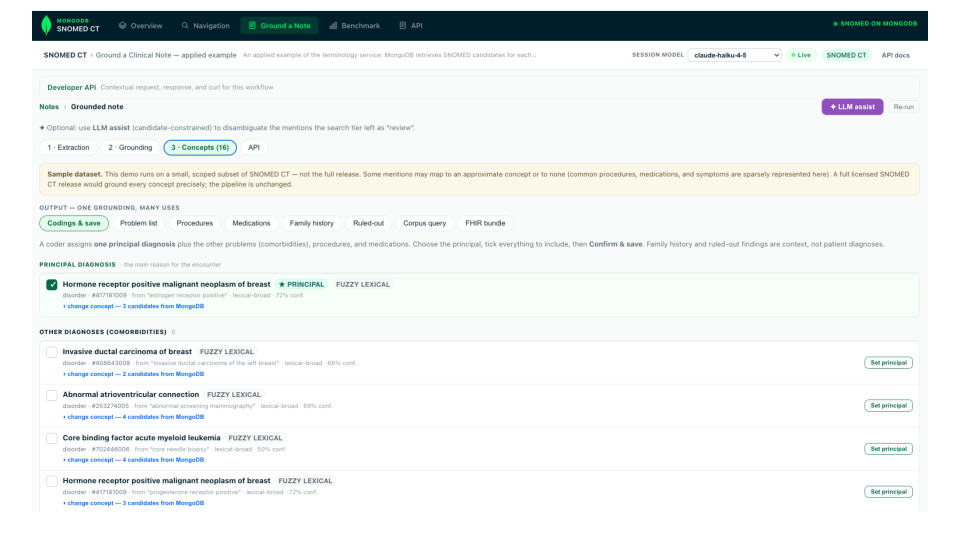
图 5。在 MongoDB 中搜索术语后对临床笔记进行基础处理
示例 API 代码片段
该解决方案为导航和地面临床笔记工作流提供 API。这些代码片段显示了核心请求模式。
搜索 SNOMED 术语和概念
使用此终结点搜索术语级别投影。响应将匹配的术语分组回 SNOMED 概念。它返回包含匹配术语、首选显示、语义类别和搜索来源的概念级别结果。
POST /api/navigator-search { "query": "heart failure", "languageCode": "en", "mode": "lexical", "limit": 24 }
当用户按照已知术语、同义词、正式名称或 SNOMED 标识符进行搜索时,请使用词汇模式。当为 MongoDB 向量搜索和重新排序配置演示时,API 还支持语义模式和混合模式。
展开概念及其后代
使用此终结点扩展概念集。SNOMED CT 使用 ECL 来描述概念集。在此示例中,表达式 << 84114007 表示“心力衰竭及其下所有更具体的概念。”
POST /api/ecl { "expr": "<< 84114007", "languageCode": "en", "limit": 200 }
该实现在 MongoDB 中使用预计算的祖先数组解析此表达式。此模式可以快速执行常见的后代查询,而无需为演示架构使用单独的图表数据库。
将临床笔记基于 SNOMED 候选者
使用此终结点从文本中提取候选临床提及,并从 MongoDB 检索有界 SNOMED 候选。响应会生成可审查的输出,而不会自动保留代码。
POST /api/nlp-map { "text": "Patient with chronic systolic heart failure and type 2 diabetes. No evidence of chest pain at present.", "languageCode": "en" }
基础工作流可检测临床提及和上下文,例如否定、历史、家族史、计划和时间表达式。MongoDB 提供候选 SNOMED 概念。审核人确认最终编码。
保存审核人确认的编码
查看后使用此终结点。应用程序仅存储已确认的编码,并为其添加祖先 ID,以实现下游语义查询。
POST /api/coding-confirm { "text": "Patient with heart failure.", "languageCode": "en", "codings": [ { "mention": "heart failure", "conceptId": "84114007", "displayTerm": "Heart failure", "semanticTag": "disorder", "accepted": true } ] }
保存的文档保留选定的 SNOMED 概念、证据文本、断言上下文、审核人状态和祖先 ID。此模式使下游查询能够通过一般概念或特定后代来定位笔记。
按含义查询基础注释
使用此终结点检索包含选定 SNOMED 概念或其临床后代的已查看笔记。
POST /api/grounded-corpus { "conceptId": "84114007", "includeDescendants": true, "limit": 10 }
此终结点展示了将祖先 ID 与查看编码存储在一起的下游价值。应用程序可以查询临床意义,而不是仅仅搜索准确词。
数据模型方法
SNOMED CT 表示连接数据。临床概念可以有许多人可读的术语、几个更广泛的概念、许多更具体的概念以及与其他概念的正式关系。
MongoDB 非常适合这种模式,因为大多数操作应用程序都需要以概念为中心的视图。当用户打开概念时,应用程序需要同时获取概念标识符、显示术语、说明、父概念、子概念、祖先路径、关系、活动状态和发布元数据。
此方法不会删除图表结构。它存储关系并为常见的导航模式添加友好查询的数组。例如,每个概念文档都可以存储其直接父级和祖先路径。此模式可以让应用程序通过索引的 MongoDB 查询查找更广泛的概念、子概念和后代。
为什么这种model有效
以下设计选择可满足特定的操作要求:快速查找、准确搜索、快速层次遍历和可审计编码。
将概念数据保持在一起:术语应用程序通常需要渲染完整的概念卡。嵌入说明、关系总结、父 ID、子 ID 和祖先 ID 可以将最有用的操作视图保持在一个文档中。
将搜索与源术语分离:搜索是术语级别的,而不是概念级别的。一个概念可以在不同的语言和方言中有多个说明。术语级别的投影可以让 MongoDB Search 和 MongoDB Vector Search 对匹配的准确术语进行排名,同时返回规范概念。
预计算层次结构路径:SNOMED CT 具有丰富的层次结构。许多应用程序需要快速的后代查询,例如“查找此概念及其下所有更具体的概念。”在每个概念和每个查看的临床编码上存储祖先 ID。然后将多键索引用于常见的层次结构查询。
存储带有已查看编码的证据:当应用程序可以解释其来源时,编码可以提供更多价值。将选定的 SNOMED 概念与临床文本范围、断言状态、主题上下文和审核人状态一起存储。此模式支持 Atlas 审核、查看和下游查询。

图 6。SNOMED CT 元模型和 MongoDB 集合映射
SNOMED CT 元模型和 MongoDB 集合映射
该解决方案使用三个术语集合,外加一个独立的遥测集合。以下部分介绍了文档形状和每个文档的主要字段。
snomed-irbd 集合
使用 snomed-irbd 作为 SNOMED CT 概念的单一可信视图。每个文档代表一个发布中的一个概念,并携带其 RF2 说明、定义关系、父概念、子概念、活动状态、发布元数据以及为层次结构和包含提供动力的预计算祖先闭包。
{ "conceptId": "44054006", "active": true, "effectiveTime": "20020131", "moduleId": "900000000000207008", "definitionStatusId": "900000000000074008", "descriptions": [ { "id": "73465010", "term": "Diabetes mellitus type II", "typeId": "900000000000013009", "languageCode": "en", "acceptabilityMap": { "900000000000509007": "..." } } ], "relationships": [ { "typeId": "116680003", "destinationId": "73211009", "relationshipGroup": "0", "active": "1" } ], "inferredParentIds": ["73211009"], "inferredAncestorIds": ["73211009", "64572001", "138875005"], "inferredChildIds": ["..."], "relationshipAttributeKeys": ["116680003|73211009"], "memberOfRefsetIds": ["..."], "releaseId": "20260601", "releaseDate": "2026-06-01T00:00:00.000Z", "releaseAppliedAt": "2026-07-06T00:00:00.000Z" }
snomed-irdb 包含以下相关字段:
conceptId: 表示 SNOMED 标识符 (SCTID);稳定的概念身份。descriptions[]: 表示概念的人类可读名称。每个名称都是同义词或完全指定的名称(正式临床名称),并记录其语言以及在该语言中是否为首选或可接受。这些条目映射到 SNOMED CT 发布文件中的说明行relationships[]: 表示概念与其他概念之间的关系。“是”关系定义层次结构。属性关系定义临床属性,例如查找站点或致病代理。relationshipAttributeKeys[]: 将每个属性关系表示为单个索引值。这使应用程序可以通过特定属性查找概念,并返回带有索引而不是全面扫描的结果。inferredParentIds、ChildIds、AncestorIds:表示在不进行图表遍历的情况下进行包含的有界预计算闭包。使用{ inferredAncestorIds: conceptId }子句查询后代,而不是存储在每个父概念上。
snomed-term-search 集合测试
使用 snomed-term-search 作为搜索投影。每个文档代表一种语言和一个版本中的一个活动说明术语,已为 MongoDB Search、范围过滤和自动嵌入式 MongoDB 向量搜索进行了去规范化。此结构使用户可以输入同义词、缩写、本地化术语、正式临床名称或自然语言短语。
搜索文档重复概念上下文,使每个搜索结果都自成体。结果可以显示匹配的术语、首选显示、语义类别、活动状态、发布和层次范围,而无需为每个候选获取完整的概念文档。
{ "conceptId": "44054006", "descriptionId": "116680003", "term": "Type 2 diabetes mellitus", "preferredTerm": "Type 2 diabetes mellitus", "fsn": "Type 2 diabetes mellitus (disorder)", "semanticTag": "disorder", "semanticTagKey":"disorder", "termType": "synonym", "preferred": true, "languageCode": "en", "definitionStatusId": "900000000000074008", "moduleId": "900000000000207008", "effectiveTime": "20020131", "parentIds": ["73211009"], "ancestorIds": ["404684003", "73211009"], "topRoots": ["404684003"], "areaTags": ["disorder"], "releaseId": "20260601", "releaseDate": "2026-06-01T00:00:00.000Z", "embedText": "Type 2 diabetes mellitus | disorder | ..." }
snomed-term-search 集合包含以下相关字段:
conceptId,descriptionId:链接回到概念和具体说明。term、preferredTerm、fsn:提供匹配的术语和概念上下文,以便搜索结果自成体。semanticTag,semanticTagKey、termType、preferred:提供过滤器和排名信号。parentIds,ancestorIds、topRoots、areaTags:范围过滤器,无需连接回snomed-irbd。releaseId,releaseDate、effectiveTime:提供发布范围的搜索和发布维护可见性。embedText: 包含 MongoDB 自动嵌入用于向量搜索的字段。
此片段说明了最重要的设计选择:搜索投影是词级别的。它展示了为什么搜索“高血糖”仍然可以返回规范概念“糖尿病”
借助自动嵌入,您只需存储人类可读的 embedText 字段,MongoDB 向量搜索会自动为该字段生成并维护嵌入。您不需要单独的嵌入管道或向量存储,因为语义层位于同一集合上。
grounded_notes 集合
在查看后使用 grounded_notes 存储应用程序输出。这些文档不是源术语数据。每个文档存储以下数据:
源文本
所选的 SNOMED CT 概念
证据范围
断言上下文,例如存在或不存在
主题上下文,例如患者或家属
查看状态
祖先 ID
下面的示例展示了这种形状。
{ "tenantId": "demo-hospital", "languageCode": "en", "text": "Patient with type 2 diabetes mellitus.", "codings": [ { "conceptId": "44054006", "system": "http://snomed.info/sct", "display": "Type 2 diabetes mellitus", "semanticTag": "disorder", "role": "principal", "target": "Condition.code", "assertion": "present", "subject": "patient", "status": "accepted", "evidence": { "text": "diabetes mellitus tipo 2" }, "ancestorIds": ["44054006","75934005"] } ], "recordedAt": "2026-07-07T16:22:47.210Z", "createdAt": { "$date": "2026-07-07T16:22:47.210Z" } }
这种设计可以将临床文本转变为可查询的临床含义。应用程序可以在以后搜索包含某个概念或 SNOMED CT 层次结构中低于该概念的任何更具体概念的已查看笔记。每个编码都保留其证据,因此审核人员可以将每个代码追溯到产生该代码的精确文本和上下文,这支持 Atlas 审核和可信的下游使用。
遥测集合
对于搜索事件、层次结构请求、注释基础活动、反馈和诊断,使用单独的 telemetry 集合。将遥测数据保持在概念数据模型之外。
构建解决方案
公共存储库包括应用程序代码、脚本和示例数据集。许可用户可以用自己的 SNOMED CT发布文件替换示例数据集。
先决条件
启用 MongoDB Search 的 MongoDB Atlas 集群。
访问获得许可的 SNOMED CT 版本或用于演示的小型示例数据集。
用于演示应用程序的 Node.js 和 npm。
可选:MongoDB 向量搜索自动嵌入配置以进行语义搜索。
可选:用于混合模式的 Voyage 重新排序密钥或其他配置的重新排序器。
可选:用于有界提取和候选消除模糊性的 LLM 网关。
步骤
构建术语侧车
从标准概念集合中生成 snomed-term-search。辅助应用程序按照发布、语言、说明和概念存储一个活跃的术语文档。它重复关键概念上下文,因此每个结果卡都无需再次加入概念集合。
# Curated demo branches TERM_PROJECTION_SCOPE=demo npm run terms:rebuild # Full licensed local release TERM_PROJECTION_SCOPE=full npm run terms:rebuild # Replace documents while preserving index definitions when possible npm run terms:rebuild:replace
创建 MongoDB 索引
为概念查找和层次结构扩展创建 btree 索引。为词汇术语查找创建 MongoDB Search 索引。如果使用语义模式或混合模式,则为语义搜索创建 MongoDB 向量搜索索引。
npm run indexes:build
使用以下推荐的源集合索引:
db.getCollection("snomed-irbd").createIndex({ releaseId: 1, conceptId: 1 }) db.getCollection("snomed-irbd").createIndex({ releaseId: 1, active: 1, conceptId: 1 }) db.getCollection("snomed-irbd").createIndex({ releaseId: 1, inferredAncestorIds: 1, active: 1 })
语义搜索使用 MongoDB 向量搜索自动嵌入,并以 voyage-4 作为默认模型。混合模式添加 Voyage rerank-2.5重排序器。对于没有自动嵌入的集群,存在手动 Voyage 嵌入回退。
配置语义搜索 & 重新排序
语义搜索和混合搜索使用 MongoDB 向量搜索自动嵌入。在配置了集群上的嵌入模型的 embedText 字段上创建向量搜索索引。
混合模式添加了可选的 Voyage 重排名器;将 VOYAGE_API_KEY 设置为可用。如果没有密钥,混合搜索仍可使用,并回退到融合顺序。重排名器会尝试您配置的基本 URL,然后尝试与 https://ai.mongodb.com/v1 对应的 MongoDB 托管 Voyage 网关,然后尝试 Voyage 自己的原生平台终结点。
运行演示应用程序
npm install npm run dev
使用简洁的 .env.local 文件。将操作默认值保存在代码或配置文件中,而不是作为环境变量的长列表。
MONGODB_URI= MONGODB_DB=terminology VOYAGE_API_KEY= ENABLE_LLM_GROUNDING=false LLM_BASE_URL= LLM_API_KEY= LLM_AUTH_HEADER=api-key LLM_GROUNDING_MODEL=gpt-5.5 # Semantic / hybrid search MONGODB_VECTOR_MODE=autoEmbed MONGODB_VECTOR_INDEX=snomed_voyage_idx MONGODB_VECTOR_AUTO_EMBED_MODEL=voyage-4 VOYAGE_API_KEY= VOYAGE_RERANK_MODEL=rerank-2.5
关键要点
在 MongoDB Atlas 中实现 SNOMED CT:通过支持搜索、层次结构、关系和应用工作流的以文档为中心的运营模型服务图形化临床术语。
统一术语导航和语义搜索:使用 MongoDB Search 和 MongoDB Vector Search 帮助用户从同一个 Atlas 支持的服务中查找、检查和确定 SNOMED CT 概念。
使用查看证据对临床文本进行基础处理:使用术语服务从临床笔记中提出 SNOMED CT 候选词,然后将查看过的编码与证据、上下文和祖先路径一起存储。
作者
Francesc Mateu Amengual, MongoDB
Giovanni Rodríguez, MongoDB
Diego Canales, MongoDB
了解详情
MongoDB Search 概述:了解 MongoDB 如何支持全文搜索、自动完成、过滤、评分和搜索驱动的应用程序体验。
MongoDB 向量搜索概述:了解 MongoDB 如何在 Atlas 内部支持语义检索和向量搜索。
获取 SNOMED CT:查看组织如何访问权限SNOMED CT 并了解其国家或地区的许可路径。
SNOMED CT 概念、描述和关系:了解此解决方案映射到MongoDB文档的基本 SNOMED CT 构建基块。