评估实时供应商风险MongoDB Atlas 。使用由...提供支持Voyage AI提供支持的多模式搜索来发现替代供应商。
行业: 零售
产品: MongoDB Atlas、Voyage AI、 MongoDB自动嵌入、 MongoDB Vector Search、 MongoDB Atlas Charts
解决方案概述
全球供应链持续面临宏观扰动。地缘政治、天气事件和后勤瓶颈在一夜之间威胁到运营的连续性。
传统的企业资源规划 (ERP) 系统无法适应这些快速变化。它们将关键供应商信息隐藏在严格的关系表、静态电子表格以及不可查询的 PDF 合同和电子邮件中。当发生中断时,采购团队会花费数小时或数天的时间跨断开连接的孤岛手动收集数据。这种延迟会导致缺货、意外成本和失去消费者信任。
在MongoDB Atlas上构建现代化、统一的智能层,将供应商管理与传统 ERP 核心解耦。
该解决方案将MongoDB Atlas视为一个融合数据存储,即一个同时充当操作存储、向量存储、搜索引擎和代理内存的平台。自主代理推断实时中断所需的每个上下文(供应商的位置、其未结采购订单、证书和先例历史记录)都位于同一集合中,在相同的访问权限控制下进行一次查询。
在情报数据层之上,以下后端模块将原始中断信号转化为经过审查、人工批准的决策:
ingestion_engine:确定性规范化层,没有 LLM、代理或推理循环。它将原始外部信号(例如地缘政治、气候和物流数据)转换为一致的内部格式,并将其写入Atlas。它提供了所有下游流程所依赖的干净点。risk_evaluator:LangGraph代理根据实时供应商和采购订单数据读取这些信号,在地理空间上匹配风险,计算动态风险优先级数字 (RPN) 以及对agent_memory中存储的历史先例进行推理,然后再将通俗易懂的风险摘要写回Atlas。
通过在MongoDB Atlas上统一运营数据和AI功能,您可以近乎实时对外部条件做出反应,保持业务敏捷。
参考架构
代理使用到达其上下文窗口的所有内容进行推理,而不是使用它所知道的所有内容进行推理。每个代理决策都取决于事先的数据过滤。数据层首先对信息进行显示、过滤和排序。将MongoDB Atlas视为此上下文层。在特工进行推理之前, Atlas会决定哪些证据值得标记。
通过实时中断进行推理的代理运行地理空间匹配、向量搜索、全文搜索、重新排名和内存查找。单独的数据库、向量存储和搜索引擎之间的往返会减慢代理的速度。在MongoDB Atlas聚合管道内运行所有查询。一个API可替换整个堆栈。
上下文控制也是费用控制。多代理系统消耗的令牌比单个聊天多 15 倍。冗余检索会增加成本。控制模型上下文以控制预算。
供应商、中断信号和合合规证据不断变化。使用灵活的文档模型将此变体存储在一个集合中。
全球供应链以多种语言生成证据。 Voyage AI将多语言证据映射到一个共享向量空间, Atlas自动嵌入使这些向量保持同步。多语言检索成为原生数据库属性,而不是外部服务。
以下架构图和步骤概述了端到端工作流程和关键数据库功能。追踪信号从原始外部源一直到批准的替代供应商。
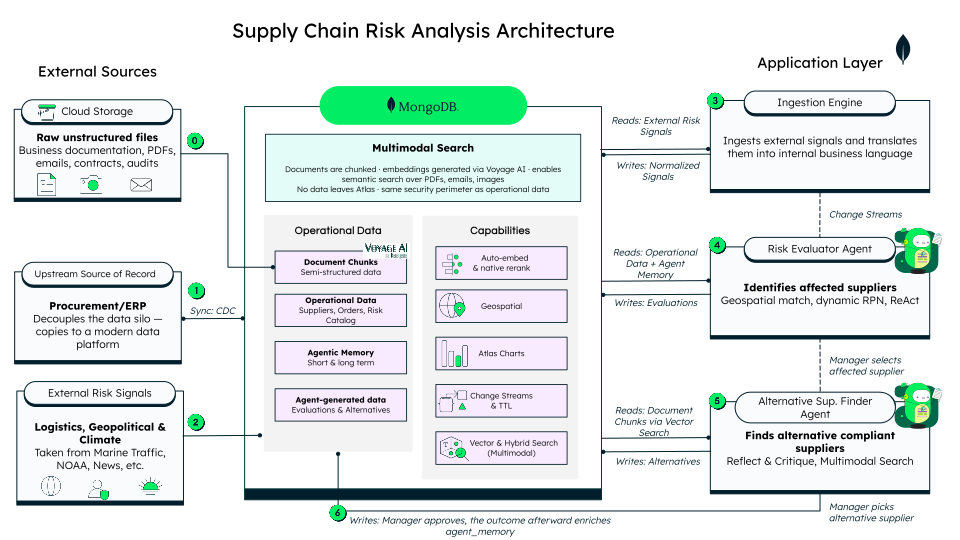
图 1。高级概述
步骤 0:非结构化文档摄取
将原始的非结构化业务文档(例如 PDF、电子邮件、合同和Atlas 审核报告)从云存储直接存储到MongoDB Atlas中。 Voyage AI多模态嵌入模型可自动将分块文档嵌入任何语言,从而启用数据库内安全的多模态和多语言搜索。
步骤 1:与 ERP 分离
ERP 执行业务规则并拥有事务工作流程。将这些规则保留在 ERP 中。通过变更数据捕获 (CDC) 将其供应商和订单数据流式传输到Atlas ,并让代理从该副本中读取,而不是直接查询 ERP。
解耦允许新功能在自己的时间轴上发展到 ERP 之上。
步骤 2—3:外部风险信号引入
将现实世界的物流、地缘政治和气候数据提取到操作数据层。这些外部风险数据的来源包括 MarineTraffic、美国国家海洋和大气管理局 (NOAA) 以及全球新闻源等。在此解决方案中,摄取引擎为每个会话生成三个演示触发信号以初始化流程。
通过摄取引擎处理原始外部信号。该引擎将外部中断事件转换为规范化的内部业务语言,并将结构化信号写入MongoDB Atlas。
步骤 4:供应商风险评估(风险评估器代理)
当规范化信号到达MongoDB Atlas时,触发风险评估器代理。代理会读取操作数据和 agent_memory,执行地理空间匹配 ($geoWithin),计算动态 RPN,然后将评估结果写回数据库。
步骤 5:替代供应商发现(替代供应商查找代理)
当经理选择受影响的供应商时,激活 另类查找器代理。该代理使用多模态向量搜索、混合搜索($rankFusion) 和原生重排名($rerank) 查询文档段,以查找合规的替代供应商,然后将候选选项写回MongoDB Atlas。
步骤 6:内存扩充
risk_evaluator 使用动态风险优先级编号 (RPN) 对每次中断进行评分。在代理最终确定分数之前,内存会直接输入该分数。
每次评估都会查询 agent_memory 两次:一次是针对供应商自身的历史记录,另一次是针对按风险类型划分的跨供应商先例。 alternative_finder 在采购方面遵循相同的逻辑。它会检查候选供应商的追踪记录,并在对候选供应商进行排名之前从类似供应商中获取语义先例。
Atlas可以原生处理这两种内存结构。记忆有两种形式:结构化事实(“确实发生过这样的事情”)和语义相似性(“发生过类似的事情”)。大多数架构将这些信息分割到两个系统中:一个用于存储事实的数据库,一个用于存储相似性的向量存储。在Atlas中,一个集合同时包含两者。精确的 find 和 $vectorSearch查询命中相同的文档,因为结构化字段和嵌入式文本并排存在。
智能供应中心工作流程
以下泳道图显示了在中断期间控制如何跨系统层移动。
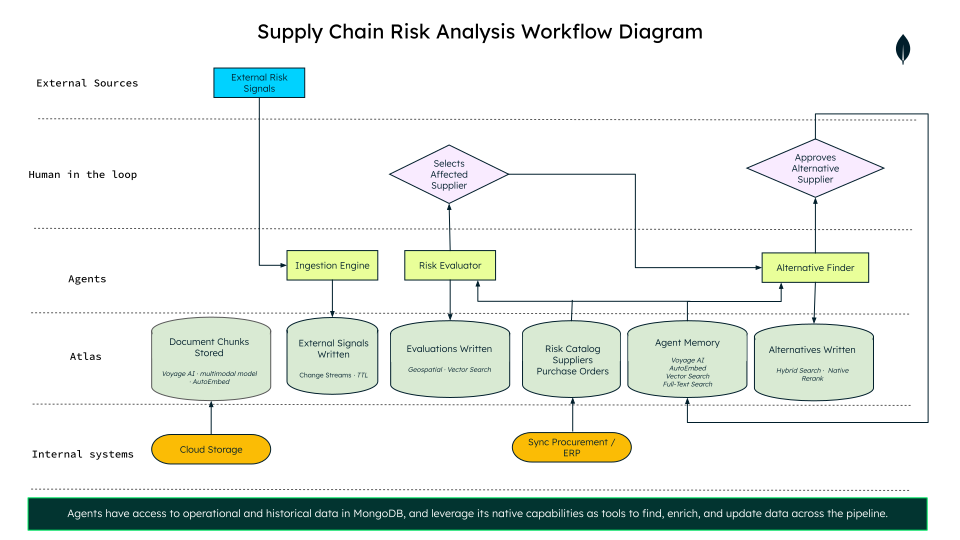
图 2。供应链风险分析工作流程
当外部风险信号到达时,ingestion_engine 将这些信号标准化到MongoDB Atlas中,从而触发 risk_evaluator代理自动计算供应商风险评分。然后,工作流程在第一个人工决策点暂停,采购经理在该决策点查看标记的风险评分并选择受影响的供应商。此选择会激活 alternative_finder代理,以从MongoDB Atlas中检索、Atlas 审核和重新排名替换候选对象。最后,在第二个人工决策点,经理审查预先出现的、引用的合规文档,以批准替代供应商。这样就无需在孤立的系统、文件格式和外语之间进行手动搜索。
数据库内多模式和多语言智能
全球供应链管理需要搜索以多种语言编写的非结构化、多格式业务文档,例如 PDF 合同、贸易协议、合规证书和Atlas 审核报告。
为处理这种复杂性, MongoDB Atlas将 Voyage AI多模式向量嵌入直接与操作数据存储在一起,以显示关键的合规见解,否则这些见解将保留在无法搜索的文档孤岛中:
Atlas自动嵌入
对非结构化供应商合规记录和合同(例如 PDF 合同、扫描的Atlas 审核报告和贸易协议)进行分块和嵌入,并将其存储在MongoDB Atlas中。
创建 autoEmbed 类型的向量搜索索引,以对文档数据段启用自动嵌入。这可确保在使用配置的 Voyage AI模型插入或更新数据时自动生成向量嵌入。
db.suppliers.createSearchIndex( "suppliers_autoembed_index", "vectorSearch", { fields: [ { type: "autoEmbed", modality: "text", path: "auto_embed_text", model: "voyage-4" }, { type: "filter", path: "region" }, { type: "filter", path: "product_categories" }, { type: "filter", path: "status" } ] } );
自动嵌入消除了外部嵌入服务和复杂的 ETL 管道,同时将数据安全地保持在MongoDB Atlas安全边界内。
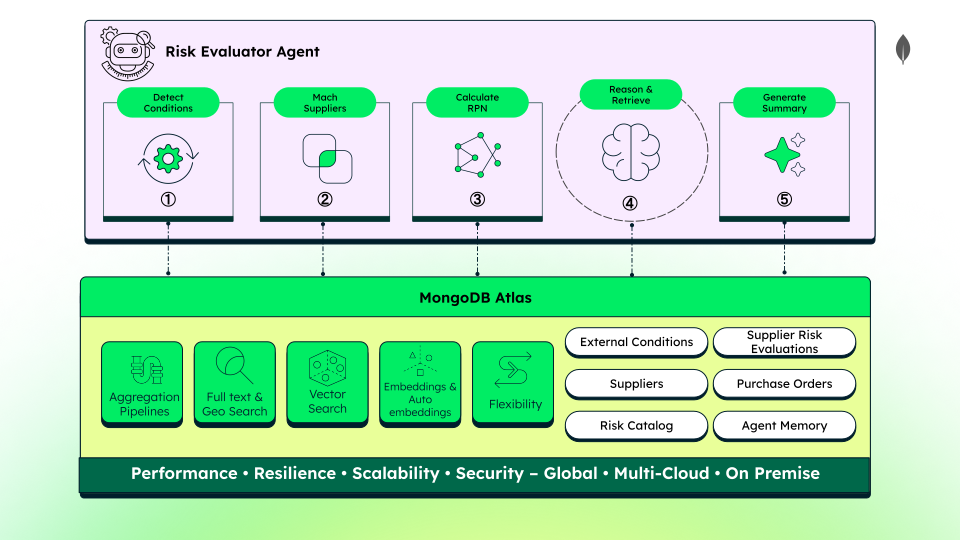
图 3。风险评估器代理
利用聚合管道、搜索功能和灵活的文档模型对这些数据段执行高级查询,并对摄取的数据执行合规验证。
多模态嵌入搜索和检索
利用存储在MongoDB Atlas中的文档数据段,使用混合搜索查询非结构化数据。构建动态搜索查询,在中断期间寻找替代合作伙伴。将区域预过滤器与详细的语义查询字符串相结合。示例,搜索“位于关税中立贸易区域且具有有效质量认证和紧急交付承诺的包装材料制造商”。
在单个MongoDB Atlas聚合管道中执行此搜索。使用 $rankFusion 混合搜索将向量相似度与全文搜索相关性合并。这种混合查询可同时匹配语义概念和确切的关键字。
使用 Voyage AI重排序模型在融合后链接原生重排序阶段 ($rerank),以提高检索准确性。数据库内交叉编码器会联合评估候选数据段和查询,以计算精确的相关性分数。在管道中运行重新排序可将敏感的供应商记录安全地保留在数据库范围内。
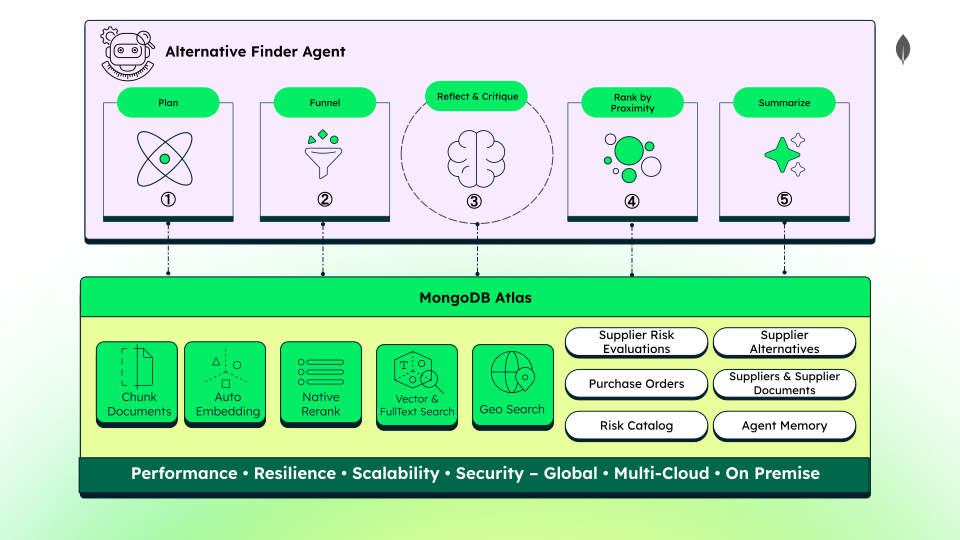
图 4。替代查找器供应商代理
多语言智能
搜索和分析任何语言的全球供应商文档,而无需构建自定义翻译管道。 Voyage AI多语言模型将不同语言的文本映射到共享向量空间。
以英语查询数据库,检索以阿拉伯语、西班牙语、中文或越南语撰写的相关合同或证书。将这些多语言嵌入原生存储在MongoDB Atlas中,以近乎零延迟的方式执行跨语言语义搜索。
将您的全球供应商文档整合到一个多语言搜索索引中,以简化您的国际合规工作流程并删除翻译开销。
数据模型方法
僵化数据库将不兼容的数据格式强制放入平面表中。现实世界的供应链实体不断变化,并且具有混乱且不断变化的结构。灵活的文档原生模式可让数据模型按照业务节奏发展。在单个API下原生存储操作记录、向量嵌入和坐标。避免严格的数据库迁移造成的开发停机。
该解决方案使用八个集合来管理风险和替代采购。
集合名称 | 用途 |
|---|---|
| 捕获具有TTL到期时间的实时外部风险信号。 |
| 对静态故障模式和影响分析 (FMEA) 风险评分和阈值进行编码。 |
| 使用GeoJSON位置存储供应商主记录。 |
| 跟踪活跃订单以量化财务风险。 |
| 保存分块的、自动嵌入的供应商合同和证书。 |
| 存储历史风险事件,以便进行情境学习。 |
| 包含动态 RPN 分数和自然语言风险摘要。 |
| 在等待人工批准的情况下保留排名候选的入围名单。 |
有关文档模型的完整概述,请参阅解决方案的后端自述文件。检查 external_conditions 和 supplier_documents 集合,探索文档模型的好处。
external_conditions
external_conditions集合作为实际风险警报的入口点,存储规范化的中断。不同的风险类型可共存于同一集合中,而无需实施严格的模式。
以下是文档在所有风险警报中股票的字段。
{ "condition_id": "COND-20260505-0941", "risk_type_triggered": "logistics_disruption", "condition_score": 0.76, "has_physical_location": true, "detected_at": "2026-05-05T09:41:00Z", "valid_until": "2026-05-08T09:41:00Z" }
气候和后勤警报存储物理位置和影响半径的精确坐标。坐标必须是GeoJSON Point对象才能对数据运行地理空间查询。使用 $geoWithin 查找完全位于指定受影响区域内的供应商。
{ // other shared fields "epicentre": { "type": "Point", "coordinates": [114.1095, 22.5229] }, "impact_radius_km": 80, "has_physical_location": true, }
地缘政治警报通过大量受影响地区追踪区域边界。要查询受影响地区内的供应商,请使用 $in操作符。
{ // other shared fields "affected_regions": ["CN", "HK"], "has_physical_location": false, }
ingestion_engine 将各种传入的API有效负载规范化为前面的代码示例所示的干净文档结构。
多态性允许您同时查询两种信号类型。在单次数据库调用中使用 $geoWithin 和 $in 执行统一地理匹配查询。这种整合可简化应用程序逻辑,并防止出现耗尽性能的查询分割。
provider_documents
supplier_documents集合包含可搜索的非结构化商业文档。以下文档示例说明了此集合布局:
{ "supplier_id": "SUP-882", "doc_type": "quality_certification", "filename": "certificado_SUP882_2024.pdf", "chunk_index": 2, "chunk_total": 4, "chunk_text": "ISO 9001:2015 and IATF 16949:2016. Valid 2024-11-01 to 2027-10-31...", "page_ref": 1, "valid_until": "2027-10-31T00:00:00Z", "embedding": [/* 1024 dimensions */] }
chunk_text:存储原始 PDF 文件中 400 到 600 词元的文本片段。这种高保真分块将大型合同分解为重叠的部分,以保留关键条款。它将非结构化文档内容与操作数据库记录一起原生存储。embedding:存储由 Voyage AI生成的 1024 维向量。多语言模型将多种语言映射到单个共享向量空间。这种对齐方式允许您使用英语搜索字符串查询西班牙语或德语文档。valid_until:追踪合规认证到期日期,以使过时的供应商记录自动过期。
构建解决方案
部署代理供应链风险解决方案。
先决条件
开始之前,确保您拥有以下帐户、密钥和软件:
MongoDB Atlas帐户: Atlas 集群(M10层级或更高)。
人择API密钥:用于支持 LLM 推理和规划的有效API密钥。
Docker Desktop:运行前端和后端服务所需的应用程序。
配置数据库并为其设定种子
设置数据库,导入种子文件,并构建运行演示所需的索引。
登录MongoDB Atlas并在Atlas 集群中创建名为 retail-supply-chain-risk 的数据库。
从 docs/ 设置 /collections 文件夹导入五个种子JSON文件:
在 Collections 屏幕上选择新数据库。
单击加号 (+) 图标或单击 Create Collection 以分别添加五个集合。
选择每个集合,单击 Import Data,然后上传相应的JSON文件。
创建运行向量搜索、混合搜索和地理空间查询所需的地理空间和搜索索引。索引配置位于 docs/ 设置/indexes 文件夹中。执行以下步骤以创建每个索引。
mongosh "<your-connection-string>" --file suppliers-location-2dsphere.js mongosh "<your-connection-string>" --file external_conditions-epicentre-2dsphere.js mongosh "<your-connection-string>" --file suppliers_autoembed_index.js mongosh "<your-connection-string>" --file agent_memory_autoembed_index.js mongosh "<your-connection-string>" --file supplier_documents_vector_index.js mongosh "<your-connection-string>" --file supplier_documents_fulltext_index.js
克隆存储库并配置环境变量
从 GitHub 克隆项目存储库。
git clone https://github.com/mongodb-industry-solutions/retail-supply-chain-management.git
配置前端后端环境变量:
将示例前端/EXAMPLE.env 复制到同一目录的新
.env文件中。将占位符值替换为您的配置详细信息。将BACKEND_URL设置为http://127.0.0.1:8000。复制示例后端/.env。示例到同一目录中的新
.env文件。将占位符值替换为您的配置详细信息。将您的 Anthropic API密钥添加为LLM_API_KEY。
构建并启动应用程序
使用Docker Compose 或分别运行后端和前端来编译并启动多服务环境。
要使用Docker Compose 启动应用程序,运行:
make build
要手动运行服务,请先启动前端:
cd frontend npm i npm run dev
然后,导航到根目录并启动后端:
make uv_init make uv_sync source backend/.venv/bin/activate cd backend uvicorn main:app --reload
在浏览器中打开位于 http://localhost:3000 的前端仪表盘。访问 http://localhost:8000/docs 查看交互式API文档。
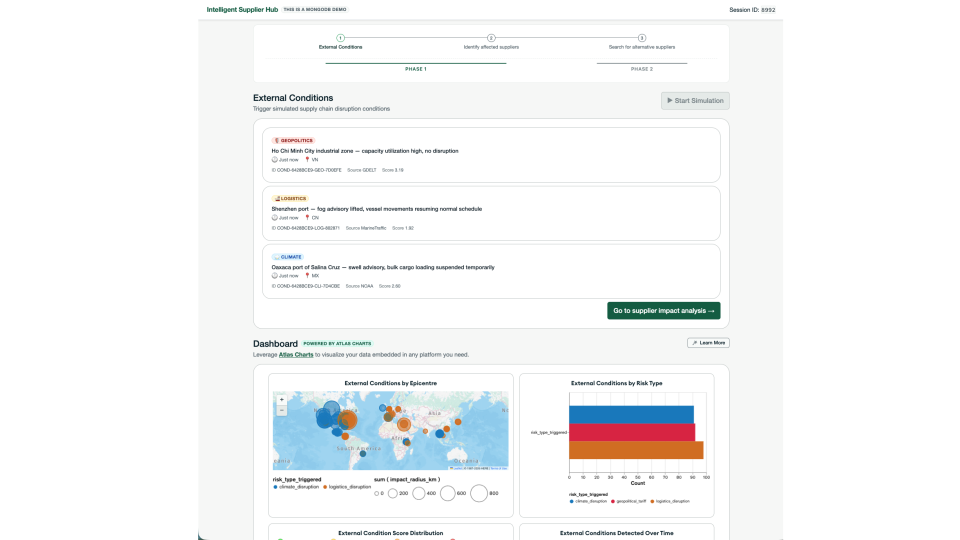
图 5。智能供应商中心系统
关键要点
该解决方案演示了构建AI驱动的供应链应用程序的几种关键架构模式:
构建统一智能层以控制成本:通过在MongoDB Atlas中创建统一智能层,将供应商管理与严格的遗留系统解耦。使用 CDC 同步来自 ERP 的数据,从而将操作数据、向量嵌入和代理内存整合到一个平台上。这种结构允许代理读取当前状态,而无需直接查询 ERP。读取同一文档进行操作检查和检索,然后在法学硕士收到数据之前,使用地理空间筛选器、混合搜索和重新排名来确定性地缩小数据范围。控制到达模型的内容可以优化推理性能并降低执行成本。
以多种语言统一非结构化数据:将 PDF 合同、电子邮件和扫描的Atlas 审核报告等非结构化文档与结构化供应商记录存储在一起。使用 Voyage AI将这些不同的格式嵌入到单个MongoDB集合中。这种统一的布局支持跨文本和图像进行语义查询,从而简化了检索架构,而无需维护单独的数据库系统。此外,多模态嵌入模型启用跨语言查询,而无需翻译开销。
将搜索和重排名保持在Atlas内部:将向量搜索、全文搜索和原生重排名整合到单个数据库查询中。使用
$rankFusion运行混合搜索,并直接在聚合管道内原生$rerank与 Voyage AI链接起来。这样就消除了额外的网络跃点、 API延迟和自定义档案管理。
作者
Florencia Arin, MongoDB
Angie Guemes, MongoDB
Ronan Conlon, MongoDB
Daniel Jamir, MongoDB