Avalie o risco do fornecedor em tempo real com o MongoDB Atlas. Descubra fornecedores alternativos usando pesquisa multimodal com tecnologia do Voyage AI.
Casos de uso: Inteligência artificial, pesquisa inteligente
Setores: Varejo
Produtos: MongoDB Atlas, Voyage AI, MongoDB embedding automatizado, MongoDB pesquisa vetorial, MongoDB Atlas Charts
Visão Geral da Solução
As cadeias de suprimentos globais enfrentam constantes macro-disrupções. Geopolítica, eventos climáticos e gargalos logísticos ameaçam a continuidade operacional da noite para o dia.
Sistemas legados de Planejamento de Recursos Empresariais (ERP) não conseguem se adaptar a essas mudanças rápidas. Eles prendem informações críticas de fornecedores dentro de tabelas relacionais rígidas, planilhas estáticas e contratos e e-mails em PDF não consultáveis. Quando ocorre uma interrupção, as equipes de aquisição gastam horas ou dias coletando dados manualmente em silos desconectados. Esse atraso leva à falta de estoque, custos inesperados e perda de confiança do consumidor.
Desacople o gerenciamento de fornecedores do seu ERP legado core criando uma camada de inteligência unificada modernizada no MongoDB Atlas.
Esta solução trata o MongoDB Atlas como um armazenamento de dados convergente—uma plataforma que funciona simultaneamente como seu armazenar operacional, armazenar de vetores, mecanismo de pesquisa e memória do agente. Cada pedaço de contexto que um agente autônomo precisa para raciocinar sobre uma interrupção ao vivo (a localização de um fornecedor, seus pedidos de compra abertos, certificados e histórico de precedentes) está a uma query de distância, na mesma coleção, sob os mesmos controles de acesso.
Além da camada de dados de inteligência, os seguintes módulos de backend transformam um sinal de interrupção bruto em uma decisão verificada e aprovada por humanos:
ingestion_engine: Camada de normalização determinística sem LLM, agente ou loop de raciocínio. Ele transforma sinais externos brutos (como dados geopolíticos, climáticos e de logística) em um formato interno consistente e os grava no Atlas. Isso fornece o ponto de partida limpo do qual todos os processos a jusante dependem.risk_evaluator: agente LangGraph que lê esses sinais em relação a dados de fornecedores e pedidos de compra em tempo real, correlaciona a exposição geograficamente, calcula um Número de Prioridade de Risco (RPN) dinâmico e analisa precedentes históricos armazenados noagent_memoryantes de gravar um resumo de risco em linguagem simples de volta ao Atlas.alternative_finder: Agente LangGraph que, uma vez que um gerente sinaliza um fornecedor para ação, pesquisa o corpus de documentação do fornecedor com recuperação híbrida de vetor e texto completo, reclassifica candidatos, audita cada reivindicação em relação às evidências citadas e classifica as opções restantes por proximidade, deixando a decisão final para um humano.
Ao unificar dados operacionais e funcionalidades de IA no MongoDB Atlas, você reage a condições externas em quase tempo real e mantém sua empresa Agile.
Arquiteturas de referência
Um agente raciocina com o que chega à sua janela de contexto, não com tudo o que sabe. Cada decisão do agente depende de um filtro de dados prévio. A camada de dados primeiro apresenta, filtro e classifica as informações. Trate o MongoDB Atlas como esta camada de contexto. O Atlas decide quais evidências merecem tokens antes que os agentes raciocinem.
Um agente que raciocina sobre interrupções em tempo real executa correspondência geoespacial, pesquisa vetorial, pesquisa de texto completo, reclassificação e pesquisas de memória. Idas e vindas entre banco de dados separados, armazenar de vetor e mecanismos de busca atrasam os agentes. Executar todas as consultas dentro dos pipelines de agregação do MongoDB Atlas. Uma API substitui toda a pilha.
O controle de contexto também é o controle de custo. Sistemas multiagentes consomem até 15x mais tokens do que chats únicos. A recuperação redundante aumenta os custos. Controle o contexto do modelo para controlar seu orçamento.
Fornecedores, sinais de disrupção e evidências de compliance mudam constantemente. Use o document model flexível para armazenar essa variação em uma coleção.
As cadeias de suprimentos globais geram evidências em muitas linguagem. O Voyage AI mapeia evidências multilíngues em um espaço vetorial compartilhado, e o Atlas Auto-Embedding mantém esses vetores sincronizados. A recuperação multilíngue torna-se uma propriedade nativa do banco de dados em vez de um serviço externo.
O diagrama de arquitetura e as etapas a seguir descrevem o fluxo de trabalho de ponta a ponta e as principais funcionalidades do banco de dados. Rastreie sinais de fontes externas brutas até fornecedores alternativos aprovados.
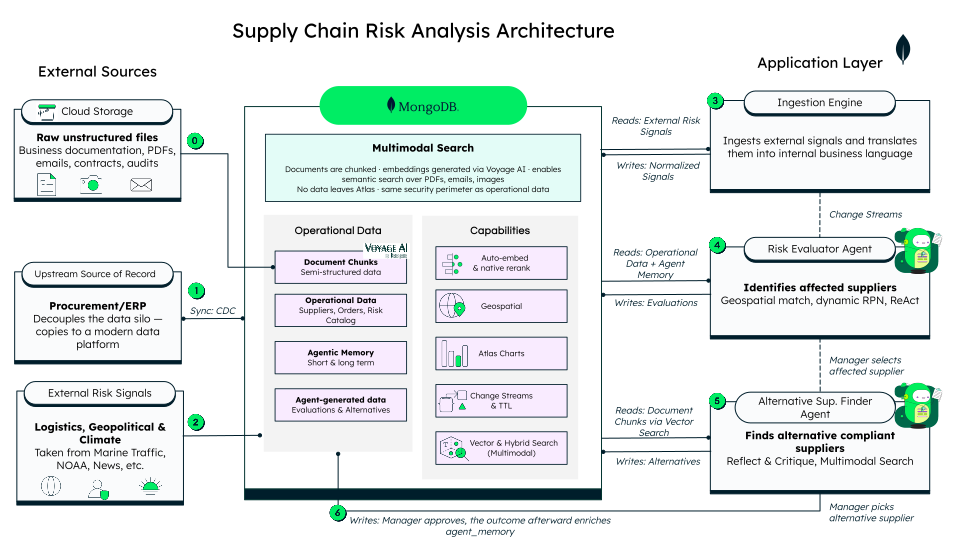
Figura 1. Visão geral de alto nível
Etapa 0: ingestão de documentos não estruturados
Armazene documentação de negócios bruta e não estruturada, como PDFs, e-mails, contratos e relatórios de auditar, do armazenamento em nuvem diretamente no MongoDB Atlas. O modelo de embedding multimodal da Voyage AI incorpora automaticamente documentos em partes em qualquer linguagem para permitir uma pesquisa multimodal e multilíngue segura no banco de dados.
Etapa 1: Desacoplar do ERP
Um ERP força regras de negócio e possui fluxos de trabalho transacionais. Deixe essas regras no ERP. Envie os dados de fornecedores e pedidos para o Atlas por meio do Change Data Capture (CDC) e permita que os agentes leiam dessa cópia em vez de consultar o ERP diretamente.
O desacoplamento permite que novas funcionalidades evoluam acima do ERP em seu próprio cronograma.
Etapa 2—3: Ingestão de sinais de risco externos
Obtenha dados logísticos, geopolíticos e climáticos do mundo real para a camada de dados operacionais. Esses dados de risco externos são provenientes de fontes como MarineTraffic, National Oceanic and Atmospheric Administration (NOAA) e feeds de notícias globais. Nesta solução, o mecanismo de ingestão gera três sinais de trigger de demonstração por sessão para inicializar o fluxo.
Processar sinais externos brutos por meio do mecanismo de ingestão. O mecanismo traduz eventos de interrupção externos em linguagem de negócios interna normalizada e grava sinais estruturados no MongoDB Atlas.
Etapa 4: Avaliação de Risco do Fornecedor (Agente Avaliador de Risco)
trigger o Risk Evaluator agente quando sinais normalizados chegarem ao MongoDB Atlas. O agente lê dados operacionais e agent_memory, realiza correspondência geoespacial ($geoWithin), calcula RPN dinâmico e grava avaliações de volta no banco de dados.
Etapa 5: Descoberta de fornecedor alternativo (Agente localizador de fornecedores alternativos)
Ative o agente alternative_finder quando um gerente selecionar um fornecedor afetado. O agente faz query de partes de documentos usando pesquisa vetorial multimodal, pesquisa híbrida ($rankFusion) e reranking nativo ($rerank) para encontrar fornecedores alternativos compatíveis e, em seguida, grava as opções candidatas no MongoDB Atlas.
Etapa 6: Enriquecimento de Memória
O risk_evaluator avalia cada interrupção com um Número de Prioridade de Risco (RPN) dinâmico. A memória alimenta diretamente essa pontuação antes que o agente a finalize.
Ele consulta agent_memory duas vezes por avaliação: uma vez para o histórico do próprio fornecedor e uma vez para precedentes entre fornecedores por tipo de risco. O alternative_finder segue a mesma lógica no lado da aquisição. Ele verifica o registro de um candidato e extrai precedentes semânticos de fornecedores semelhantes antes de classificar os candidatos.
O Atlas gerencia ambas as estruturas de memória nativamente. A memória assume duas formas: fato estruturado ("isso aconteceu exatamente") e similaridade semântica ("algo parecido aconteceu"). A maioria das arquiteturas dividem-nos em dois sistemas: um banco de dados para fatos e um vector store para similaridade. No Atlas, uma coleção contém ambos. Uma query exata find e uma $vectorSearch atingem os mesmos documentos porque campos estruturados e texto incorporado coexistem lado a lado.
Fluxo de trabalho do Hub de Fornecimento Inteligente
O diagrama de raias a seguir mostra como o controle se move entre as camadas do sistema durante uma interrupção.
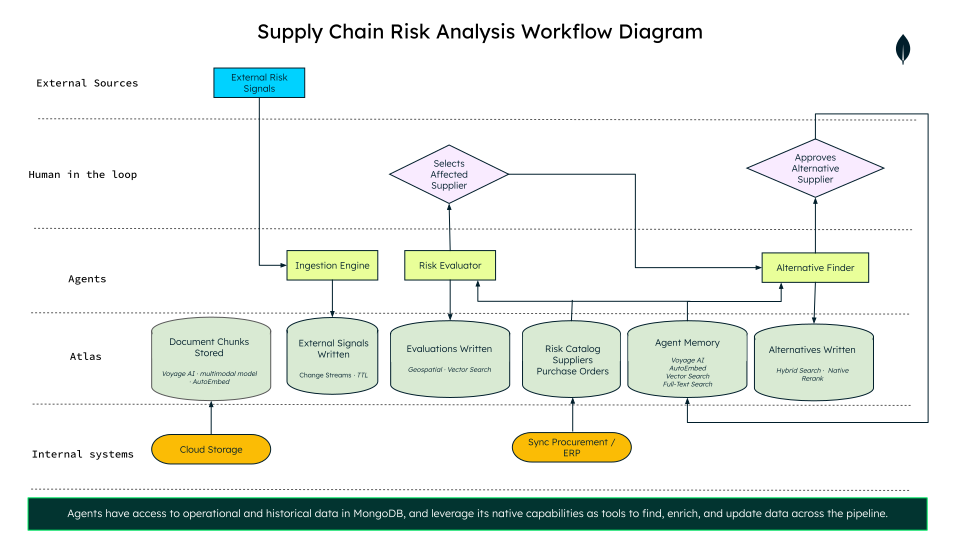
Figura 2. Fluxo de trabalho de análise de risco da cadeia de suprimentos
Quando os sinais de risco externos chegam, o ingestion_engine os normaliza no MongoDB Atlas, acionando o agente risk_evaluator para calcular automaticamente as pontuações de risco do fornecedor. O fluxo de trabalho então pausa no primeiro ponto de decisão humano, onde um gerente de compras revisa as pontuações de risco sinalizadas e seleciona um fornecedor afetado. Esta seleção ativa o agente alternative_finder para recuperar, auditar e reclassificar candidatos de substituição do MongoDB Atlas. Finalmente, no segundo ponto de decisão humana, o gerente revisa documentos de compliance pré-identificados e citados, fornecidos para aprovar um fornecedor alternativo. Isso elimina a necessidade de pesquisas manuais em sistemas isolados, formatos de arquivo e idiomas estrangeiros.
Inteligência multimodal e multilíngue no banco de dados
O gerenciamento global da cadeia de suprimentos exige a pesquisa de documentação comercial não estruturada e de vários formatos, como contratos em PDF, acordos comerciais, certificados de compliance e relatórios para auditar, escrita em várias linguagens.
O MongoDB Atlas lida com essa complexidade ao armazenar embeddings de vetores multimodais da Voyage AI diretamente junto com dados operacionais para revelar perspicácias críticas de compliance que, de outra forma, permaneceriam em silos de documentos não pesquisáveis:
Atlas Embedding automático
Dividir em partes e incorporar registros e contratos de compliance de fornecedores não estruturados, como contratos em PDF, relatórios digitalizados para auditar e acordos comerciais, e armazená-los no MongoDB Atlas.
Crie um índice de pesquisa vetorial com o tipo autoEmbed para habilitar Embedding Automatizado nas partes do documento. Isso garante que os embeddings vetoriais sejam gerados automaticamente após a inserção ou atualização de dados usando o modelo Voyage AI configurado.
db.suppliers.createSearchIndex( "suppliers_autoembed_index", "vectorSearch", { fields: [ { type: "autoEmbed", modality: "text", path: "auto_embed_text", model: "voyage-4" }, { type: "filter", path: "region" }, { type: "filter", path: "product_categories" }, { type: "filter", path: "status" } ] });O Embedding automatizado elimina serviços de embedding externos e pipelines de ETL complexos, mantendo os dados em segurança dentro do perímetro de segurança do MongoDB Atlas.
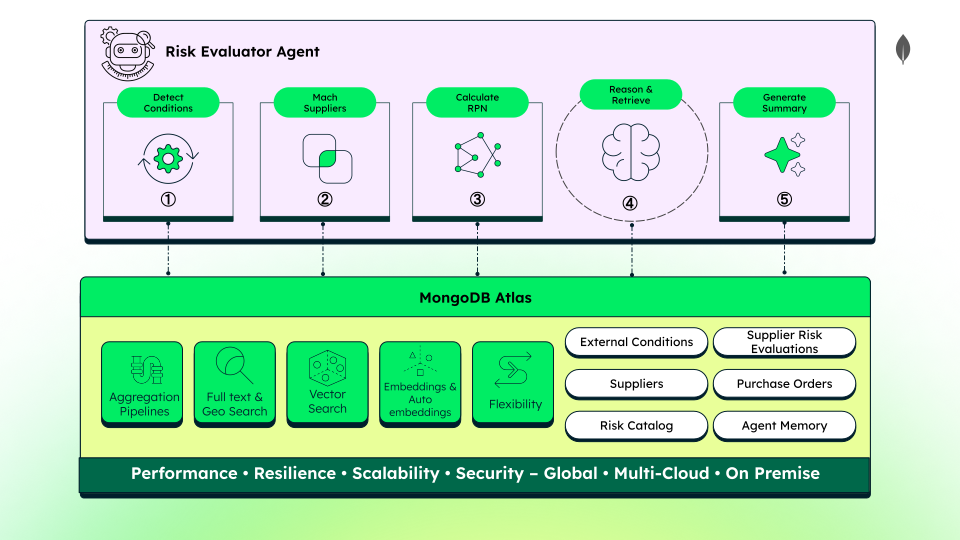
Figura 3. Agente Avaliador de Riscos
Aproveite o pipeline de agregação, a funcionalidade de pesquisa e o document model flexível para executar query avançadas nessas parte e realizar validação de compliance nos seus dados ingeridos.
Pesquisa e recuperação de embedding multimodal
Com as partes do documento armazenadas no MongoDB Atlas, query dados não estruturados usando hybrid search. Construa uma query de pesquisa dinâmica para encontrar parceiros de substituição durante uma interrupção. Combinar pré-filtros regionais com uma string da query semântica detalhada. Por exemplo, pesquise por um "fabricante de materiais de embalagem em uma zona de comércio com tarifa neutra com certificações de qualidade ativas e compromissos de entrega urgentes."
Execute esta pesquisa em um único pipeline de agregação do MongoDB Atlas. Use a pesquisa híbrida $rankFusion para mesclar a similaridade vetorial com a relevância da pesquisa de texto completo. Esta query híbrida corresponde a conceitos semânticos e palavras-chave exatas simultaneamente.
Encadeie um estágio de rerank nativo ($rerank) após a fusão usando um modelo de reranking da Voyage AI para melhorar a precisão da recuperação. O cross-encoder no banco de dados avalia as parte candidatas em conjunto com sua query para calcular pontuações de relevância precisas. A execução do reranking no pipeline mantém os registro confidenciais dos fornecedores com segurança dentro do perímetro do banco de dados.
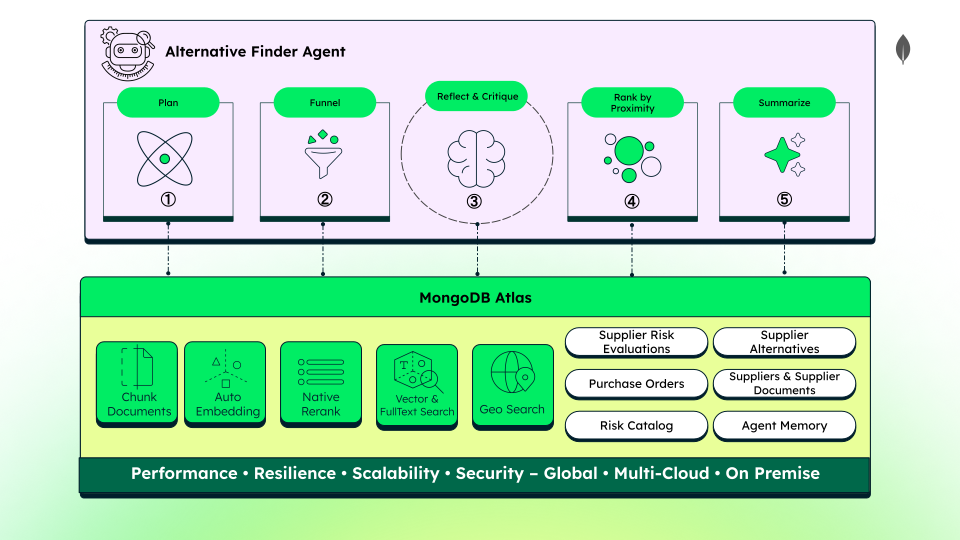
Figura 4. Agente Localizador de Fornecedores Alternativo
Inteligência multilíngue
Pesquise e analise a documentação de fornecedores globais em qualquer linguagem sem criar pipeline de tradução personalizado. O modelo multilíngue Voyage AI mapeia texto de diferentes idiomas em um espaço vetorial compartilhado.
Query o banco de dados em inglês para recuperar contratos ou certificados relevantes escritos em árabe, espanhol, chinês ou vietnamita. Armazene esses embedding multilíngues nativamente no MongoDB Atlas para executar pesquisas semânticas multilíngues com latência próxima de zero.
Consolide sua documentação global de fornecedores em um único índice de pesquisa multilíngue para simplificar seus fluxos de trabalho de compliance internacional e remover a sobrecarga de tradução.
Abordagem do modelo de dados
Bancos de dados rígidos forçam formatos de dados incompatíveis em tabelas planas. As entidades da cadeia de suprimentos do mundo real mudam constantemente e têm estruturas confusas e em evolução. Um esquema flexível, nativo de documentos, permite que o modelo de dados evolua no ritmo de negócios. Armazenar registros operacionais, embedding de vetor e coordenadas nativamente em uma única API. Evite o tempo de inatividade no desenvolvimento de migrações de banco de dados rígidas.
Esta solução usa oito coleções para gerenciar riscos e fornecimento alternativo.
Nome da collection | Propósito |
|---|---|
| Captura sinais de risco externos em tempo real com expiração de TTL. |
| Codifica pontuações de risco e limites estáticos da Análise de Modos de Falha e Efeitos (FMEA). |
| Armazena registros de fornecedores mestre com localizações GeoJSON. |
| Acompanha pedidos ativos para quantificar a exposição financeira. |
| Armazena contratos e certificados de fornecedores divididos em partes e incorporados automaticamente. |
| Armazena episódios de risco históricos para aprendizado contextual. |
| Contém pontuações RPN dinâmicas e resumos de risco em linguagem natural. |
| Persiste listas de candidatos ranqueados pendentes de aprovação humana. |
Para uma visão geral completa do document model, consulte o README do backend da solução. Examine as coleções external_conditions e supplier_documents para explorar os benefícios do document model.
external_conditions
A coleção external_conditions serve como ponto de entrada para alertas de risco do mundo real, armazenando interrupções normalizadas. Diferentes tipos de risco coexistem na mesma coleção sem forçar um esquema rígido.
A seguir estão os campos que os documentos compartilham em todos os alertas de risco.
{ "condition_id": "COND-20260505-0941", "risk_type_triggered": "logistics_disruption", "condition_score": 0.76, "has_physical_location": true, "detected_at": "2026-05-05T09:41:00Z", "valid_until": "2026-05-08T09:41:00Z"}Alertas climáticos e logísticos armazenam coordenadas precisas para uma localização física e raio de impacto. As coordenadas devem ser um GeoJSON ponto objeto para executar consultas geoespaciais nos dados. Use $geoWithin para encontrar fornecedores localizados inteiramente dentro de uma área afetada especificada.
{ // other shared fields "epicentre": { "type": "Point", "coordinates": [114.1095, 22.5229] }, "impact_radius_km": 80, "has_physical_location": true,}Alertas geopolíticos acompanham os limites regionais com um array de regiões afetadas. Para query fornecedores dentro das regiões afetadas, use o operador $in.
{ // other shared fields "affected_regions": ["CN", "HK"], "has_physical_location": false,}O ingestion_engine normaliza os payloads de API de entrada variados na estrutura de documento limpa mostrada nos exemplos de código anteriores.
O polimorfismo permite que você query ambos os tipos de sinal simultaneamente. Execute query de correspondência geográfica unificada usando $geoWithin e $in em uma única chamar ao banco de dados. Essa consolidação simplifica a lógica do seu aplicativo e evita divisões de query de drenagem de desempenho.
documentos_do_fornecedor
A coleção supplier_documents abriga documentos comerciais não estruturados tornados pesquisáveis. A seguinte amostra de documento ilustra este layout de coleção:
{ "supplier_id": "SUP-882", "doc_type": "quality_certification", "filename": "certificado_SUP882_2024.pdf", "chunk_index": 2, "chunk_total": 4, "chunk_text": "ISO 9001:2015 and IATF 16949:2016. Valid 2024-11-01 to 2027-10-31...", "page_ref": 1, "valid_until": "2027-10-31T00:00:00Z", "embedding": [/* 1024 dimensions */]}chunk_text: Armazena um segmento de texto de 400 a 600 tokens de arquivos PDF brutos. Esta parte de alta fidelidade divide grandes contratos em segmentos sobrepostos para preservar cláusulas críticas. Ele armazena o conteúdo de documento não estruturado nativamente junto com os registros do seu banco de dados operacional.embedding: Armazena o vetor de 1024dimensões gerado pelo Voyage AI. O modelo multilíngue mapeia várias linguagens para um único espaço vetorial compartilhado. Esse alinhamento permite que você query documentos em espanhol ou alemão usando strings de pesquisa em inglês.valid_until: Acompanha as datas de vencimento de certificações de compliance para expirar automaticamente os registros de fornecedores desatualizados.
Construir a solução
Implantar a solução de risco da cadeia de suprimentos baseada em agentes.
Pré-requisitos
Certifique-se de ter as seguintes contas, chaves e software antes de começar:
Conta do MongoDB Atlas: Um cluster do Atlas (M10 tier ou superior).
Chave API Anthropic: Uma chave API ativa para impulsionar o raciocínio e o planejamento do LLM.
Docker Desktop: O aplicativo necessário para executar os serviços de frontend e backend.
Definir configurações do Atlas
Ative as seguintes funcionalidades do Atlas antes de implantar o código:
Conecte-se à sua conta do MongoDB Atlas.
Habilitar o $rerank agregação estágio nas configurações do seu projeto.
Adicione sua chave de API do Voyage Model no nível do projeto às configurações do seu projeto Atlas.
Configurar e alimentar o banco de dados
Configure seu banco de dados, importe os arquivos iniciais e crie os índices necessários para executar a demonstração.
Faça login no MongoDB Atlas e crie um banco de dados chamado retail-supply-chain-risk em seu cluster Atlas.
Importe os cinco arquivos JSON de seed da pasta Docs/configurar/coleções:
Selecione seu novo banco de dados na tela Collections.
Clique no ícone de mais (+) ou clique em Create Collection para adicionar cada uma das cinco coleções.
Selecione cada coleção, clique em Import Data e faça upload do arquivo JSON respectivo.
Crie os índices geoespaciais e de pesquisa necessários para executar pesquisa vetorial, pesquisa híbrida e queries geoespaciais. As configurações de índice estão na pasta docs/configurar/indexes. Execute as etapas a seguir para criar cada índice.
mongosh "<your-connection-string>" --file suppliers-location-2dsphere.jsmongosh "<your-connection-string>" --file external_conditions-epicentre-2dsphere.jsmongosh "<your-connection-string>" --file suppliers_autoembed_index.jsmongosh "<your-connection-string>" --file agent_memory_autoembed_index.jsmongosh "<your-connection-string>" --file supplier_documents_vector_index.jsmongosh "<your-connection-string>" --file supplier_documents_fulltext_index.jsClonar o repositório e configurar as variáveis de ambiente
Clone o repositório do projeto do Github.
git clone https://github.com/mongodb-industry-solutions/retail-supply-chain-management.gitConfigurar as variáveis de ambiente do frontend e do backend:
Copie a amostra frontend/EXAMPLE.env para um novo arquivo
.envno mesmo diretório. Substitua os valores de espaço reservado pelos detalhes da sua configuração. DefinaBACKEND_URLcomohttp://127.0.0.1:8000.Copie a amostra backend/.env.example para um novo arquivo
.envno mesmo diretório. Substitua os valores de espaço reservado pelos detalhes da sua configuração. Adicione sua chave de API da Anthropic comoLLM_API_KEY.
Criar e iniciar o aplicativo
Compile e inicie seu ambiente de vários serviços usando o Docker Compose ou executando o backend e o frontend separadamente.
Para iniciar o aplicativo usando o Docker Compose, execute:
make buildPara executar os serviços manualmente, primeiro inicie o frontend:
cd frontendnpm inpm run devEm seguida, navegue até o diretório raiz e inicie o backend:
make uv_initmake uv_syncsource backend/.venv/bin/activatecd backenduvicorn main:app --reloadAbra o dashboard do frontend em http://localhost:3000 no seu navegador. Veja a documentação interativa da API em http://localhost:8000/docs.
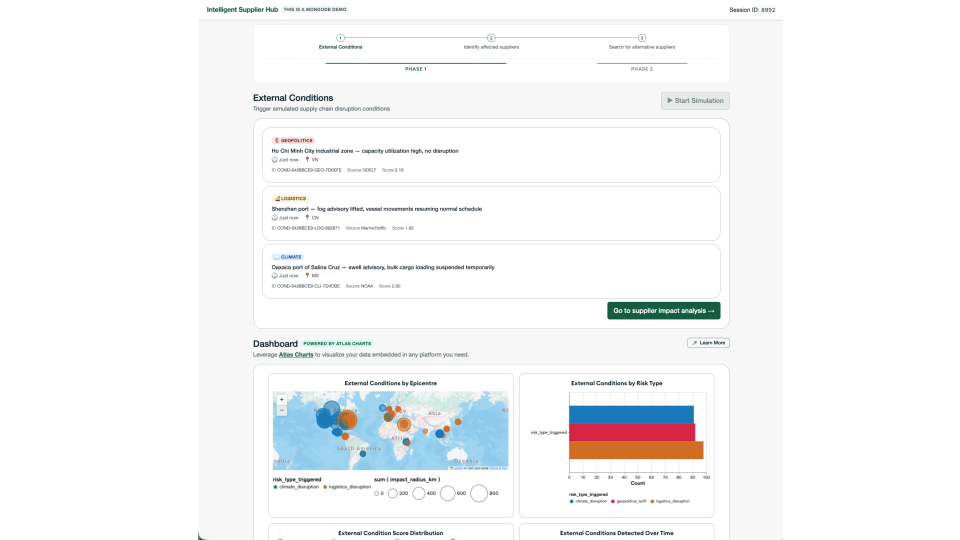
Figura 5. Sistema Hub de Fornecedores Inteligente
Leia o guia para navegar pela demonstração.
Principais Aprendizados
Esta solução demonstra vários padrões arquitetônicos críticos para criar aplicativos de cadeia de suprimentos orientados por IA:
Construa uma camada de inteligência unificada para controlar custos: Desvincule o gerenciamento de fornecedores de sistemas legados rígidos criando uma camada de inteligência unificada no MongoDB Atlas. Consolidar dados operacionais, embeddings, e memória do agente em uma única plataforma, realizando a sincronização de dados do ERP usando CDC. Essa estrutura permite que os agentes leiam o estado atual sem consultar o ERP diretamente. Leia o mesmo documento para verificações operacionais e recuperação, em seguida, restrinja os dados de forma determinística usando filtros geoespaciais, pesquisa híbrida e reclassificação antes que um LLM o receba. Controlar o que chega ao modelo otimiza o desempenho da inferência e reduz o custo de execução.
Unificar dados não estruturados em várias linguagens: Armazenar documentos não estruturados, como contratos em PDF, e-mails e relatórios para auditar digitalizados, juntamente com registros de fornecedores estruturados. Use o Voyage AI para incorporar esses diversos formatos em uma única coleção MongoDB. Este layout unificado permite query semântica em texto e imagens, simplificando sua arquitetura de recuperação sem manter sistemas de banco de dados separados. Além disso, os modelos de embedding multimodal permitem consultas multilíngues sem sobrecarga de tradução.
Mantenha a pesquisa e a reclassificação dentro do Atlas: Consolide a pesquisa vetorial, a pesquisa de texto completo e a reclassificação nativa em uma única query de banco de dados. Use
$rankFusionpara executar pesquisa híbrida e encadear nativo$rerankcom Voyage AI diretamente dentro de sua pipeline de agregação. Isso elimina saltos de rede adicionais, latência da API e gerenciamento personalizado de credenciais.
Autores
Florencia Arin, MongoDB
Angie Guemes, MongoDB
Ronan Conlon, MongoDB
Daniel Jamir, MongoDB