As decisões de subscrição, sinistros e atendimento no setor de seguros dependem de um contexto que geralmente está espalhado por muitos sistemas diferentes, incluindo sistemas de administração de apólices, plataformas de sinistros, telemática e dados de risco de terceiros, entre outros. Montar esse contexto manualmente todas as vezes é lento, inconsistente e difícil de auditar.
Esta arquitetura descreve uma camada de contexto no MongoDB Atlas, que é um tier de dados operacionais em tempo real que reúne o contexto de objetos de negócios em um único objeto ativo que agentes e aplicativos podem ler, gravar e agir.
A camada de contexto fica entre os sistemas de registro existentes e os fluxos de trabalho de subscrição, sinistros e serviços orientados por IA, para que as seguradoras não precisem substituir esses sistemas para torná-los utilizáveis pelos agentes. Ele combina um document model flexível, recuperação nativa de IA, propagação de mudanças em tempo real e governança em nível de campo para atender aos requisitos de baixa latência e auditabilidade que os loops de decisão regulamentados e aumentados por agentes exigem.
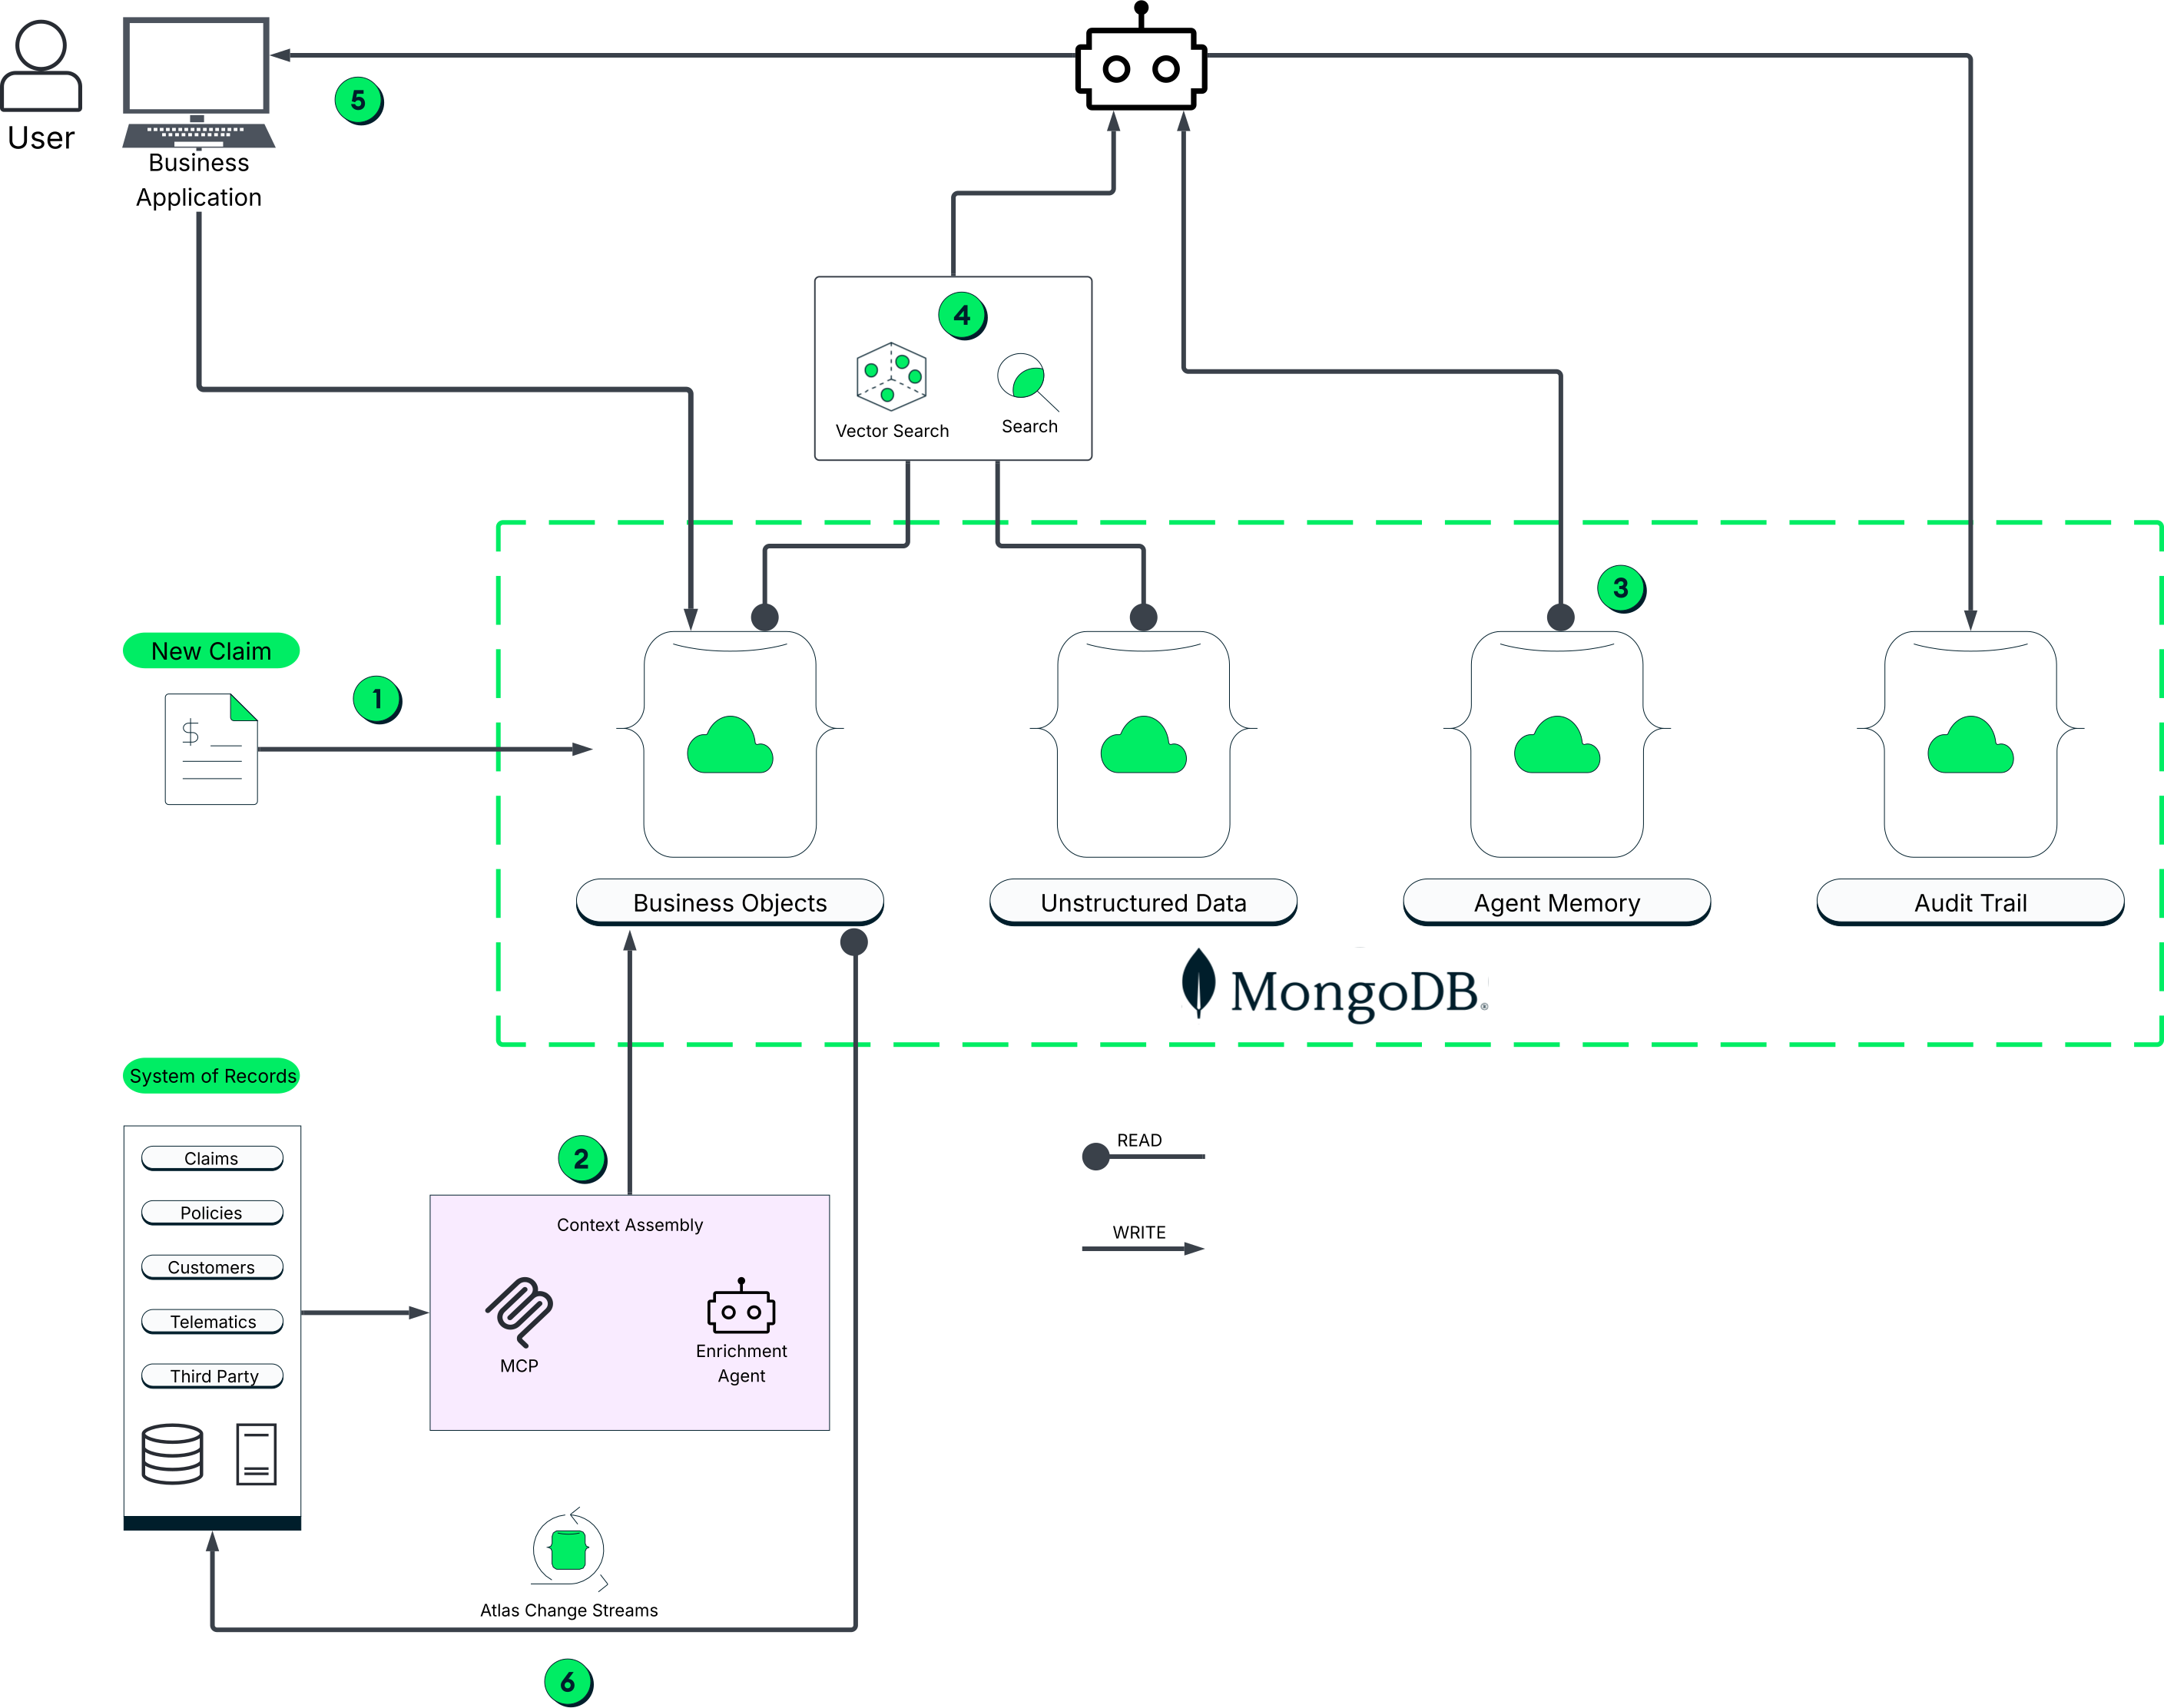
Figura 1. Arquitetura da Camada de Contexto & Fluxo de Dados do Agente de IA
Fluxo de dados
As etapas a seguir rastreiam uma única submissão ou reivindicação à medida que ela se move pela camada de contexto, desde a entrada até uma decisão gravada e auditável.
Submissão ou entrada de reivindicação
Uma nova submissão ou sinistro chega e o serviço de entrada captura identificadores principais e campos estruturados iniciais. Após a identificação dessas informações, o serviço de ingestão as grava em uma coleção
business_objectsno MongoDB Atlas como um único documento.Enriquecimento e montagem de contexto
Um agente de enriquecimento especializado reúne o contexto restante de que o subscritor ou o gestor de sinistros precisa, como limites de cobertura, endossos, descrições de perdas, notas do ajustador e muito mais. O agente reúne dados do sistema de registro para criar um único registro ativo. Agora, um único documento MongoDB contém tudo o que um subscritor ou agente de sinistros precisa para obter conhecimento, tomar uma ação e agir.
Memória do agente e recuperação de estado
Ao mesmo tempo que o enriquecimento de contexto, o serviço também recuperar a memória anterior para esta submissão ou reivindicação, já que a memória agentic mantém o histórico de conversas, rastreamentos de decisão, histórico de auditoria e sentimento para este caso específico. Isso permite que um agente de subscrição ou de sinistros retome o trabalho com memória total de turnos anteriores, recomendações e substituições humanas.
Recuperação nativa de IA em conteúdo estruturado e não estruturado
O serviço emite query híbridas de
$vectorSearche$searchcontra o objeto de negócios e artefatos não estruturados vinculados, como notas de ajustador, narrativas de perda ou metadados de imagem. Para fazer isso, embeddings ajustados ao domínio e reranking podem ser usados, para que o agente veja o histórico e o precedente mais relevantes primeiro, em vez de uma lista bruta de correspondências.Decisão do agente, o Human-In-The-Loop e write-back
O agente revisa o contexto reunido e executa uma ação, como emitir uma cotação ou fazer uma solicitação de mais informações. Em muitas situações, esta ação precisará ser revisada por um ser humano, mantendo a revisão final sempre sob controle humano. Por fim, a decisão, juntamente com seu rastreamento de raciocínio completo, é gravada de volta pelo agente em sua própria coleção de rastreamentos de decisão no MongoDB como uma entrada para auditar imutável para garantir total compliance, rastreabilidade e transparência sobre as ações do agente.
Propagação em tempo real com Change Streams
O MongoDB Change Streams transmite atualizar para cada agente, dashboard e sistema downstream que monitora a submissão ou reivindicação. Além disso, novos sinais podem ser introduzidos pelo usuário humano a qualquer ponto, para que possam ser usados para trigger agentes diretamente, como um novo indicador de fraude em uma reivindicação que dispara o agente de reivindicações imediatamente, sem um ciclo de lote.
Componentes
Sistemas de registro
Um sistema de registro (SoR), também conhecido como sistema único de registro (SSoR), é um sistema de computador único que serve como a fonte de dados autorizada para um elemento de dados ou objeto de dados crítico. O SoR mantém o "estado verdadeiro" dos dados, o que significa que é a versão mais atualizada, precisa e compatível disponível para essa fonte de dados específica.
Nesta arquitetura, os sistemas de registro permanecem como a fonte das transações de negócios. Eles continuam a ter suas responsabilidades originais, enquanto a camada de contexto reúne um contexto de decisão utilizável entre eles.
Objetos de negócio e memória do agente
Os objetos de negócio mantêm a entidade operacional, seja uma submissão, uma reivindicação ou um registro de cliente, como um único documento continuamente enriquecido. Isso garante que cada consumidor trabalhe a partir da mesma visão atualizada, em vez de ter que reunir as informações de fontes dispersas. O MongoDB armazena a memória do agente junto com esse registro para que os agentes mantenham o contexto e o histórico de auditoria em uma decisão de várias etapas.
Recuperação nativa de IA
O MongoDB pesquisa vetorial, combinado com a pesquisa de texto completo e o reranking, permite que os agentes recuperar o histórico de perdas, precedentes ou diretrizes mais relevantes de campos estruturados e artefatos não estruturados em uma única query, em vez de orquestrar em um armazenamento vetorial separado.
Propagação em tempo real
O MongoDB Change Streams e o Stream Processing nativo mantêm cada agente e sistema downstream sincronizados com o estado atual de uma submissão ou reivindicação, e permitem que novos sinais ou eventos trigger um agente diretamente, em vez de esperar por um ciclo de polling ou lote.
Trilha de auditoria
A camada de contexto mantém um rastro de auditar imutável para cada leitura e gravação, para que todas as decisões assistidas por IA permaneçam transparentes e rastreáveis em todos os momentos. Uma coleção reúne as informações completas sobre cada decisão, desde a identidade do usuário/agente que tomou a decisão até as etapas para chegar à conclusão, contexto, metadados de IA, resultado da decisão e muito mais.
Limitações
Este padrão introduz complexidade e deve ser adotado intencionalmente.
A camada operacional nem sempre é a melhor para fins analíticos: essa arquitetura não é adequada para cargas de trabalho apenas de análise, repositórios de arquivamento ou casos de uso em que as decisões não exigem montagem de contexto em tempo real, gravar ou auditabilidade. Se a necessidade primário for relatório ou análise orientada a lote, as plataformas analíticas podem ser suficientes sem a adição de uma camada de contexto operacional.
A flexibilidade de esquema exige sua própria disciplina: Essa abordagem também exige disciplina em modelagem de dados, resolução de identidade, governança e gerenciamento do ciclo de vida. Uma camada de contexto pode acumular objetos grandes e complexos e esquemas em evolução, portanto, a equipe deve definir limites de objeto, expectativas e padrões para atualizar antecipadamente.
A complexidade do sistema upstream não será eliminada: reduz a fragmentação do tempo de decisão, mas ainda depende de acesso aos dados e qualidade de dados upstream confiáveis. A má qualidade da fonte ou o design fraco do evento aparecerão dentro da camada de contexto em vez de desaparecerem.
A arquitetura funciona melhor quando adaptada a um caso de uso específico com um modelo de dados predefinido e, em seguida, expandida a partir de um fluxo de trabalho de referência comprovado.
Saiba mais
Explore as outras arquiteturas de referência: