이 페이지에서는 MongoDB 벡터 검색 성능 벤치마크결과를 살펴보니다. MongoDB는 다양한 구현 필요사항을 지원하는 범위 솔루션들을 제공합니다. 고객은 특정 비즈니스 설정에 적합한 성능 및 정확도 수준을 선택할 수 있습니다.
결과 요약
2048 차원에서
voyage-3-large임베딩을 사용하는 15.3M 벡터에서, 양자화가 구성된 MongoDB Vector Search는 < 50ms 쿼리 지연 시간 으로 90~95%의 정확도를 유지합니다.이진 양자화는 인덱스 제공 비용의 약 4분의 1 수준으로 더 저렴한 솔루션을 제공합니다. 전체 충실도 벡터로 다시 점수를 매기기 때문에 많은 대규모 워크로드에 더 나은 옵션이 될 수 있지만, 성능이 요구 사항에 맞는지 확인하기 위해 샘플 데이터 세트에서 테스트를 실행하는 것이 좋습니다.
대규모 워크로드를 양자화하여 실행할 때는 1024차원 이상을 권장합니다.
numCandidates에 선택된 값에 따라 선택적 필터가 성능을 향상시키거나 악화시킬 수 있습니다.이진 양자화를 위한 재점수화의 추가 비용은 높은 동시성 워크로드에서 처리량 감소로 나타납니다.
샤딩은 처리량을 약간 개선하지만 처리량 향상을 위해 검색 노드의 수를 늘리거나 검색 노드의 사용 가능한 코어 수를 확장할 것을 권장합니다.
다차원 벤치마크 전반에 걸친 리콜 및 지연 시간 분석
첫 번째 결과 집합은 5.5M(550만 개) 문서로 구성된 데이터셋에 대해 수행한 테스트를 보여줍니다. 이 데이터세트는 각 문서마다 voyage-3-large를 사용해 생성한 다양한 차원(256, 512, 1024, 2048)의 벡터를 포함하고 있습니다.
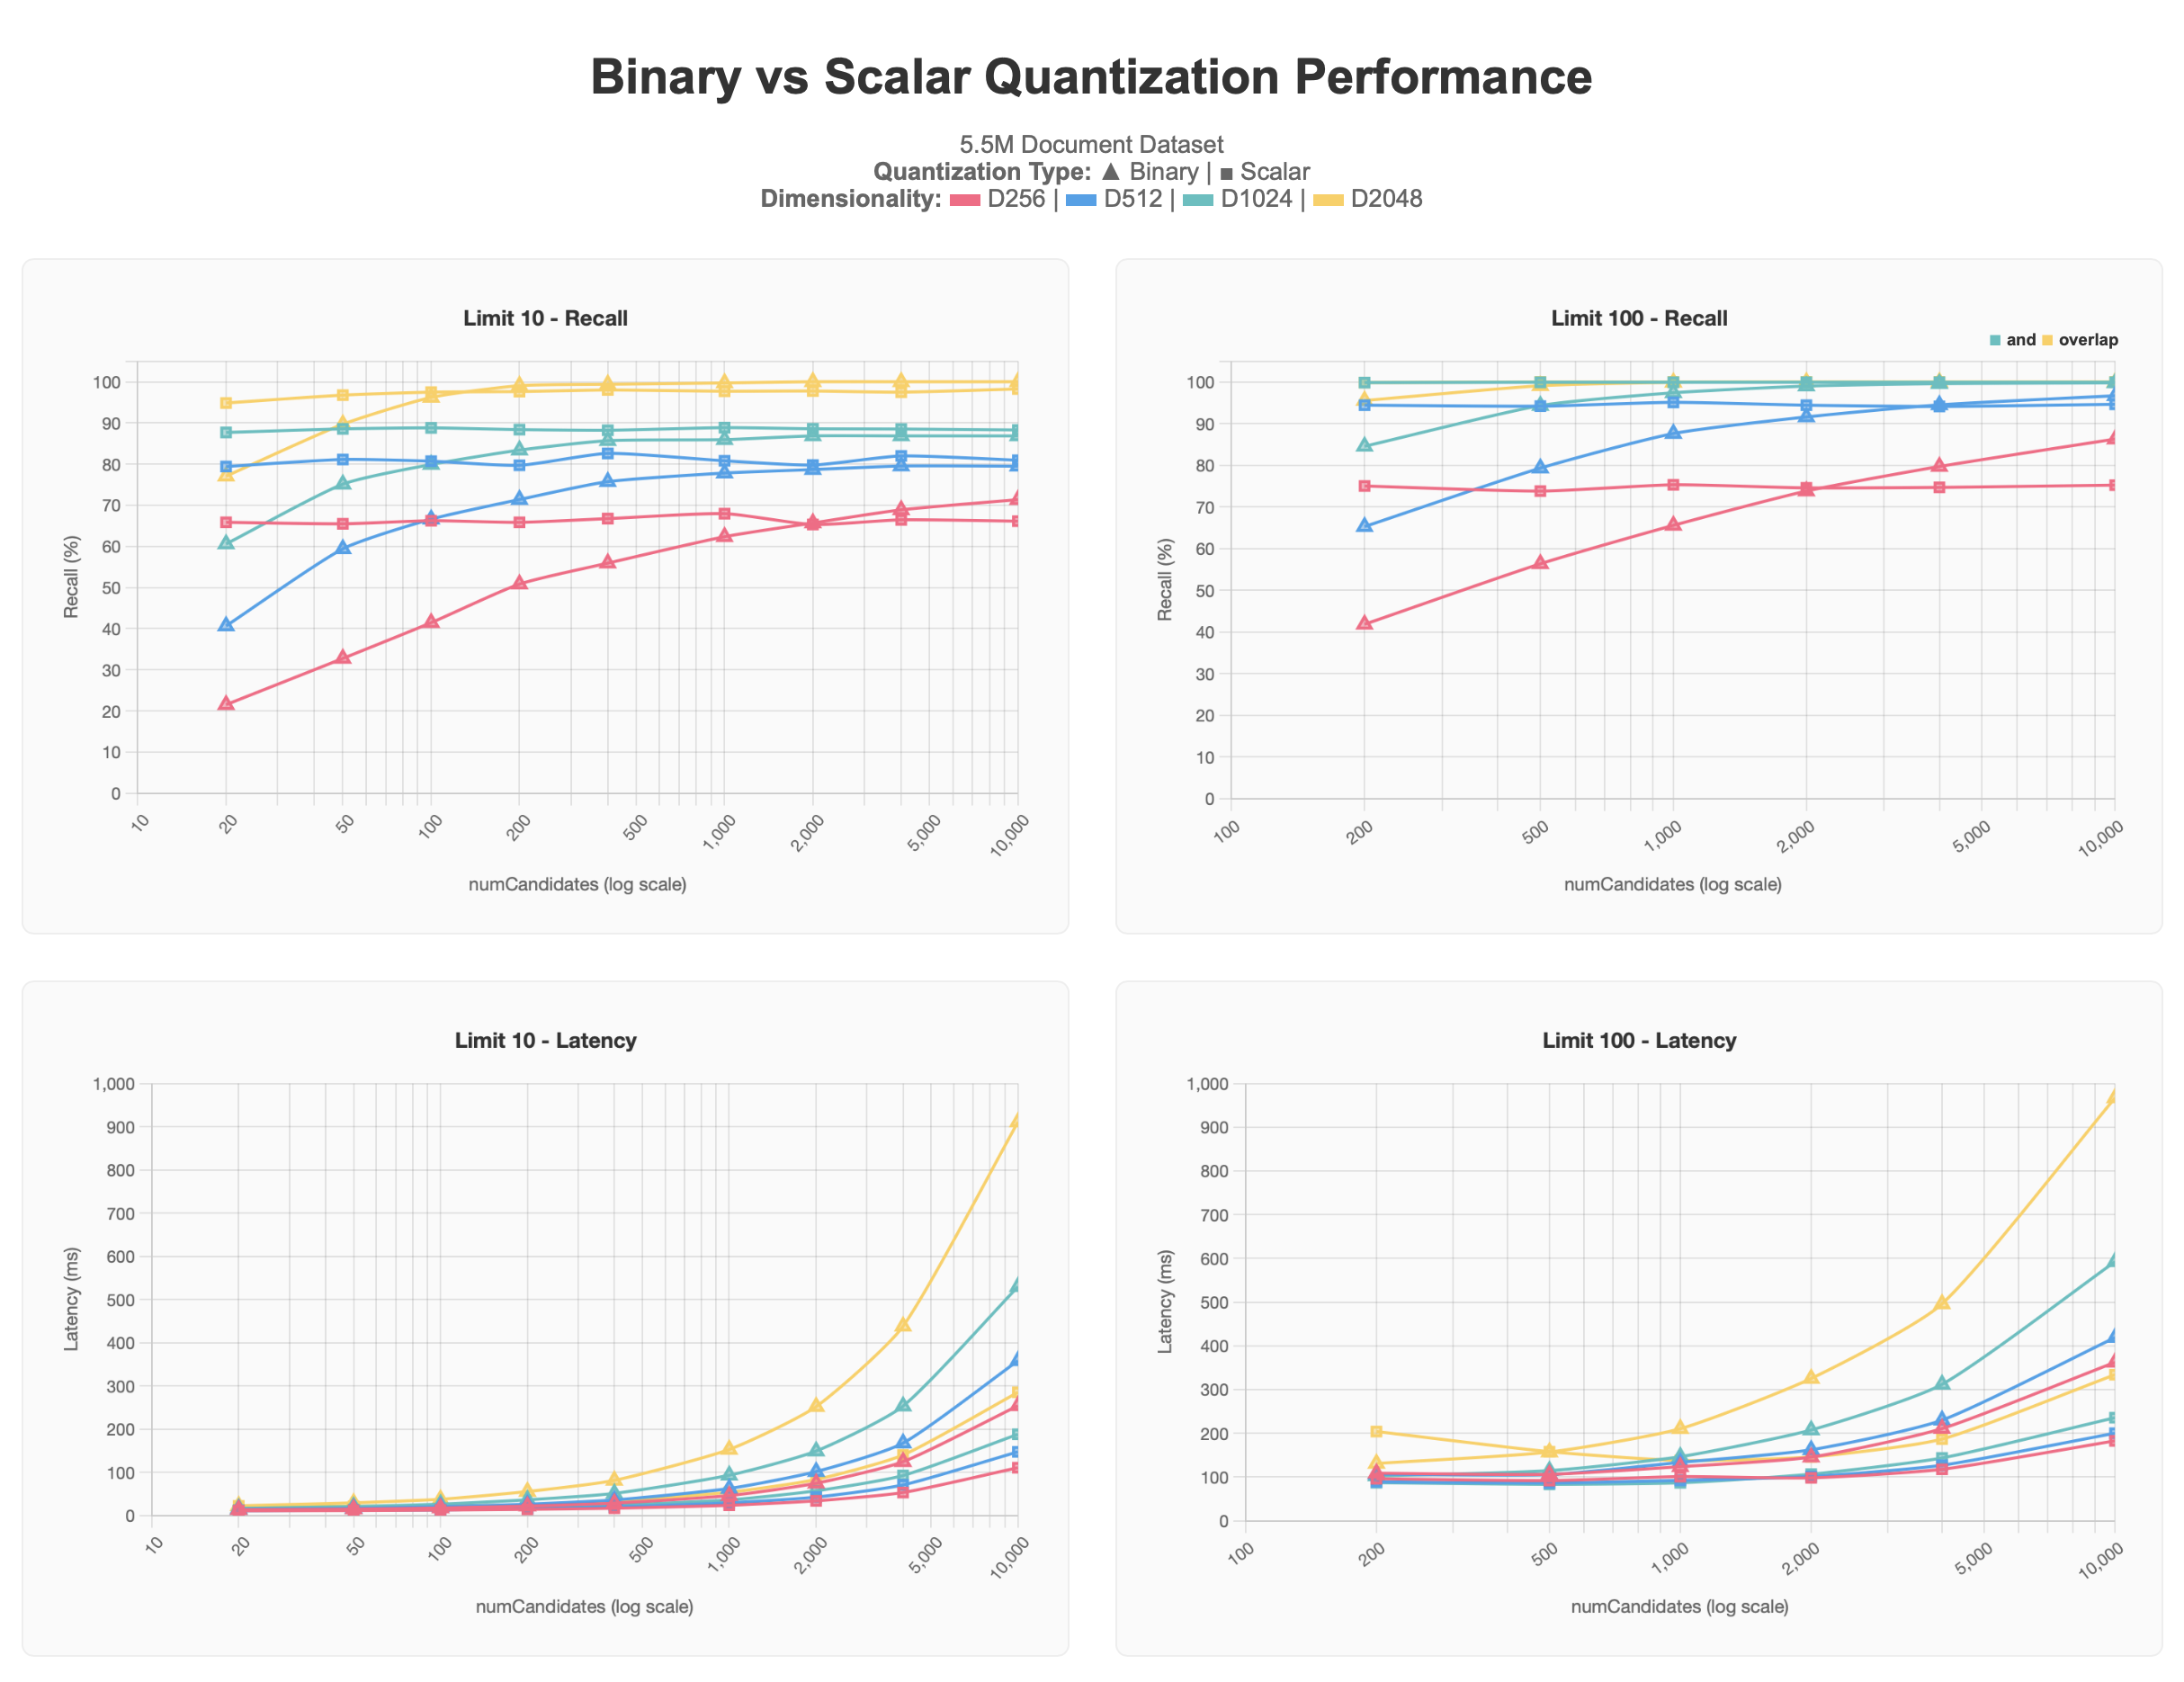
스칼라 양자화된 결과는 모두 이진 양자화된 결과보다 높은 수준에서 시작하지만 numCandidates 이 증가해도 점근 수준을 유지합니다. 반대로 이진 양자화된 쿼리는 더 많은 numCandidates 가 요청될수록 더 정확한 결과를 산출하여 스칼라 양자화의 점근선에 접근하고, 일부 경우에는 이를 전달하는데, 특히 1000의 numCandidates 이상에서는 지연 시간 비용 .
limit의 값이 낮을수록 100% 정확도에 도달하려면 일반적으로 numCandidates이 높아야 합니다. 쿼리가 최상위 결과에 대해 더욱 선택적이기 때문입니다. 이 효과는 이진 양자화 플롯에서 특히 잘 보입니다. 높은 차원의 벡터(1024d 및 그 이상)는 더 낮은 numCandidates에서 90-95% 목표 범위에 도달합니다. 이는 더 풍부한 표현이 가까운 이웃을 더 쉽게 구별할 수 있게 하기 때문입니다. limit 결과를 100로 만들어내는 테스트는 limit 결과를 10로 만들어내는 테스트보다 numCandidates이 덜 낮은 상태로 90-95% 목표 범위에 도달합니다. 그 이유는 결과 세트가 클 수록 검색이 관련 잎을 표면으로 드러내는 기회가 더 많아지기 때문입니다.
이러한 정보를 바탕으로 대규모 데이터셋을 다룰 때는 1024차원 이상의 차원을 유지하고 양자화를 적용하는 것이, 낮은 차원에 양자화를 적용하지 않는 것보다 확장성 측면에서 더 좋다는 결론을 내렸습니다. 또한 요청하는 벡터의 수 역시 결과에 영향을 미칩니다.
더 큰 규모의 벤치마크 결과
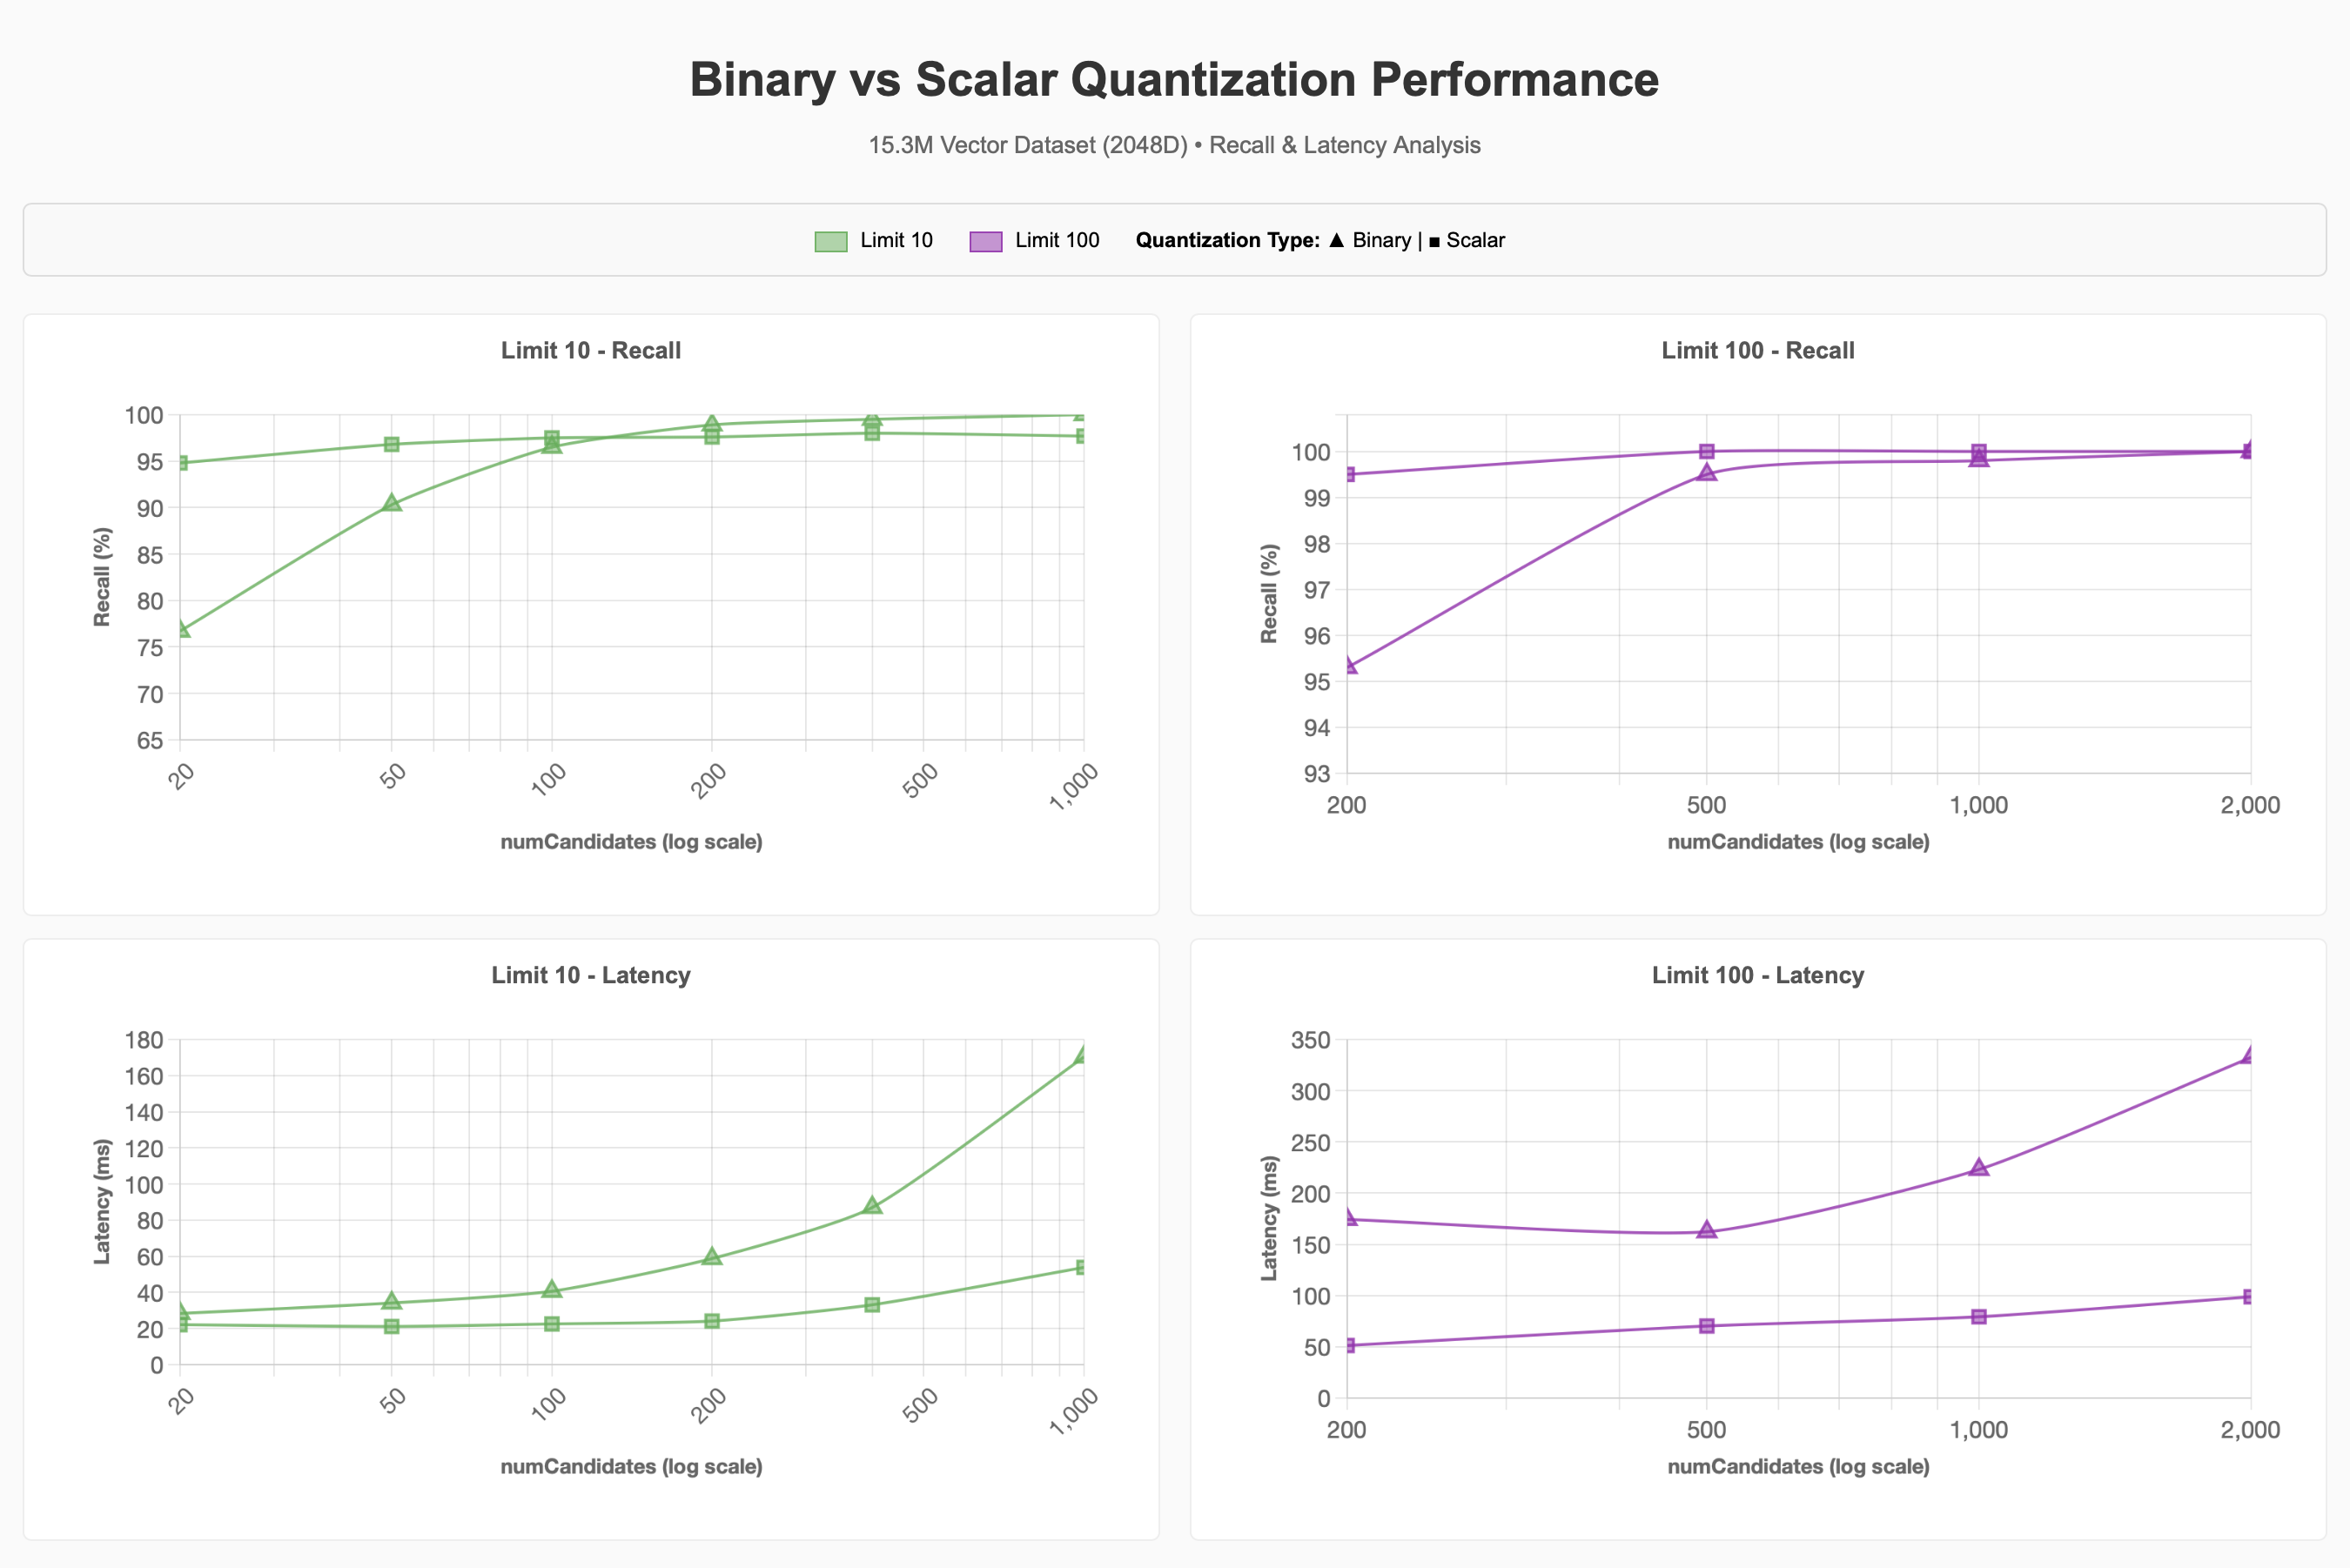
더 큰 15.3M(1,530만 개) 벡터 데이터셋의 경우 차원을 2048차원으로 고정한 뒤 양자화, 필터링 및 동시성이 성능에 미치는 영향을 조사했습니다. 이전 테스트 결과에서 더 높은 차원이 리콜(재현율) 유지에 더 유리하게 작용했기 때문에 2048차원으로 설정하였으며, 사실 1024차원만으로도 90~95% 리콜 목표 달성에는 충분했을 것입니다.
리콜 및 지연 시간 분석
이진 양자화를 사용할 때, 기준선과 비교하여 90~95% 리콜 목표를 달성하려면 훨씬 더 많은 numCandidates가 필요하다는 것을 관찰했습니다. numCandidates가 높을수록 일반적으로 지연 시간이 길어지지만, 이는 상황에 따라 달라질 수 있습니다.
필터링
15.3M(1,530만 개) 항목 중 약 500k(전체의 약 3%에 해당하는 약 50만 개)가 반려동물 용품 카테고리에 속하는 데이터셋에 선택적 필터를 적용할 때 리콜과 지연 시간이 어떻게 변하는지 관찰했습니다.
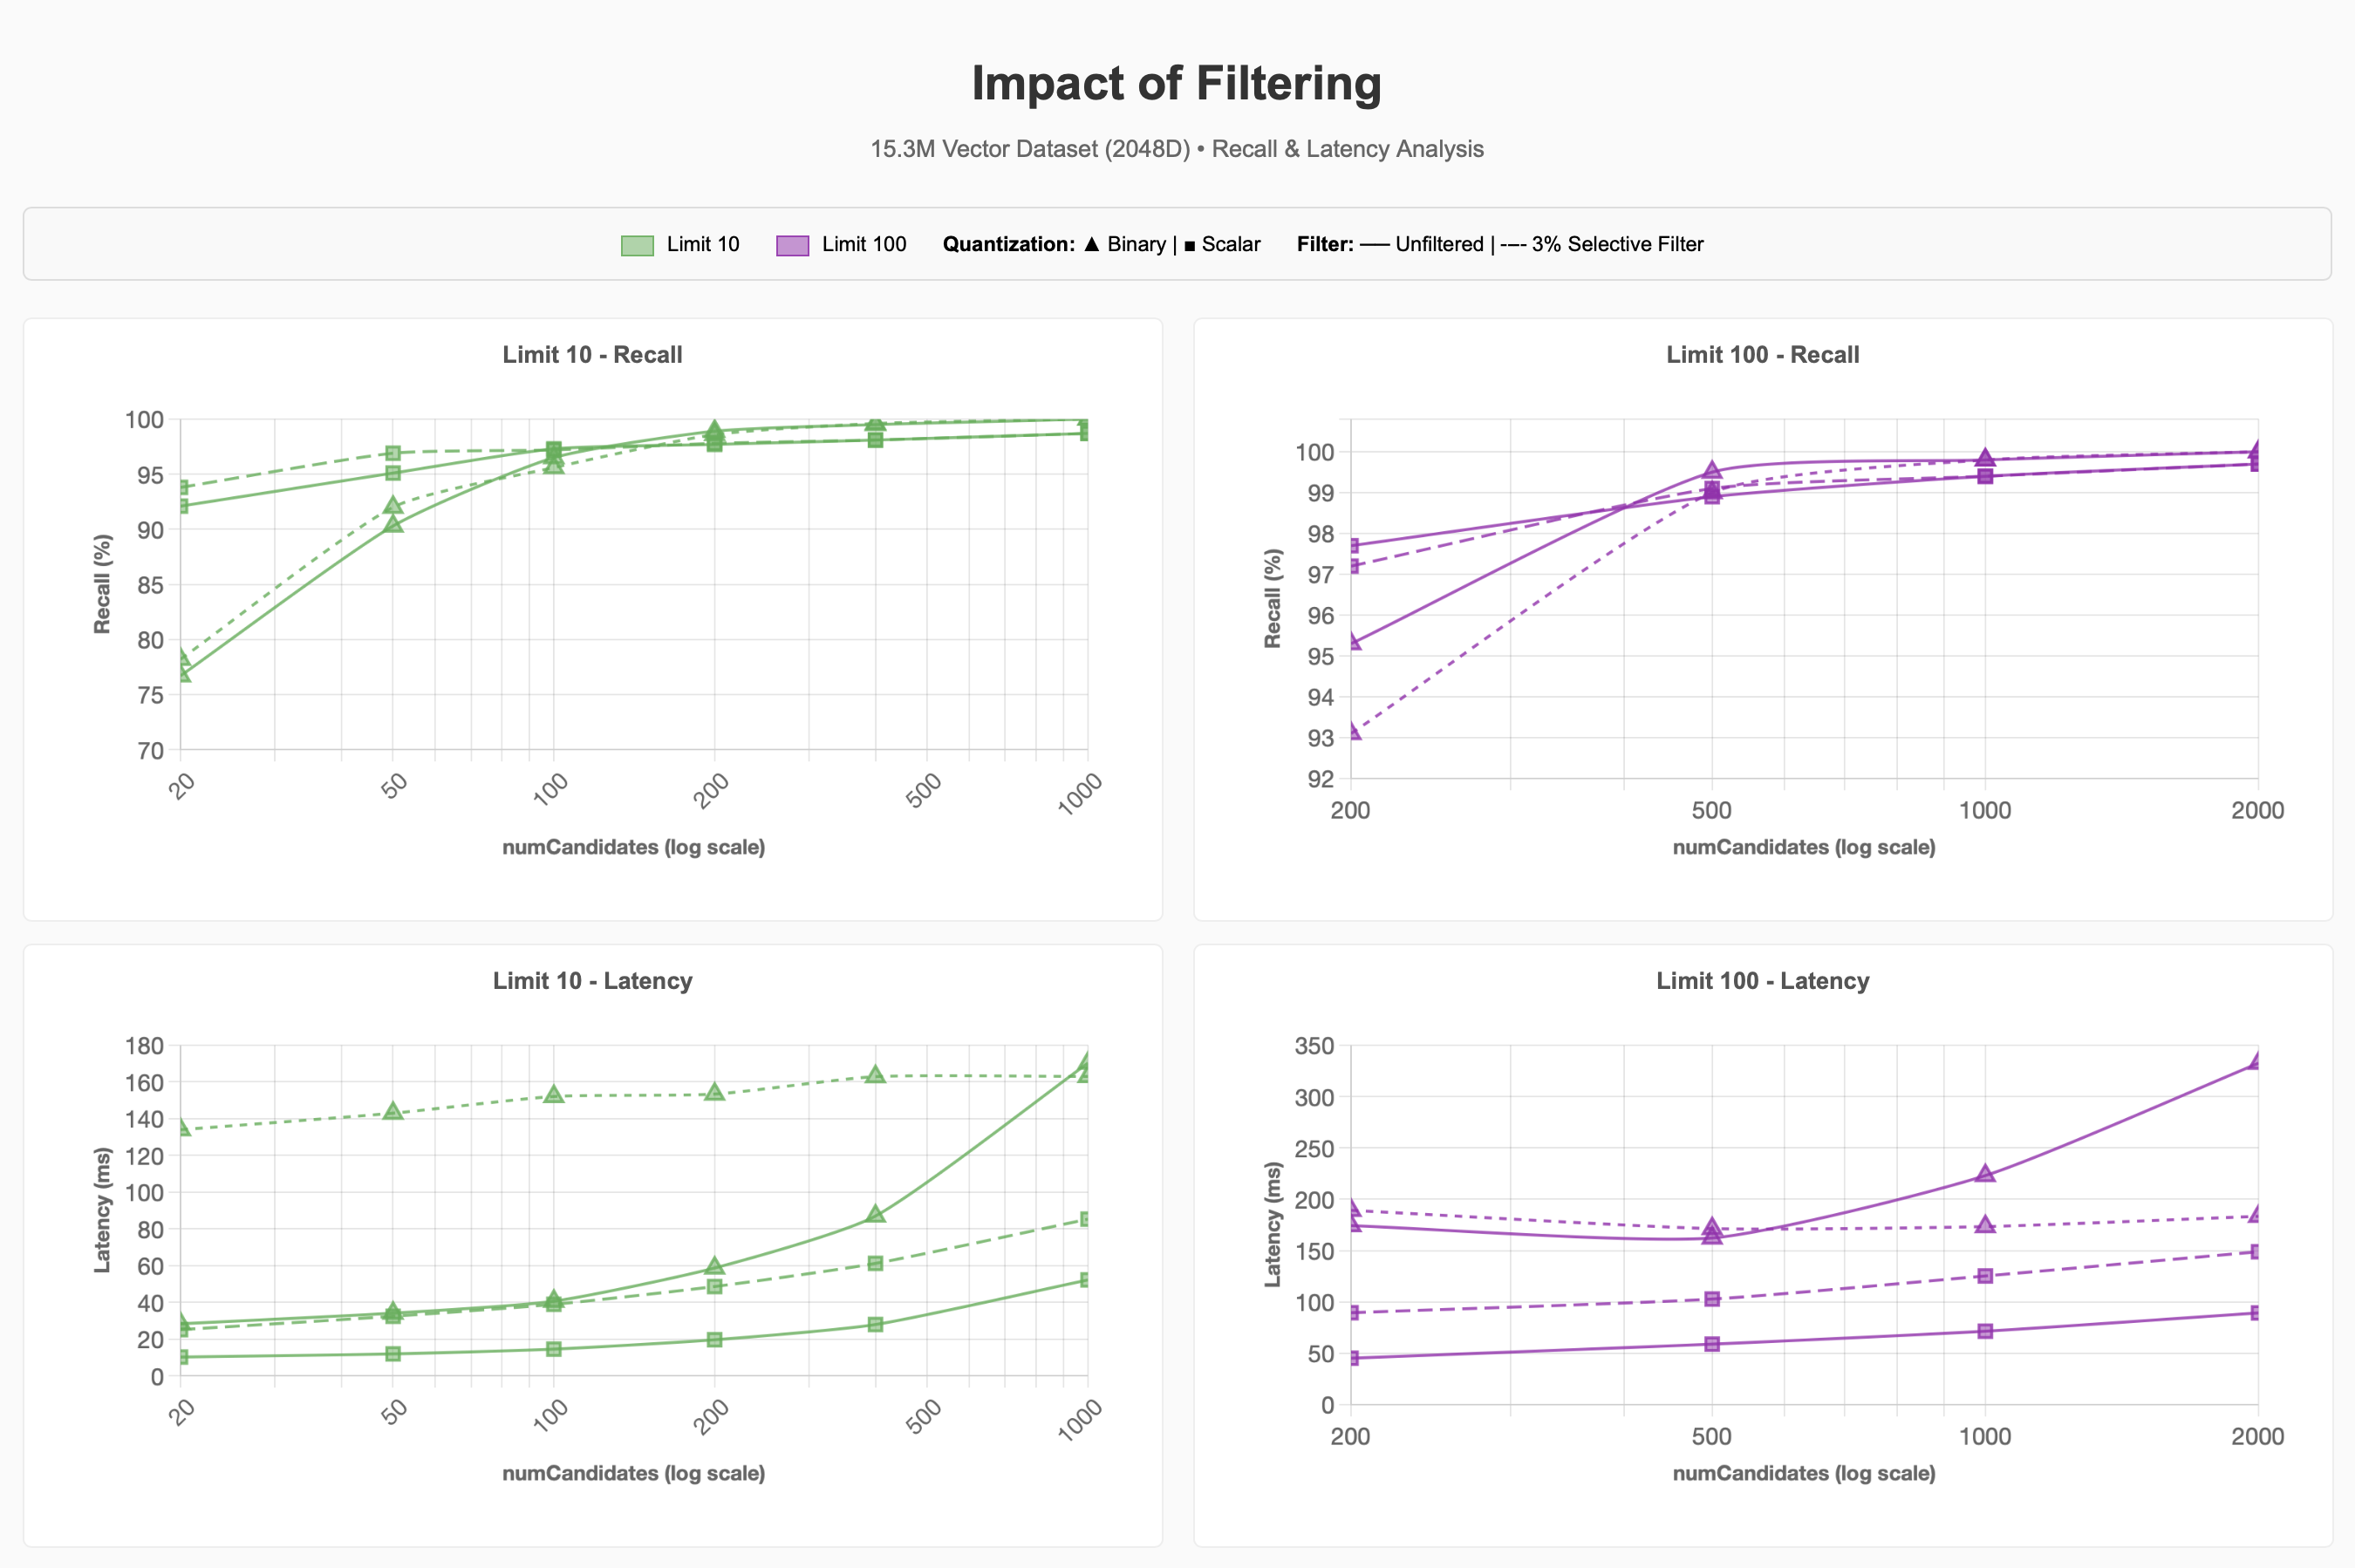
선택 필터는 데이터의 작은 일부만 일치하는 필터입니다 (이 경우, ~3%). 검색 엔진이 이제 이 작은 하위 집합 내에서 가장 가까운 이웃을 찾아야 하므로 동일한 재현율에 도달하려면 인덱스를 더 많이 탐색하고 더 많은 후보를 평가해야 합니다. 각 쿼리는 필터맅되지 않은 쿼리보다 더 많은 작업을 수행합니다.
예상대로 3% 선택적 필터로 인해 쿼리가 더 많은 작업을 수행할 수 있음을 알 수 있습니다. 더 낮은 limit 값에서 이진 양자화를 사용할 경우, 필터를 적용하지 않은 쿼리보다 90~95% 재현율을 달성하는 데 약 4배 더 많은 작업이 필요했습니다.
Hierarchical Navigable Small Worlds 에 대한 Acorn- 101 검색 전략을 지원 루센 의 향후 개선 사항은 이 프로세스 개선할 수 있습니다. 그러나 요청된 후보 수가 세그먼트 내 메타데이터 필터하다 와 일치하는 벡터 수를 초과할 때 ENN을 수행하면 선택한 양자화 체제에 관계없이 필터하다 선택성이 쿼리 성능에 큰 역할을 한다는 것을 알 수 있습니다.
동시성
이 테스트는 스칼라 및 이진 양자화를 사용할 때 다양한 limit 값에서 동시 요청 수를 1, 10 및 100으로 확장하여 테스트했습니다. numCandidates 값은 90~95%의 리콜을 달성할 수 있도록 선택되었습니다.
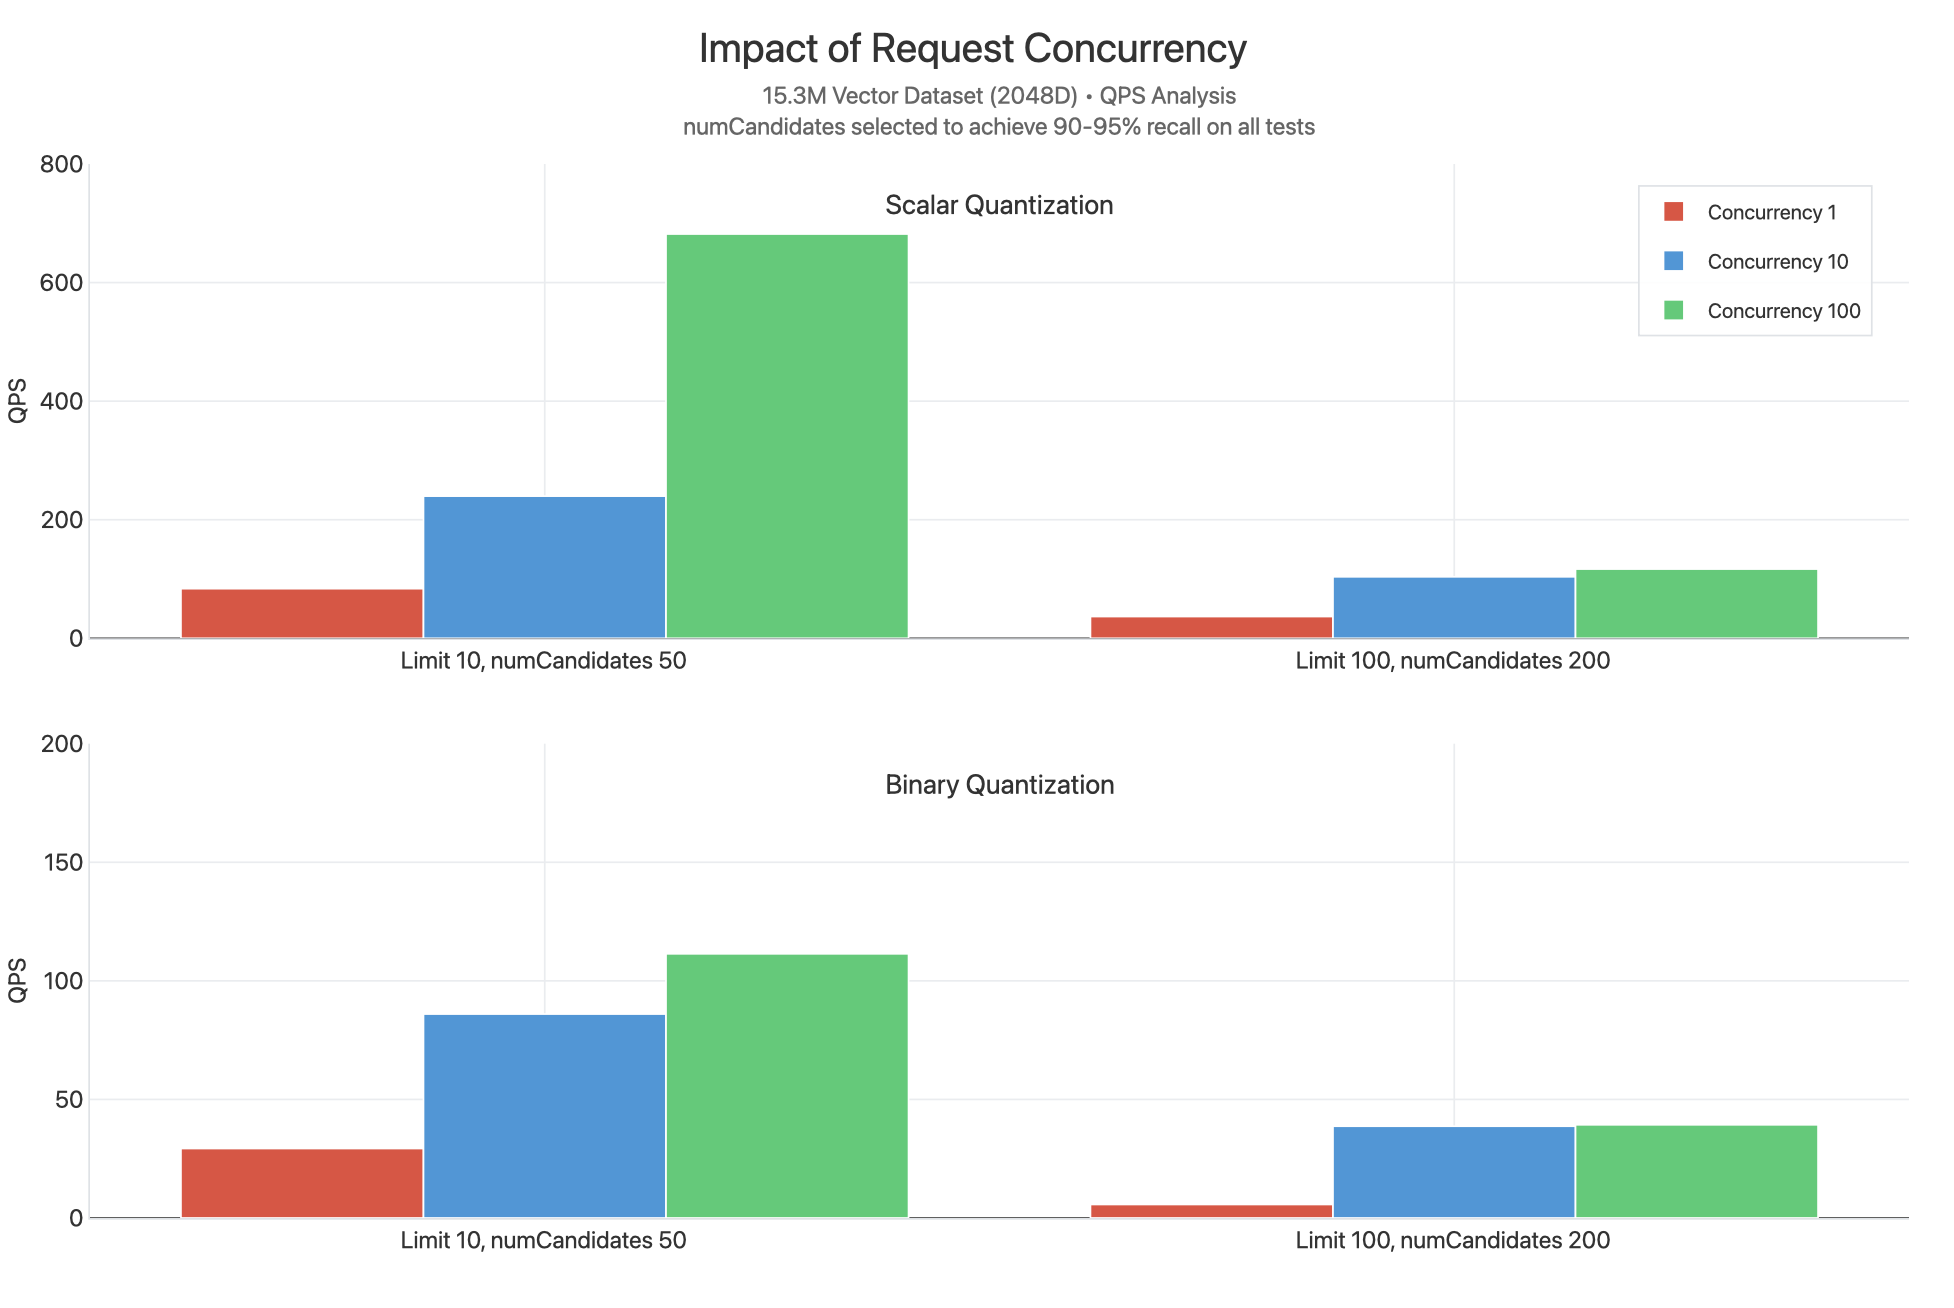
스칼라 양자화는 모든 limit 값에서 더 높은 QPS를 달성하는 것으로 나타납니다. 이는 numCandidates 값이 낮아 쿼리별로 수행되는 작업이 적고, 재점수화가 필요하지 않기 때문인 것으로 보입니다. 동시성이 높을수록 동시성 10 및 동시성 100에 대한 QPS 곡선이 서로 가까운 것으로 나타나며, 이는 시스템이 사용 가능한 CPU 리소스를 효율적으로 사용하고 있음을 나타내고, 예비 동시성이 주로 지연 시간에 영향을 미친다는 것을 의미합니다.
예외적으로, 스칼라 양자화에서 limit 10, 동시성 100 조건에서는 QPS가 현저히 더 높게 나타나는 데이터 포인트가 있습니다. 이는 재점수화를 하지 않고 limit 값이 낮을수록 쿼리별 비교 작업이 적어지기 때문에, 각 요청의 반환이 더 빨라지고 코어가 다른 쿼리 처리에 더 효과적으로 사용될 수 있기 때문입니다.
요청 처리를 위한 사용 가능한 vCPU 수를 확장하려면 검색 노드 계층을 확장하거나 검색 노드 수를 최소 2에서 최대 32 노드로 확장하는 방식이 동시성 병목 현상을 해소하고, 수천 건의 QPS 수준까지 무리 없이 확장할 수 있도록 도와줄 수 있습니다.
샤딩
클러스터와 컬렉션이 _id에서 샤딩되고, 바이너리 양자화 인덱스에 대해 필터링되지 않은 쿼리가 실행될 경우 어떤 일이 발생하는지도 관찰했습니다.
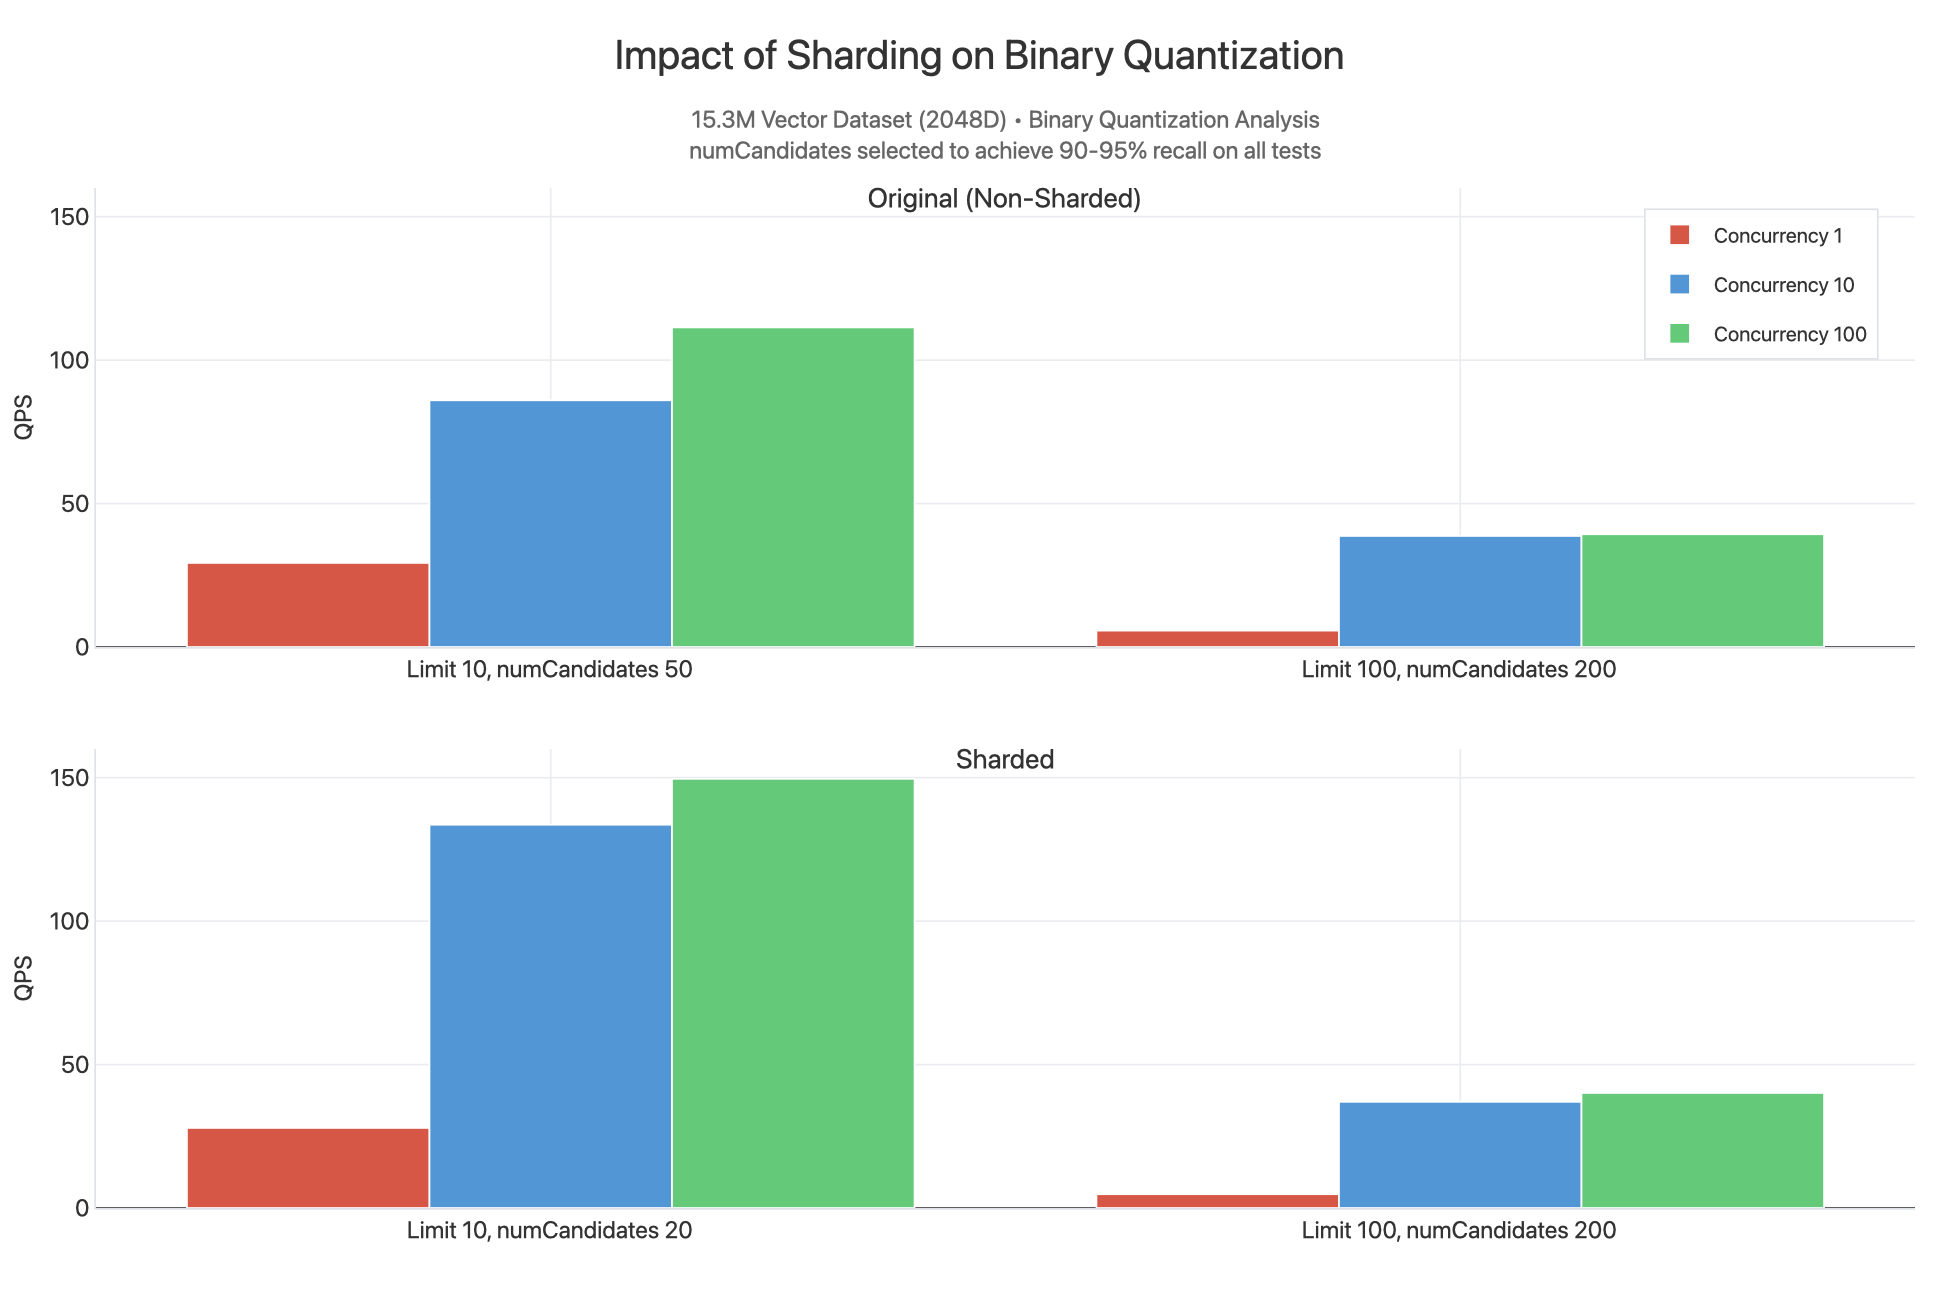
여기서 샤딩된 결과는 limit 10에서 더 높은 QPS를 보이며 numCandidates 값을 더 낮게 설정해 90~95% 리콜(Recall) 범위 내 결과를 반환할 수 있음을 알 수 있습니다. 이는 15.3M 규모의 데이터셋이 세 개의 샤드에 분할되고 각 샤드는 HNSW 그래프가 포함된 세그먼트에 분산된 5.1M 벡터로 자체 인덱스를 구축하기 때문입니다. 기능적으로는 3 개의 샤드에 쿼리가 동시에 분산-수집(scatter-gather) 방식으로 실행되어, 각 쿼리가 가장 가까운 n 개의 벡터를 더 쉽게 찾을 수 있는 덜 고도화된 검색을 수행하게 됩니다. 이러한 이유로 샤딩 시 numCandidates를 줄이고 쿼리 처리를 위한 코어를 더 많이 사용할 수 있어 QPS가 소폭 증가하지만, 샤딩 도입에 따른 비용 증가를 정당화할 만큼 큰 차이는 아닙니다. 벡터 검색 성능은 여전히 안정적이므로 처리량을 확장하기 위해 클러스터를 샤딩할 필요는 없습니다.
참고
limit 100, numCandidates 200의 경우에도 값은 유사합니다. 지능형 샤드 키 매칭이 필터로 사용되는 필터 쿼리에서는 더 나은 성능을 기대할 수 있습니다.