결과 설명을 사용하여 쿼리에 대한 다음 정보를 확인할 수 있습니다.
쿼리를 완료하는 데 걸린 시간
쿼리가 인덱스를 사용했는지 여부
쿼리를 수행하기 위해 스캔한 문서 및 인덱스 키의 수
참고
쿼리에 대한 계획 결과 설명은 MongoDB 버전에 따라 변경될 수 있습니다.
cursor.explain("executionStats") 및 db.collection.explain("executionStats") 메서드는 쿼리 성능에 대한 통계를 제공합니다. 이러한 통계는 쿼리에서 인덱스를 사용하는지 여부와 방법을 측정하는 데 유용할 수 있습니다. 자세한 내용은 db.collection.explain()를 참조하세요.
MongoDB Compass는 쿼리 성능에 대한 통계를 표시하는 설명 계획 모달을 제공합니다. 이러한 통계는 쿼리에서 인덱스를 사용하는지 여부와 방법을 측정하는 데 유용할 수 있습니다.
쿼리 성능 평가
이 페이지의 예시는 sample_mflix 데이터 세트의 데이터를 사용합니다. 이 데이터 세트를 자체 관리형 MongoDB 배포서버에 로드하는 방법에 대한 자세한 내용은 샘플 데이터세트 로드를 참조하세요. 샘플 데이터베이스를 수정한 경우, 이 페이지의 예시를 실행하려면 데이터베이스를 제거하고 다시 생성해야 할 수 있습니다.
이 페이지의 예시에서는 sample_mflix 샘플 데이터 집합의 데이터를 사용합니다. 이 데이터 세트를 배포서버에 로드하는 방법에 대한 자세한 내용은 Atlas 배포서버에 샘플 데이터 가져오기를 참조하십시오.
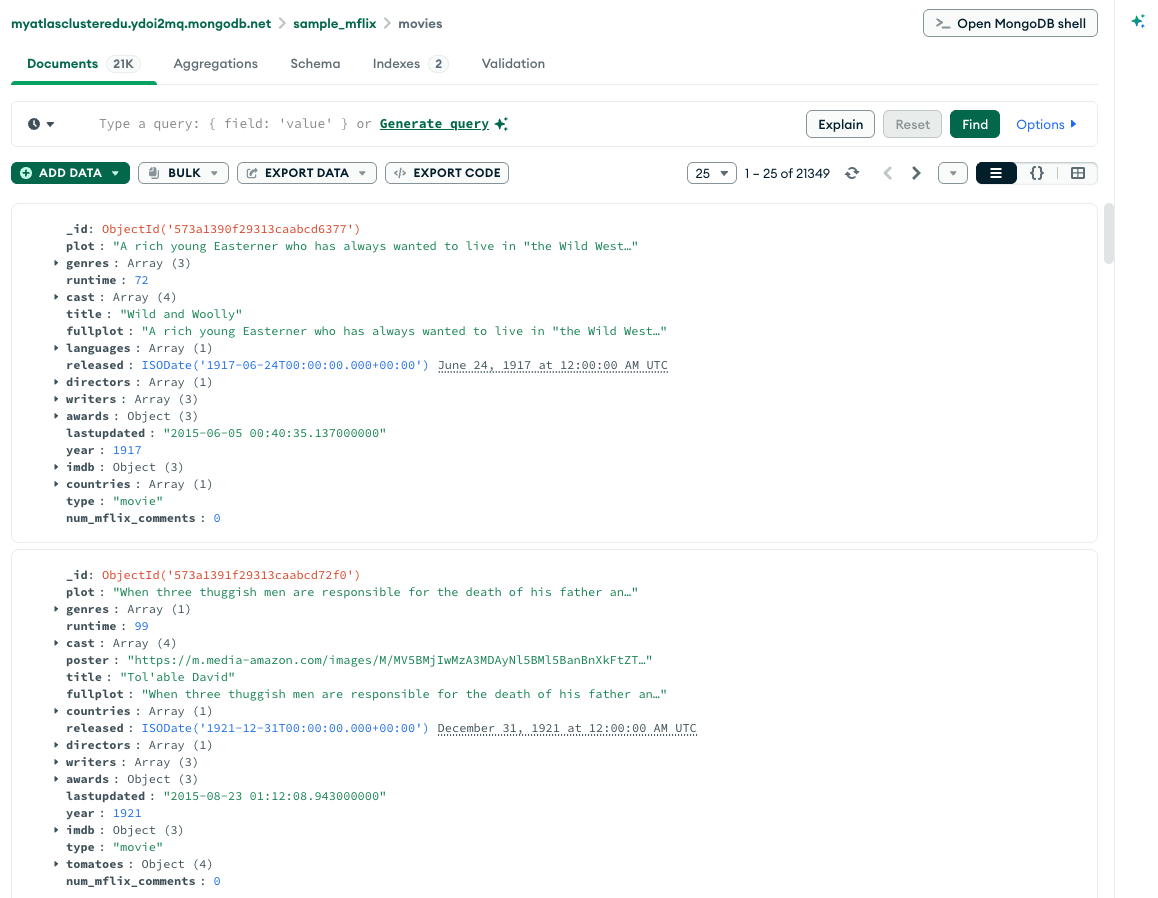
데이터셋을 로드한 후, MongoDB Compass를 동일한 배포서버에 연결하고 movies 컬렉션을 엽니다.
컬렉션 문서는 MongoDB Compass에 다음과 같이 나타납니다.
인덱스가 없는 쿼리
다음 쿼리는 year 필드의 값이 2000 ~ 2005 사이인 문서를 검색합니다.
db.movies.find( { year: { $gte: 2000, $lte: 2005 } } )이 쿼리는 컬렉션에 있는 21349 개의 문서 중 3809 개와 일치합니다.
선택한 쿼리 계획을 보려면 cursor.explain("executionStats") 커서 메서드를 find 명령의 끝에 연결합니다.
db.movies.find( { year: { $gte: 2000, $lte: 2005 } }).explain("executionStats"){ queryPlanner: { namespace: 'sample_mflix.movies', winningPlan: { stage: 'COLLSCAN', '...': '...' }, '...': '...' }, executionStats: { executionSuccess: true, nReturned: 3809, totalKeysExamined: 0, totalDocsExamined: 21349, executionStages: { stage: 'COLLSCAN', '...': '...' }, '...': '...' }, '...': '...'}컬렉션 스캔을 나타내기 위해
queryPlanner.winningPlan.stage에서COLLSCAN을 표시합니다.컬렉션 스캔은
mongod가 결과를 식별하기 위해 전체 컬렉션 문서를 문서별로 스캔해야 함을 나타냅니다. 이 작업은 일반적으로 비용이 많이 드는 작업이며 쿼리 속도가 느려질 수 있습니다.executionStats.nReturned은(는)3809을(를) 표시하여 우승한 쿼리 계획이 3,809 개의 문서를 반환한다는 것을 나타냅니다.executionStats.totalKeysExamined가0을 표시하여 이 쿼리가 인덱스를 사용하지 않음을 나타냅니다.executionStats.totalDocsExamined가21349을 표시하여 MongoDB가 일치하는 3,809 개의 문서를 찾기 위해 21,349 개의 문서(즉, 컬렉션의 모든 문서 스캔)를 스캔해야 함을 나타냅니다.
다음 쿼리는 year 필드의 값이 2000 ~ 2005 사이인 문서를 검색합니다.
다음 필터를 Compass 쿼리 표시줄에 복사하고 Find를 클릭합니다.
{ year: { $gte: 2000, $lte: 2005 } }이 쿼리는 컬렉션에 있는 21349 개의 문서 중 3809 개와 일치합니다.
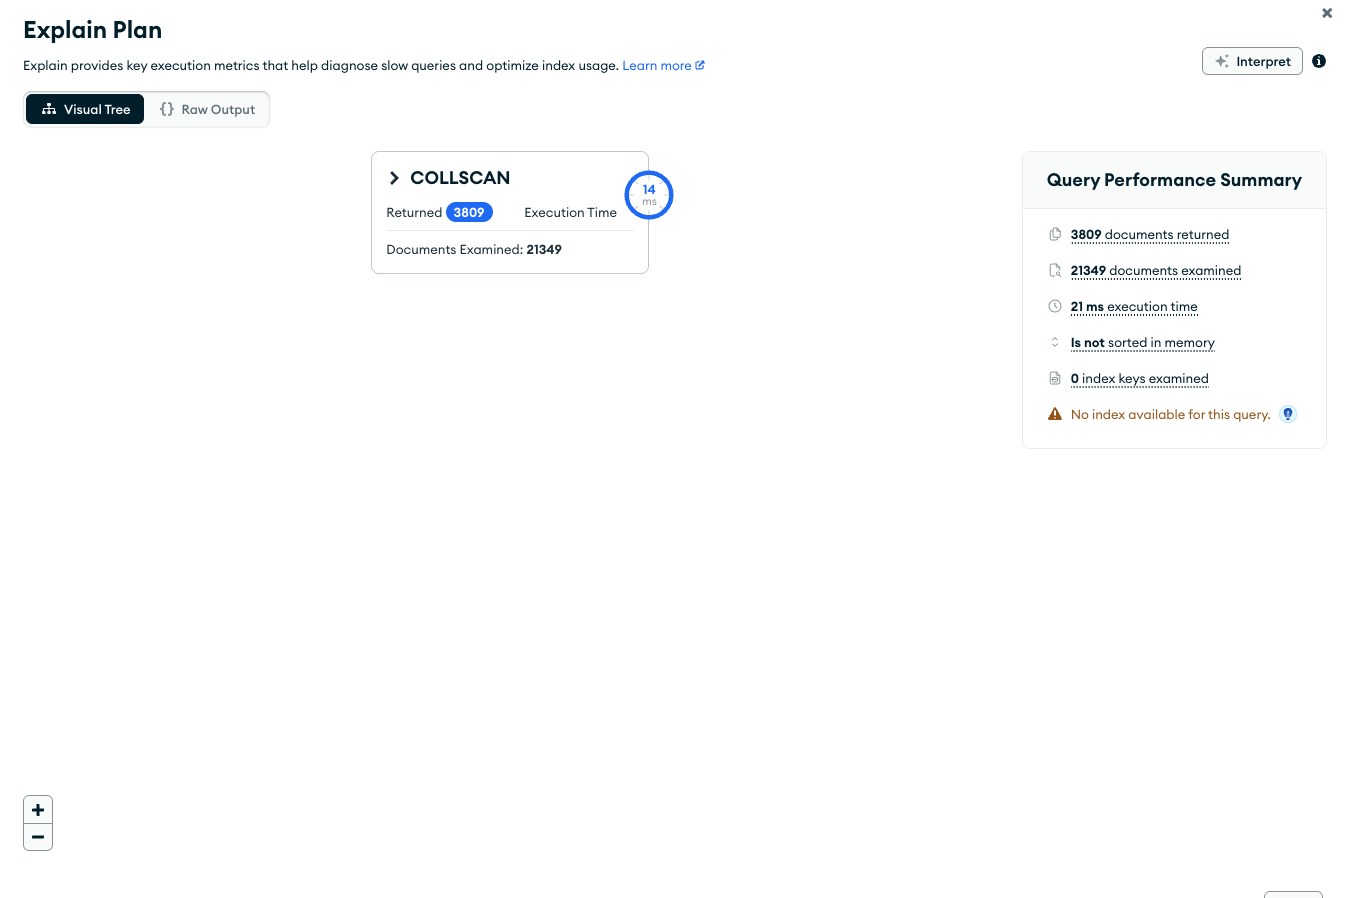
쿼리 계획을 보려면 쿼리 표시줄에서 Explain을(를) 클릭하세요.
MongoDB Compass는 다음과 같이 쿼리 계획을 표시합니다.
시각적 트리
Query Performance Summary은(는) 쿼리의 실행 통계를 보여줍니다.
Documents Returned 성공적인 쿼리 계획이 3,809 문서를 반환한다는 것을 나타내기 위해
3809을 표시합니다.Documents Examined 을
21349표시하여 MongoDB가 21 일치하는349 개의 문서를 찾기 위해 컬렉션의 모든, 문서를 스캔해야 3 809 했음을 나타냅니다.Index Keys Examined
0을 표시하여 이 쿼리가 인덱스를 사용하지 않음을 나타냅니다.
MongoDB Compass는
COLLSCAN쿼리 단계를 표시하여 이 쿼리에 컬렉션 스캔이 사용되었음을 나타냅니다. 컬렉션 스캔은mongod가 결과를 식별하기 위해 전체 컬렉션 문서를 문서별로 스캔해야 함을 나타냅니다. 이 작업은 일반적으로 비용이 많이 드는 작업이며 쿼리 속도가 느려질 수 있습니다.
Raw JSON
Raw Output 옵션을 클릭하여 원시 JSON 형식으로 Explain Plan 세부 정보를 볼 수도 있습니다.
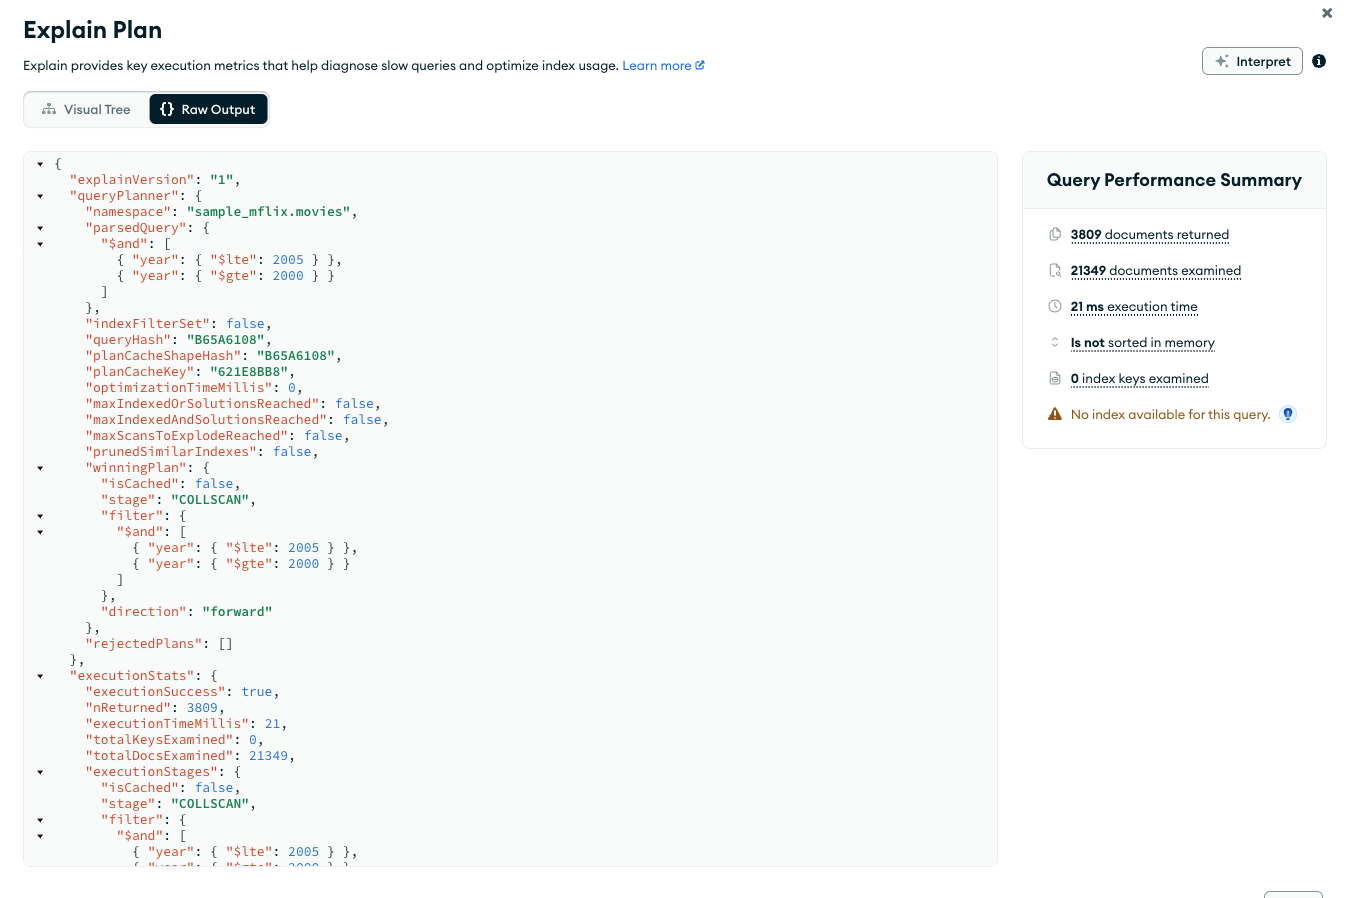
일치하는 문서 수와 검토된 문서 수의 차이는 효율성을 높이기 위해 쿼리에 인덱스를 사용하는 것이 도움이 될 수 있음을 시사할 수 있습니다.
인덱스가 있는 쿼리
year 필드에 대한 쿼리를 지원하려면 year 필드에 인덱스를 추가합니다.
db.movies.createIndex( { year: 1 } )쿼리 계획 통계를 보려면 explain() 메서드를 사용합니다.
db.movies.find( { year: { $gte: 2000, $lte: 2005 } }).explain("executionStats"){ queryPlanner: { namespace: 'sample_mflix.movies', winningPlan: { stage: 'FETCH', inputStage: { stage: 'IXSCAN', keyPattern: { year: 1 }, '...': '...' }, '...': '...' }, '...': '...' }, executionStats: { executionSuccess: true, nReturned: 3809, totalKeysExamined: 3809, totalDocsExamined: 3809, '...': '...' }, '...': '...'}queryPlanner.winningPlan.inputStage.stage가IXSCAN을 표시해 인덱스를 사용함을 나타냅니다.executionStats.nReturned은(는)3809을(를) 표시하여 우승한 쿼리 계획이 3,809 개의 문서를 반환한다는 것을 나타냅니다.executionStats.totalKeysExamined가3809을 표시해 MongoDB가 3,809 인덱스 항목을 스캔했음을 나타냅니다. 검사한 키의 수는 반환된 문서 수와 일치합니다. 즉,mongod함수가 결과를 반환하기 위해 인덱스 키만을 검색했음을나타냅니다.mongod는 모든 문서를 스캔할 필요가 없었고 일치하는 문서 3,809 만을 메모리로 가져왔습니다. 그 결과 매우 효율적인 쿼리가 생성됩니다.executionStats.totalDocsExamined는3809을 표시해 MongoDB가 3,809 문서를 스캔했음을 나타냅니다.
year 필드에 대한 쿼리를 지원하려면 year 필드에 인덱스를 추가합니다.
sample_mflix.moviescollection의 Indexes 탭을 클릭합니다.Create을 클릭한 다음 드롭다운 메뉴에서 Index을 선택합니다.
Select or type a field name 드롭다운 메뉴에서
year을(를) 선택합니다.Select a type 드롭다운 메뉴에서
1 (asc)을(를) 선택합니다.Create Index를 클릭합니다.
참고
인덱스 이름 필드를 비워두면 MongoDB Compass가 인덱스에 기본 이름을 생성합니다.
이제 Indexes 탭에서 새로 만든 인덱스를 볼 수 있습니다.
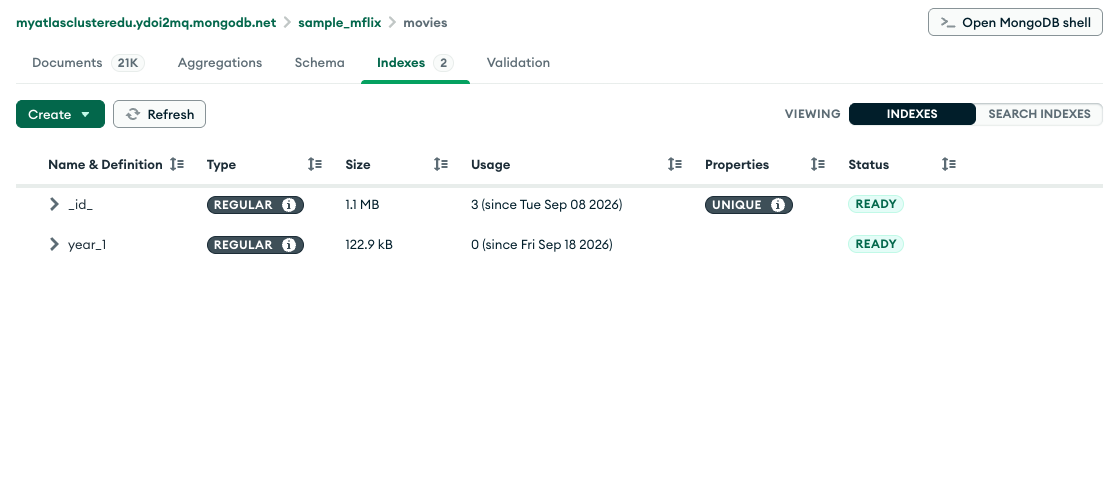
sample_mflix.movies 컬렉션에 대한 Documents 탭으로 돌아가서 이전 단계의 쿼리를 다시 실행합니다.
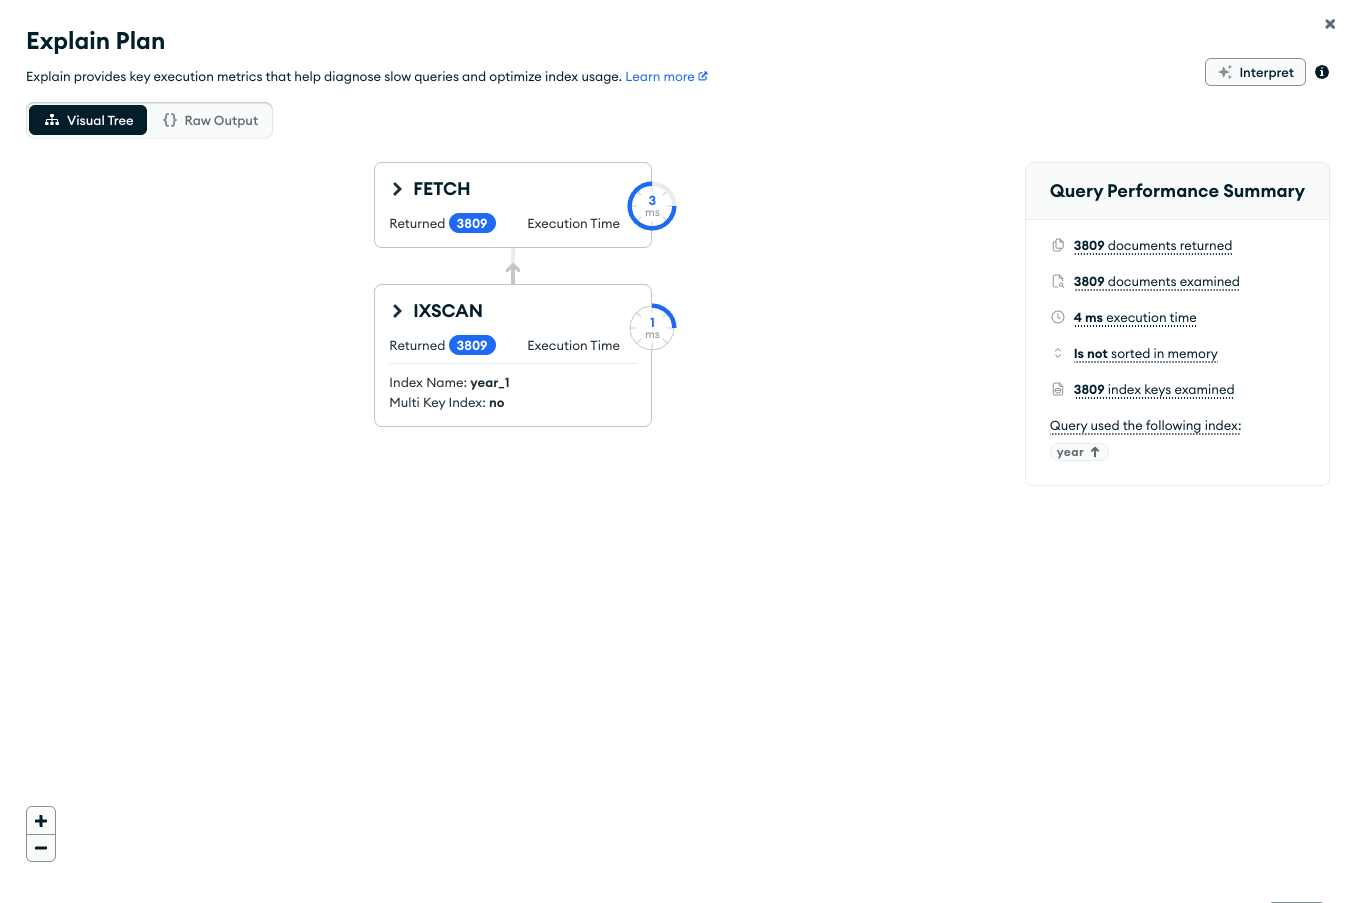
{ year: { $gte: 2000, $lte: 2005 } }Explain Plan 모달을 엽니다. MongoDB Compass는 다음과 같이 쿼리 계획을 표시합니다.
시각적 트리
Query Performance Summary은(는) 쿼리의 실행 통계를 보여줍니다.
Documents Returned 성공적인 쿼리 계획이 3,809 문서를 반환한다는 것을 나타내기 위해
3809을 표시합니다.Documents Examined
3809을 표시하면 MongoDB가 3,809 문서를 스캔했음을 나타냅니다.Query Performance Summary 하단에서 MongoDB Compass는 쿼리가
year인덱스를 사용했음을 보여줍니다.
Query Performance Summary의 왼쪽에서 MongoDB Compass는 쿼리 단계인
FETCH와IXSCAN을 표시합니다.IXSCAN은mongod가FETCH단계를 실행하고 문서를 조회하기 전에 쿼리를 만족시키기 위해 인덱스를 사용했음을 나타냅니다.
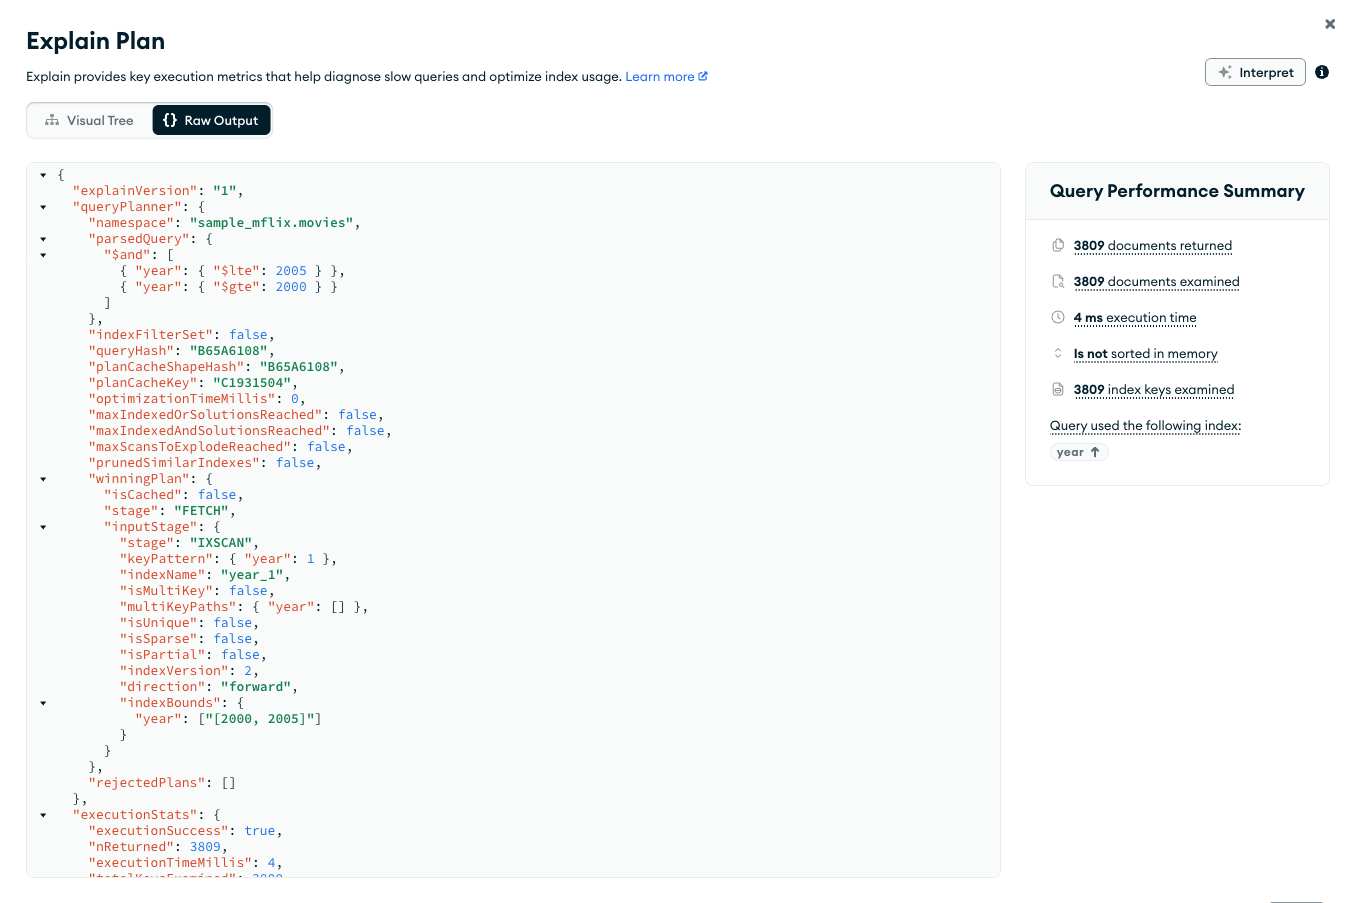
Raw JSON
Raw Output 옵션을 클릭하여 원시 JSON 형식으로 설명 세부 정보를 볼 수도 있습니다.
인덱스가 없으면 쿼리는 전체 컬렉션을 스캔하여 일치하는 문서를 반환합니다. 또한 쿼리는 각 문서 전체를 스캔하여 잠재적으로 해당 문서를 메모리로 가져와야 합니다. 이로 인해 비용이 많이 들고 쿼리 작업이 느려질 수 있습니다.
인덱스를 사용하여 쿼리를 실행하면 쿼리는 반환하는 만큼의 인덱스 항목과 문서만 스캔하므로 더 효율적인 쿼리가 됩니다.
인덱스의 성능을 비교합니다.
두 개 이상의 인덱스를 사용하는 쿼리의 성능을 수동으로 비교하려면 hint() 메서드를 explain() 메서드와 함께 사용하세요.
다음 쿼리를 생각해 보세요.
db.movies.find( { year: { $gte: 2000, $lte: 2005 }, rated: "PG"} )이 쿼리는 235 개의 문서와 일치합니다.
쿼리를 지원하려면 복합 인덱스를 추가하세요. 복합 인덱스의 경우, 필드의 순서가 중요합니다.
예를 들어, 다음 두 개의 복합 인덱스를 추가하세요. 첫 번째 인덱스는 year 필드를 먼저 기준으로 정렬하고, 그 다음 rated 필드를 기준으로 정렬합니다. 두 번째 인덱스는 먼저 rated를 기준으로 정렬하고, 그 다음 year 필드를 기준으로 정렬합니다.
db.movies.createIndex( { year: 1, rated: 1 } )db.movies.createIndex( { rated: 1, year: 1 } )첫 번째 인덱스가 쿼리에 미치는 영향을 평가하세요.
db.movies.find( { year: { $gte: 2000, $lte: 2005 }, rated: "PG" }).hint( { year: 1, rated: 1 } ).explain("executionStats"){ queryPlanner: { namespace: 'sample_mflix.movies', winningPlan: { stage: 'FETCH', inputStage: { stage: 'IXSCAN', keyPattern: { year: 1, rated: 1 }, '...': '...' }, '...': '...' }, '...': '...' }, executionStats: { executionSuccess: true, nReturned: 235, totalKeysExamined: 246, totalDocsExamined: 235, '...': '...' }, '...': '...'}MongoDB는 246개의 인덱스 키(executionStats.totalKeysExamined)를 스캔하여 235개의 일치하는 문서(executionStats.nReturned)를 반환했습니다.
두 번째 인덱스가 쿼리에 미치는 영향을 평가하세요.
db.movies.find( { year: { $gte: 2000, $lte: 2005 }, rated: "PG" }).hint( { rated: 1, year: 1 } ).explain("executionStats"){ queryPlanner: { namespace: 'sample_mflix.movies', winningPlan: { stage: 'FETCH', inputStage: { stage: 'IXSCAN', keyPattern: { rated: 1, year: 1 }, '...': '...' }, '...': '...' }, '...': '...' }, executionStats: { executionSuccess: true, nReturned: 235, totalKeysExamined: 235, totalDocsExamined: 235, '...': '...' }, '...': '...'}MongoDB는 235개의 인덱스 키(executionStats.totalKeysExamined)를 스캔하여 235개의 일치하는 문서(executionStats.nReturned)를 반환했습니다.
그렇기에 두 번째 복합 인덱스 { rated: 1, year: 1 }가 예시 쿼리를 지원하는 데 더 효율적인 인덱스입니다. 이 복합 인덱스를 사용하면 MongoDB 서버가 일치하는 모든 문서를 찾을 때 index keys 235 개만 스캔하면 되지만, 복합 인덱스 { year: 1, rated: 1 }를 사용할 때는 246 개를 스캔해야 하기 때문입니다.