Atlas Infinite는 컴퓨팅과 스토리지를 두 개의 독립적인 계층으로 분리합니다. 컴퓨팅 노드는 쿼리, 트랜잭션 및 집계를 실행합니다. 저장 계층은 데이터를 영구적으로 저장하고 고가용성을 위해 여러 복사본을 유지합니다. MongoDB는 컴퓨팅 계층과 독립적으로 저장 계층을 managed하므로 데이터 이동이나 복제 없이 확장 및 복구 작업을 실행할 수 있습니다.
다음 다이어그램은 Atlas Infinite가 애플리케이션, 컴퓨팅 및 저장 계층 전반에 걸쳐 Atlas 내에서 어떻게 구성되는지, 그리고 그 아래에 Atlas 관리 인터페이스가 어떻게 위치하는지 보여줍니다.
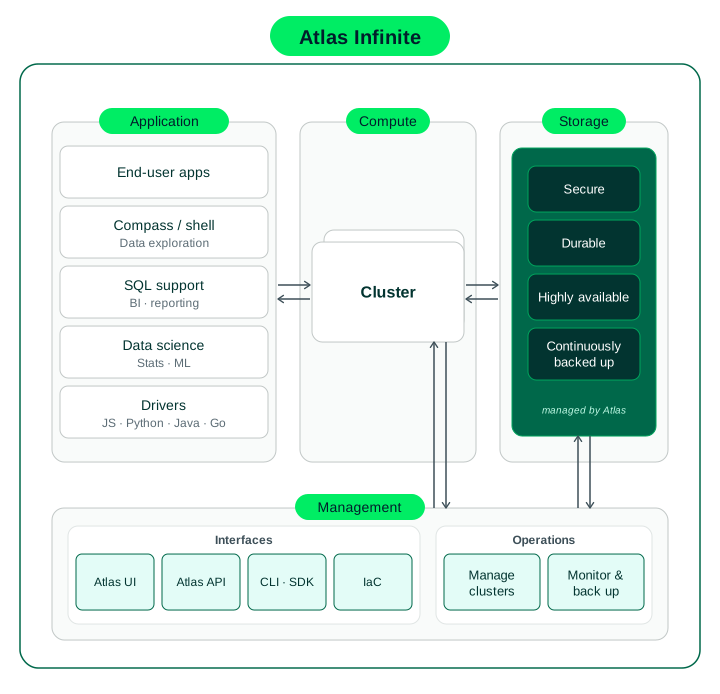
Atlas Infinite 컴퓨팅 및 저장이 Atlas 애플리케이션 및 관리 스택 내에 어떻게 포함되는가
컴퓨트 계층
컴퓨트 노드는 쿼리, 트랜잭션 및 집계를 실행하는 계층입니다. 컴퓨트 노드는 저장소와 분리되어 있으므로 저장소와 독립적으로 컴퓨트 용량을 확장할 수 있습니다. 수요가 증가하면 컴퓨트 용량을 추가하고 수요가 제거되면 다시 확장할 수 있습니다. 자동 확장을 활성화하면 Atlas가 사용자를 위해 컴퓨트를 조정합니다.
퍼블릭 프리미어 단계에서 Atlas는 클러스터의 리전 내 서로 다른 가용영역에 컴퓨팅 노드를 배포합니다.
저장 계층
Atlas Infinite의 저장 계층은 애플리케이션 데이터를 지속형으로 유지하며, 고가용성을 위해 여러 복사본을 관리합니다. Atlas Infinite를 사용하면 MongoDB는 애플리케이션의 워크로드를 실행하는 컴퓨팅 노드와 분리된 독립적인 계층으로 저장소를 관리합니다. 저장 계층은 컴퓨팅 계층과 독립적으로 복제를 처리하고, 읽기를 제공하며, 지속적인 백업을 제공합니다. 클러스터 계층을 확장하거나 컴퓨팅 노드에 장애가 발생하여 Atlas Infinite가 페일오버를 수행할 때, 애플리케이션의 데이터는 쿼리 처리를 위해 저장 계층에서 계속 사용할 수 있습니다. MongoDB는 이를 새 컴퓨팅 노드로 복사하지 않습니다.
보안
Atlas Infinite은 각 클러스터를 저장 계층 전반에서 격리합니다. Atlas는 저장 계층 내 통신을 위해 X.509 인증서로 내부 트래픽을 상호 인증합니다.
저장 계층이 공유되므로 각 고객의 데이터는 고객 간에 공유되지 않는 고유한 키로 암호화됩니다. 저장 계층은 이러한 키를 컴퓨팅 노드와 별도로 관리하므로 모든 컴퓨팅 노드가 수신하는 데이터를 복호화할 수 있습니다. Atlas가 Atlas Infinite 데이터를 암호화하는 방법을 알아보려면 Atlas 미사용 데이터 암호화 개요를 참조하세요.
복제 및 페일오버
Atlas Infinite 클러스터 에는 두 개의 선택 가능한 컴퓨팅 노드가 있습니다. 하나는 쓰기를 제공하는 프라이머리 이고, 다른 하나는 프라이머리 실패하거나 다시 시작될 때 인계받는 다른 투표 선택 가능 노드 입니다. 공개 미리 보기 중에 워크로드 격리 를 위해 읽기 전용 및 분석 노드를 최대 5개까지 추가할 수 있습니다. 그러면 클러스터 에는 총 최대 7개의 컴퓨팅 노드가 생깁니다. 다음 노드 유형을 추가할 수 있습니다.
읽기 전용 노드는 운영 워크로드에서 읽기를 제공.
분석 노드는 운영 워크로드에서 분석 쿼리를 격리합니다.
검색 노드는 MongoDB Search 및 MongoDB Vector Search 워크로드를 실행 . 검색 노드는 클러스터의 컴퓨팅 노드와 별개이며 5개 노드 제한에 포함되지 않습니다.
컴퓨트 노드는 프라이머리에 투표하지 않습니다. 저장 계층은 클러스터의 노드 간 투표 대신 페일오버를 조정합니다. 프라이머리가 실패하거나 다시 시작되면 스탠바이가 프라이머리가 됩니다. 저장 계층은 최신 데이터를 모든 컴퓨팅 노드에서 즉시 사용할 수 있도록 유지합니다. 페일오버로 인해 인덱스 생성이 중단되면 빌드가 자동으로 재개됩니다.
읽기 설정 (read preference)은 Atlas Core 클러스터에서와 동일하게 작동합니다. 모든 읽기 설정 (read preference) 모드와 사전 정의된 복제본 세트 태그를 지정하다를 사용할 수 있습니다.
애플리케이션의 드라이버가 읽기 설정 (read preference)을 설정합니다. 드라이버 기본값은 primary이므로, 읽기 설정 (read preference)을 변경하지 않으면 애플리케이션은 모든 읽기 작업을 프라이머리로 보냅니다.
Atlas Infinite 클러스터에는 하나의 대기 노드가 있습니다. 애플리케이션이 프라이머리가 아닌 노드에서 읽을 때, 읽기 전용 노드나 분석 노드를 추가하고 다른 읽기 설정 (read preference)을 설정하지 않는 한 해당 읽기는 대기 노드로 이동합니다. 다음 권장 사항을 사용하세요.
애플리케이션의 운영 읽기 작업을 하나 이상의 노드에서 제공하려면 읽기 전용 노드를 추가하세요. 읽기 전용 노드는
primary를 제외한 모든 읽기 설정 (read preference)에서 읽기 작업을 제공하므로, 추가하는 각 노드가 해당 트래픽의 일부를 처리합니다. 해당 읽기 작업을 스탠바이 노드와 읽기 전용 노드에 분산하려면secondaryPreferred의 읽기 설정 (read preference)을 지정하세요. 이렇게 하면 애플리케이션의 읽기 작업이 프라이머리에서 수행되지 않으며 단일 스탠바이 노드에 과부하가 걸리는 것을 방지할 수 있습니다. Atlas Core 클러스터에서는 여러 세컨더리가 노드를 추가하지 않고도 이러한 읽기 작업을 분산합니다.분석과 같은 워크로드를 애플리케이션의 운영 읽기에서 격리하려면 분석 노드 또는 읽기 전용 노드를 추가하고 사전 정의된 복제본 세트 태그를 지정 하여 사용하여 해당 노드로 쿼리를 전달합니다.
모든 노드에 더 많은 읽기 제공 용량을 제공하려면 클러스터 계층을 확장하세요.
백업, 복원 및 특정 시점 복구는 저장 계층에서 작동합니다. 백업 및 복원에 대해 학습하려면 Atlas Infinite 클러스터 복원을 참조하세요.
Atlas Infinite 클러스터의 쓰기 고려 (write concern)
쓰기 고려 (write concern)는 쓰기 (write) 작업에 대해 MongoDB에서 요청하는 승인 수준을 설명합니다.
이 섹션에서는 Atlas Infinite 클러스터의 쓰기 고려 (write concern) 기본값, Atlas가 각 쓰기 고려 (write concern) 필드를 처리하는 방법, 그리고 Atlas Core 클러스터와 쓰기 고려 (write concern)가 어떻게 다른지 설명합니다.
Atlas Infinite 클러스터에서 저장 계층은 데이터를 저장 및 복제하며, 저장 계층이 쓰기 (write)를 캡처하면 Atlas는 해당 쓰기 (write)를 승인합니다.
Atlas Infinite 클러스터에서 기본값 쓰기 고려 (write concern)는 w: "majority"입니다. 애플리케이션은 연결 문자열 또는 단일 쓰기 (write) 작업에 대해 쓰기 고려 (write concern)를 설정합니다. Atlas UI에서는 기본값을 변경할 수 없습니다.
Atlas는 애플리케이션이 보내는 모든 쓰기 고려(write concern)를 허용하고 필요한 경우 Atlas Infinite 클러스터가 지원하는 값으로 수정하므로 애플리케이션의 쓰기 고려(write concern)는 계속 작동합니다.
Atlas Infinite 클러스터에서 Atlas는 쓰기 고려 (write concern) 필드를 다음과 같이 처리하다.
애플리케이션은 쓰기 (write) 인증 수준을 설정합니다로
w:애플리케이션에서
w을(를) 설정하지 않으면 Atlas는 기본값인w: "majority"을(를) 적용합니다. Atlas Infinite 클러스터에서"majority"은(는) 클러스터의 노드 과반수가 아니라 저장 계층 내의 과반수를 의미합니다. Atlas는w: "majority"쓰기 (write)를 절대 롤백하지 않습니다.애플리케이션이
w을(를)0또는1(으)로 설정하면 Atlas는 애플리케이션이 설정한 값을 적용합니다.w: 0요청은 승인을 요구하지 않습니다.w: 1쓰기 (write)는w: "majority"쓰기 (write)보다 빨리 반환되지만 드문 오류 발생 시 Atlas가 롤백할 수 있습니다.애플리케이션에서
w을(를)2또는2보다 큰 숫자로 설정하면 Atlas는w: "majority"을(를) 적용합니다.
애플리케이션에서 제한 시간을 설정하려면
wtimeout(연결 문자열의wtimeoutMS), 밀리초 단위.wtimeout은(는) 기본값을 사용하는 쓰기 (write)를 포함하여w: "majority"쓰기 (write)에 적용됩니다.애플리케이션이
wtimeout을(를) 설정한 경우, Atlas가 승인할 수 없는 쓰기(write)는wtimeout제한에 도달하면 쓰기 고려 (write concern) 오류를 반환합니다.애플리케이션에서
wtimeout을(를) 설정하지 않으면 쓰기 (write)가 무기한 대기 상태가 되어 애플리케이션이 차단됩니다.
Atlas는 항상 적용됩니다
j: true. 저장 계층은 Atlas가 쓰기 (write)를 승인하기 전에 노드의 메모리 외부에서 각 쓰기 (write)를 유지합니다. 애플리케이션의j설정은 이 동작에 영향을 미치지 않습니다.
Atlas Infinite 클러스터와 Atlas Core 클러스터 간의 쓰기 고려 (write concern)는 다음과 같은 차이점이 있습니다.
Atlas Infinite 클러스터에서
w을(를)0,1또는"majority"(으)로 설정합니다.w: 1및w: "majority"의 경우 저장 계층에서 쓰기 (write)를 보장합니다.w: 0의 경우 저장 계층에서 쓰기 (write)를 확인하지 않습니다. Atlas Core 클러스터에서w을(를) 숫자로 설정하여 해당 노드 수만큼의 요청 확인을 받을 수도 있습니다.Atlas Infinite 클러스터에서 Atlas는 항상
j: true을(를) 적용하며, 저널 승인을 비활성화할 수 없습니다. Atlas Core 클러스터에서는j: false을(를) 사용하여 저널 승인을 끌 수 있습니다.
Atlas Infinite 클러스터의 oplog
Atlas Infinite 클러스터에서 oplog 컬렉션인 local.oplog.rs은 복제가 저장 계층에서 처리되므로 복제를 제공하지 않습니다. 이 컬렉션은 변경 스트림과 제한된 기록이 필요한 일부 내부 기능을 제공합니다. 컬렉션은 클러스터의 저장 데이터로 계산됩니다.
복제는 oplog 컬렉션을 사용하지 않습니다. Atlas Infinite 클러스터에서 복제는 저장 계층에서 발생하며, Atlas는 oplog 컬렉션인
local.oplog.rs도 그곳에 저장합니다. 모든 노드가 저장 계층에서 읽기 때문에 클러스터에 새로 참여하거나 다시 참여하는 노드는 oplog window 뒤처질 수 없습니다. 자세히 알아보려면 복제 및 페일오버를 참조하세요.Atlas가 항목을 보관하는 기간. Atlas는 모든 oplog 항목을 최소 oplog 보존 창 동안 보관합니다. 항목이 창보다 오래되면 Atlas는 이를 삭제합니다. Atlas Infinite 및 Atlas Core에서 기본값 최소 oplog 보존 창은 24 시간입니다. Additional Settings에서 최소 oplog 보존 창을 설정 하여 클러스터가 보관할 기록의 양을 결정할 수 있습니다.
운영 경험
애플리케이션은 코드 변경 없이 Atlas Infinite에서 실행됩니다. Atlas Infinite는 MongoDB 유선 프로토콜을 사용하므로 애플리케이션은 MongoDB 드라이버 및 기타 연결 방법을 사용하여 Atlas Infinite 클러스터에 연결합니다. MongoDB 프로그래밍 도구를 사용하여 클러스터에 액세스하고 관리할 수도 있습니다.