Atlas Infinite 将计算与存储分离为两个独立的层。计算节点运行您的查询、事务和聚合。存储层持久存储您的数据,并维护多个副本以实现高可用性。MongoDB 独立于计算层托管存储层,因此扩展和恢复操作运行无需移动或复制数据。
下图展示了 Atlas Infinite 如何融入 Atlas,跨越应用程序、计算和存储层,下方是 Atlas 管理界面。
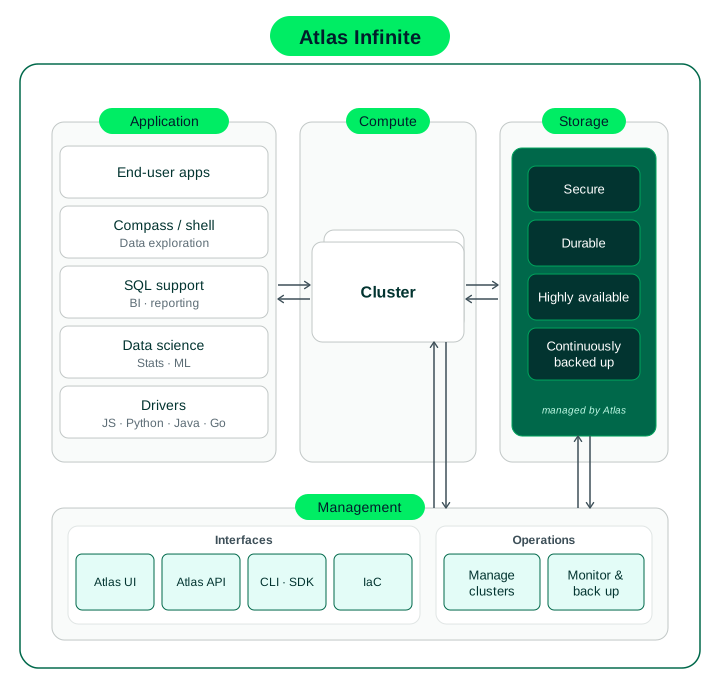
如何将 Atlas Infinite 计算和存储集成到 Atlas 应用程序和管理堆栈
计算层
计算节点是运行查询、事务和聚合的层。由于计算节点与存储解耦,您可以独立于存储扩展计算容量。您可以随着需求的增长增加计算容量,并在需求下降时将其扩展。如果您启用自动伸缩,Atlas 会为您调整计算资源。
在公共预览版中,Atlas 会将您的计算节点部署在集群区域内的不同可用区中。
存储层
Atlas Infinite 中的存储层可确保应用程序数据的持久性,并维护多个副本以实现高可用性。借助 Atlas Infinite,MongoDB 将存储作为独立层进行托管,与运行应用程序工作负载的计算节点分离。存储层负责处理复制、提供读取服务并提供持续备份,独立于计算层。当您扩展集群层,或者当计算节点发生故障且 Atlas Infinite 执行故障转移时,应用程序的数据仍可在存储层中用于提供查询服务。MongoDB 不会将其复制到新的计算节点。
安全性
Atlas Infinite 将每个集群隔离在存储层中。Atlas 使用 X.509 证书对存储层内的通信进行内部流量相互身份验证。
由于存储层是共享的,每个客户数的数据都使用唯一的密钥进行加密,这些密钥绝不会在客户数之间共享。存储层将这些密钥与计算节点分开管理,因此每个计算节点都可以解密其接收到的数据。要学习;了解Atlas如何加密Atlas Infinite 数据,请参阅Atlas静态加密概述。
复制和故障转移
一个Atlas Infinite集群有两个可选举计算节点:一个主节点 (primary node in the replica set)(用于写入)和一个备用节点(另一个可选举节点,在主节点 (primary node in the replica set)故障或重新启动时接管)。在公共预览期间,您最多可以添加五个只读节点和分析节点以进行工作负载隔离性。这样,您的集群总共最多有七个计算节点。您可以添加以下节点类型:
只读节点为操作工作负载的读取请求提供服务。
分析节点将分析查询与您的操作工作负载隔离开来。
计算节点不参与主节点 (primary node in the replica set) 的选举。存储层负责协调故障转移,而不是在集群的节点之间进行选举。当主节点 (primary node in the replica set) 发生故障或重启时,备用节点将成为主节点 (primary node in the replica set)。存储层确保每个计算节点都能随时访问您的最新数据。如果故障转移中断了索引构建,构建会自动恢复。
读取偏好(read preference)的工作方式与在 Atlas Core 集群上相同。您可以使用所有 读取偏好(read preference)模式和预定义的副本集标签。
应用程序的驱动程序设置读取偏好(read preference)。驱动程序默认值为 primary,因此除非您更改读取偏好(read preference),否则您的应用程序会将每次读取发送到主节点 (primary node in the replica set)。
Atlas Infinite 集群具有一个备用节点。当您的应用程序从主节点 (primary node in the replica set) 以外的节点读取数据时,这些读取操作会发送到该备用节点,除非您添加了只读节点或分析节点并设置了不同的读取偏好(read preference)。请遵循以下建议:
若要从多个节点为应用程序的操作读取提供服务,请添加只读节点。只读节点可以提供除
primary之外的任何读取偏好(read preference)的读取服务,因此您添加的每个节点都会分担部分流量。要将这些读取操作分配到备用节点和只读节点,请设置secondaryPreferred的读取偏好(read preference)。这可以使应用程序的读取操作远离主节点 (primary node in the replica set),并避免使单个备用节点过载。在 Atlas Core 集群上,多个从节点(secondary node from replica set)无需添加节点即可分散这些读取。为了让每个节点有更多的容量来提供读取服务,请扩展集群层。
备份、恢复和时间点恢复在存储层运行。要了解备份和恢复,请参阅 恢复 Atlas Infinite 集群。
Atlas Infinite 集群上的写关注(write concern)
写关注(write concern)描述了您从 MongoDB 请求的写入操作确认级别。
本节介绍了 Atlas Infinite 集群上的默认写关注(write concern)、Atlas 如何处理每个写关注(write concern)字段,以及写关注(write concern)与 Atlas Core 集群的区别。
在 Atlas Infinite 集群上,存储层会存储并复制您的数据,一旦存储层捕获到您的写入,Atlas 就会确认该写入。
在 Atlas Infinite 集群上,默认写关注(write concern)为 w: "majority"。您的应用程序在连接字符串中或针对单个写入操作设置写关注(write concern)。您无法在 Atlas 用户界面中更改默认设置。
Atlas 接受您的应用程序发送的任何写关注(write concern),并在必要时将其修改为 Atlas Infinite 集群支持的值,以便您的应用程序的写关注(write concern)可以持续工作。
在 Atlas Infinite 集群上,Atlas 对写关注(write concern)字段的处理方式如下:
您的应用程序可以通过以下方式设置写入确认级别
w:如果您的应用程序未设置
w,Atlas 将应用默认值w: "majority"。在 Atlas Infinite 集群上,"majority"指的是存储层中的大多数,而不是集群节点中的大多数。Atlas 绝不会回滚w: "majority"写入。如果您的应用程序将
w设置为0或1,Atlas 将应用您的应用程序设置的值。w: 0请求不需要确认。w: 1写入的返回速度比w: "majority"写入快,但在极少数故障情况下,Atlas 可能会回滚它。如果您的应用程序将
w设置为2或任何大于2的数字,Atlas 将应用w: "majority"。
您的应用程序可以使用以下方式设置时间限制:
wtimeout(连接字符串中的wtimeoutMS),以毫秒为单位。wtimeout应用于w: "majority"写入,包括使用默认的写入:如果您的应用程序设置了
wtimeout,则当写入达到wtimeout限制时,Atlas 无法确认的写入将返回写关注(write concern)错误。如果您的应用程序未设置
wtimeout,则写入操作将无限期等待并阻塞您的应用程序。
Atlas 始终应用
j: true在 Atlas 确认写入之前,存储层会将每次写入持久化到节点内存之外。您的应用程序的j设置对此行为没有影响。
Atlas Infinite 集群和 Atlas Core 集群之间的写关注(write concern)存在以下差异:
在 Atlas Infinite 集群上,您可以将
w设置为0、1或"majority"。对于w: 1和w: "majority",存储层会提供您的 ACID 一致性保证写入。对于w: 0,存储层不会确认您的写入。在 Atlas Core 集群上,您还可以将w设置为一个数字,这会请求来自相应数量节点的确认。在 Atlas Infinite 集群上,Atlas 始终应用
j: true,并且您无法禁用日志确认。在 Atlas Core 集群上,您可以使用j: false关闭日志确认。
Atlas Infinite 集群上的 oplog
在 Atlas Infinite 集群上,oplog 集合 local.oplog.rs 不提供服务复制功能,因为复制是在存储层处理的。该集合为变更流和一些需要有限历史记录的内部功能提供服务。该集合计入集群的存储数据。
复制不使用 oplog 集合。在 Atlas Infinite 集群上,复制发生在存储层,Atlas 也会在那里存储 oplog 集合
local.oplog.rs。每个节点都从存储层读取数据,因此加入或重新加入集群的节点不会落后于 oplog window。要了解更多信息,请参阅复制和故障转移。Atlas 保留条目的时长。Atlas 会将每个 oplog 条目至少保留最短的 oplog 保留窗口时长。一旦条目超过该窗口,Atlas 就会将其删除。在 Atlas Infinite 和 Atlas Core 中,默认的最短 oplog 保留窗口为 24 小时。您可以在 Additional Settings 中设置最短 oplog 保留窗口,以确定集群保留的历史记录量。
oplog 集合如何影响数据大小和费用。oplog 集合记录对集群的每次写入。oplog 集合计入集群中存储的数据和存储费用,与 Atlas Core 集群相同。Atlas 为 连续云备份 保留的历史记录属于备份费用的一部分。该历史记录不计入集群存储。要了解详情,请参阅MongoDB Atlas Infinite 集群费用。
运维经验
您的应用程序无需更改代码即可在 Atlas Infinite 上运行。Atlas Infinite 使用 MongoDB 传输协议,因此您的应用程序使用 MongoDB 驱动程序和其他连接方法连接到您的 Atlas Infinite 集群。您还可以使用 MongoDB 编程工具访问和管理集群。