このページでは、当社のMongoDB ベクトル検索 パフォーマンスベンチマークの結果を探ります。MongoDB は様々な実装ニーズに対応する幅広い範囲のソリューションを提供しています。カスタマーは、各カスタマーのビジネス設定に適したパフォーマンスと精度のレベルを選択できます。
結果の概要
2048 次元で
voyage-3-large埋め込みを使用する 15.3M ベクトルでは、量子化が構成されたMongoDB ベクトル検索 は90-95% の精度を維持し、 クエリレイテンシは 50 ミリ秒未満です。バイナリ量子化は、インデックスの提供コストの約4分の1という、より安価なソリューションを提供します。フルフィデリティのベクトルで再スコアリングを行うため、多くの大規模なワークロードに適したオプションとなる可能性がありますが、パフォーマンスがニーズに合っていることを確認するために、サンプルデータセットでテストを実行することをお勧めします。
量子化を使用して大規模なワークロードを実行する場合は、1024を超える次元が推奨されます。
選択的フィルターにより、
numCandidatesに選択された値によってパフォーマンスが改善または低下する可能性があります。バイナリ量子化の再スコアリングにかかる追加コストは、並行処理が多いワークロードを実行する際にスループットの低下として現れます。
シャーディングによりスループットが若干向上しますが、スループットを向上させるためには、検索ノード数または検索ノードで使用可能なコアの数をスケールアウトすることをお勧めします。
多次元ベンチマークにおけるリコールとレイテンシの分析
最初の結果セットは、ベクトルの複数次元(256、512、1024、2048)を含む5.5Mドキュメントデータセットに対して実行されたテストを示します。すべては、各ドキュメント内でvoyage-3-largeを使用して生成されました。
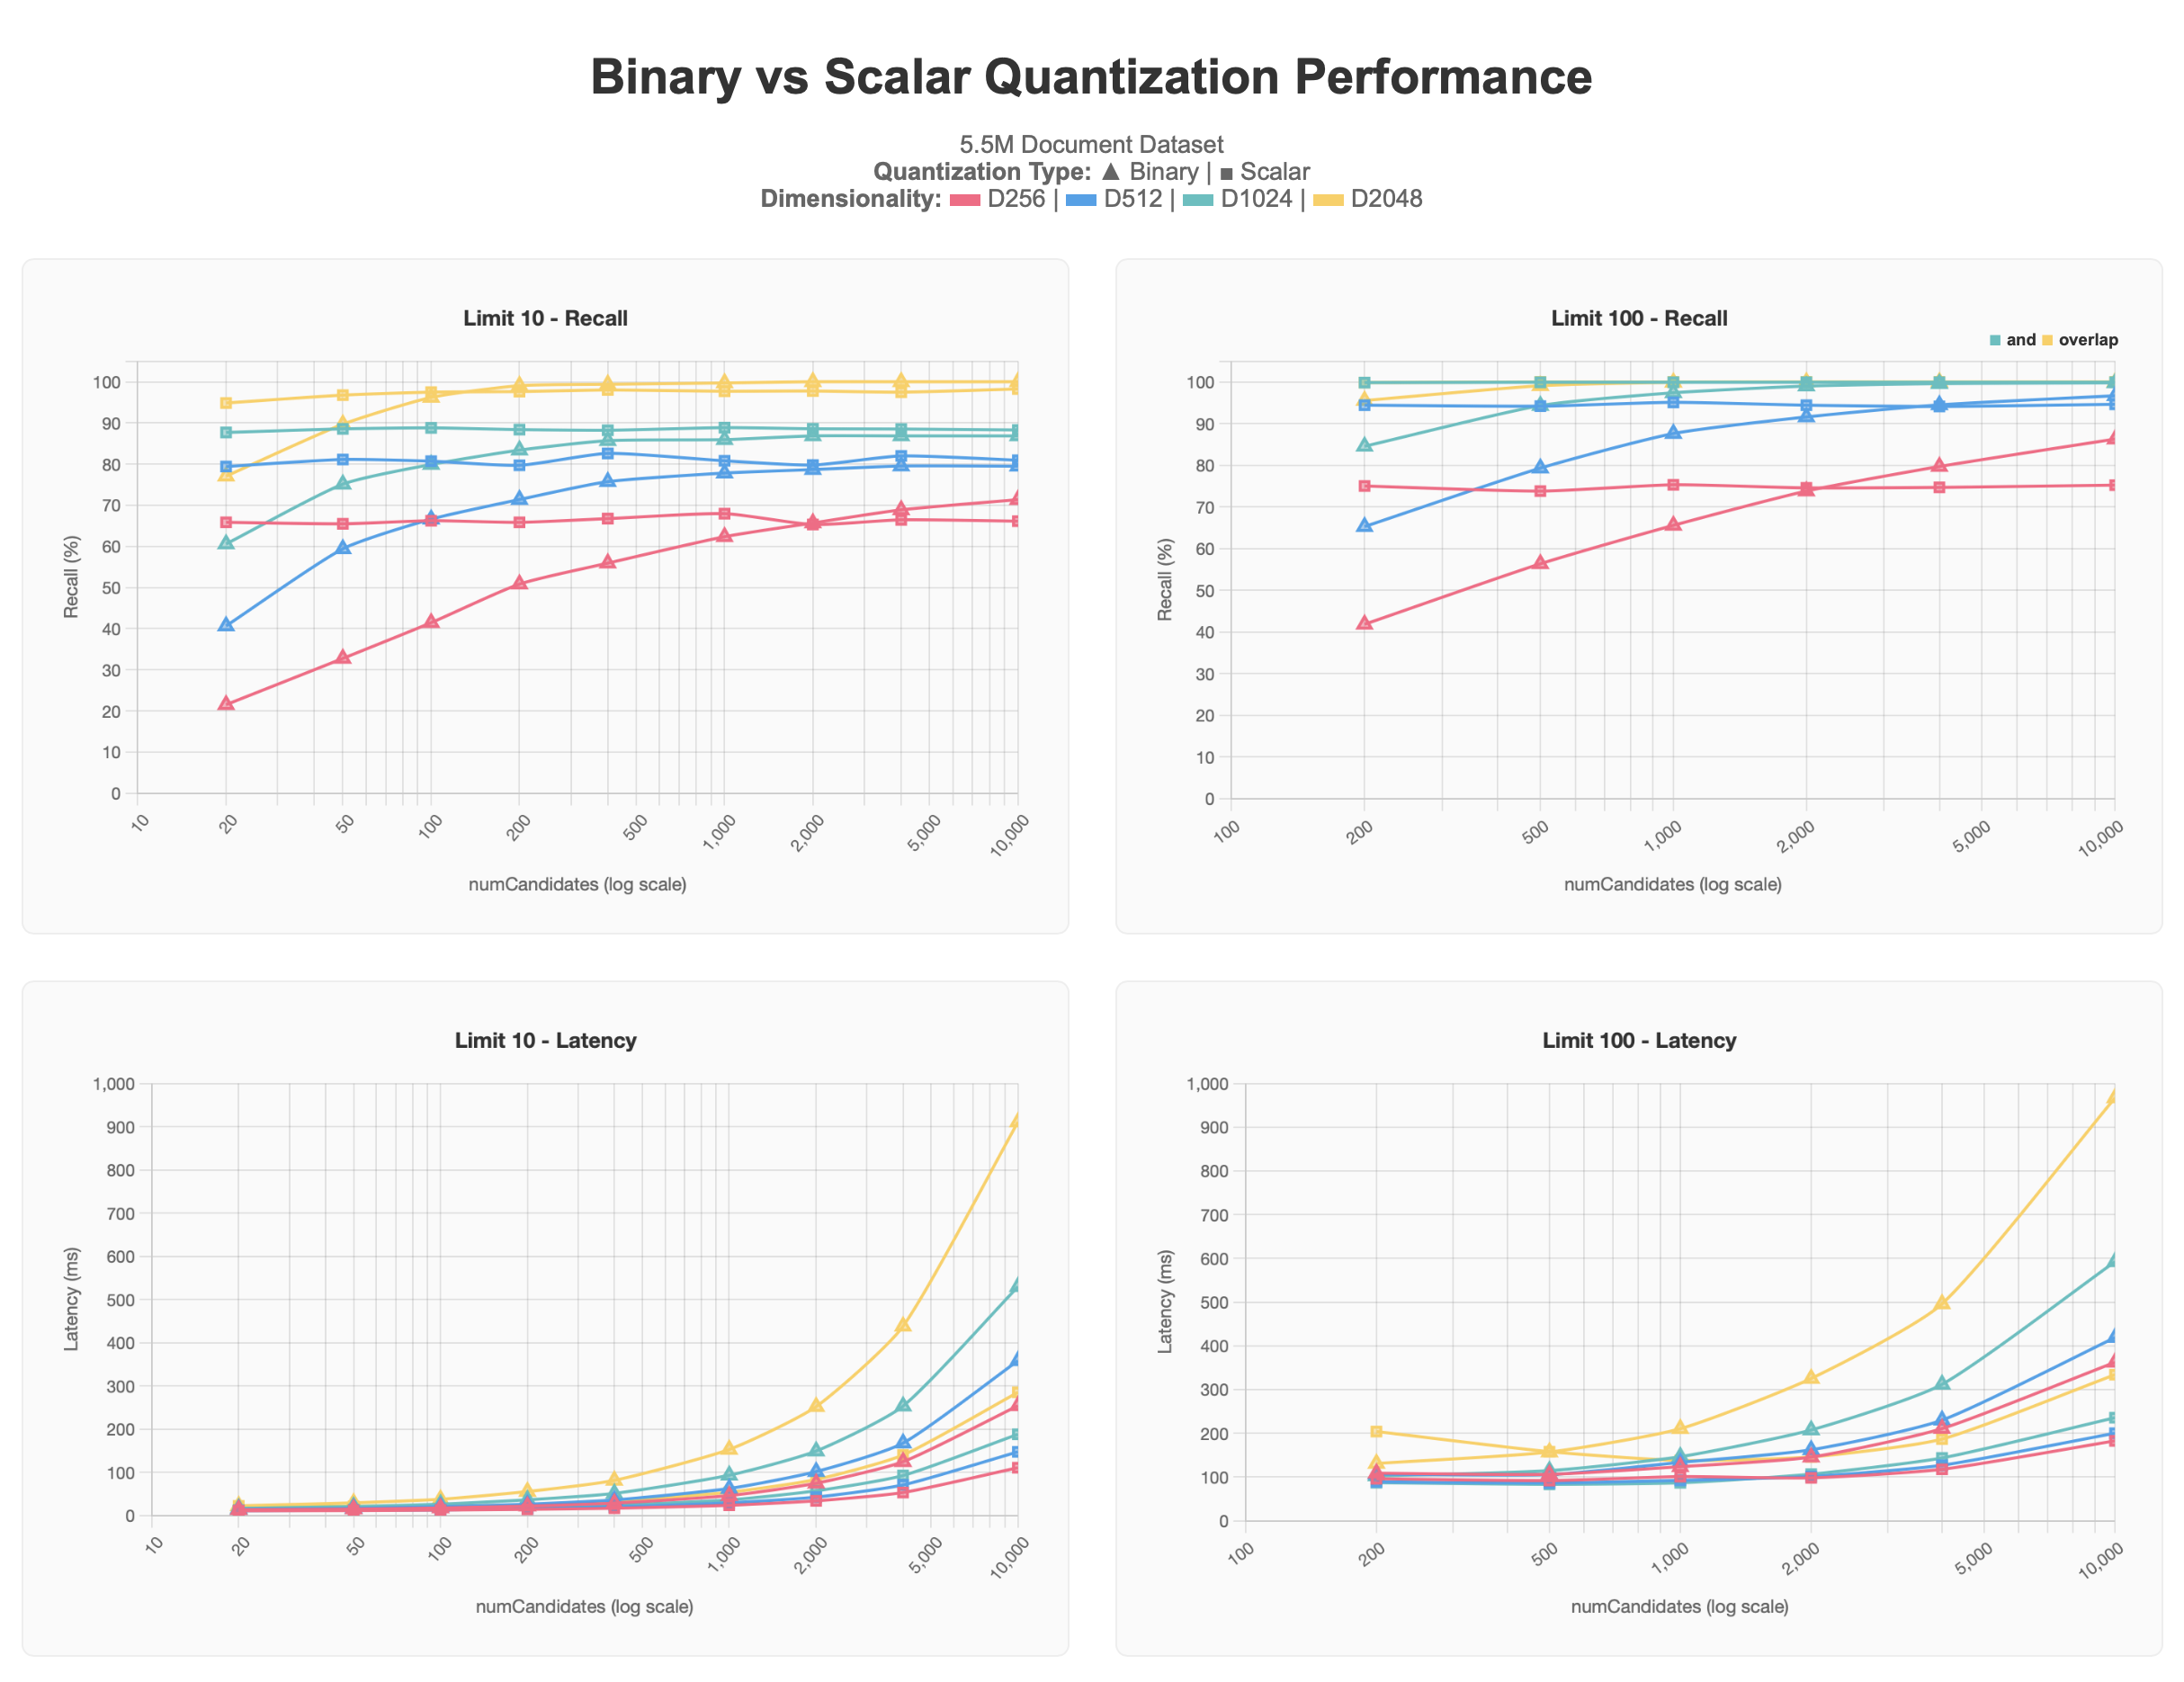
スカラー量子化された結果は、すべてバイナリ量子化された結果よりも高いレベルで始まりますが、numCandidates が増加しても非単調レベルに維持されます。逆に、バイナリ定量化クエリでは、numCandidates が要求されるにつれて、より正確な結果が得られ、スカラー量子化の非公式に近似し、場合によってはそれを渡すと、レイテンシが高く、特に 1000 の numCandidates を超えるようにコストます。
limit の値が低い場合、クエリは最上位の結果に対してより選択的であるため、100% の精度に近づくには一般的により高い numCandidates が必要になります。この効果はバイナリ量子化プロットで特に見られます。高次元ベクトル(1024d 以上)は、表現が豊富になると近隣のベクトルを区別しやすくなるため、より低い numCandidates で 90~95%の目標範囲に達します。limit によって結果を 100 して 90-95% の目標範囲に達するテストは、limit によって結果を 10 するテストよりも低い numCandidates です。なぜなら、結果セットが大きいほど、検索で関連する近隣を表面化する機会が増えるためです。
この情報を踏まえ、大規模なデータセットを扱う際は、量子化を使用せず低次元で行う代わりに、1024d以上の次元を使用してスケーリングに量子化を適用することをお勧めします。ユースケースにリクエストされたベクトル量も要因として働きます。
より大規模なベンチマーク結果
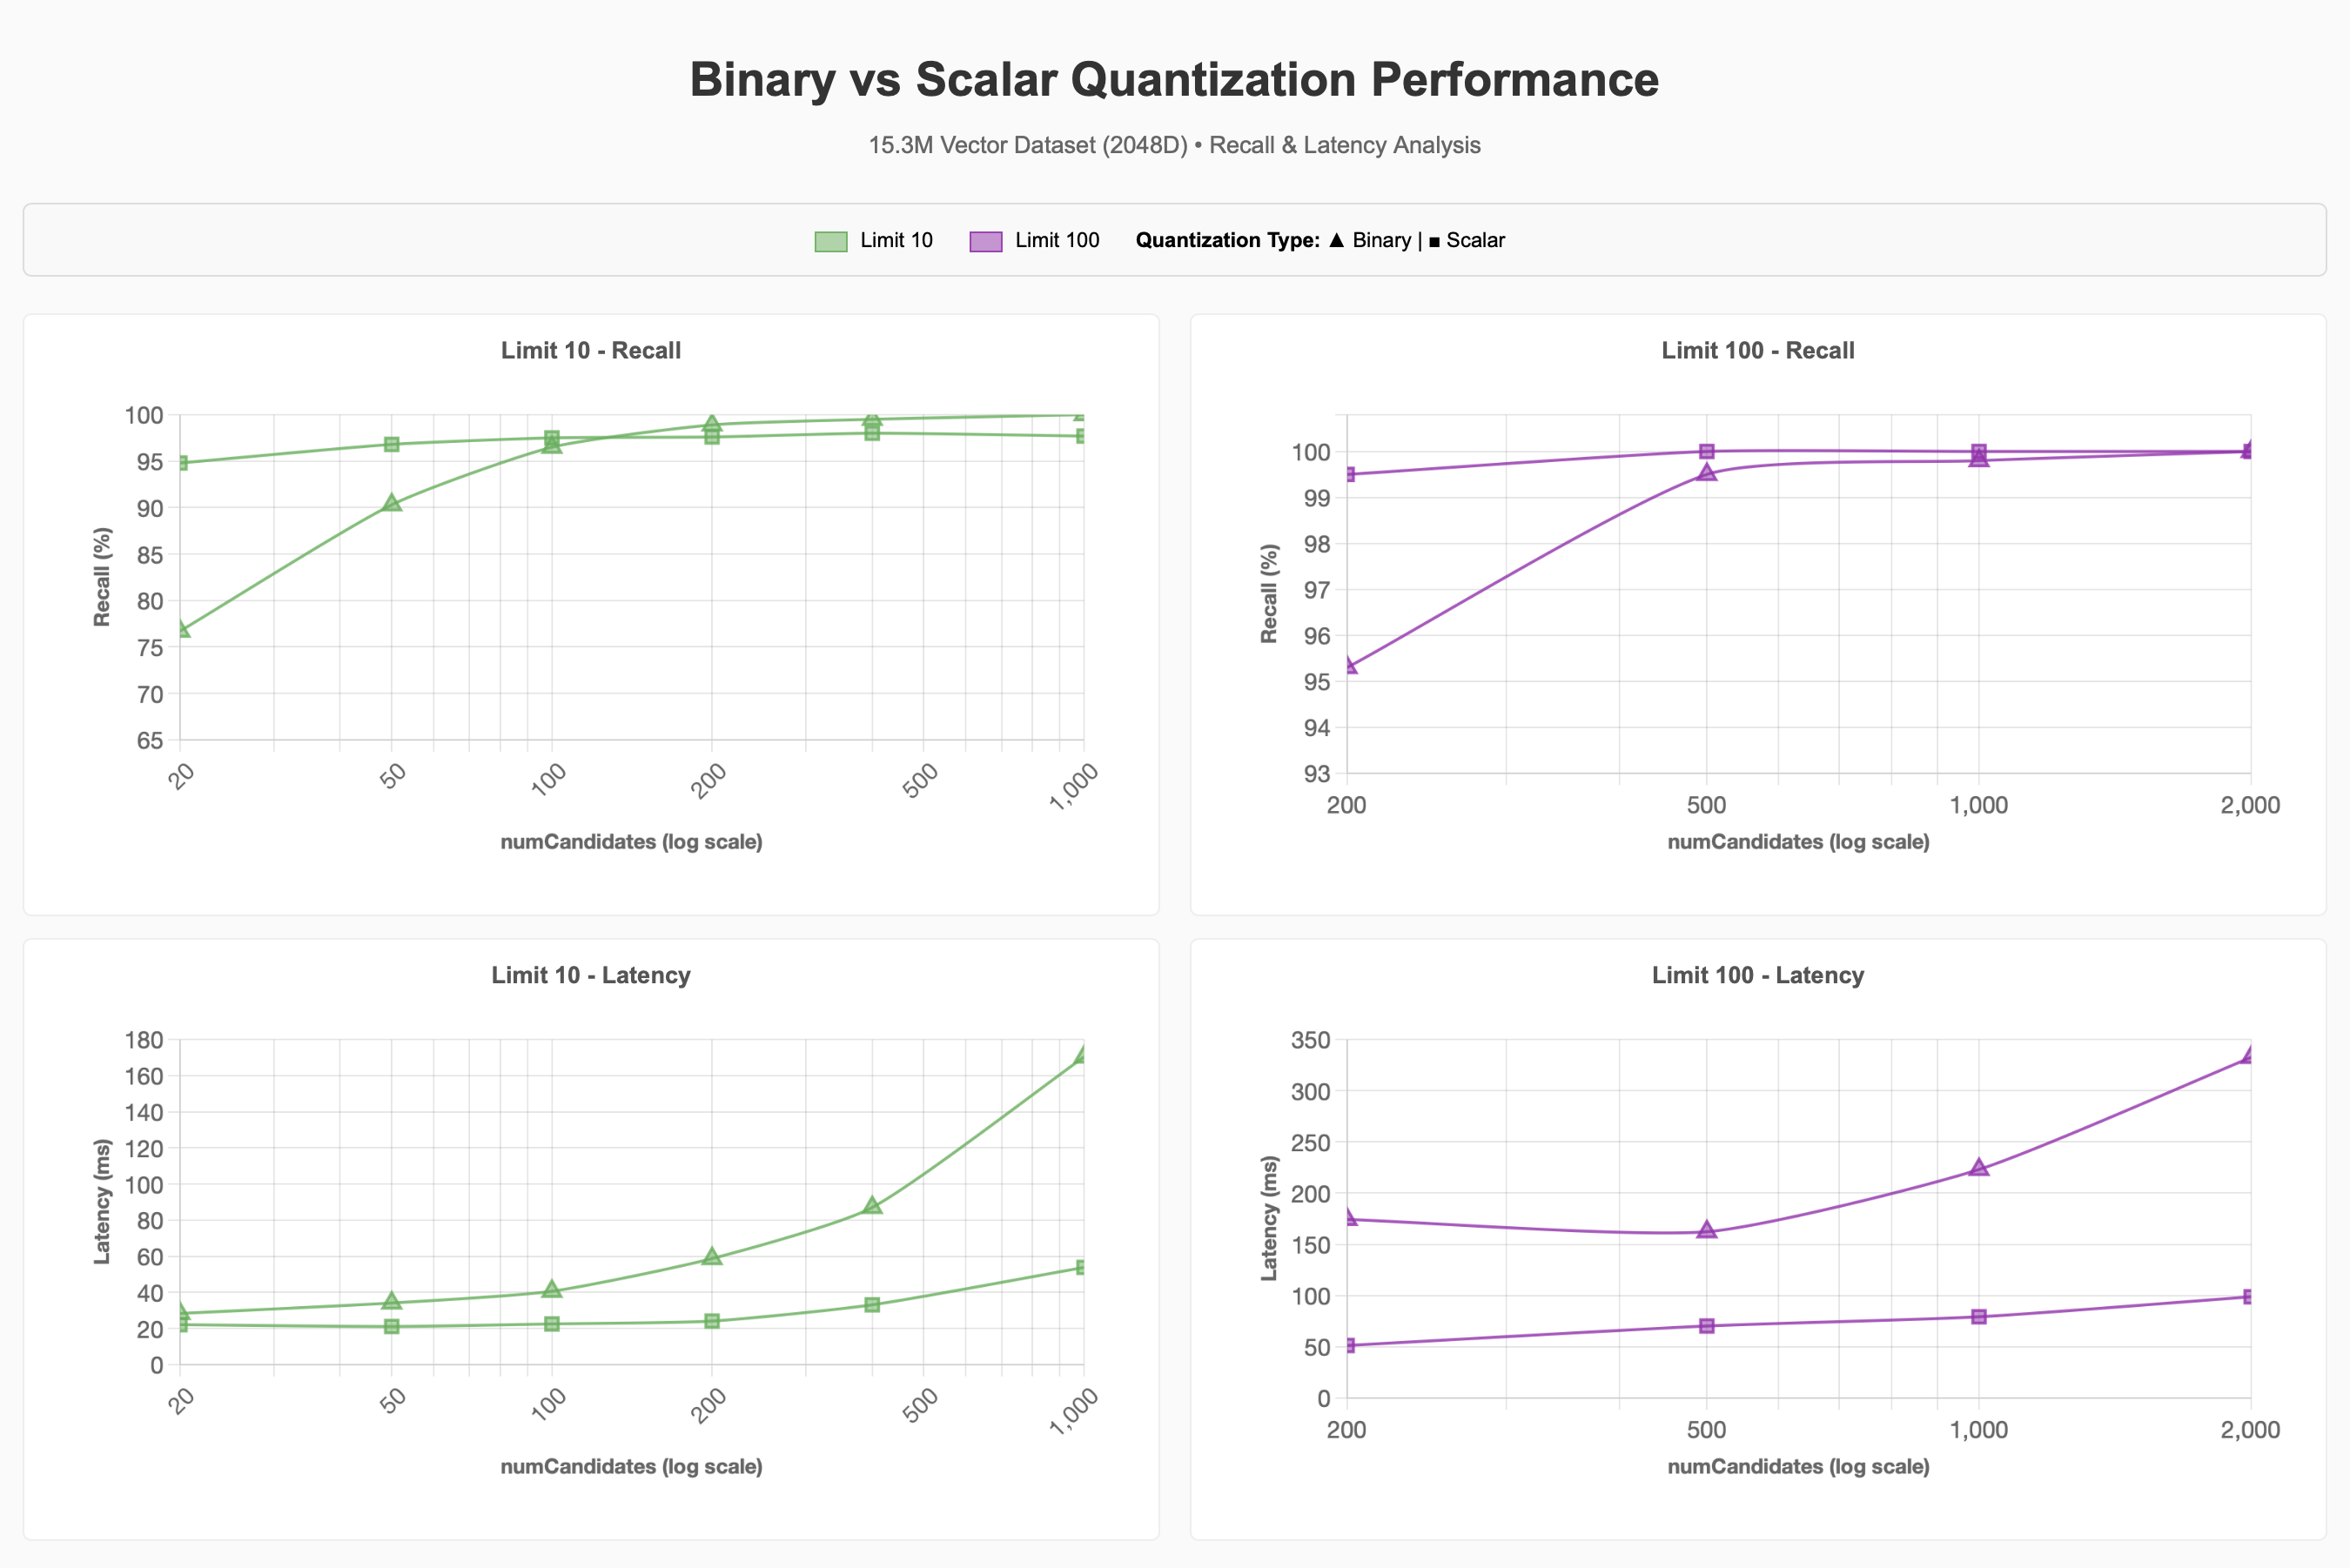
大規模な15.3Mベクトルデータセットでは、次元を2048dに固定し、量子化、フィルター、同時実行性がパフォーマンスに与える影響を調査しました。前回の一連のテスト結果から、次元が高いほどリコールがより有利に維持されることが示されたため、2048dに固定することにしましたが、1024dも90~95%のリコール目標を達成するために有益であることが考えられます。
リコールとレイテンシの分析
バイナリ量子化を使用して90-95%のリコール目標を達成する場合、ベースラインと比べてはるかに大量のnumCandidatesが必要になることを観察しました。一般的にnumCandidatesが高いほどレイテンシが高くなりますが、状況によっては異なる場合があります。
フィルタリング
ペット用品カテゴリ(コーパスの~3%)の15.3Mアイテムのうち~500kアイテムのデータセットで選択的フィルターを使用した場合、リコールとレイテンシで何が起こるかを観察したところ、
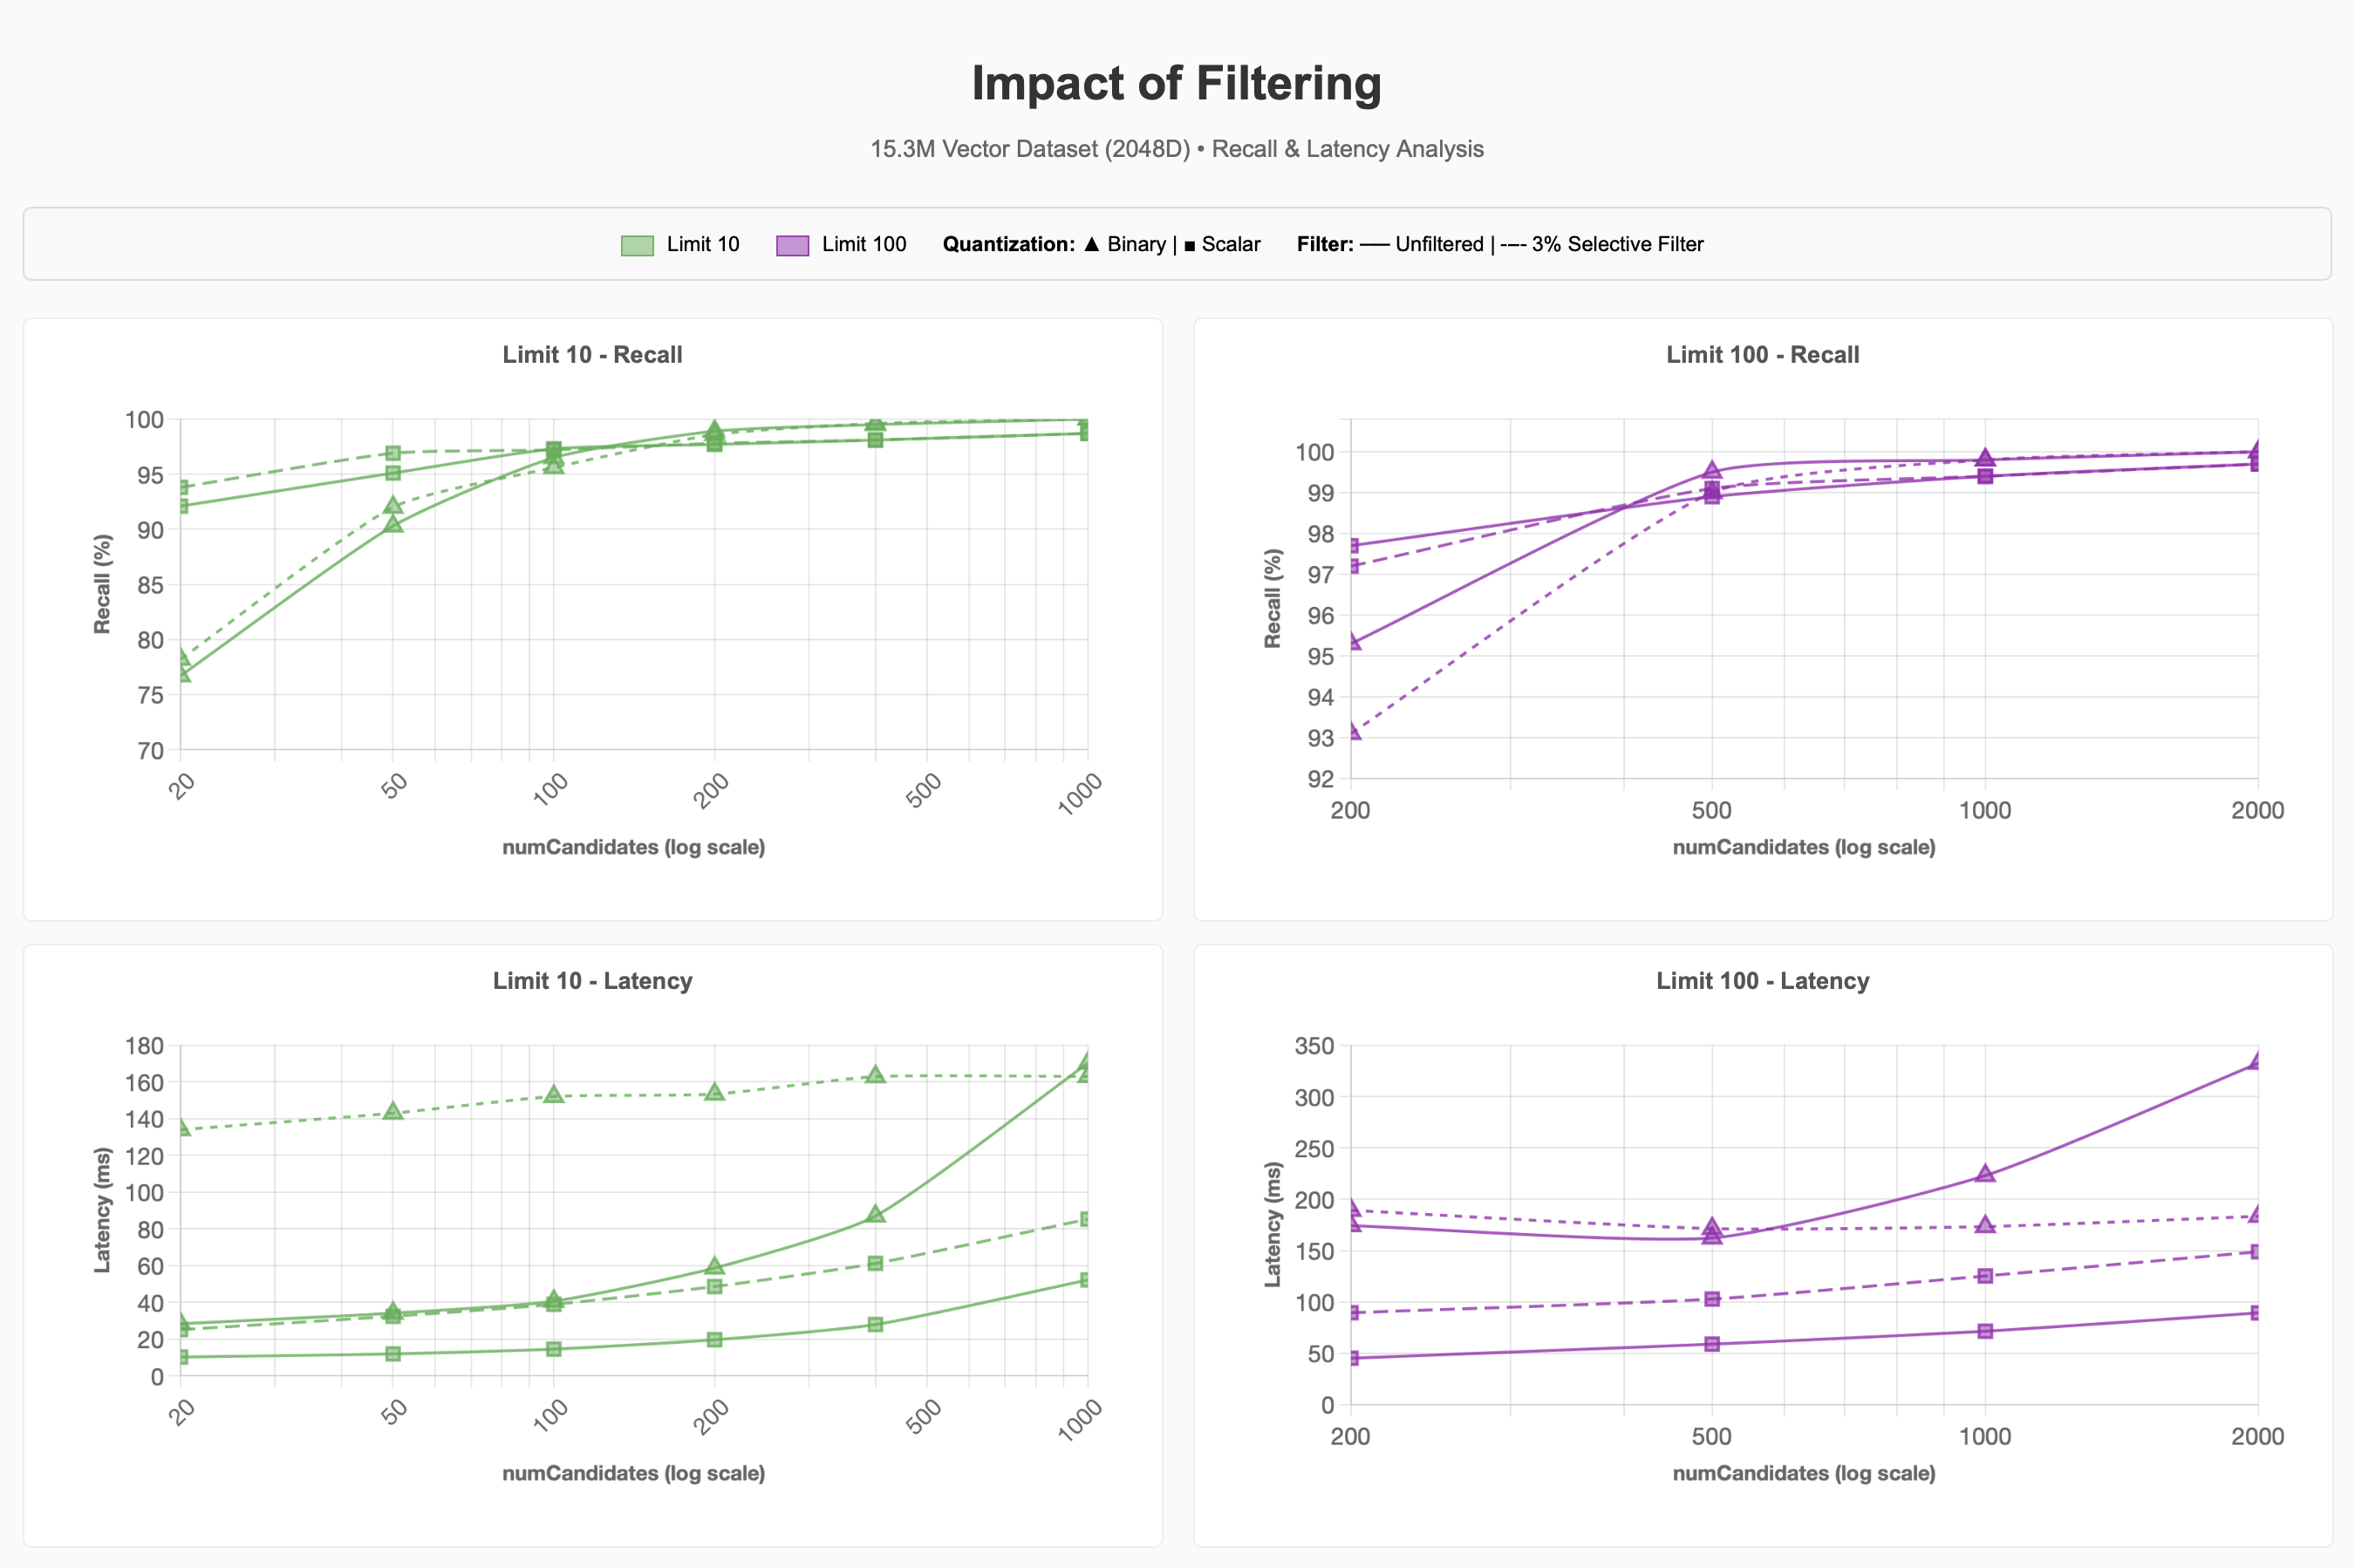
セレクティブフィルターは、データのごく一部にのみ一致するフィルターです (この場合は約3%) 。検索エンジンはこの小さなサブセット内で最近傍の近傍を検出する必要があるため、インデックスをより広範囲に検索し、より多くの候補を評価して、同じリコールに達する必要があります。各クエリは、フィルタリングされていないクエリよりも負荷が多くなります。
予想通り、3%の選択フィルターによってクエリの作業負荷が増加する可能性があることがわかります。より低いlimit値でのバイナリ量子化に関しては、フィルタリングされていないクエリと比べて、90-95%のリコールの達成に約4倍の作業が必要でした。
Hierarchical Navigable Small Worlds の Agon-1 検索戦略をサポートする Lucene 10 の将来の改善によって、このプロセスが改善される可能性があります。ただし、要求された候補の数がセグメント内のメタデータフィルターに一致するベクトルの数を超える場合にENNを実行すると、選択された量子化レプリカセットに関係なく、フィルターの選択性がクエリ パフォーマンスの大部分を占めることが示されます。
同時実行性
これらのテストは、スカラー量子化とバイナリ量子化を使用する場合にさまざまなlimit値で1、10、100の間の並行リクエストをスケーリングします。numCandidatesは、90~95%のリコールを達成するために選択された値で選択されます。
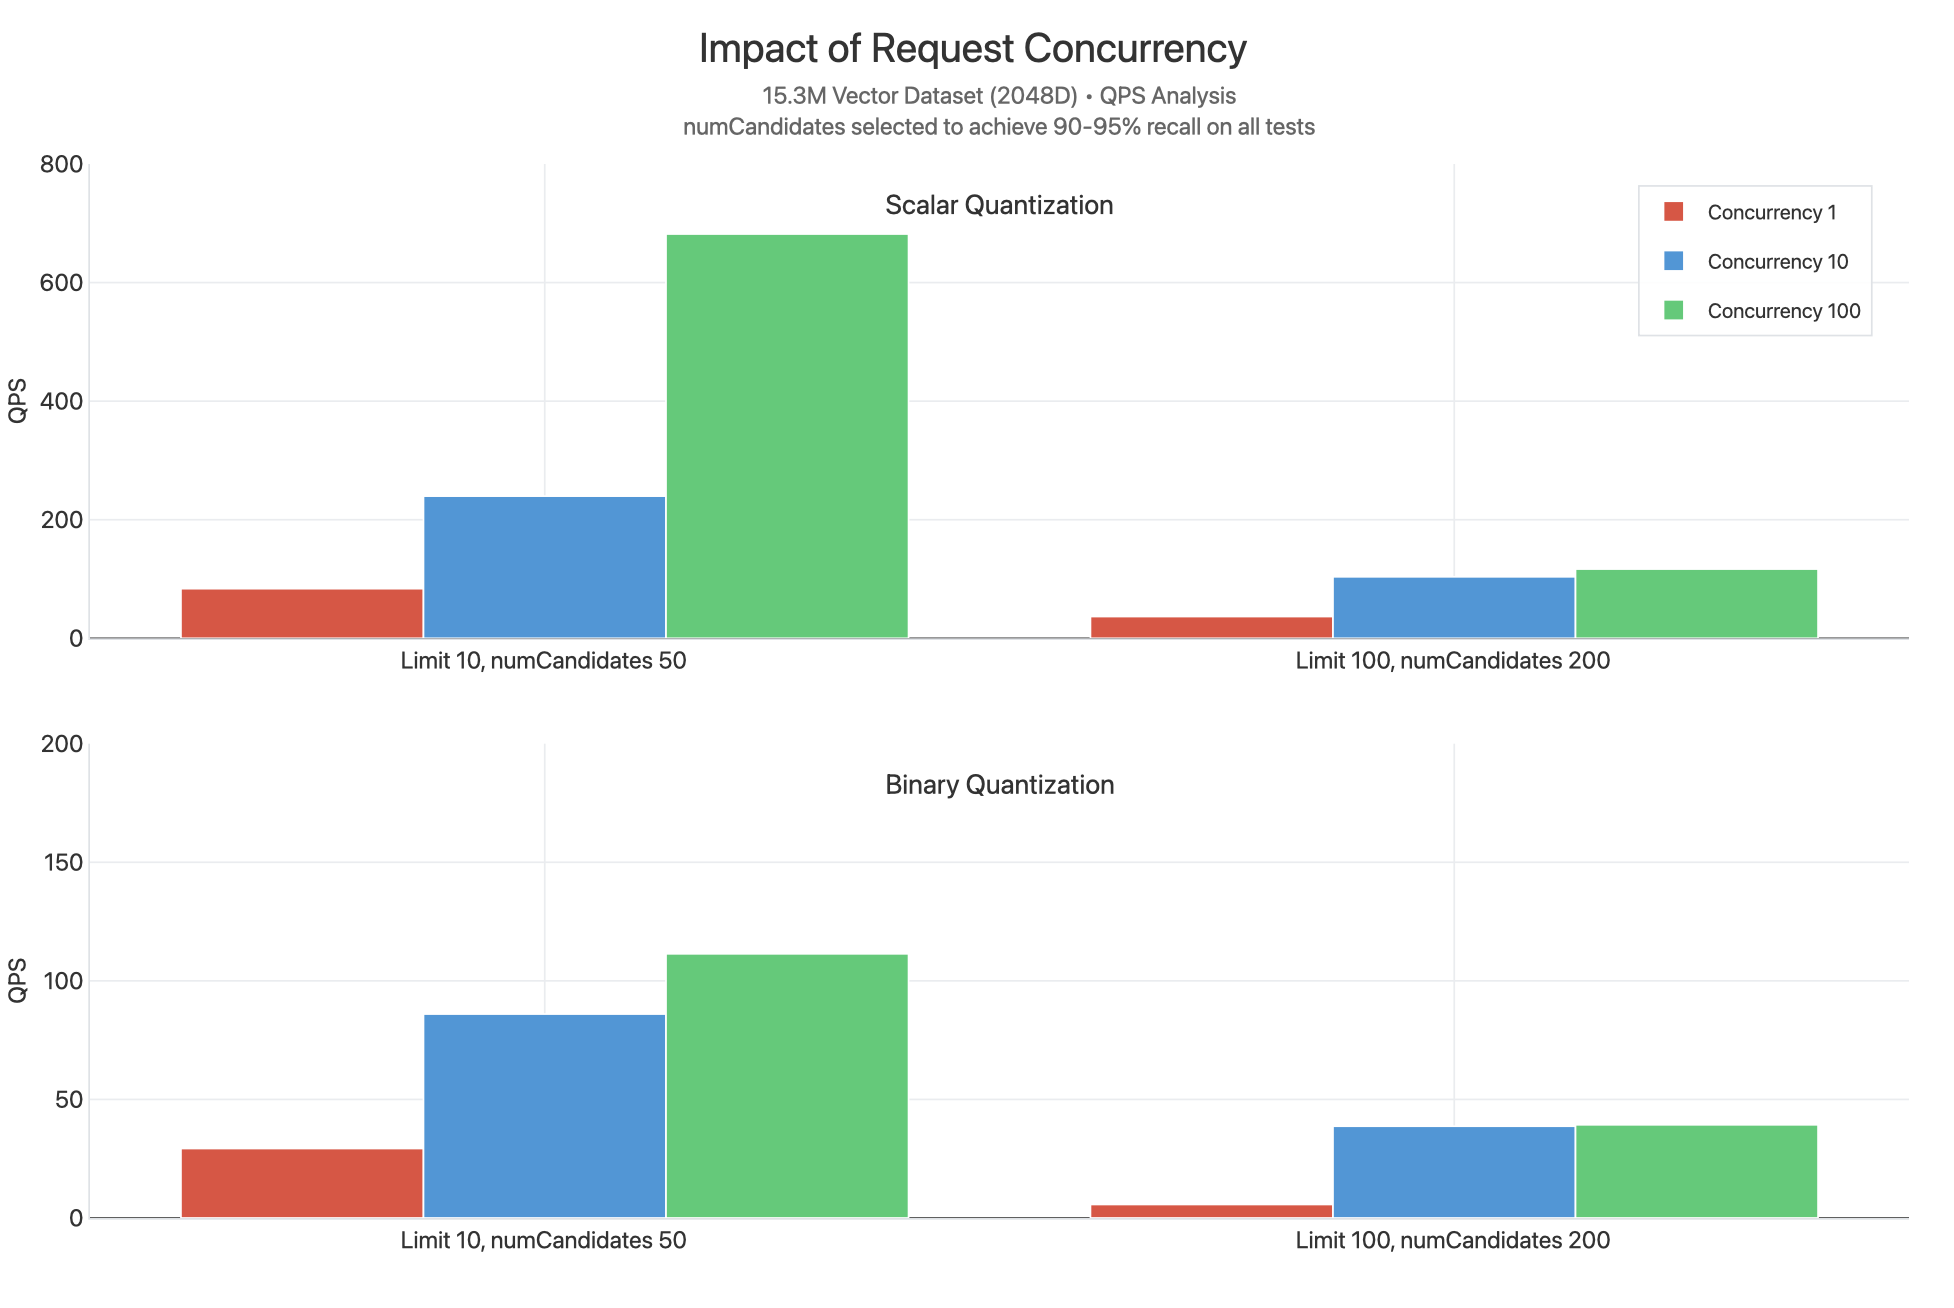
スカラー量子化は、すべてのlimitの値でより高いQPSを達成することが観察されています。おそらく、各クエリがnumCandidatesが低い状態で再スコアリングなしで完了できるためです。同時実行数が高い場合では、同時実行数 10 と同時実行数 100 の QPS 曲線は近接しています。これは、システムが使用可能な CPU リソースを効率的に使用していること、また余計な同時実行数は主にレイテンシに影響します。
著しく高いQPSを達成するスカラー量子化の1つの例外的なデータ点は制限10、並行100です。これは、再スコアリングが行われず、limit値が低いために、このクエリに対して実行される比較数が少なくなり、各リクエストが回答をより迅速に返し、コアが他のクエリを処理できるようになるからだと考えられます。
検索ノード階層を拡大するか検索ノード数を最小2から最大32件に拡大すして利用可能なvCPUを拡大しリクエストを処理することは、並行性ボトルネックを解決して数千のQPSに拡大するのに役立つ場合があります。
シャーディング
また、クラスターとコレクションがシャーディングされ(_idで)、フィルタリングされていないクエリがバイナリ量子化されたインデックスに対して発行された場合に何が起こるかも観察しました。
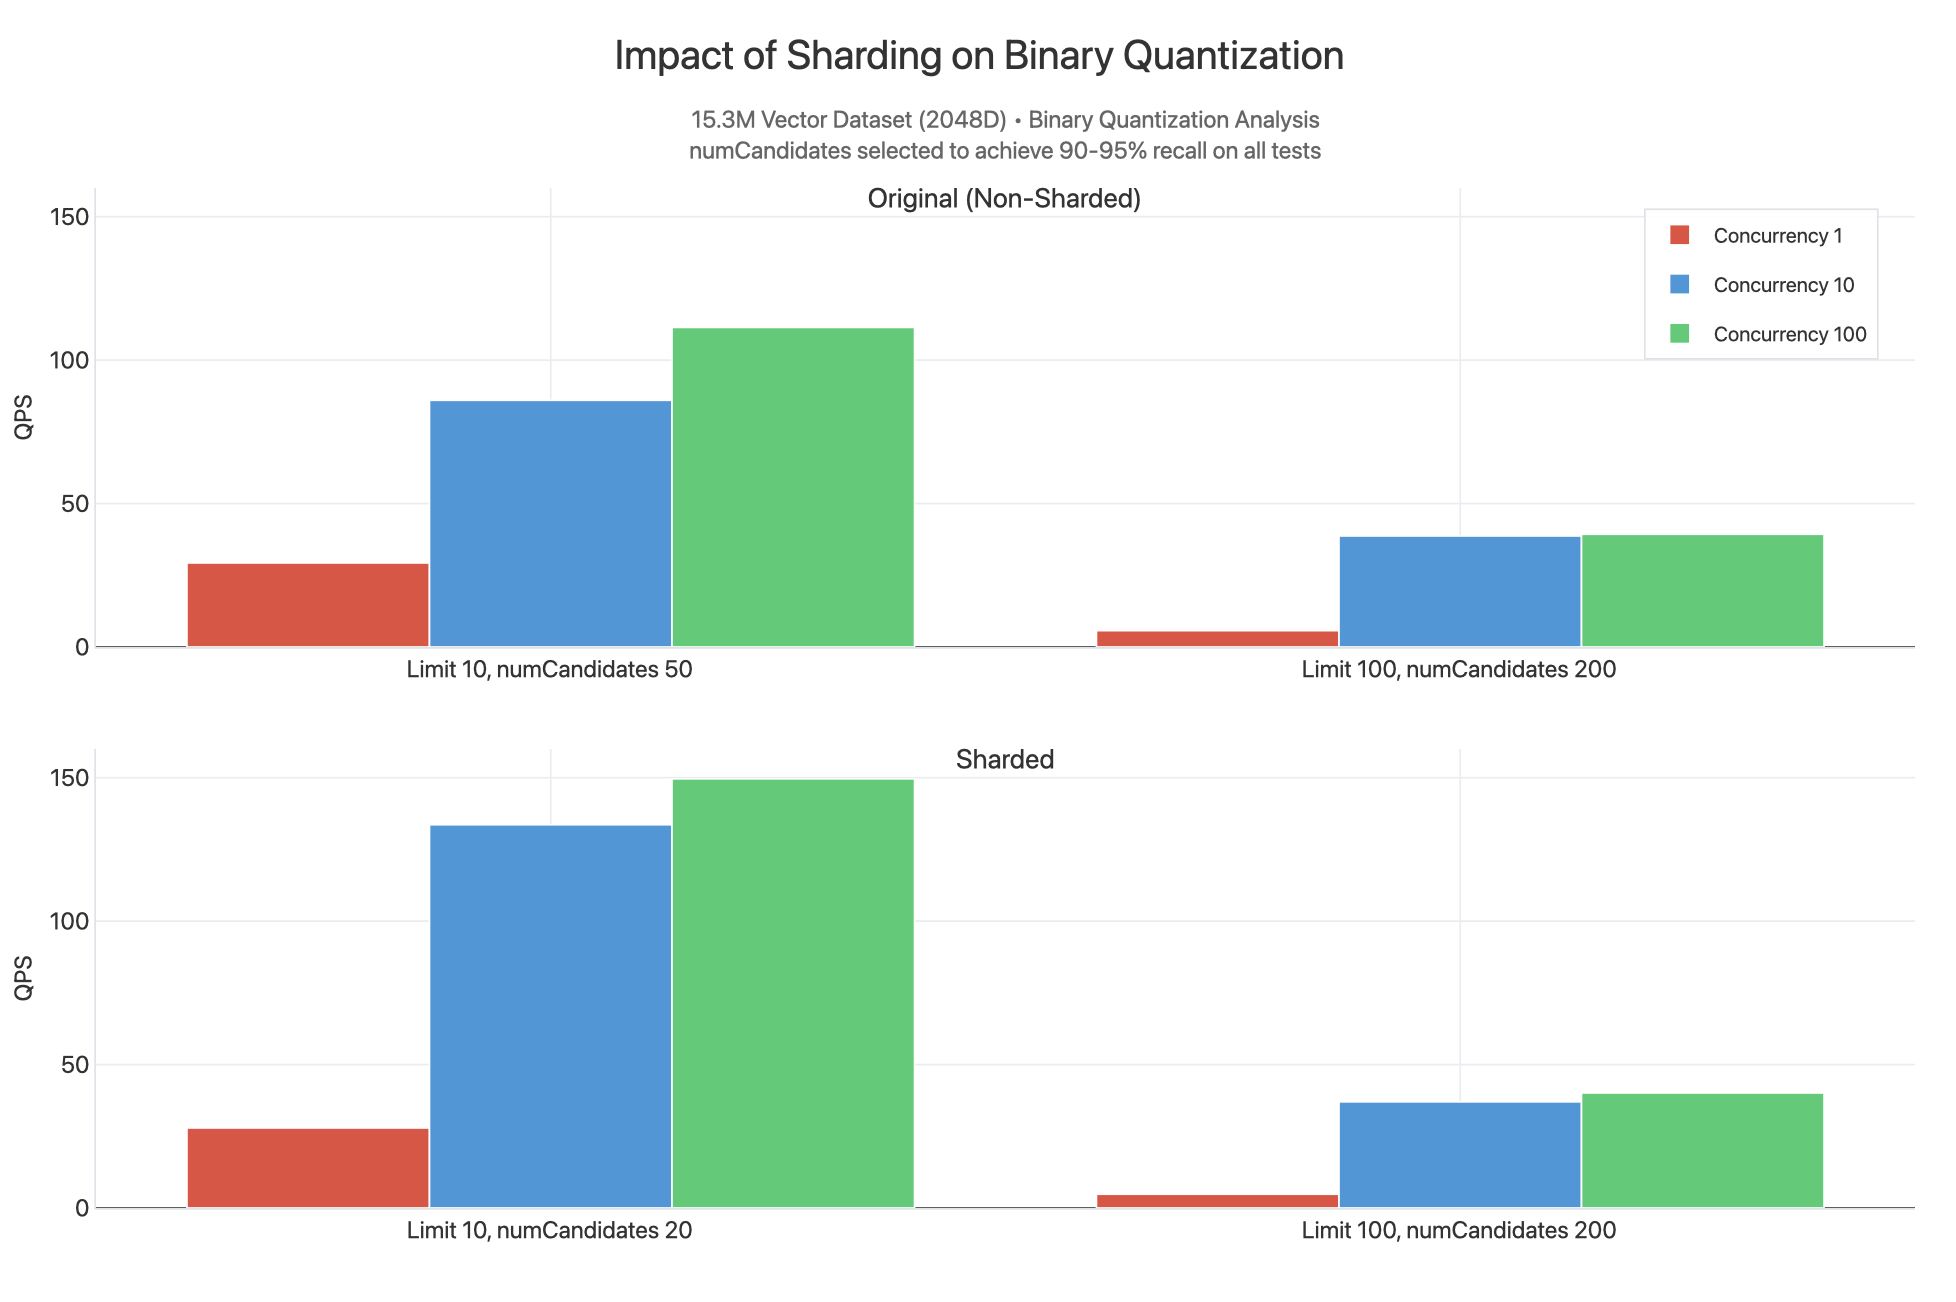
ここでは、numCandidatesの低い値を指定して90~95%のリコール範囲の結果を出せるため、シャーディングされた結果は制限10で高いQPSを実現しているのが確認できます。これは、15.3Mのデータセットが3つのシャードに分裂されており、各シャードにはHNSWグラフを含むセグメント全体で5.1Mベクトルで満たされた独自のインデックスがあるためです。機能的には、3つのシャードで同時に収集された各クエリ分散がnベクトルに最も近いベクトルを発見する可能性が高いため、あまり高度でない検索を行っています。そのため、numCandidatesを削減でき、勤めるクエリに利用可能なコアが増えるものの、クラスターのシャーディングのコストの増加を正当化するほど十分ではないためQPSはシャーディング時にわずかに高くなります。ベクトル検索のパフォーマンスは信頼性が高いため、スループットを増やすためにクラスターをシャードする必要はありません。
注意
制限100、numCandidates 200の値は類似しています。インテリジェントなシャードキーのマッチングをフィルターとして使用することで、フィルターされたクエリのパフォーマンスの向上を期待できます。