Atlas Infinite は、コンピュートとストレージを2つの独立したレイヤーに分離します。コンピュートノードは、クエリ、トランザクション、集計を実行します。ストレージレイヤーはデータを永続的に保存し、高可用性のために複数のコピーを保持します。MongoDBはコンピュートレイヤーとは独立してストレージレイヤーをマネージドするため、拡大やリカバリの操作はデータの移動や複製なしで実行されます。
次の図は、Atlas InfiniteがAtlas内で、アプリケーション、コンピューティング、ストレージの各レイヤーにどのように適合し、その下にAtlasマネジメントインターフェースがどのように配置されているかを示しています。
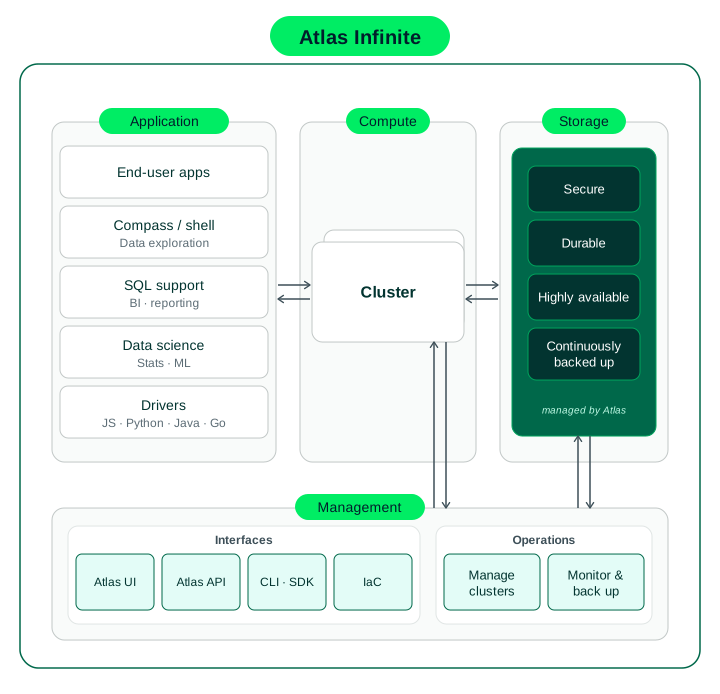
Atlas Infinite コンピュートとストレージが Atlas アプリケーションおよびマネジメント スタック内にどのように組み込まれるか
コンピューティングレイヤー
コンピュートノードは、クエリ、トランザクション、集計を実行するレイヤーです。コンピュートノードはストレージから分離されているため、ストレージとは独立してコンピュートキャパシティーを増やすことができます。需要の増加に合わせてコンピュートキャパシティーを追加し、需要が減少したときに縮小することができます。オートスケーリングを有効にすると、Atlasがコンピュートを調整します。
パブリックプレビューでは、Atlasはクラスターのリージョン内の別々のアベイラビリティーゾーンにコンピューティングノードを配置します。
ストレージ層
Atlas Infiniteのストレージレイヤーは、アプリケーションのデータを耐久性があるものに保ち、高可用性のために複数のコピーを維持します。Atlas Infiniteでは、MongoDBはストレージを、アプリケーションのワークロードを実行するコンピューティングノードとは別の独立したレイヤーとして管理します。ストレージレイヤーは、コンピューティングレイヤーとは独立して、レプリケーションの取り扱い、読み取りの提供、継続的なバックアップの提供を行います。クラスター階層を増やすとき、またはコンピューティングノードが失敗してAtlas Infiniteがフェイルオーバーを実行するとき、アプリケーションのデータはクエリを実行するためにストレージレイヤーで利用可能なままになります。MongoDBはそれを新しいコンピューティングノードにコピーしません。
セキュリティ
Atlas Infiniteは、各クラスターをストレージレイヤー全体で分離します。Atlasは、ストレージレイヤー内の通信において、X.509証明書を使用して内部トラフィックを相互認証します。
ストレージレイヤーは共有されているため、各カスタマーのデータは、カスタマー間で共有されることのない固有のキーで暗号化されます。ストレージレイヤーはこれらのキーをコンピュートノードとは別に管理するため、すべてのコンピュートノードは受信したデータを復号できます。AtlasがAtlas Infiniteデータをどのように暗号化するかを学ぶには、「Atlasの保管時の暗号化の概要」を参照してください。
レプリケーションとフェイルオーバー
Atlas Infinite クラスターには、選択可能なコンピューティング ノードとして、書込み (write) を処理する プライマリ と、もう 1 つの選挙可能な ノードである スタンバイ の 2 つの選択可能なコンピューティング ノードがあります。プライマリが障害または再起動したときに引き継ぐものです。public preview中に、ワークロード分離のために最大 5 つの読み取り専用ノードと分析ノードを追加できます。これにより、クラスターには合計で最大 7 つのコンピューティング ノードが存在します。次のノードタイプを追加できます。
読み取り専用ノードは、運用ワークロードからの読み取りを処理します。
分析ノードは、分析クエリを運用ワークロードから分離します。
コンピュートノードはプライマリの選出には投票しません。ストレージレイヤーは、クラスターのノード間での選挙ではなく、フェイルオーバーを調整します。プライマリが失敗または再起動すると、スタンバイがプライマリになります。ストレージレイヤーは、最近のデータをすべてのノードですぐに利用できるようにします。フェイルオーバーによってインデックス構築が中断された場合、構築は自動的に再開されます。
読み込み設定 (read preference)は、Atlas Coreクラスターの場合と同様に機能します。すべての 読み込み設定 (read preference)モード と、定義済みのレプリカセットタグを使用できます。
アプリケーションのドライバーが読み込み設定 (read preference) を設定します。ドライバーのデフォルトは primary です。そのため、読み込み設定 (read preference) を変更しない限り、アプリケーションはすべての読み込みをプライマリに送信します。
Atlas Infiniteクラスターには、1つのスタンバイノードがあります。アプリケーションがプライマリ以外のノードから読み取る場合、読み取り専用ノードや分析ノードを追加して別の読み込み設定 (read preference) を設定しない限り、それらの読み取りはスタンバイノードに送られます。次の推奨事項を使用してください。
アプリケーションの運用読み取りを複数のノードから提供するには、読み取り専用ノードを追加します。読み取り専用ノードは、
primaryを除くすべての読み込み設定 (read preference) で読み取りを勤めるため、追加した各ノードはそのトラフィックの一部を勤める。これらの読み取りをスタンバイノードと読み取り専用ノードに分散させるには、読み込み設定 (read preference) をsecondaryPreferredに設定します。これにより、アプリケーションの読み取りがプライマリから除外され、単一のスタンバイノードの過負荷が回避されます。Atlas Coreクラスターでは、複数のセカンダリがノードを追加することなく、それらの読み取りを分散させます。分析などのワークロードをアプリケーションの運用読み取りから分離するには、分析ノードまたは読み取り専用ノードを追加し、定義済みのレプリカセットタグを使用してクエリをそれらのノードに送信します。
すべてのノードの読み取りキャパシティーを増やすには、クラスター階層を増やします。
バックアップ、復元する、およびポイントインタイムリカバリは、ストレージレイヤーで動作します。バックアップと復元するについて学ぶには、「Atlas Infinite クラスターを復元する。」を参照してください。
Atlas Infiniteクラスターにおける書込み保証 (write concern)
書込み保証 (write concern) は、書き込み (write) 操作に対して MongoDB にリクエストする確認応答のレベルを表します。
このセクションでは、Atlas Infiniteクラスターにおける書込み保証 (write concern)のデフォルト、Atlasが各書込み保証 (write concern)フィールドを取り扱う方法、および書込み保証 (write concern)がAtlas Coreクラスターとどのように異なるかについて説明します。
Atlas Infiniteクラスターでは、ストレージレイヤーがデータを保存および複製し、ストレージレイヤーが書き込み (write)をキャプチャするとAtlasが書き込み (write)を認識します。
Atlas Infiniteクラスターでは、デフォルトの書込み保証 (write concern) は w: "majority" です。アプリケーションは、接続文字列または単一の書き込み (write) 操作で書込み保証 (write concern) を設定します。Atlas UI でデフォルトを変更することはできません。
Atlas は、アプリケーションが送信するあらゆる書込み保証 (write concern) を受け入れ、必要に応じて Atlas Infinite クラスターがサポートする値に変更します。これにより、アプリケーションの書込み保証 (write concern) は引き続き機能します。
Atlas Infiniteクラスターでは、Atlasは書込み保証 (write concern) フィールドを次のように取り扱います。
アプリケーションは、書き込み (write)認識レベルを、を使用して設定します。
w:アプリケーションで
wが設定されていない場合、Atlas はデフォルトのw: "majority"を適用します。Atlas Infiniteクラスターでは、"majority"はクラスターのノードの過半数ではなく、ストレージ層内の過半数を指します。Atlasは、w: "majority"書き込み (write)をロールバックすることはありません。アプリケーションで
wを0または1に設定した場合、Atlas はアプリケーションが設定した値を適用します。w: 0リクエストは確認応答を要求しません。w: 1書き込み (write)はw: "majority"書き込み (write)よりも早く戻りますが、Atlasはまれな障害が発生した場合にロールバックする可能性があります。アプリケーションで
wを2または2より大きい数値に設定した場合、Atlas はw: "majority"を適用します。
アプリケーションは、次を使用して制限時間を設定できます。
wtimeout(接続文字列内のwtimeoutMS、ミリ秒単位)。wtimeoutは、デフォルトを使用する書き込み (write) を含め、w: "majority"書き込み (write) に適用されます。アプリケーションが
wtimeoutを設定している場合、Atlas が確認できない書き込み (write)は、wtimeoutの制限に達すると書込み保証 (write concern) エラーを返します。アプリケーションで
wtimeoutが設定されていない場合、書き込み (write) は無期限に待機し、アプリケーションをブロックします。
Atlasは常に適用します
j: trueストレージレイヤーは、Atlasが書き込みを承認する前に、各書き込み (write)をノードのメモリ外に永続化します。アプリケーションのj設定は、この動作には影響しません。
書込み保証 (write concern)は、Atlas InfiniteクラスターとAtlas Coreクラスターで次のように異なります。
Atlas Infiniteクラスターでは、
wを0、1、または"majority"に設定します。w: 1およびw: "majority"の場合、ストレージレイヤーが書き込み (write)を保証します。w: 0の場合、ストレージレイヤーは書き込み (write)を確認しません。Atlas Coreクラスターでは、wを数値に設定して、その数のノードからの確認をリクエストすることもできます。Atlas Infiniteクラスターでは、Atlasは常に
j: trueを適用するため、ジャーナルの確認を無効にすることはできません。Atlas Coreクラスターでは、j: falseを使用してジャーナリングの確認をオフにできます。
Atlas Infinite クラスターの oplog
Atlas Infiniteクラスターでは、oplogコレクションlocal.oplog.rsはレプリケーションを処理しません。レプリケーションはストレージレイヤーで処理されるためです。このコレクションは、変更ストリームと、限定的な履歴を必要とする一部の内部機能に役立ちます。コレクションは、クラスターの保存データとしてカウントされます。
レプリケーションはoplogコレクションを使用しません。Atlas Infiniteクラスターでは、レプリケーションはストレージレイヤーで行われ、Atlasはoplogコレクション
local.oplog.rsもそこに保存します。すべてのノードがストレージレイヤーから読み取るため、クラスターに参加または再参加するノードがoplog windowから遅れることはありません。詳細については、レプリケーションとフェイルオーバーを参照してください。oplogコレクションは、変更ストリームと内部機能に勤めます。
local.oplog.rsは、変更ストリームと、限られた履歴を必要とする一部の内部機能に勤めます。保持ウィンドウは、中断された変更ストリームが過去にどれだけ遡って再開できるかを決定しますが、クラスター自体をどれだけ遡って復元できるかを管理するものではありません。その場合は、ポイントインタイム復元を使用してください。Atlasがエントリを保持する期間。Atlasは、すべてのoplogエントリを少なくとも最小oplog保持ウィンドウの間保持します。エントリがウィンドウより古くなると、Atlasはそれを削除します。Atlas InfiniteおよびAtlas Coreにおけるデフォルトの最小oplog保持ウィンドウは24時間です。Additional Settingsで最小oplog保持ウィンドウを設定して、クラスターが保持する履歴の量を決定できます。
oplogコレクションがデータサイズとコストに与える影響oplogコレクションは、クラスターへのすべての書き込み (write)をレコードします。oplogコレクションは、Atlas Coreクラスターと同様に、クラスターに保存 (する)されるデータおよびストレージコストにカウントされます。Atlasがクラウドバックアップのために保持する履歴は、バックアップコストの一部です。その履歴はクラスターのストレージにはカウントされません。詳細については、MongoDB Atlas Infinite クラスターコストを参照してください。
運用エクスペリエンス
アプリケーションは、コードを変更することなくAtlas Infinite上で実行されます。Atlas InfiniteはMongoDBワイヤプロトコルを使用しているため、アプリケーションはMongoDBドライバーやその他の接続方法を使用してAtlas Infiniteクラスターに接続します。MongoDBのプログラムツールを使用してクラスターにアクセスし、管理することもできます。