機械学習とベクトル検索を使用して、パーソナライズされた正確な検索エクスペリエンスを提供します。
ユースケース: 生成 AI
業種: 小売
製品: MongoDB Atlas、MongoDB Atlas Search、MongoDB Atlas Vector Search、MongoDB Change Streams、MongoDB Connector for Spark
パートナー: Databricks
ソリューション概要
このソリューションは、MongoDB の柔軟なデータモデルと Databricks の高度な分析機能を統合して、オンラインショッププラットフォーム向けのAI検索機能を構築し、より直感的で効率的な買い物エクスペリエンスを提供します。
AI、機械学習、 MongoDB Atlas Vector Search を使用すると、カスタマーの買い物エクスペリエンスをパーソナライズし、ユーザーの嗜好や検索履歴に適した製品を提案できます。これにより、カスタマー満足度が向上し、売上が向上します。
このソリューションでは、 MongoDB Atlas は、大規模でさまざまなeコマースデータセットを効率的に管理するスケーラブルなデータベース環境を提供します。MongoDB Atlas Vector Search は複雑な検索クエリを処理して、検索タームが部分的な場合でも、カスタマーが必要なものを見つけられるようにします。最後に、Databricks は強力な機械学習とリアルタイム分析機能を提供し、ベクトル検索の精度を向上させます。このフレームワークは、金融サービス、医療、保証などの他の業界に適用できます。
参照アーキテクチャ
次の 2 つの図は、ソリューション アーキテクチャを示します。最初の図はソリューション全体のアーキテクチャを示し、2 番目の図はソリューションのベクトル検索部分をより詳細に示しています。これらのアーキテクチャは、このソリューションで連携します。
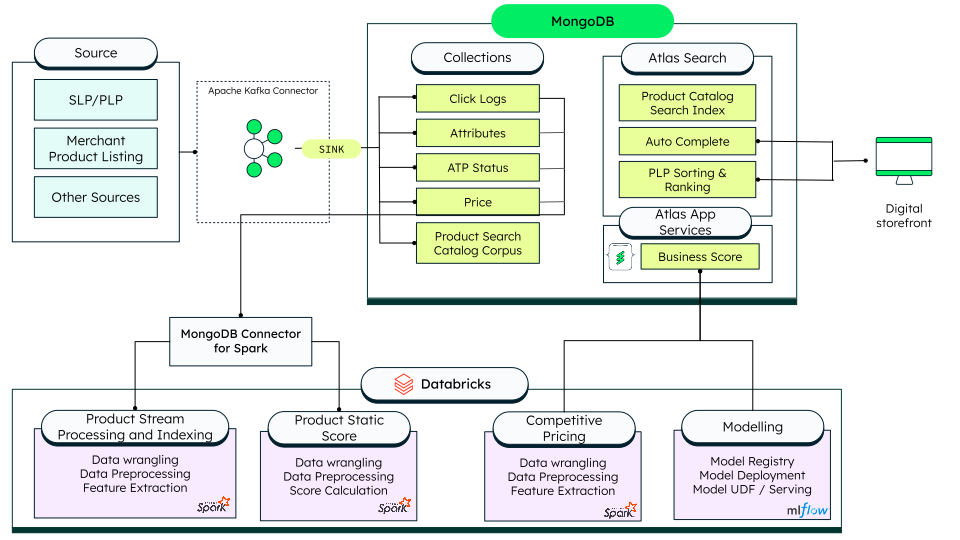
図の 1。さまざまなMongoDB Atlasコンポーネント、Databricks ノート、データ ワークフローを備えたAI拡張検索エンジンのアーキテクチャ。
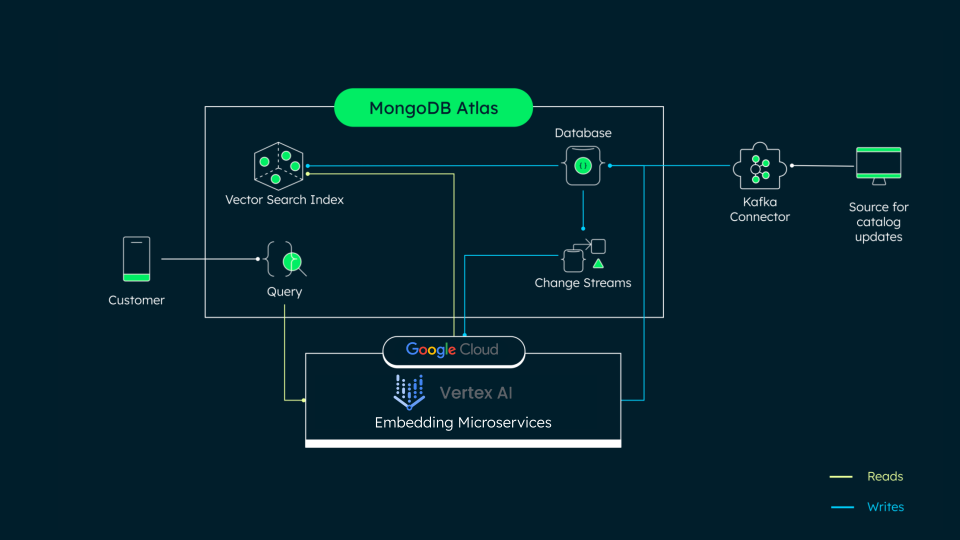
図 2。MongoDB AtlasおよびDatabricksのさまざまな統合コンポーネントを通じてデータがどのように流れるかを示すベクトル検索ソリューションのアーキテクチャ
データモデルアプローチ
このソリューションを使用する場合、開発者はデータを保存するときに多形パターンを使用する必要があります。このパターンにより、コレクション内のドキュメントが類似しているが同一ではない場合でも、効率的なクエリが可能になります。
このソリューションでは、各製品ドキュメントには _id、price、brandName などの共通フィールドがあります。また、color1、ageGroup、season など、製品カテゴリに固有のさまざまなフィールドを持つこともできます。MongoDB の 柔軟なドキュメントデータモデルにより、 同じコレクション内で異なる製品の種類を表現するときに、統一性とカスタマイズの両方をサポートするようにスキーマを設計できます。
次のコード ブロックは、製品アイテムを表すドキュメントの例を示します。
{ "_id": { "$oid": "64934d5a4fb07ede3b0dc0d3" }, "colour1": "NA", "ageGroup": "Adults-Women", "link": "http://assets.myntassets.com/v1/images/style/properties/41b9db06cab6a17fef365787e7b885ba_images.jpg", "brandName": "Baggit", "fashionType": "Fashion", "price": { "$numberDouble": "375.0" }, "atp": { "$numberInt": "1" }, "title": "Baggit Women Chotu Taj White Belt", "gender": "Women", "mfg_brand_name": "Baggit", "subCategory": "Belts", "masterCategory": "Accessories", "score": { "$numberDouble": "0.0" }, "season": "Summer", "articleType": "Belts", "baseColour": "White", "id": "33464", "discountedPrice": { "$numberDouble": "324.0" }, "productDisplayName": "Baggit Women Chotu Taj White Belt", "count": { "$numberInt": "10" }, "pred_price": { "$numberDouble": "0.8616750344336797" }, "price_elasticity": { "$numberDouble": "0.0" }, "discount": { "$numberDouble": "14.0" }}ソリューションのビルド
Atlas Vector Search を使い始める
『Atlas Vector Search クイックスタートガイド』にアクセスし、数分で最初のインデックスを作成できます。
アプリケーションを配置する
アプリケーションをローカルに配置するには、Githubリポジトリの README 手順に従います。
Databricks のジョブとワークフローの作成
JSONを使用して Databricks のジョブとワークフローを作成する方法については、この Databricks のドキュメント を参照してください。
分析に Databricks ノートを使用
ノートについては、このGithubフォルダーを参照してください。
キーポイント
未加工データの変換: trigger と関数を使用して、 MongoDB Atlasの未加工データを Databricks にプッシュできます。また、 MongoDB Connector for Sparkを活用して、さまざまな機械学習アルゴリズム用にデータを形成することもできます。
リアルタイムデータの処理:リアルタイムデータを処理して、製品スコアリング、製品の特権、推奨エンジンなどのアクション可能なインサイトを得ることが出来ます。
柔軟なスキーマを使用 : MongoDB の柔軟なドキュメントモデルを使用して、多形パターンを適用できます。これにより、共有フィールドと一意のフィールドを持つドキュメントを同じコレクション内に保存できます。
作成者
Francesco Baldissera, MongoDB
Ashwin Gangadhar、MongoDB
Vittal Pai、MongoDB