- $cmd
- Una colección virtual que expone los comandos de la base de datos MongoDB. Para usar los comandos de la base de datos, consulte la sección "Emitir comandos".
- _id
- El campo _id es obligatorio en todos los documentos de MongoDB y debe tener un valor único. Puedes considerar el campo
_idcomo la clave primaria del documento. Si creas un nuevo documento sin el campo_id, MongoDB lo crea automáticamente y le asigna un ObjectId BSON único. - utilización absoluta de la CPU del sistema
Utilización de la CPU del sistema relativa a la cantidad total de CPU disponible para las instancias en la nube que comparten CPU. En las métricas de Atlas, este valor aparece como System CPU.
Cuando un proveedor de servicios en la nube limita la utilización de la CPU para una instancia en la nube, la utilización absoluta de la CPU del sistema de la instancia es igual a la utilización de CPU de referencia asignada a esta instancia.
Cuando un proveedor de servicios en la nube agrega CPU por encima de la CPU base, por ejemplo, mediante un mecanismo de ráfaga, la suma de la utilización normalizada de la CPU del kernel y la utilización de la CPU del usuario en una instancia puede superar la CPU base de la instancia. En este caso, la suma de la utilización normalizada de la CPU del kernel y la utilización de la CPU del usuario sigue siendo inferior a la cantidad total de CPU compartida por las instancias en la nube. Véase también utilización relativa dela CPU del sistema, utilización de la CPU base e instancias con capacidad de ráfaga.
- acumulador
- Una expresión en una secuencia de agregación que mantiene el estado entre los documentos de dicha secuencia. Para obtener una lista de las operaciones del acumulador,consulte
$group. - acción
- Una operación que el usuario puede realizar sobre un recurso. Las acciones y los recursos se combinan para crear privilegios. Véase acción.
- base de datos admin
- Una base de datos con privilegios. Los usuarios deben tener acceso a la base de datos
adminpara ejecutar ciertos comandos administrativos. Para obtener una lista de los comandos administrativos, consulta Administration Commands. - Amenaza Avanzada Persistente
- En seguridad, un atacante que obtiene y mantiene acceso a largo plazo a la red, el disco y/o la memoria y permanece sin ser detectado durante un período extendido.
- Agregación
- Una operación que reduce y resume grandes conjuntos de datos. Para obtener más información, consultar Operaciones de Agregación.
- Aggregation Pipeline
- Consta de una o más etapas que procesan documentos. Los pipelines de agregación ofrecen una sintaxis rica para expresar los query complejos. Para obtener una lista de las etapas, consulta Etapas de agregación.
- alerta
Atlas envía notificaciones cuando las operaciones de la base de datos o el uso del servidor alcanzan umbrales que afectan al rendimiento del clúster. Para saber qué condiciones puede configurar para activar las alertas, consulte la sección «Revisar condiciones de alerta».
- nodo de análisis
- Nodo especializado de solo lectura que puede aislar los query para que no afecten la carga de trabajo operativa. Los nodos de análisis son útiles para manejar datos analíticos, como los query de reporte ejecutados por herramientas de BI. Se puede alojar nodos de análisis en regiones geográficas dedicadas para optimizar el rendimiento de lectura y reducir la latencia.
- API
Protocolo de comunicación que facilita la interacción entre el cliente y MongoDB Atlas. Puede utilizarse la API de administración de Atlas para automatizar muchas de las tareas realizadas en la interfaz de usuario de Atlas.
- Búsqueda aproximada del vecino más cercano (ANN)
Técnica computacional utilizada para encontrar rápidamente puntos en un conjunto de datos que están cerca de un punto de query dado. Atlas Vector Search utiliza la búsqueda ANN para encontrar incrustaciones vectoriales en los datos que sean más cercanas a los incrustaciones vectoriales en la query sin escanear todos los vectores.
- árbitro
- Un miembro del conjunto de réplicas existe únicamente para votar en las elecciones. Los árbitros no replican datos. Un árbitro participa en las elecciones primarias, pero no puede ser candidato a la primaria. Para más detalles, consulte Árbitro del conjunto de réplicas.
- Atlas
- MongoDB Atlas es una base de datos como servicio alojada en la nube.
- Búsqueda de Atlas
La indexación de texto detallada permite realizar búsquedas avanzadas en sus datos sin necesidad de gestión adicional. Atlas Search ofrece opciones para diversos tipos de analizadores de texto, clasificación de resultados basada en puntuaciones y un lenguaje de consulta avanzado.
- Atlas user
Cuenta utilizada para acceder a la aplicación Atlas. Puede otorgar a los usuarios de Atlas acceso a organizaciones, proyectos o ambos, con permisos específicos definidos por roles de usuario. Un usuario de Atlas es diferente de un usuario de base de datos. Los usuarios de Atlas no proporcionan acceso a ninguna base de datos MongoDB.
- Atlas user role
Conjunto de permisos otorgados a un usuario de Atlas. Puede otorgar permisos a nivel de organización o de proyecto.
- Atlas Vector Search
- Funcionalidad de Atlas que permite realizar búsqueda semántica en incrustaciones vectoriales comparando vectores de query con vectores indexados para encontrar la coincidencia más cercana.
- operación atómica
- Una operación atómica es una operación de guardar que se finaliza por completo o no se completa en absoluto. Para las transacciones distribuidas, que implican escrituras en varios documentos, todas las escrituras en cada documento deben tener éxito para que la transacción tenga éxito. Las operaciones atómicas no pueden completarse de manera parcial. Consultar Atomicidad y transacciones.
- Autenticación
- Verificación de la identidad del usuario. Consulta Autenticación en implementaciones autogestionadas.
- Autorización
- Provisionamineto de acceso a bases de datos y operaciones. Consulta Control de acceso basado en roles en implementaciones autogestionadas.
- Escalado automático
Opción configurable para que el clúster aumente o disminuya automáticamente su nivel de clúster, su capacidad de almacenamiento o ambos en respuesta al uso del clúster.
- cifrado automático
- Al usar el cifrado en uso, el cifrado y descifrado se realizan automáticamente según el esquema de cifrado preconfigurado. La biblioteca compartida de cifrado automático traduce el lenguaje de consulta de MongoDB a la llamada correcta, lo que significa que no necesita modificar su aplicación para realizar llamadas específicas de cifrado y descifrado.
- B-tree
- Una estructura de datos comúnmente utilizada por los sistemas de gestión de bases de datos para almacenar índices. MongoDB utiliza índices B-tree.
- Backup
Copia de los datos que encapsula el estado del clúster en un momento determinado. Las copias de seguridad ofrecen una medida de protección en caso de eventos de pérdida de datos.
Atlas ofrece copias de seguridad en la nube totalmente gestionadas.
- cursor de copia de seguridad
- Un cursor rastreable que apunta a una lista de archivos de copia de seguridad. Los cursores de copia de seguridad son solo para uso interno.
- balanceador
- Un proceso interno de MongoDB que se ejecuta en el contexto de un clúster fragmentado y gestiona la migración de fragmentos. Los administradores deben deshabilitar el balanceador para todas las operaciones de mantenimiento en un clúster fragmentado. Consulte Balanceador de clúster fragmentado.
- utilización de la CPU base
- Fracción de la cantidad total de CPU disponible para las instancias en la nube que comparten CPU. Un proveedor de nube asigna una cantidad determinada de CPU base a cada instancia en la nube, según el nivel del clúster de la instancia. Normalmente, la utilización de CPU base se sitúa entre 20 % y 50 % de la CPU total disponible para las instancias en la nube compartida. Este valor no es visible directamente en las métricas de Atlas. Para consultar la base para los tipos de instancias de AWS, consulte la columna Baseline CPU utilization per vCPU en la documentación de instancias con capacidad de ráfaga de AWS. Consulte también la utilización relativa de CPU del sistema y las instancias con capacidad de ráfaga.
- big-endian
Un orden de bytes en el que el byte más significativo (big end) de un valor de datos multibyte se almacena en la dirección de memoria más baja.
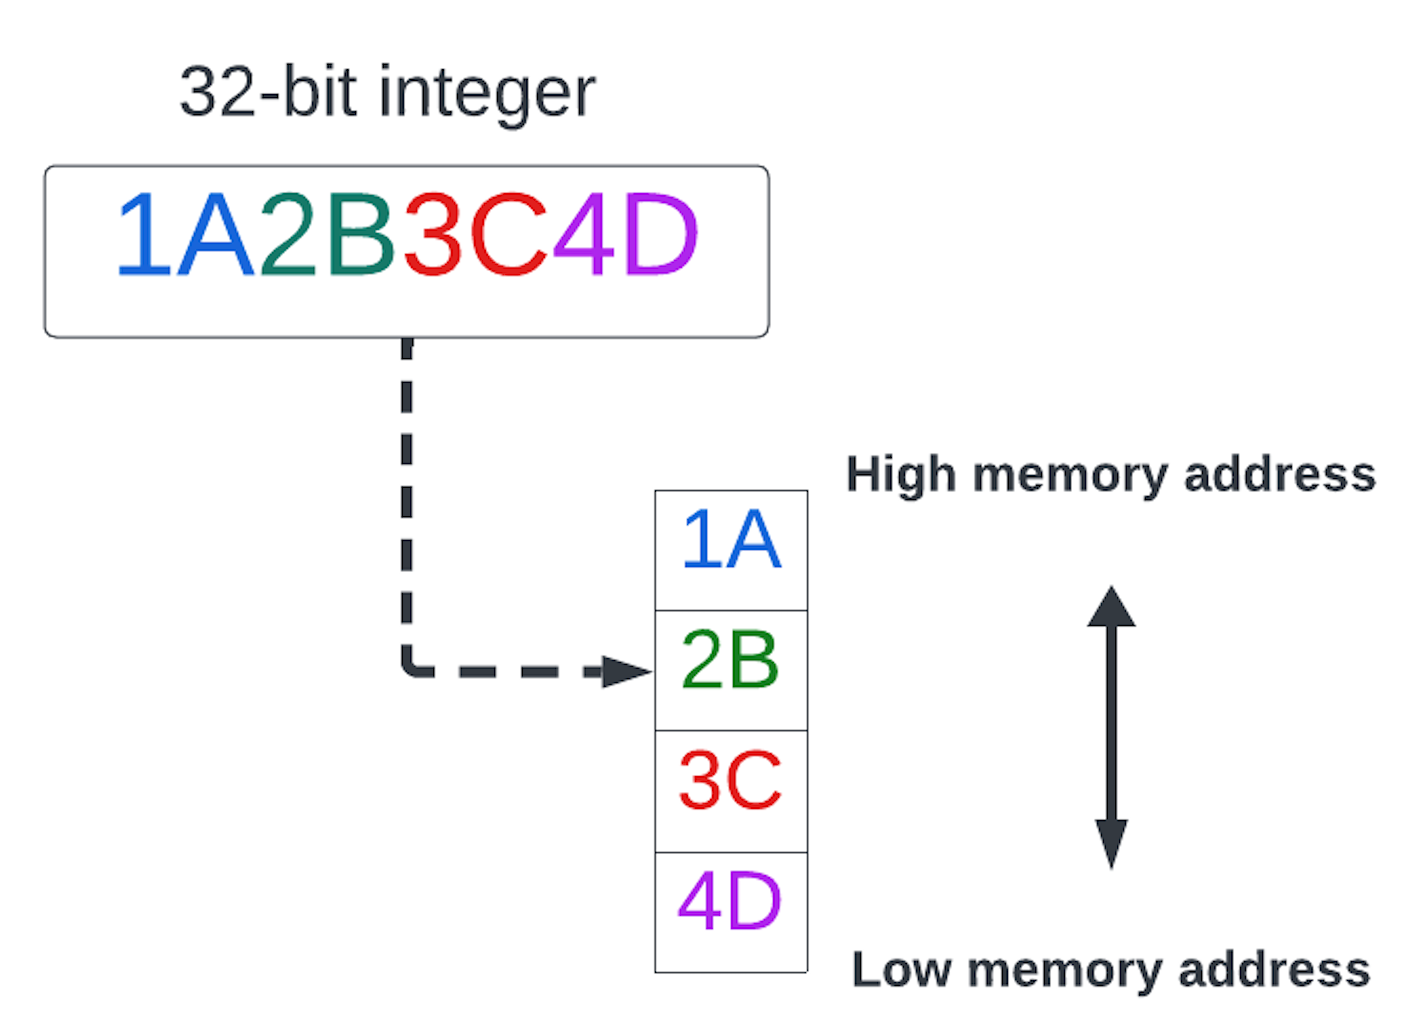 haga clic para ampliar
- ordenamiento bloqueante
- Un algoritmo de ordenación que debe ejecutarse en memoria antes de que se devuelva el resultado. Las ordenaciones en memoria pueden afectar el rendimiento con conjuntos de datos grandes. Utilice una ordenación indexada para evitar una ordenación en memoria.
- escaneo acotado de colección
- Un plan utilizado por el optimizador del query que excluye documentos con rangos de valores específicos de campo. Por ejemplo, si un rango de valores de campo de fecha está fuera de un rango de fechas especificado, los documentos en ese rango se excluyen del plan del query. Consulta el escaneo de colección.
- BSON
- BSON es un formato de serialización utilizado para almacenar documentos y realizar llamadas a procedimientos remotos en MongoDB. Es una combinación de las palabras "binario" y "JSON". BSON se puede interpretar como una representación binaria de documentos JSON (JavaScript Object Notation). Consulte Tipos de BSON y JSON extendido de MongoDB (v2).
- BSON types
- Conjunto de tipos compatibles con el formato de serialización BSON. Para obtener una lista de los tipos BSON, consulte Tipos BSON.
- instancias ráfaga
- Tipos de instancias en la nube que comparten una CPU física común y que, para algunos proveedores, utilizan un modelo de "crédito de CPU". Al usar instancias con capacidad de ráfaga, porciones de la CPU compartida pueden estar disponibles o no para cada una de las instancias virtuales, según las diferentes demandas de los recursos de la instancia. Para obtener más información, consulte Instancias con capacidad de ráfaga deAWS, Ráfaga de disco de Azure y Ráfaga de CPU de GCP. Consulte también Utilización de CPUde referencia, Utilización absoluta de CPU del sistema y Utilización relativa de CPU del sistema.
- Teorema CAP
- Dadas tres propiedades de los sistemas de computación, coherencia, disponibilidad y tolerancia a particiones, un sistema de computación distribuido puede proporcionar dos de estas características, pero nunca las tres.
- colección con tamaño fijo
- Una colección de tamaño fijo que sobrescribe automáticamente sus entradas más antiguas cuando alcanza su tamaño máximo. El oplog de MongoDB que se utiliza en la replicación es una colección con límite de tamaño. Consulte Colecciones con límite de tamaño.
- cardinalidad
- La medida del número de elementos dentro de un conjunto de valores. Por ejemplo, el conjunto
A = { 2, 4, 6 }contiene 3 elementos y tiene una cardinalidad de 3. Consulta Cardinalidad de la clave de partición. - producto cartesiano
- El resultado de combinar dos conjuntos de datos donde el conjunto combinado contiene todas las combinaciones posibles de valores.
- cfq (Planificador de I/O de Equidad Completa)
- Complete Fairness Queueing (CFQ (Planificador de I/O de Equidad Completa)) es un planificador de operaciones de E/S que asigna ancho de banda para los procesos de solicitudes entrantes.
- suma de verificación
- Un valor calculado que se utiliza para garantizar la integridad de los datos. El algoritmo md5 se utiliza a veces como suma de verificación.
- fragmento
- Un rango contiguo de valores de clave de fragmento dentro de un fragmento.Los rangos de fragmentos incluyen el límite inferior y excluyen el límite superior. MongoDB divide los fragmentos cuando es necesario equilibrar los datos dentro del clúster. Si bien el tamaño predeterminado del fragmento es de 128 megabytes, es posible que los fragmentos superen este tamaño sin que se produzca una división automática. La división de fragmentos se realiza como parte del proceso de equilibrio para distribuir los datos de manera uniforme en todo el clúster. Para obtener más detalles, consulte Particionamiento de datos con fragmentos, Equilibrador de clúster fragmentado y Administración del equilibrador de clúster fragmentado.
- Cliente
La capa de aplicación utiliza una base de datos para la persistencia y el almacenamiento de datos. Loscontroladores proporcionan la interfaz entre la capa de aplicación y el servidor de base de datos.
Un cliente también puede ser un único hilo o proceso.
- afinidad de cliente
- Una conexión de cliente coherente a una fuente de datos especificada.
- ClientSession
- Una sesión de cliente agrupa operaciones de base de datos relacionadas en un contexto de aplicación compartido. Los drivers exponen las sesiones de cliente a través de un objeto
ClientSession. Las sesiones de cliente permiten la coherencia causal, las escrituras reintentables, las transacciones multi-documento y las lecturas de snapshot. Utilizan las sesiones de servidor como marco subyacente. - copias de seguridad en la nube
Almacenamiento de copias de seguridad del clúster localizado mediante la funcionalidad de instantáneas nativa del proveedor de servicios en la nube del clúster.
Atlas admite copias de seguridad en la nube para clústeres alojados en:
- clúster
Conjunto de nodos que componen una implementación de MongoDB. Los clústeres pueden ser conjuntos de réplicas o implementaciones fragmentadas.
- clase de clúster
Configurable para clústeres M40+ alojados en AWS.
Clase de almacenamiento del clúster. La clase que se ha seleccionado afecta el rendimiento del almacenamiento del clúster y los costos del clúster. Se puede elegir una de las siguientes clases:
- Low CPU
- General
- Local NVMe SSD
- nivel de clúster
Determina las especificaciones de memoria, almacenamiento, vCPU e IOPS para cada servidor de datos del clúster. El tamaño del almacenamiento del clúster y el rendimiento general aumentan a medida que aumenta el nivel del clúster.
- cluster-to-cluster sync
- Sincroniza datos entre clústeres fragmentados. También conocido como sincronización C2C.
- colección con índice clusterizado
- Una colección que almacena documentos ordenados por una clave de índice agrupado. Véase Colecciones agrupadas.
- CMK
- Abreviatura de Clave Maestra de Cliente, véase Clave Maestra de Cliente.
- Colección
- Una colección es el equivalente a una tabla de un sistema de gestión de bases de datos relacionales (RDBMS). Una colección se encuentra en una única base de datos. Las colecciones no imponen un esquema. Los documentos de una colección pueden tener campos diferentes. Por lo general, los documentos de una colección tienen un propósito similar o relacionado. Véase Espacios de nombres.
- escaneo de colección
- Los escaneos de colección son una estrategia de ejecución de queries en la que MongoDB debe inspeccionar cada documento de una colección para verificar si cumple con los criterios de query. Estos query son muy ineficientes y no utilizan índices. Consulte Optimización de los query para obtener más información sobre las estrategias de ejecución de consultas.
- confirmación
- Guarda los cambios de datos realizados después del inicio del comando
startSession. Las operaciones dentro de una transacción no son permanentes hasta que se confirman con el comandocommitTransaction. - quórum de confirmación
- Durante una creación de índices, el quórum de confirmación especifica cuántos secundarios deben estar listos para confirmar su creación de índices local antes de que el nodo primario realice la confirmación.
- Índice compuesto
- Un índice que consiste de dos o más claves. Consultar Índices compuestos.
- control de concurrencia
- El control de concurrencia garantiza que las operaciones de la base de datos se puedan ejecutar simultáneamente sin comprometer su integridad. El control de concurrencia pesimista, como el que se utiliza en sistemas con bloqueos, bloquea cualquier operación potencialmente conflictiva, incluso si no existe tal conflicto. El control de concurrencia optimista, el enfoque utilizado por WiredTiger, retrasa la comprobación hasta después de que se haya producido un posible conflicto, finalizando y reintentando una de las operaciones en caso de conflicto de escritura.
- config database
- Base de datos interna con metadatos para un clúster fragmentado. Normalmente, no se modifica la base de datos
config. Para obtener más información sobre la base de datosconfig, consulte Base de datos de configuración. - config server
- Una instancia
mongodque almacena todos los metadatos asociados a un clúster fragmentado.Consulte Servidores de configuración. - partición de configuración
- Una instancia
mongodque almacena todos los metadatos asociados a un clúster fragmentado y que también puede almacenar datos de la aplicación.Consulte la sección Fragmentos de configuración. - pool de conexiones
- Una caché de conexiones a bases de datos mantenida por el controlador. Las conexiones en caché se reutilizan cuando se requieren conexiones a la base de datos, en lugar de abrir nuevas conexiones.
- tormenta de difusión
- Un escenario en el que un controlador intenta abrir más conexiones a una implementación de las que esa implementación puede gestionar. Cuando las solicitudes de nuevas conexiones fallan, el controlador solicita establecer aún más conexiones en respuesta a que la implementación se ralentiza o no logra abrir nuevas conexiones. Estas solicitudes continuas pueden sobrecargar la implementación y provocar interrupciones del servicio.
- contenedor
- Un conjunto de software y sus librerías dependientes empaquetados juntos para facilitar la transferencia entre entornos informáticos. Los contenedores se ejecutan como procesos compartimentados en el sistema operativo y pueden tener sus propias restricciones de recursos. Las tecnologías comunes de contenedores son Docker y Kubernetes.
- factor de contención
- Varias operaciones que intentan modificar el mismo recurso, como un campo de documento, generan conflictos que retrasan las operaciones. El factor de contención es una configuración utilizada con Queryable Encryption para particionar internamente los pares de campo/valor cifrados y optimizar las operaciones. Ver contención.
- similitud coseno
- Métrica que utiliza el ángulo entre dos vectores para determinar su similitud. La similitud del coseno es sensible a la orientación del vector. Puede usar la función de similitud del coseno al indexar sus incrustaciones vectoriales para Atlas Vector Search. Si los vectores están normalizados a longitud unitaria, utilice la función de similitud del producto escalar.
- Robo de CPU
- El porcentaje en que el uso de la CPU supera la tasa de acumulación de créditos de CPU base garantizada. El robo de CPU es relevante para los proveedores de nube que se basan en el modelo de créditos en su estrategia de ráfaga. Los créditos de CPU son unidades de utilización de CPU que se acumulan. Los créditos se acumulan a una tasa constante para proporcionar un nivel de rendimiento garantizado. Puede utilizar estos créditos para obtener rendimiento adicional de la CPU. Cuando se agota el saldo de créditos, MongoDB solo proporciona el rendimiento base garantizado de la CPU y muestra el exceso como porcentaje de robo. Véase también utilización relativade la CPU del sistema, utilización base de la CPU e instancias con capacidad de ráfaga.
- CRUD
- Un acrónimo para las operaciones fundamentales de una base de datos: crear, leer, actualizar y borrar (CRUD, por sus siglas en inglés). Vea Operaciones CRUD de MongoDB.
- CSV
- Un formato de datos de texto con valores separados por comas. Los archivos CSV se pueden usar para intercambiar datos entre bases de datos relacionales porque contienen datos tabulares. Puedes importar archivos CSV usando
mongoimport. - cursor
- Un puntero al conjunto de resultados de una consulta. Los clientes pueden iterar a través de un cursor para recuperar resultados. Por defecto, los cursores que no se abren dentro de una sesión se cierran automáticamente después de 10 minutos de inactividad. Los cursores abiertos en una sesión se cierran al finalizar o expirar la sesión.Consulte Cursores.
- rol personalizado
Conjunto personalizado de acciones de privilegios y roles de MongoDB que puede guardar y asignar a un usuario de la base de datos. Cree roles personalizados cuando los roles integrados de Atlas no describan el conjunto de privilegios que desea.
- Llave maestra de cliente
- Una clave que cifra su clave de cifrado de datos. La clave maestra del cliente debe estar alojada en un proveedor de claves remoto.
- daemon
- Un proceso en segundo plano, no interactivo.
- directorio de datos
- La ubicación del sistema de archivos donde
mongodalmacena los archivos de datos.dbPathespecifica el directorio de datos. - Llave de cifrado de datos
- Una clave que se utiliza para cifrar los campos de los documentos de MongoDB. La clave de cifrado de datos cifrada se almacena en la colección de Key Vault. Esta clave se cifra mediante la clave maestra del cliente.
- Data Explorer
Herramienta en Atlas para visualizar e interactuar con datos de clúster. También puedes usar Data Explorer para gestionar índices y ejecutar pipelines de agregación para procesar tus datos.
- Federación de Datos
MongoDB ofrece la solución para consultar datos almacenados en buckets S3 de bajo costo, clústeres Atlas y puntos finales HTTP mediante el lenguaje de consulta de MongoDB. Las aplicaciones de análisis pueden usar Atlas Data Federation para aprovechar los datos archivados y procesarlos según sus necesidades.
- archivos de datos
- Almacenar datos e índices de documentos. La opción
dbPathespecifica la ubicación del sistema de archivos para los archivos de datos. - pipeline de ingesta de datos
- Flujo de trabajo para organizar y transformar datos utilizando RAG y almacenarlos en una base de datos vectorial como Atlas.
- partición de datos
- Una arquitectura de sistema distribuido que realiza la división de datos en rangos. Fragmentación utiliza particionamiento. Vea particionamiento de bloque de información.
- conciencia del centro de datos
- Una propiedad que permite a los clientes dirigirse a los miembros de un sistema en función de su ubicación. Losconjuntos de réplicas implementan la detección de centros de datos mediante el etiquetado. Consulte Detección de centros de datos.
- database
- Un contenedor para colecciones. Cada base de datos tiene un conjunto de archivos en el sistema de archivos. Un servidor MongoDB normalmente tiene varias bases de datos.
- comando de base de datos
- Una operación de MongoDB, distinta de una inserción, actualización, eliminación o query. Para obtener una lista de comandos de base de datos, consulta Comandos de base de datos. Para usar comandos de base de datos, consulta Emitir comandos.
- exfiltración de base de datos
- La exfiltración de base de datos se refiere a que una parte autorizada toma datos de un sistema seguro y hace uso compartido de estos con una parte no autorizada o los almacena en un sistema no seguro. Esto puede deberse a un accionar malicioso o accidental.
- database profiler
- Una herramienta que, cuando se habilita, mantiene un registro de todas las operaciones de larga duración en la colección
system.profilede una base de datos. El perfilador se utiliza con mayor frecuencia para diagnosticar los query lentos. Ve Perfilador de base de datos. - usuario de base de datos
Credenciales utilizadas para autenticar a un cliente y permitirle el acceso a un clúster de MongoDB. Se pueden asignar privilegios a un usuario de base de datos para determinar su nivel de acceso al clúster. Los usuarios de base de datos son diferentes de los usuarios de Atlas. Los usuarios de base de datos tienen acceso a las implementaciones de MongoDB, no a la aplicación Atlas.
- dbpath
- La ubicación del almacenamiento de archivos de datos de MongoDB. Ve
dbPath. - DDL (Lenguaje de Definición de Datos)
- DDL incluye comandos que crean y modifican colecciones e índices.
- fila de letra muerta
- Una fila de letra muerta es una colección dentro de una base de datos Atlas que almacena documentos que generan errores durante la ingesta.
- clúster dedicado
Categoría de clúster que contiene clústeres de nivel
M10y superior.NivelEntornos recomendadosM10yM20Desarrollo
Producción de baja carga de tráfico
M30y superiorProducción
- servidor de configuración dedicado
- Una instancia
mongodque solo almacena todos los metadatos asociados con un clúster fragmentado. - DEK
- Clave de cifrado de datos. Para obtener más detalles, consulte la sección Clave de cifrado de datos.
- miembro atrasado
- Un miembro del conjunto de réplicas que no puede convertirse en principal y que aplica operaciones con un retardo especificado. Este retardo es útil para proteger los datos de errores humanos (bases de datos eliminadas accidentalmente) o de actualizaciones que tengan efectos imprevistos en la base de datos de producción. Consulte Miembros del conjunto de réplicas con retardo.
- vectores densos
- Representación numérica de datos donde la mayoría o todas las dimensiones contienen valores distintos de cero. Atlas búsqueda vectorial utiliza vectores densos, que están repletos de más datos, para capturar relaciones más complejas.
- implementación
- Un grupo de servidores MongoDB que contienen sus datos. Los clústeres administrados por Atlas son clústeres (conjuntos de réplicas o clústeres fragmentados).
- dimensión
- Número de componentes o elementos que conforman las funcionalidades o atributos de los datos en espacios multidimensionales. Atlas Vector Search admite hasta
4096dimensiones en el momento de la indexación y en el momento de la query. - Documento
- Un registro en una colección de MongoDB es la unidad básica de datos en MongoDB. Los documentos son análogos a los objetos JSON, pero existen en la base de datos en un formato más rico en tipos conocido como BSON. Véase Documentos.
- Notación de puntos
- MongoDB utiliza la notación de puntos para acceder a los elementos de un arreglo y a los campos de un documento incrustado. Consultar notación de puntos.
- similitud de producto punto
- Mide la similitud entre dos vectores en un espacio multidimensional y devuelve un valor escalar, que es positivo cuando los vectores apuntan aproximadamente en la misma dirección, negativo cuando los vectores apuntan en direcciones opuestas y cero cuando los vectores no tienen similitud. Atlas Vector Search admite el uso de la función de similitud
dotproductal buscar los vecinos más cercanos. Recomendamos esta función de similitud en lugar de la similitud coseno si los vectores están normalizados a longitud unitaria. - drenar
- El proceso detransferir fragmentos de un shard a otro. Los administradores deben vaciar los shards antes de eliminarlos del clúster. Consulte Eliminar fragmentos de un clúster fragmentado.
- controlador
- Una biblioteca cliente para interactuar con MongoDB en un lenguaje de programación específico. Véase controlador.
- durable
- Una operación de escritura es duradera cuando persiste tras el apagado (o fallo) y el reinicio de uno o más procesos del servidor. Para un único servidor
mongod, una operación de escritura se considera duradera cuando se ha escrito en el archivo de registro del servidor. Para un conjunto de réplicas, una operación de escritura se considera duradera después de que la operación de escritura alcance la durabilidad en la mayoría de los nodos con derecho a voto y se haya escrito en los registros de la mayoría de dichos nodos. - nodo elegible
- Nodo que puede convertirse en el miembro principal de su conjunto de réplicas. Atlas prioriza los nodos de la región de mayor prioridad para la elegibilidad primaria durante las elecciones. Para garantizar elecciones confiables, el número total de nodos elegibles en toda una región debe ser 3, 5 o 7.
- elección
- Proceso mediante el cual los miembros de un conjunto de réplicas seleccionan un nodo primario al iniciar el sistema y en caso de fallo. Véase Elección de conjuntos de réplicas.
- integración
- Representación de datos como textos, imágenes, audio, video, etc., en un arreglo de números, que pueden interpretarse como coordenadas en un espacio multidimensional. Atlas admite el almacenamiento de embeddings en un clúster de Atlas y Atlas Vector Search admite la indexación y búsqueda de embeddings vectoriales de hasta
4096dimensiones. - llave de cifrado
String aleatoria de bits generada específicamente para cifrar y descifrar datos.
Atlas
Project Ownerspermite configurar una capa adicional de cifrado para los datos, además del cifrado predeterminado que proporciona Atlas. Los propietarios de proyectos pueden usar su proveedor de gestión de claves de cliente compatible con Atlas junto con el motor de almacenamiento cifrado de MongoDB.Atlas admite los siguientes proveedores de gestión de claves de cliente al configurar el cifrado en reposo:
- esquema de cifrado
- En Queryable Encryption, el JSON schema que define qué campos son consultables y qué tipos de consultas se permiten en esos campos.
- endianness
- En informática, el orden de bytes (endianness) se refiere a la secuencia de los bytes. Este orden puede referirse a la transmisión a través de un medio de comunicación o, más comúnmente, a cómo se organizan los bytes en la memoria del ordenador, según su importancia y posición. Para más detalles, consulte big-endian y little-endian.
- encriptación de sobre
- Un procedimiento de cifrado en el que los datos se cifran mediante una clave de cifrado de datos, la cual, a su vez, se cifra con otra clave denominada clave maestra del cliente. Las claves cifradas se almacenan como documentos BSON en una colección de MongoDB llamada KeyVault.
- similitud euclidiana
- Fórmula para calcular la similitud utilizando la distancia entre dos vectores en un espacio multidimensional. La distancia euclidiana es sensible a la magnitud de los vectores. Atlas Vector Search admite el uso de
euclideancomo función de similitud para indexación de vectores y buscar vecinos más cercanos. - coherencia eventual
- Un modelo de coherencia en el que, si no se producen nuevos guardados, todas las lecturas de un elemento de datos acaban devolviendo el valor escrito más recientemente. En un sistema de base de datos, esto significa que no se garantiza que los nodos de lectura reflejen guardar más recientes.
- cifrado explícito
- Al usar el cifrado en uso, especifique explícitamente la operación de cifrado o descifrado, el ID de clave y el tipo de consulta (para el cifrado consultable) o el algoritmo (para el cifrado de campo del lado del cliente) al trabajar con datos cifrados. Compárese con el cifrado automático.
- expresión
Un componente de una query que se resuelve en un valor. Las expresiones no tienen estado, lo que significa que devuelven un valor sin modificar ninguno de los valores utilizados para crear la expresión.
En el lenguaje del query de MongoDB, puedes crear expresiones a partir de los siguientes componentes:
ComponenteEjemploConstantes
3Operadores
Expresiones de ruta de campo
"$<path.to.field>"Por ejemplo,
{ $add: [ 3, "$inventory.total" ] }es una expresión que consta del operador$addy dos operandos:La constante
3La expresión de ruta de campo
"$inventory.total"
La expresión devuelve el resultado de sumar 3 al valor en la ruta
inventory.totaldel documento de entrada.- conmutación por error
- Proceso que permite que un miembro secundario de un conjunto de réplicas se convierta en primario en caso de fallo. Véase Conmutación por error automática.
- Campo
- Un par nombre-valor en un documento. Un documento tiene cero o más campos. Los campos son análogos a las columnas en las bases de datos relacionales.Véase Estructura del documento.
- ruta de campo
- Ruta a un campo en un documento. Para especificar una ruta de campo, utiliza una string que anteponga el nombre del campo con un signo de dólar (
$). - cortafuegos
- Un filtro de red a nivel de sistema que restringe el acceso en función de las direcciones IP y otros parámetros. Los cortafuegos son parte de una red segura. Consultar Cortafuegos.
- clúster gratuito y flexible
Categoría de clúster que incluye los clústeres
FreeyFlex. Los clústeres gratuitos y flexibles se utilizan generalmente para desarrollo y pequeñas cargas de trabajo de producción. Los clústeres gratuitos no caducan y proporcionan acceso a un subconjunto de las características y funcionalidades de Atlas.- fsync
Una llamada al sistema que vacía todas las páginas sucias en memoria a almacenamiento. A medida que las aplicaciones guardan datos, MongoDB registra los datos en la capa de almacenamiento.
Para garantizar la durabilidad de los datos, WiredTiger utiliza puntos de control. Para obtener más información, consulte la sección "Registro de eventos" y "Motor de almacenamiento de WiredTiger".
- geohash
- Un valor de geohash es una representación binaria de la ubicación en una cuadrícula de coordenadas. Consultar Valores de Geohash.
- GeoJSON
- GeoJSON es un formato de intercambio de datos geoespaciales basado en JSON (JavaScript Object Notation). Se utiliza en consultas geoespaciales. Para ver los objetos GeoJSON compatibles, consulte Datos geoespaciales. Para consultar la especificación del formato GeoJSON, visite https://tools.ietf.org/html/rfc7946#section-3.1.
- Geoespacial
- Relacionado con la ubicación geográfica. Consultar Los query geoespaciales.
- clúster global
Clústeres con zonas geográficas definidas para admitir operaciones de lectura y escritura conscientes de la ubicación para instancias de aplicaciones y clientes distribuidos globalmente. Puede habilitarse la fragmentación global en clústeres de nivel
M30y superiores.- zona de escritura global
Zona geográfica que representa un subconjunto de la distribución global de su clúster. Cada clúster global admite hasta 9 zonas de escritura globales distintas. Cada zona consta de una región de máxima prioridad y una o más regiones elegibles, desolo lectura o analíticas.
Las regiones geográficas disponibles dependen del proveedor de servicios de nube seleccionado.
- GridFS
- Convención para almacenar archivos grandes en una base de datos MongoDB. Todos los controladores oficiales de MongoDB admiten la convención GridFS, al igual que el programa
mongofiles. Consulte GridFS. - group
- Ver proyecto.
- ID del grupo
- Ver ID del proyecto.
- clave de partición con hash
- Un tipo de clave de fragmentación que utiliza un hash del valor del campo de clave de fragmentación para distribuir documentos entre los miembros del clúster fragmentado. Véase Índices hash.
- gestor de verificaciones de estado
- Un gestor de salud realiza comprobaciones de estado en una faceta del gestor de salud con un nivel de intensidad especificado. Estas comprobaciones se realizan a intervalos de tiempo determinados. Un gestor de salud puede configurarse para mover automáticamente un mongos con fallos fuera de un clúster.
- faceta de gestión de verificaciones de estado
- Conjunto de funciones que un administrador de salud puede configurar para realizar comprobaciones de estado. Por ejemplo, puede configurar un administrador de salud para supervisar y gestionar automáticamente los problemas de estado de los clústeres DNS o LDAP. Consulte la sección "Aspectos del administrador de salud" para obtener más información.
- miembro oculto
- Un miembro del conjunto de réplicas que no puede convertirse en principal y que es invisible para las aplicaciones cliente. Consulte Miembros ocultos del conjunto de réplicas.
- grafos jerárquicos navegables de mundos pequeños
- Algoritmo para realizar una búsqueda eficiente del vecino más cercano en un espacio multidimensional. Atlas Vector Search realiza una búsqueda ANN con mundos pequeños navegables jerárquicos.
- Alta disponibilidad
La alta disponibilidad indica un sistema diseñado para durabilidad, redundancia y conmutación por error automática. Las aplicaciones que son compatibles con el sistema pueden operar sin interrupciones durante un período prolongado. Los sets de réplicas de MongoDB admiten alta disponibilidad cuando se implementan de acuerdo con las mejores prácticas.
Para obtener orientación sobre la arquitectura de implementación de sets de réplicas, consulta Arquitecturas de implementación de sets de réplicas.
- región de mayor prioridad
Región perteneciente a un grupo multirregional al que Atlas da prioridad en cuanto a elegibilidad primaria durante las elecciones.
- Búsqueda híbrida
- Método para combinar diferentes métodos de búsqueda, como la búsqueda de texto completo y la búsqueda semántica, para aprovechar sus respectivas fortalezas. Los resultados se combinan utilizando una técnica como la Fusión de Rangos Recíprocos (RRF).
- idempotent
- Una operación produce el mismo resultado con la misma entrada cuando se ejecuta varias veces.
- impacto
Mejora estimada del rendimiento de un índice que sugiere Performance Advisor.
- ordenación en memoria
Un algoritmo de ordenación que debe ejecutarse en memoria antes de que se devuelva el resultado. Las ordenaciones en memoria pueden afectar el rendimiento con conjuntos de datos grandes. Utilice una ordenación indexada para evitar una ordenación en memoria.
Consulta Uso de ordenación e índices para obtener más información sobre las operaciones de ordenación indexada.
- Encriptación en uso
- Cifrado que protege los datos cuando se transmiten, almacenan y procesan, y habilita los query compatibles sobre esos datos cifrados. MongoDB proporciona dos enfoques para la encriptación en uso: Queryable Encryption y Cifrado a nivel de campo del lado del cliente.
- index
- Una estructura de datos que optimiza los query. Consulte Índices.
- Límites del índice
- El rango de valores de índice que MongoDB busca al usar un índice para ejecutar un query. Para obtener más información, consultar Límites del índice multiclave.
- firma de índice
- La combinación de parámetros que identifican de manera única el índice.
- ordenación indexada
- Una ordenación donde un índice proporciona el resultado ordenado. Las operaciones de ordenación que utilizan un índice suelen tener un mejor rendimiento que la ordenación en memoria. Consulte «Usar índices para ordenar los resultados de una consulta» para obtener más información.
- init script
- Un script de shell utilizado por el sistema de inicio de una plataforma Linux para iniciar, reiniciar o detener un proceso demonio. Si instaló MongoDB mediante un gestor de paquetes, se le proporcionará un script de inicio para su sistema como parte de la instalación. Consulte la guía de instalación correspondiente a su sistema operativo.
- sistema de inicialización
- El sistema de inicio es el primer proceso que se ejecuta en una plataforma Linux tras el arranque del kernel y gestiona todos los demás procesos del sistema. El sistema de inicio utiliza un script de inicio para iniciar, reiniciar o detener un proceso demonio, como
mongodomongos. Las versiones recientes de Linux suelen utilizar el sistema de inicio systemd y el comandosystemctl. Las versiones anteriores de Linux suelen utilizar el sistema de inicio System V y el comandoservice. Consulte la guía de instalación de su sistema operativo. - Sincronización inicial
- La operación de conjunto de réplicas replica los datos de un miembro existente del conjunto de réplicas a un nuevo miembro del conjunto de réplicas. Consulte Sincronización inicial.
- bloqueo de intención
- Un bloqueo sobre un recurso indica que quien lo posee leerá (intención compartida) o escribirá (intención exclusiva) en dicho recurso, utilizando un control de concurrencia con una granularidad mayor que la del recurso con el bloqueo de intención. Los bloqueos de intención permiten la lectura y escritura concurrente de un recurso.Consulte ¿Qué tipo de bloqueo utiliza MongoDB?
- endpoint de la interfaz
AWS Punto final deVPC con una dirección IP privada que envía tráfico al servicio de punto final privado de Atlas a través de AWS PrivateLink.
- punto de interrupción
- Un punto en una operación cuando puede finalizar de manera segura. MongoDB solo finaliza una operación en los puntos de interrupción designados. Ve Terminar operaciones en ejecución.
- lista de acceso IP
Lista de direcciones IP y bloques CIDR con acceso a clústeres dentro de un proyecto Atlas. Para conexiones de clientes a través de Internet pública, Atlas permite conexiones a un clúster únicamente desde entradas incluidas en la lista de acceso IP del proyecto correspondiente. La lista de acceso puede contener hasta 200 entradas.
Atlas también permite conexiones de clientes a través de redes no públicas, como conexiones de interconexión de red o puntos finales privados. Este tipo de conexiones funcionan independientemente de la lista de control de acceso IP. Para obtener más información, consulte Interconexión de red y Acerca de los puntos finales privados en Atlas.
- IPv6
- Una revisión del estándar de IP (Protocolo de Internet) con un amplio espacio de direcciones para dar soporte a los hosts de Internet.
- ISODate
- El formato de fecha internacional utilizado por
mongoshpara mostrar fechas. El formato esYYYY-MM-DD HH:MM.SS.millis. - JavaScript
- Un lenguaje de scripting. mongosh, el intérprete de comandos
mongoy ciertas funciones del servidor utilizan un intérprete de JavaScript. Consulte JavaScript del lado del servidor para obtener más información. - journal
- Registro de transacciones binario y secuencial que se utiliza para restaurar la base de datos a un estado válido en caso de un apagado forzoso. El registro de transacciones escribe los datos primero en el registro y luego en los archivos de datos principales. Los archivos de registro se asignan previamente y existen como archivos en el directorio de datos. Consulte Registro de transacciones.
- JSON
- JSON (JavaScript Object Notation). Formato de texto plano para expresar datos estructurados, compatible con numerosos lenguajes de programación. Para más información, consulte http://www.json.org. Algunas herramientas de MongoDB generan una representación aproximada de los documentos BSON de MongoDB en formato JSON. Consulte JSON extendido de MongoDB (v2).
- Documento JSON
- Un documento JSON es una colección de campos y valores en un formato estructurado. Para ver ejemplos de documentos JSON, consulte http://json.org/example.html.
- JSONP
- JSON con relleno. Se refiere a un método para insertar JSON en aplicaciones. Presenta posibles problemas de seguridad.
- fragmento jumbo
- Un fragmento que crece más allá del tamaño especificado y no se puede dividir en fragmentos más pequeños. Para más detalles, consulte Fragmentos indivisibles/gigantes.
- Búsqueda de vecinos más cercanos K
- Dado un conjunto de puntos P con una función de similitud S definida, para un punto de consulta q, se encuentra el conjunto de k puntos en P con los mejores valores de S(p, q). La búsqueda ENN (Atlas Vector Search) devuelve los k puntos principales exactos, mientras que la búsqueda ANN devuelve k puntos que son similares a q, pero no necesariamente los k más similares a q.
- material clave
- La string aleatoria de bits utilizada por un algoritmo de cifrado para cifrar y descifrar datos.
- colección de bóvedas de llaves
- Una colección de MongoDB que almacena las claves de cifrado de datos encriptadas como documentos BSON.
- planificador kyber
- Un planificador de E/S diseñado para mejorar el rendimiento en entornos con alta contención de recursos. Mejora la interpolación de E/S y reduce el impacto de latencia de los vecinos ruidosos.
- LDAP
- Protocolo multiplataforma utilizado para autenticar usuarios y autorizarles el acceso a los datos en un clúster. Con Atlas, puede gestionar la autenticación y autorización de usuarios de todos los clientes de MongoDB mediante su propio servidor LDAP a través de TLS.Una única configuración de LDAPS se aplica a todos los clústeres de un proyecto Atlas.
- mínimo privilegio
- Una política de autorización que concede a un usuario únicamente el acceso que es esencial para su trabajo.
- legacy coordinate pairs
- El formato utilizado para datos geoespaciales antes de la versión 2.4 de MongoDB. Este formato almacena datos geoespaciales como puntos en un sistema de coordenadas planas (por ejemplo,
[ x, y ]). Consulte Consultas geoespaciales. - LineString
- Un LineString es una matriz de dos o más posiciones. Un LineString cerrado con cuatro o más posiciones se denomina LinearRing, tal como se describe en la especificación GeoJSON LineString: https://tools.ietf.org/html/rfc7946#section-3.1.4. Para usar un LineString en MongoDB, consulte Objetos GeoJSON.
- link-token
- string que contiene la información necesaria para conectar desde Cloud Manager u Ops Manager a Atlas durante una migración en vivo desde una implementación de Cloud Manager u Ops Manager a un clúster en Atlas.
- little-endian
Un orden de bytes en el que el byte menos significativo (little end) de un valor de datos multibyte se almacena en la dirección de memoria más baja.
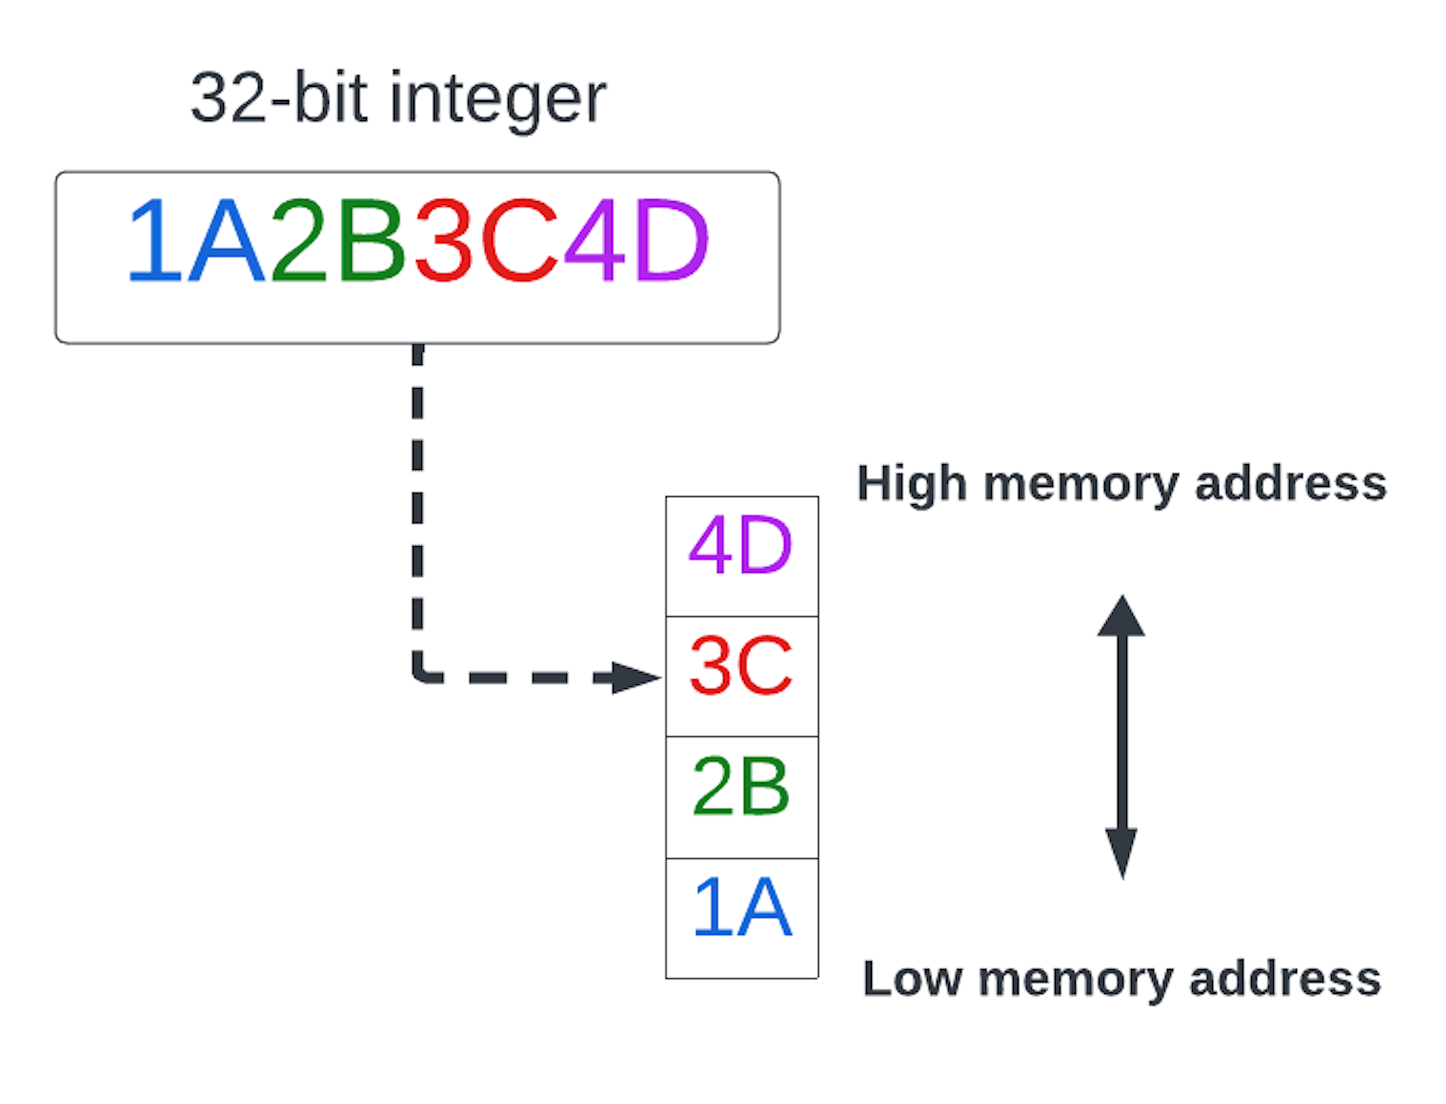 haga clic para ampliar
- migración en vivo
Proceso para migrar sin problemas un set de réplicas de origen existente o un clúster a Atlas. Durante el proceso de migración en vivo, Atlas mantiene el clúster de destino sincronizado con la fuente remota hasta que transfieras tus aplicaciones al clúster de Atlas.
- bloqueo
- MongoDB utiliza bloqueos para garantizar que la concurrencia no afecte la corrección. MongoDB utiliza bloqueos de lectura, de escritura y de intención. Para obtener más información, consulte ¿Qué tipo de bloqueo utiliza MongoDB?
- entradas de registro
- Contienen eventos del servidor, como conexiones entrantes, comandos ejecutados y problemas encontrados. Para más detalles, consulta Mensajes de registro.
- LVM
- Administrador de volúmenes lógicos. LVM es un programa que abstrae las imágenes de disco de los dispositivos físicos y ofrece varias capacidades de manipulación de discos en bruto y de snapshots útiles para la gestión del sistema. Para obtener información sobre LVM y MongoDB, consulta Copia de seguridad y restauración usando LVM en Linux.
- periodo de mantenimiento
Día y hora de la semana en que Atlas debe iniciar el mantenimiento semanal de su clúster. Puede configurar su ventana de mantenimiento en la configuración de su proyecto.
Importante
Consideraciones sobre el periodo de mantenimiento
Actividades de mantenimiento urgentes. Actividades de mantenimiento urgentes como parches de seguridad que no pueden esperar a la ventana elegida. Atlas iniciará esas actividades de mantenimiento cuando sea necesario.
Operaciones de mantenimiento en curso Una vez programado el mantenimiento para su clúster, no puede cambiar su periodo de mantenimiento hasta que finalicen las tareas de mantenimiento actuales.
El mantenimiento requiere elecciones de conjuntos de réplicas. Atlas realiza el mantenimiento de la misma manera que el procedimiento de mantenimiento descrito en el Manual de MongoDB. Este procedimiento requiere al menos una elección de conjunto de réplicas durante la ventana de mantenimiento por cada conjunto de réplicas.
El mantenimiento comienza lo más cerca posible de la hora. El mantenimiento siempre comienza lo más cerca posible de la hora programada, pero las actualizaciones en curso del clúster o problemas inesperados del sistema podrían retrasar la hora de inicio.
- Map-Reduce
- Un proceso de agregación que tiene una fase de "map" que selecciona los datos y una fase de "reduce" que transforma los datos. En MongoDB, se pueden ejecutar agregaciones arbitrarias sobre los datos mediante map-reduce. Para la implementación de map-reduce, consultar Map-Reduce. Para todos los enfoques de agregación, consultar operaciones de agregación.
- tipo de mapeo
- Una estructura en lenguajes de programación que asocia claves con valores. Las claves pueden contener pares incrustados de claves y valores (por ejemplo, diccionarios, hashes, mapas y arreglos asociativos). Las propiedades de estas estructuras dependen de la especificación del lenguaje y de su implementación. Normalmente, el orden de las claves en los tipos de mapeo es arbitrario y no está garantizado.
- md5
- Un algoritmo de hash que calcula una suma de verificación para los datos proporcionados. El algoritmo devuelve un valor único para identificar los datos. MongoDB utiliza md5 para identificar fragmentos de datos para GridFS. Consulte filemd5 (comando de base de datos).
- media
- Promedio de un conjunto de números.
- mediana
- En un conjunto de datos, la mediana es el valor percentil donde el 50 % de los datos se sitúan en ese valor o por debajo de él.
- nodo
- Un proceso mongod individual. Un conjunto de réplicas tiene varios miembros. Un miembro también se conoce como nodo.
- metadata collection
- En Queryable Encryption, las colecciones internas que MongoDB utiliza para permitir los query de campos cifrados. Consulte Colecciones de metadatos.
- MIME
- Extensiones de correo de Internet multipropósito. Un conjunto estándar de definiciones de tipo y codificación que se utiliza para declarar la codificación y el tipo de datos en múltiples contextos de almacenamiento, transmisión y correo electrónico. La herramienta
mongofilesofrece la opción de especificar un tipo MIME para describir un archivo insertado en el almacenamiento GridFS. - moda
- Número que ocurre con mayor frecuencia en un conjunto de números.
- mongo
La consola heredada de MongoDB. El proceso
mongoinicia la consola heredada como un demonio conectado a una instanciamongodomongos. La consola tiene una interfaz JavaScript.A partir de MongoDB v5.0,
mongoestá obsoleto y mongosh reemplaza amongocomo intérprete de comandos del cliente.Consulte mongosh.- mongod
- El servidor de base de datos MongoDB. El proceso
mongodinicia el servidor MongoDB como un demonio. El servidor MongoDB gestiona las solicitudes de datos y las operaciones en segundo plano. Véase mongod. - MongoDB Charts
Herramienta de visualización para tus datos de Atlas. Puedes lanzar MongoDB Charts desde tu clúster de Atlas y ver tus datos con la aplicación Charts para comenzar a visualizar tus datos.
- mongos
- El enrutador de consultas del clúster fragmentado de MongoDB. El proceso
mongosinicia el enrutador de MongoDB como un demonio. El enrutador de MongoDB actúa como interfaz entre una aplicación y un clúster fragmentado de MongoDB, y gestiona todo el enrutamiento y el equilibrio de carga en el clúster. Consulte Instancias de mongos. - mongosh
MongoDB Shell. mongosh ofrece una interfaz de shell para una instancia
mongodo unamongos.A partir de MongoDB v5.0, mongosh reemplaza a
mongocomo el intérprete de comandos preferido.- clúster multiregional
Clúster Atlas que abarca varias regiones geográficas. Los clústeres multirregionales pueden aumentar la disponibilidad y mejorar el rendimiento al dirigir las consultas de las aplicaciones a las regiones geográficas más adecuadas.
Los clústeres multirregionales deben contener nodos elegibles.
Los clústeres multirregionales pueden contener nodos de solo lectura y nodos de análisis.
- namespace
- Un namespace es una combinación del nombre de la base de datos y el nombre de la colección o índice:
<database-name>.<collection-or-index-name>. Todos los documentos pertenecen a un namespace. Ver namespaces. - Namespace Insights
Herramienta Atlas que supervisa la latencia de las consultas a nivel de colección. Permite visualizar métricas y estadísticas de latencia de consultas para determinados hosts y tipos de operaciones. Administra los espacios de nombres anclados y selecciona hasta cinco espacios de nombres para mostrar en los gráficos de latencia de consultas correspondientes.
- orden natural
Los objetos del tipo
recordIdsse crean y almacenan en el índice de WiredTiger. El orden de clasificación predeterminado para un escaneo de colección ejecutado en una sola instancia es el orden natural.En los sets de réplicas, no se garantiza que el orden natural sea coherente y puede diferir entre los nodos.
En colecciones fragmentadas, el orden natural no está definido. Sin embargo, el uso del
$naturalobliga a cada partición a realizar un escaneo de la colección.Para obtener más información, consulta Devolución en orden natural.
- partición de red
Una falla de red que separa un sistema distribuido en particiones de tal manera que los nodos de una partición no pueden comunicarse con los nodos de la otra partición.
A veces, las particiones son parciales o asimétricas. Un ejemplo de partición parcial es la división de los nodos de una red en tres conjuntos, donde los miembros del primer conjunto no pueden comunicarse con los miembros del segundo conjunto, y viceversa, pero todos los nodos pueden comunicarse con los miembros del tercer conjunto.
En una partición asimétrica, la comunicación puede ser posible solo cuando se origina en ciertos nodos. Por ejemplo, los nodos de un lado de la partición pueden comunicarse con el otro lado solo si ellos inician el canal de comunicación.
- conexión peering de red
Proceso mediante el cual dos redes de Internet se conectan e intercambian tráfico. Puede establecer una conexión directa entre su VPC y la VPC de Atlas creada para sus clústeres de MongoDB. Gracias a esta conexión, sus servidores de aplicaciones pueden conectarse directamente a Atlas sin salirse de las redes públicas.
- node
- Un proceso mongod individual. Un conjunto de réplicas tiene varios nodos. Un nodo también se conoce como miembro.
- ningún planificador
- La opción de programador
noneen el mecanismo de colas de la capa multi-cola (blk-mq) sirve la misma función que el programador heredado de operación nula (noop). No realiza cronograma de solicitudes y pasa las operaciones de E/S tal como se reciben al driver del dispositivo de bloque. - noop
- El programador No operación (
noop) asigna ancho de banda de E/S para procesos entrantes según una cola FIFO (primero en entrar, primero en salir). A partir del kernel de Linux 5.3, este planificador se sustituye por el planificadornonefuncionalmente equivalente. - NVMe
- NVMe (Non-Volatile Memory Express) es un protocolo para acceder a medios de almacenamiento de alta velocidad.
- Almacenamiento NVMe
Disponible para clústeres M40+ alojados en AWS
Para aplicaciones alojadas en AWS que requieren E/S de baja latencia y alto rendimiento, puede utilizar la clase de clúster NVMe. Esta clase aprovecha un protocolo de datos único para mejorar significativamente la velocidad de acceso a los datos.
Los clústeres NVMe utilizan un nodo secundario oculto que consta de un volumen aprovisionado con alto rendimiento y IOPS para facilitar las copias de seguridad.
- object identifier
- Ver ObjectId.
- ObjectId
- Un tipo BSON de 12 bytes que es único dentro de una colección. El ObjectId se genera utilizando la marca de tiempo, el ID del equipo, el ID del proceso y un contador incremental del proceso local. MongoDB utiliza los valores de ObjectId como valores predeterminados para los campos _id.
- operation log
- Ver oplog.
- metadatos de operación
- Información sobre la ejecución de procesos en lugar de su contenido, como la cantidad y el tiempo de las operaciones de inserción, actualización y borrado.
- filtro de rechazo de operación
- Una forma de la query rechazada. Para obtener más detalles, consulta Bloquear las query lentas con filtros de rechazo de operaciones.
- tiempo de operación
- Ver tiempo óptimo.
- nodo operativo
- Cualquier nodo elegible o un nodo de solo lectura en su clúster Atlas.
- operador
- Una palabra clave que comienza con
$se utiliza para expresar componentes MQL como predicados de consulta, expresiones y etapas de agregación. Por ejemplo,$gtes el operador "mayor que" de MQL. Para ver los operadores disponibles, consulte la Referencia del lenguaje de consulta de MongoDB. - oplog
- Una colección limitada que almacena un historial ordenado de escrituras lógicas en una base de datos MongoDB. El oplog es el mecanismo básico que permite la replicación en MongoDB. Véase Oplog del conjunto de réplicas.
- colección de búfer de oplog
Una colección temporal creada durante las operaciones de refragmentación que almacena las entradas del oplog de un fragmento donante.
Las colecciones de búfer de oplog aseguran que las particiones receptoras puedan acceder a las entradas de oplog cuando se borran de la partición donante. Las colecciones de búfer de oplog se eliminan cuando se completa el reordenamiento.
- oplog hole
- Una brecha temporal en el oplog porque las operaciones de guardar del oplog no están en secuencia. Los primarios del set de réplicas aplican entradas del oplog en paralelo como una operación por lotes. Como resultado, pueden generarse brechas temporales en el oplog debido a entradas que aún no se han escrito desde un agrupamiento.
- oplog window
Las entradas deloplog tienen una marca de tiempo. La ventana del oplog es la diferencia de tiempo entre la marca de tiempo más reciente y la más antigua en
oplog. Si un nodo secundario pierde la conexión con el primario, solo puede usar la replicación para sincronizarse nuevamente si la conexión se restablece dentro de la ventana del oplog.- optime
Una referencia a una posición en el oplog de replicación. El valor optime es un documento que contiene:
ts, la marca de tiempo de la operación.t, latermen la cual la operación fue generada originalmente en el primario.
- plan del query ordenado
- Un plan del query que devuelve resultados en el orden coherente con el
sort(). Consulta planes del query. - organización
Agrupación lógica de proyectos de Atlas. Puedes usar una organización para administrar la facturación, los usuarios y la configuración de seguridad de los proyectos que contiene.
La facturación se realiza a nivel de la organización mientras se mantiene la visibilidad del uso en cada proyecto.
Puedes ver todos los proyectos dentro de una organización.
Puedes utilizar equipos para asignar en bloque a los usuarios de la organización a proyectos dentro de esta.
- identificador de la organización
- Cadena hexadecimal única de 24 dígitos que se utiliza para identificar su organización de Atlas. El punto final Return All Organizations devuelve el ID de todas las organizaciones a las que puede acceder el usuario autenticado que ejecuta la llamada a la API.
- cursor huérfano
- Un cursor que no está correctamente cerrado ni iterado en el código de la aplicación. Los cursores huérfanos pueden causar problemas de rendimiento en la implementación de MongoDB.
- documento huérfano
En un clúster particionado, los documentos huérfanos son aquellos documentos en una partición que también existen en fragmentos en otras particiones. Esto se debe a una migración fallida o a una limpieza incompleta de la migración debido a un cierre atípico.
Los documentos huérfanos se eliminan automáticamente después de que se completa una migración de fragmentos. Ya no es necesario ejecutar
cleanupOrphanedpara borrar documentos huérfanos.- miembro pasivo
- Un miembro de un conjunto de réplicas que no puede convertirse en primario porque su
members[n].priorityes0. Véase Miembros del conjunto de réplicas de prioridad 0. - per-CPU cache
- Un tipo de caché que almacena memoria localmente para un núcleo específico de la CPU. La nueva versión de TCMalloc, que se introduce en MongoDB 8.0, utiliza las cachés por CPU.
- caché por hilo
- Un tipo de caché que almacena memoria localmente para cada hilo de aplicación. Las cachés por hilo son utilizadas por la versión heredada de TCMalloc, que se usa en MongoDB 7.0 y versiones anteriores.
- percentil
- En un conjunto de datos, un percentil es un valor donde ese porcentaje de los datos está en o por debajo del valor especificado. Para obtener más detalles, se puede consultar Comportamiento.
- Performance Advisor
Atlas es una herramienta que supervisa las consultas lentas ejecutadas en su clúster y sugiere índices para mejorar el rendimiento de las consultas. Cada índice sugerido por el Asesor de rendimiento incluye una puntuación de impacto que indica la mejora potencial del rendimiento que dicho índice aportaría.
- PID
- Un identificador de proceso. Los sistemas tipo UNIX asignan un PID entero único a cada proceso en ejecución. Puedes utilizar un PID para inspeccionar un proceso en ejecución y enviarle señales. Consulta
/procsistema de archivos. - pipe
- Un canal de comunicación en sistemas tipo UNIX que permite a procesos independientes enviar y recibir datos. En el shell de UNIX, las operaciones de pipe permiten a los usuarios dirigir la salida de un comando a la entrada de otro.
- pipeline
- Una serie de operaciones en una agregación. Consulta pipeline de agregación.
- forma de la query de caché del plan
Una combinación de predicado de consulta, ordenación,proyección y cotejo. La formade consulta de la caché de planes permite a MongoDB identificar consultas equivalentes y analizar su rendimiento.
Para el predicado de query, solo se utilizan la estructura del predicado y los nombres de campo. Los valores en el predicado de query no se utilizan. Por ejemplo, un predicado de query
{ type: 'food' }es equivalente a{ type: 'drink' }.Para identificar las queries lentas con la misma forma de la query de caché de planes, cada forma de la query de caché de planes tiene un valor hexadecimal
planCacheShapeHash. Para obtener más información, consulta planCacheShapeHash y planCacheKey.A partir de MongoDB 8.0, el campo
queryHashexistente se duplica en un nuevo campo llamadoplanCacheShapeHash. Si estás utilizando una versión anterior de MongoDB, solo verás el campoqueryHash. Las versiones futuras de MongoDB removerán el campoqueryHashobsoleto y deberás utilizar el campoplanCacheShapeHashen su lugar.- punto
- Un único par de coordenadas, tal como se describe en la especificación GeoJSON Point: https://tools.ietf.org/html/rfc7946#section-3.1.2. Para usar un Point en MongoDB, consulte GeoJSON Objects.
- polígono
Una matriz de matrices de coordenadas LinearRing, como se describe en la especificación GeoJSON Polygon: https://tools.ietf.org/html/rfc7946#section-3.1.6. Para polígonos con múltiples anillos, el primero debe ser el anillo exterior y los demás deben ser anillos interiores o agujeros.
MongoDB no permite que el anillo exterior se autointersecte. Los anillos interiores deben estar completamente contenidos dentro del bucle exterior y no deben cruzarse ni superponerse entre sí. Consulta Objetos GeoJSON.
- documento post-imagen
- Un documento después de ser insertado, reemplazado o actualizado. Consultar Change Streams con imágenes de documentos antes y después.
- powerOf2Sizes
- Configuración para cada colección que asigna espacio a cada documento para maximizar la reutilización del almacenamiento y reducir la fragmentación.
powerOf2Sizeses la configuración predeterminada para las colecciones TTL. Para cambiar la configuración de la colección, consultecollMod. - documento pre-imagen
- Un documento antes de ser sustituido, actualizado o borrado. Consultar Change Streams con imágenes de documentos antes y después.
- pre-división
- Una operación que se realiza antes de insertar datos y que divide el rango de posibles valores de clave de fragmentación en bloques para facilitar la inserción y lograr un alto rendimiento de escritura. En algunos casos, la pre-división acelera la distribución inicial de documentos en un clúster fragmentado al dividir manualmente la colección en lugar de esperar a que lo haga el balanceador de MongoDB. Consulte Crear rangos en un clúster fragmentado.
- reducción de prefijo
- Reduce el consumo de memoria y disco al almacenar cualquier prefijo de clave de índice idéntico solo una vez por página de memoria. Ver: Compresión para más información sobre el comportamiento de compresión de WiredTiger.
- primario
- En un conjunto de réplicas, el miembro principal es el que recibe todas las operaciones de escritura. Véase Principal.
- llave primaria
- Identificador único e inmutable de un registro. En los sistemas de gestión de bases de datos relacionales (RDBMS), la clave primaria suele ser un número entero almacenado en el campo
idde cada fila. En MongoDB, el campo _id almacena la clave primaria de un documento, que suele ser un ObjectId BSON. - partición primaria
- Cada base de datos en un clúster particionado tiene una partición primaria. Es el fragmento por defecto para todas las colecciones no particionadas en la base de datos. Consulta Partición primaria.
- prioridad
- Un valor configurable que ayuda a determinar qué miembros de un conjunto de réplicas tienen más probabilidades de convertirse en primarios.Véase
members[n].priority. - privilegio
- Una combinación de un recurso específico y las acciones permitidas sobre dicho recurso. Véase privilegio.
- Proyecto
Agrupación lógica de clústeres. Puede haber varios clústeres dentro de un mismo proyecto y varios proyectos dentro de una misma organización.
Nota
Proyecto es sinónimo de grupo.
- ID del proyecto
Cadena hexadecimal única de 24 dígitos que se utiliza para identificar su proyecto de Atlas. El punto final de la API Obtener todos los proyectos devuelve el ID de todos los proyectos a los que puede acceder el usuario autenticado que ejecuta la llamada a la API.
Nota
El Identificador del proyecto es sinónimo del ID del grupo.
- proyección
- Documento proporcionado a una consulta que especifica los campos que MongoDB devuelve en el conjunto de resultados. Para obtener más información sobre las proyecciones, consulte Proyectar campos para devolver desde una consulta.
- cuantización
- Método para comprimir el valor de dimensiones individuales en un vector a un rango más pequeño para reducir el consumo de recursos y aumentar la velocidad. Atlas Vector Search admite la indexación y consulta de vectores cuantizados.
- Consulta
- Solicitud de lectura. MongoDB utiliza un lenguaje de consulta en formato JSON que incluye operadores cuyos nombres comienzan con el carácter
$. Enmongosh, puede ejecutar consultas utilizando los métodosdb.collection.find()ydb.collection.findOne(). Consulte la sección "Leer documentos". - estructura del query
- Una combinación del optimizador de consultas y el motor de ejecución de consultas que procesa una operación.
- operador del query
- Una palabra clave que empieza por
$en un query. Por ejemplo,$gtes el operador "mayor que". Para obtener una lista de los operadores del query, consultar operadores del query. - optimizador del query
- Un proceso que genera planes del query. Para cada query, el optimizador genera un plan que hace coincidir la query con el índice que devuelve los resultados de la manera más eficiente posible. El optimizador reutiliza el plan del query cada vez que se ejecuta el query. Si una colección cambia significativamente, el optimizador crea un nuevo plan del query. Consultar planes del query.
- plan del query
- El plan de ejecución más eficiente elegido por el planificador de query. Para obtener más detalles, consultar Planes del query.
- predicado de query
Una expresión que devuelve un valor booleano que indica si un documento coincide con la query especificada. Por ejemplo,
{ name: { $eq: "Alice" } }, que devuelve documentos que tienen un campo"name"cuyo valor es la string"Alice".Los predicados de query pueden contener expresiones secundarias y operadores para coincidencias más complejas. Para ver los operadores del query disponibles, consultar Predicados de query.
- Perfilador de la query
- Herramienta de Atlas que diagnostica y supervisa problemas de rendimiento en tu clúster. El Query Profiler puede revelar consultas de larga duración y sus estadísticas de rendimiento. Puede filtrar los datos devueltos por el perfilador del query para centrarse en namespaces y tipos de operaciones específicos.
- forma del query
Una forma de la query es un conjunto de especificaciones que agrupan query similares. Para obtener más detalles, consulta Formas de la query.
- rango
- Un rango contiguo de valores de clave de fragmento dentro de un bloque. Los rangos de datos incluyen el límite inferior y excluyen el límite superior. MongoDB migra datos cuando un fragmento contiene demasiados datos de una colección en relación con otros fragmentos. Consulte Particionamiento de datos con bloques y Balanceador de clúster fragmentado.
- RDBMS
- Sistema de gestión de bases de datos relacionales. Un sistema de gestión de bases de datos basado en el modelo relacional, que normalmente utiliza SQL como lenguaje de consulta.
- readConcern
- Especifica un nivel de aislamiento para las operaciones de lectura. Por ejemplo, puede usar la restricción de lectura para leer solo los datos que se hayan propagado a la mayoría de los nodos en un conjunto de réplicas. Consulte la sección "Restricción de lectura".
- bloqueo de lectura
- Un bloqueo compartido sobre un recurso, como una colección o una base de datos, que, mientras está activo, permite la lectura simultánea pero no la escritura. Véase ¿Qué tipo de bloqueo utiliza MongoDB?
- preferencia de lectura
- Configuración que determina cómo los clientes dirigen las operaciones de lectura. La preferencia de lectura afecta a todos los conjuntos de réplicas, incluidos los conjuntos de réplicas de fragmentos. Por defecto, MongoDB dirige las lecturas a las réplicas primarias. Sin embargo, también puede dirigirlas a las secundarias, donde podrían devolver datos obsoletos. Consulte Preferencia de lectura.
- nodo de solo lectura
- El conjunto de réplicas se ubica en una región geográfica específica que complementa las regiones de nodos seleccionables. Puede usar nodos de solo lectura para ubicar los datos donde se leen con mayor frecuencia y así mejorar el rendimiento.
- Panel de rendimiento en tiempo real
Servicio de monitorización de Atlas que muestra el tráfico de red actual, las operaciones de base de datos en sus clústeres y las estadísticas de hardware de sus máquinas host. Utilice RTPP para evaluar visualmente los tiempos de ejecución de las consultas, monitorizar la actividad de la red y detectar posibles retrasos en la replicación de los miembros secundarios de los conjuntos de réplicas.
- recuperar
- Mide la fracción de vecinos más cercanos reales que devolvió una búsqueda ANN. Esta medida refleja qué tan cerca se aproxima el algoritmo a los resultados de la búsqueda ENN. La notación Recall@k se refiere a la medida de cuántos de los vecinos más cercanos reales estaban presentes en los k mejores resultados devueltos por Atlas Vector Search.
- recuperando
- El estado de un miembro del conjunto de réplicas indica que un miembro no está listo para comenzar las actividades de un miembro secundario o primario. Los miembros en recuperación no están disponibles para lectura.
- utilización relativa de la CPU del sistema
Para los clústeres
M10yM20, la utilización de la CPU en relación con la utilización de CPU de referencia asignada a la instancia. Se calcula dividiendo el valor Normalized System CPU entre el porcentaje de CPU de referencia. Este valor no es visible directamente en las métricas de Atlas, y el porcentaje de CPU de referencia no se muestra en el panel de métricas. Para estimarlo, divida la lectura Normalized System CPU entre un valor de referencia en el rango 20%–50% típico de los tipos de instancias con capacidad de ráfaga.Atlas limita este valor a 100%. Véase también la utilización absoluta de la CPU del sistema, lautilización base de la CPU y las instancias con capacidad de ráfaga.
- set de réplicas
- Grupo de servidores de MongoDB que mantienen el mismo conjunto de datos. Los sets de réplicas proporcionan redundancia, alta disponibilidad y son la base para todas las implementaciones de producción.
- Replicación
- Una característica que permite a varios servidores de bases de datos compartir los mismos datos. La replicación asegura la redundancia de datos y facilita el balanceo de carga. Consulte Replicación.
- atraso de la replicación
- El intervalo de tiempo entre la última operación registrada en el oplog del servidor principal y la última operación aplicada a un servidor secundario específico. Generalmente, se busca que el retardo de replicación sea lo más corto posible.Consulte Retardo de replicación.
- memoria residente
- La memoria residente es un subconjunto de la memoria de una aplicación que se almacena actualmente en la RAM física. La memoria virtual incluye la memoria asignada a la RAM física y al almacenamiento.
- resource
- Una base de datos, colección, conjunto de colecciones o clúster. Un privilegio permite realizar acciones sobre un recurso específico. Véase recurso.
- rol
- Conjunto de privilegios que permiten realizar acciones sobre recursos específicos. Los roles asignados a un usuario determinan su acceso a los recursos y las operaciones. Véase Seguridad.
- rollback
- Un proceso que revierte las operaciones de guardado para garantizar la coherencia de todos los miembros del set de réplicas. Ver Rollbacks durante la conmutación por error de un set de réplicas.
- reinicio en secuencia
- Proceso que reinicia todos los nodos del clúster en secuencia. Para mantener la disponibilidad del clúster, Atlas reinicia un nodo a la vez, comenzando por un nodo secundario. Atlas mantiene siempre un nodo primario hasta que finaliza el reinicio progresivo.
- Cuantificación escalar
- La cuantización escalar implica seleccionar los valores mínimo y máximo en todos los vectores indexados de un segmento para cada dimensión, y producir espacios con el mismo tamaño entre esos valores. Las correspondencias de cada una de estas dimensiones con los espacios proporcionan los nuevos valores cuantizados. Atlas Vector Search admite la cuantización escalar automática para vectores float32 y la ingesta e indexación de tus vectores cuantizados mediante proveedores de embeddings.
- secundario
- Un miembro del conjunto de réplicas que replica el contenido de la base de datos maestra. Los miembros secundarios pueden realizar solicitudes de lectura, pero solo los miembros primarios pueden realizar operaciones de escritura. Consulte la sección "Secundarios".
- índice secundario
- Un índice de base de datos que mejora el rendimiento de las query al minimizar la cantidad de trabajo que el motor de las query debe realizar para ejecutar una query. Consultar Índices.
- miembro secundario
- Véase secundario. También conocido como nodo secundario.
- lista de nodos iniciales
- Los controladores y clientes (como
mongosh) utilizan una lista de semillas para el descubrimiento inicial de la configuración del conjunto de réplicas. Las listas de semillas se pueden proporcionar como una lista de pareshost:port(consulte el formato de cadena de conexión estándar o mediante entradas DNS). Para obtener más información, consulte el formato de conexión SRV. - autogestionamiento
- Cuando una persona u organización es la encargada de configurar y mantener una instancia de MongoDB, y no una gestión externa o servicios de terceros (como MongoDB Atlas).
- Semantic Search
- Busca valores que tengan un significado similar a la query. La búsqueda semántica capta la relación natural entre palabras o frases incluso cuando no existe una coincidencia léxica. La búsqueda semántica y la búsqueda vectorial suelen usarse indistintamente. Atlas Vector Search ofrece capacidad de búsqueda semántica sobre datos vectoriales almacenados en clústeres de Atlas.
- nombre del conjunto
- El nombre arbitrario dado a un set de réplicas. Todos los nodos de un set de réplicas deben tener el mismo nombre especificado con la configuración
replSetNameo la opción--replSet. - partición
- Una única instancia
mongodo conjunto de réplicas que almacena parte del conjunto de datos total de un clúster fragmentado. Normalmente, en un entorno de producción, asegúrese de que todos los fragmentos formen parte de conjuntos de réplicas.Consulte Fragmentos. - clave de partición
- El campo que usa MongoDB para distribuir documentos entre los miembros de un clúster fragmentado. Consulte Claves de fragmentación.
- clúster fragmentado
- El conjunto de nodos que componen una implementación particionada de MongoDB. Un clúster particionado consta de servidores de configuración, particiones y uno o más procesos de enrutamiento de
mongos. Consulta Componentes del clúster particionado. - fragmentación
- Una arquitectura de base de datos que particiona los datos por rangos de claves y distribuye los datos entre dos o más instancias de base de datos. El particionado permite el escalado horizontal. Consulta Particionado.
- asistente de shell
- Un método en
mongoshque tiene una sintaxis concisa para un comando de base de datos. Los asistentes de shell mejoran la experiencia interactiva. Consulte Métodos de mongosh. - función de similitud
- Mide la similitud entre dos vectores. Atlas búsqueda vectorial admite las funciones de similitud
euclidean,cosineydotProduct. - replicación monomaster
- Una topología de replicación en la que solo una instancia de base de datos acepta escrituras. La replicación monomaster garantiza la coherencia y es la topología de replicación que utiliza MongoDB. Consultar Set de réplicas primario.
- rápido
- Snappy es una biblioteca de compresión/descompresión que equilibra los requisitos de computación eficientes con tasas de compresión razonables. Es la biblioteca de compresión predeterminada para WiredTiger en MongoDB. Consulte la documentación de Snappy y la documentación de compresión de WiredTiger para obtener más información.
- snapshot
Una instantánea es una copia de los datos de una instancia
mongoden un momento específico. Puede recuperar los metadatos de la instantánea para todo el clúster o conjunto de réplicas, o para un único servidor de configuración en un clúster.- softIRQ
- La métrica de utilización de CPU refleja la porción de CPU que una instancia en la nube utiliza actualmente para procesar solicitudes de interrupción de software. En algunos proveedores de servicios en la nube, esta métrica es útil para realizar un seguimiento de la utilización de CPU en instancias con capacidad de ráfaga.
- clave de clasificación
- El valor con el que se compara al ordenar los campos. Para aprender cómo MongoDB determina la clave de ordenación para los campos no numéricos, consulta Orden de comparación/ordenación.
- división
- La división entre fragmentos en un clúster fragmentado. Consulte Particionamiento de datos con fragmentos.
- SQL
- El languaje del query estructurado (SQL) se utiliza para la interacción con bases de datos relacionales.
- SSD
- Disco de estado sólido. Almacenamiento de alto rendimiento que utiliza electrónica de estado sólido para la persistencia en lugar de platos giratorios y cabezales móviles de lectura/guardado utilizados por discos duros mecánicos.
- lectura desactualizada
- Una lectura obsoleta se refiere a cuando una transacción lee datos antiguos (obsoletos) que han sido modificados por otra transacción pero que aún no se han confirmado en la base de datos.
- autónomo
Una instancia de
mongodque se ejecuta como un servidor único y no como parte de un conjunto de réplicas. Para convertir una instancia independiente en un conjunto de réplicas, consulte Convertir una instancia independiente autogestionada de mongod en un conjunto de réplicas.Nota
Una instancia autónoma no es un set de réplicas con solo un nodo.
- colección de reserva
Una colección temporal creada en la partición receptora para cada partición donante durante las operaciones de resharding.
Las colecciones de reserva retienen documentos que no pueden insertarse de inmediato debido a conflictos de operación. Por ejemplo, si la clave de fragmentación de un documento se ha actualizado, ahora pertenece a una partición diferente, y el orden de las operaciones aplicadas a este documento puede ser ambiguo. El destinatario almacena estos documentos en una colección de reserva hasta que pueda aplicar las operaciones en el orden correcto.
- retiro
El miembro principal del conjunto de réplicas deja de ser principal y se convierte en un miembro secundario.
Si un set de réplicas pierde contacto con el primario, los secundarios eligen un nuevo primario. Cuando el antiguo primario aprende de la elección, se retira y se reincorpora al set de réplicas como secundario.
Si el usuario ejecuta el comando
replSetStepDown, el primario se desactiva, obligando al set de réplicas a elegir un nuevo primario.
- motor de almacenamiento
- La parte de una base de datos que es responsable de gestionar cómo se almacenan y se accede a los datos, tanto en memoria como en disco. Los distintos motores de almacenamiento ofrecen un mejor rendimiento para cargas de trabajo específicas. Consulta Motores de almacenamiento para implementaciones autogestionadas para obtener detalles específicos sobre los motores de almacenamiento incorporados en MongoDB.
- orden de almacenamiento
- Ver el orden natural.
- coherencia estricta
- Una propiedad de un sistema distribuido que exige que todos los nodos incorporen los cambios más recientes al sistema. En un sistema de base de datos, esto significa que cualquier sistema que pueda proporcionar datos debe contener los últimos guardados.
- Nombre alternativo del sujeto
- El Nombre Alternativo del Sujeto (SAN) es una extensión del certificado X.509 que permite un arreglo de valores, como direcciones IP y nombres de dominio, que especifican los recursos que un único certificado de seguridad puede proteger.
- sincronizar
- La operación de conjunto de réplicas consiste en que los miembros replican los datos del nodo principal. La sincronización se produce por primera vez cuando MongoDB crea o restaura un miembro, lo que se denomina sincronización inicial. Posteriormente, la sincronización se produce de forma continua para mantener el miembro actualizado con los cambios en los datos del conjunto de réplicas. Consulte Sincronización de datos del conjunto de réplicas.
- syslog
- En sistemas tipo UNIX, un proceso de registro que otorga un estándar uniforme para que los servidores y procesos envíen información de registro. MongoDB ofrece una opción para enviar la salida al sistema syslog del host. Consulta
syslogFacility. - tag
Una etiqueta aplicada a un miembro del set de réplicas y utilizada por los clientes para realizar operaciones con conocimiento del centro de datos. Para obtener más información sobre el uso de etiquetas con sets de réplicas, consultar Listas de conjuntos de etiquetas de preferencia de lectura.
Nota
Las zonas de clúster fragmentadas reemplazan las etiquetas.
- tag set
- Un documento que contiene cero o más etiquetas.
- cursor con seguimiento
- En una colección con límite de acceso, un cursor rastreable es un cursor que permanece abierto después de que el cliente agota los resultados del cursor inicial. A medida que los clientes insertan nuevos documentos en la colección con límite de acceso, el cursor rastreable continúa recuperando documentos.
- equipo
- Grupo de usuarios de Atlas en la misma organización. Puedes usar equipos para otorgar acceso al mismo grupo de usuarios de Atlas en varios proyectos. Todos los usuarios del equipo comparten el mismo acceso al proyecto.
- término
- Para los miembros de un set de réplicas, un número que aumenta de manera monótona y que corresponde a un intento de elección.
- colección de series de tiempo
- Una colección que almacena eficientemente secuencias de mediciones a lo largo de un período de tiempo. Consultar Serie de tiempo.
- topología
El estado de una implementación de instancias de MongoDB. Incluye:
Tipo de implementación (autónomo, set de réplicas o clúster).
Disponibilidad de servidores.
Función de cada servidor (principal,secundario, servidor de configuración o
mongos).
- transacción
- Grupo de operaciones de lectura o escritura. Para obtener más detalles, consultar Transacciones.
- coordinador de transacciones
- Un componente de MongoDB que gestiona las transacciones en un conjunto de réplicas o un clúster fragmentado. Coordina la ejecución y finalización de transacciones de múltiples documentos entre nodos y permite que una operación compleja se trate como una operación atómica.
- TSV
- Formato de datos basado en texto con valores separados por tabulaciones. Este formato se usa comúnmente para intercambiar datos entre bases de datos relacionales, ya que es adecuado para datos tabulares. Puede importar archivos TSV usando
mongoimport. - TTL
- El tiempo de vida (TTL) es un tiempo de expiración o período para que una pieza de información determinada permanezca en una caché u otro almacenamiento temporal antes de que el sistema la borre o la haga caducar. MongoDB tiene una característica de colección TTL. Consultar Expirar datos de colecciones configurando TTL.
- arreglo sin límites
- Un arreglo que aumenta constantemente con el tiempo. Si el valor de un campo de un documento es un arreglo sin límites, el arreglo puede tener un impacto negativo en el rendimiento. En general, se debe diseñar el esquema para evitar arreglos ilimitados.
- índice único
- Un índice que aplica la unicidad para un campo específico en una sola colección. Consultar Índices únicos.
- unix epoch
- 1 de enero de 1970 a las 00:00:00 UTC. Comúnmente se utiliza para expresar el tiempo, y se cuenta el número de segundos o milisegundos desde este punto.
- plan del query no ordenado
- Un plan del query que devuelve resultados en un orden inconsistente con el orden de
sort(). Consultar planes del query. - actualizar
- El proceso de actualizar un clúster de una versión de MongoDB a una versión más reciente.
- inserción
Una opción para las operaciones de actualización. Por ejemplo:
db.collection.updateOne(),db.collection.findAndModify(). Si la inserción estrue, la operación de actualización:actualiza los documentos que coinciden con el query.
o si ningún documento coincide, inserta un nuevo documento. El nuevo documento tiene los valores de campo especificados en la operación de actualización.
Para obtener más información sobre upserts, consultar Insertar un documento nuevo si no se encuentra ninguna coincidencia (
Upsert).- base de datos vectorial
- Sistema que almacena incrustaciones vectoriales y metadatos asociados, y permite la búsqueda del vecino más cercano en las incrustaciones vectoriales almacenadas. Puede usar Atlas como base de datos vectorial y Atlas Vector Search para realizar búsquedas vectoriales en las incrustaciones vectoriales almacenadas. Puede usar la base de datos vectorial para implementar RAG.
- Índice vectorial
- Estructura de datos que procesa eficientemente las consultas de búsqueda del vecino más cercano. Atlas Vector Search admite la creación de índices de tipo
vectorpara indexar campos para ejecutar consultas$vectorSearch. - Búsqueda vectorial
- Método para realizar una búsqueda de k vecinos más cercanos sobre un conjunto de vectores almacenados en un índice vectorial. Atlas Vector Search admite búsquedas ANN y ENN para k vecinos más cercanos.
- memoria virtual
- La memoria de trabajo de una aplicación, que normalmente reside tanto en el disco como en la RAM física.
- hora de reloj
- El tiempo que transcurre entre el inicio y la finalización de un programa de computadora o de un cálculo.
- WGS84
- El sistema de referencia predeterminado y el datum geodésico que MongoDB utiliza para calcular la geometría sobre una esfera similar a la Tierra para consultas geoespaciales en objetos GeoJSON. Consulte la especificación "EPSG:4326: WGS 84": http://spatialreference.org/ref/epsg/4326/.
- operador de ventana
- Devuelve valores de un rango de documentos de una colección. Consultar los operadores de ventana.
- conjunto de trabajo
- Los datos que MongoDB utiliza con mayor frecuencia.
- nivel de confirmación de escritura (write concern)
- Especifica si una operación de escritura se ha realizado correctamente. La función de confirmación de escritura permite que su aplicación detecte errores de inserción o instancias
mongodno disponibles. Para conjuntos de réplicas, puede configurar la confirmación de escritura para confirmar la replicación a un número específico de miembros. Consulte la sección de Confirmación de escritura. - conflicto de escritura
- Se produce una situación en la que dos operaciones concurrentes, al menos una de las cuales es de escritura, intentan utilizar un recurso que infringe las restricciones de un motor de almacenamiento que utiliza control de concurrencia optimista. MongoDB finaliza automáticamente y vuelve a intentar una de las operaciones de escritura conflictivas.
- bloqueo de escritura
- Un bloqueo exclusivo sobre un recurso, como una colección o una base de datos. Cuando un proceso escribe en un recurso, adquiere un bloqueo de escritura exclusivo para impedir que otros procesos escriban o lean en dicho recurso. Para obtener más información sobre los bloqueos, consulte las preguntas frecuentes sobre concurrencia.
- zlib
- Una biblioteca de compresión de datos que ofrece tasas de compresión más altas a costa de un mayor consumo de CPU, en comparación con el uso de Snappy por parte de MongoDB. Puede configurar WiredTiger para que utilice zlib como su biblioteca de compresión.Consulte http://www.zlib.net y la documentación de compresión de WiredTiger para obtener más información.
- zona
- Agrupación de documentos basada en rangos de valores de clave de fragmento para una colección fragmentada determinada. Cada fragmento en el clúster fragmentado puede pertenecer a una o más zonas. En un clúster equilibrado, MongoDB dirige las lecturas y escrituras de una zona únicamente a los fragmentos que se encuentran dentro de esa zona. Consulte la página del manual de Zonas para obtener más información.
- zstd
- Una biblioteca de compresión de datos que ofrece mayores tasas de compresión y menor consumo de CPU en comparación con zlib.