Evaluar el riesgo de proveedores en tiempo real con MongoDB Atlas. Descubrir proveedores alternativos utilizando la búsqueda multimodal impulsada por Voyage AI.
caso de uso: Inteligencia Artificial, Búsqueda Inteligente
Industrias: Comercio minorista
Productos: MongoDB Atlas, Voyage AI, MongoDB Automated Embedding, MongoDB Vector Search, MongoDB Atlas Charts
Descripción general de la solución
Las cadenas de suministro globales se enfrentan a macrointerrupciones constantes. La geopolítica, los eventos meteorológicos y los cuellos de botella logísticos amenazan la continuidad operativa de la noche a la mañana.
Los sistemas heredados de planificación de recursos empresariales (ERP) no pueden adaptarse a estos rápidos cambios. Atrapan información crítica de proveedores dentro de tablas relacionales rígidas, hojas de cálculo estáticas y contratos y correos electrónicos en PDF no consultables. Cuando se produce una interrupción, los equipos de adquisiciones pasan horas o días recopilando datos manualmente en silos desconectados. Este retraso provoca desabastecimientos, costos inesperados y la pérdida de confianza del consumidor.
Desacople la gestión de proveedores de su ERP heredado núcleo mediante la creación de una capa modernizada, capa de inteligencia unificada en MongoDB Atlas.
Esta solución trata MongoDB Atlas como un almacén de datos convergente: una plataforma que funciona simultáneamente como su almacén operativo, almacén de vectores, motor de búsqueda y memoria del agente. Cada fragmento de contexto que un agente autónomo necesita para razonar sobre una interrupción en tiempo real (la ubicación de un proveedor, sus órdenes de compra abiertas, certificados y el historial de precedentes) está a una query de distancia, en la misma colección y bajo los mismos controles de acceso.
Además de la capa de datos de inteligencia, los siguientes módulos de backend convierten una señal de interrupción sin procesar en una decisión verificada y aprobada por humanos:
ingestion_engine: Capa de normalización determinista sin LLM, agente ni bucle de razonamiento. Transforma señales externas sin procesar (como datos geopolíticos, climáticos y logísticos) en un formato interno coherente y los guarda en Atlas. Proporciona el punto de partida limpio del que dependen todos los procesos posteriores.risk_evaluator: agente de LangGraph que lee esas señales con datos en tiempo real de proveedores y órdenes de compra, compara la exposición geoespacialmente, calcula un número dinámico de Risk prioridad Number (RPN), y razona sobre precedentes históricos almacenados enagent_memoryantes de escribir un resumen de riesgos en lenguaje sencillo de nuevo en Atlas.alternative_finder: Agente LangGraph que, una vez que un administrador marca a un proveedor para acción, busca en el corpus de documentación del proveedor con recuperación híbrida de vectores y texto completo, reordena los candidatos, audita cada reclamación con respecto a la evidencia citada y clasifica las opciones restantes por proximidad mientras deja la decisión final a un humano.
Al unificar los datos operativos y la capacidad de IA en MongoDB Atlas, reacciona a las condiciones externas casi en tiempo real y mantiene su negocio agile.
Arquitecturas de Referencia
Un agente razona con todo lo que llega a su ventana de contexto, no con todo lo que sabe. Cada decisión del agente depende del filtro de datos previo. La capa de datos muestra, aplica un filtro y clasifica la información en primer lugar. Trate MongoDB Atlas como esta capa de contexto. Atlas decide qué pruebas merecen tokens antes de que los agentes razonen.
Un agente que razona a través de interrupciones en tiempo real ejecuta coincidencia geoespacial, búsqueda vectorial, búsqueda de texto completo, reclasificación y búsquedas en memoria. Las idas y vueltas entre bases de datos separadas, almacenes vectoriales y motores de búsqueda ralentizan a los agentes. Ejecute todas las queries dentro de los pipeline de agregación de MongoDB Atlas. Una API reemplaza toda la pila.
El control del contexto también es control de costos. Los sistemas multiagente consumen hasta 15veces más tokens que los chats individuales. La recuperación redundante aumenta el costo. Controle el contexto del modelo para controlar su presupuesto.
Los proveedores, las señales de interrupción y las pruebas de cumplimiento cambian constantemente. Utilice el modelo orientado a documentos flexible para almacenar esta variación en una colección.
Las cadenas de suministro globales generan pruebas en muchos lenguajes. Voyage AI mapea pruebas multilingües en un espacio vectorial compartido, y Atlas Auto-Embedding mantiene estos vectores sincronizados. La recuperación multilingüe se convierte en una propiedad nativa de la base de datos en lugar de un servicio externo.
El siguiente diagrama de arquitectura y los pasos describen el flujo de trabajo de extremo a extremo y las capacidades clave de la base de datos. Rastrear señales de fuentes externas sin procesar a proveedores alternativos aprobados.
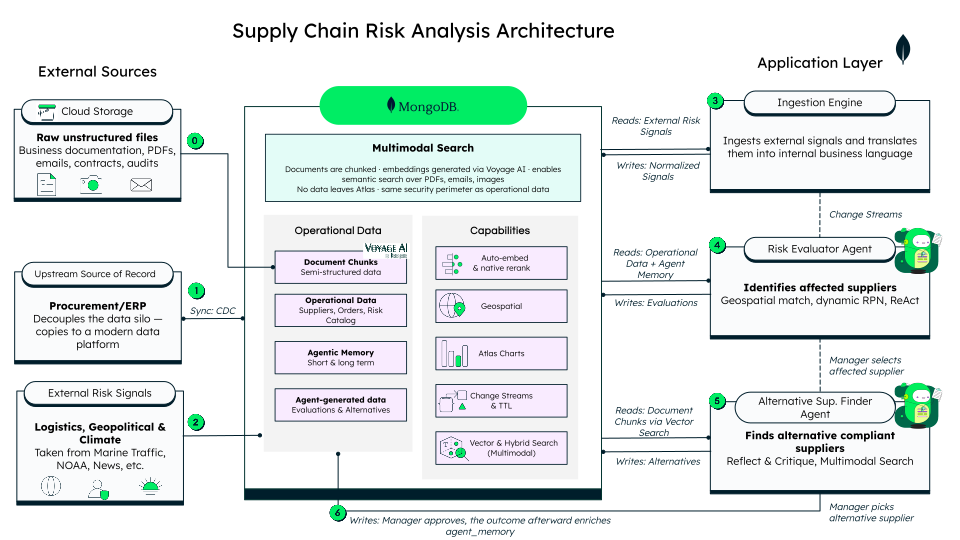
Figura 1. Visión general de alto nivel
Paso 0: Ingesta de documentos no estructurados
Almacene documentación empresarial sin procesar y no estructurada, como archivos PDF, correos electrónicos, contratos e informes de auditoría, desde el almacenamiento en la nube directamente en MongoDB Atlas. El modelo de incrustación multimodal de Voyage AI incrusta automáticamente documentos en fragmento en cualquier lenguaje para habilitar la búsqueda multimodal y multilingüe segura en la base de datos.
Paso 1: Desacoplar del ERP
Un ERP aplica reglas de negocio y gestiona flujos de trabajo transaccionales. Mantenga esas reglas en el ERP. Transmita los datos de sus proveedores y pedidos a Atlas a través de la captura de datos de cambios (CDC), y permita que los agentes lean de esa copia en lugar de consultar el ERP directamente.
El desacoplamiento permite que las nuevas capacidades evolucionen por encima del ERP según su propio calendario.
Paso 2—3: Ingesta de señales de riesgo externas
Extraiga datos logísticos, geopolíticos y climáticos del mundo real en la capa de datos operativos. Estos datos de riesgo externos proceden de fuentes como MarineTraffic, la Administración Nacional Oceánica y Atmosférica (NOAA) y fuentes de noticias globales. En esta solución, el motor de ingestión genera tres señales de activador de demostración por sesión para inicializar el flujo.
Procesar señales externas sin procesar a través del motor de ingesta. El motor traduce los eventos de interrupción externos en un lenguaje empresarial interno normalizado y guarda señales estructuradas en MongoDB Atlas.
Paso 4: Evaluación de riesgos de proveedores (Agente evaluador de riesgos)
Activador el agente evaluador de riesgos cuando las señales normalizadas lleguen a MongoDB Atlas. El agente lee datos operativos y agent_memory, realiza coincidencia geoespacial ($geoWithin), calcula RPN dinámico y guarda las evaluaciones de nuevo en la base de datos.
Paso 5: Detección de proveedores alternativos (Agente de búsqueda de proveedores alternativos)
Active el agente alternative_finder cuando un administrador/administradora selecciona un proveedor afectado. El agente consulta fragmentos de documentos mediante la búsqueda vectorial multimodal, la búsqueda híbrida ($rankFusion) y la reclasificación nativa ($rerank) para encontrar proveedores alternativos conformes y, a continuación, guarda las opciones candidatas en MongoDB Atlas.
Paso 6: Enriquecimiento de la memoria
El risk_evaluator califica cada interrupción con un número de prioridad de riesgo (RPN) dinámico. La memoria se incorpora directamente a esa puntuación antes de que el agente la finalice.
Consulta a agent_memory dos veces por evaluación: una vez para el historial propio del proveedor y una vez para el precedente entre proveedores por tipo de riesgo. El alternative_finder sigue la misma lógica en el lado de la búsqueda de proveedores. Verifica el historial de un candidato y extrae precedentes semánticos de proveedores similares antes de clasificar a los candidatos.
Atlas gestiona ambas estructuras de memoria de forma nativa. La memoria adopta dos formas: hecho estructurado ("esto exacto sucedió") y similitud semántica ("algo así sucedió"). La mayoría de las arquitecturas dividen estos en dos sistemas: una base de datos para hechos y un almacén de vectores para la similitud. En Atlas, una colección contiene ambos. Una find exacta y una query $vectorSearch afectan a los mismos documentos porque los campos estructurados y el texto incrustado coexisten.
Flujo de trabajo del Hub de suministro inteligente
El siguiente diagrama de carriles muestra cómo se mueve el control a través de las capas del sistema durante una interrupción.
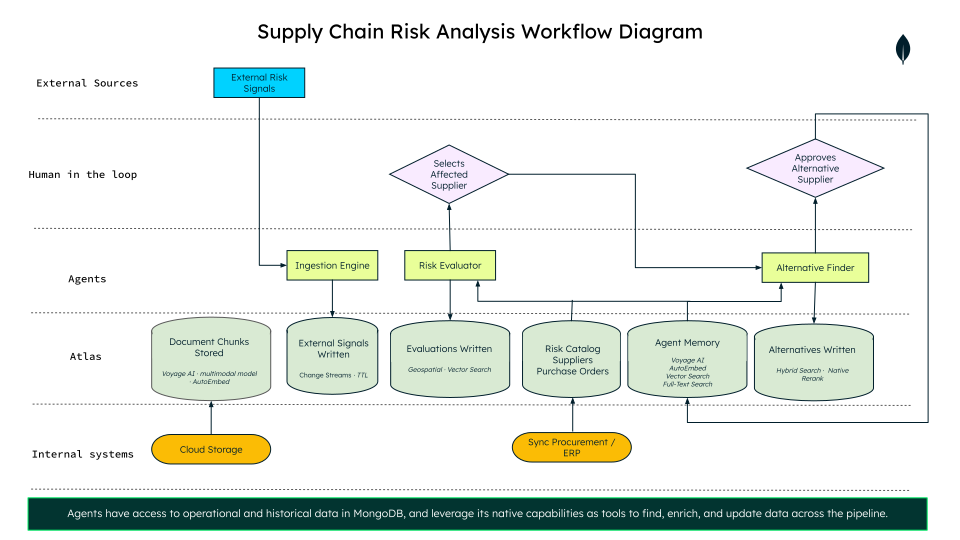
Figura 2. Flujo de trabajo de análisis de riesgo de la cadena de suministro
A medida que llegan las señales de riesgo externas, el ingestion_engine las normaliza en MongoDB Atlas, activando el agente risk_evaluator para calcular automáticamente las puntuaciones de riesgo de los proveedores. El flujo de trabajo se detiene entonces en el primer punto de decisión humana, donde un administrador de adquisiciones revisa las puntuaciones de riesgo marcadas y selecciona un proveedor afectado. Esta selección activa el agente alternative_finder para recuperar, auditar y reclasificar a los candidatos de reemplazo de MongoDB Atlas. Por último, en el segundo punto de decisión humana, el administrador revisa los documentos de cumplimiento citados y pre-identificados proporcionados para aprobar un proveedor alternativo. Esto elimina las búsquedas manuales en sistemas aislados, formatos de archivo y lenguajes extranjeros.
Inteligencia multimodal y multilingüe en la base de datos
La gestión global de la cadena de suministro requiere la búsqueda de documentación empresarial no estructurada y multiformato, como contratos en PDF, acuerdos comerciales, certificados de cumplimiento e informes de auditoría, escritos en múltiple lenguaje.
MongoDB Atlas gestiona esta complejidad almacenando incrustaciones vectoriales multimodales de Voyage AI directamente junto con los datos operativos para revelar perspectivas críticas de cumplimiento que de otro modo permanecerían en silos de documentos no rastreables:
Atlas Auto-embedding
Fragmentar e incrustar registros y contratos de cumplimiento de proveedores no estructurados, como contratos PDF, informes de auditoría escaneados y acuerdos comerciales, y almacenarlos en MongoDB Atlas.
Cree un índice de búsqueda vectorial con el tipo autoEmbed para habilitar la incrustación automatizada en los fragmentos de documentos. Esto garantiza que las incrustaciones vectoriales se generen automáticamente al insertar o actualizar datos utilizando el modelo Voyage AI configurado.
db.suppliers.createSearchIndex( "suppliers_autoembed_index", "vectorSearch", { fields: [ { type: "autoEmbed", modality: "text", path: "auto_embed_text", model: "voyage-4" }, { type: "filter", path: "region" }, { type: "filter", path: "product_categories" }, { type: "filter", path: "status" } ] } );
La incrustación automatizada elimina los servicios de incrustación externos y los pipeline de ETL complejos, al tiempo que mantiene los datos de forma segura dentro del perímetro de seguridad de MongoDB Atlas.
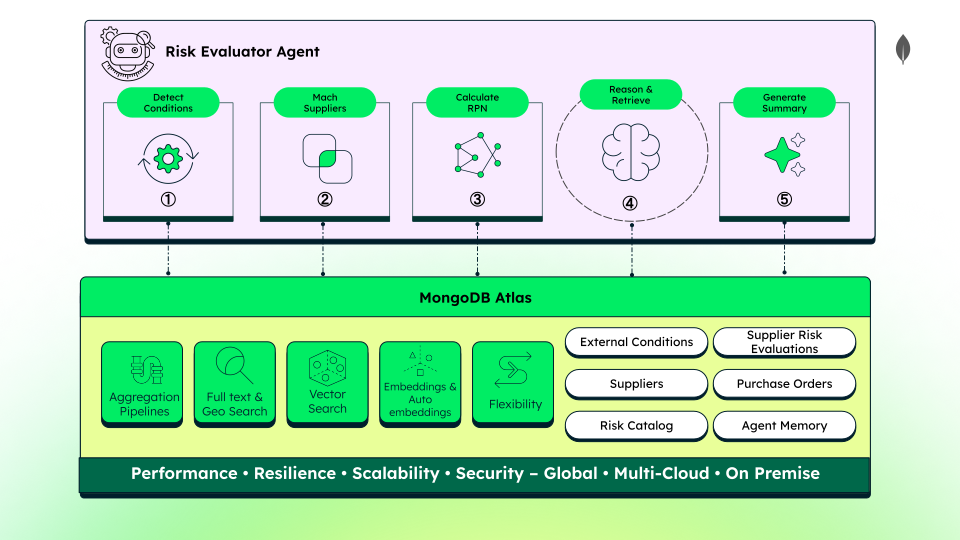
Figura 3. Agente evaluador de riesgos
Aproveche el pipeline de agregación, las capacidades de búsqueda y el modelo orientado a documentos flexible para ejecutar queries avanzadas en estos fragmentos y realizar la validación del cumplimiento en los datos ingeridos.
Búsqueda y recuperación de incrustaciones multimodales
Con los fragmentos de documentos almacenados en MongoDB Atlas, consulte datos no estructurados mediante búsqueda híbrida. Construya una consulta de búsqueda dinámica para encontrar emparejamientos de reemplazo durante una interrupción. Combine prefiltros regionales con un string del query semántico detallado. Por ejemplo, busque un "fabricante de materiales de embalaje en una zona comercial con aranceles neutrales con certificaciones de calidad activas y compromisos de entrega urgentes."
Ejecute esta búsqueda en un único pipeline de agregación de MongoDB Atlas. Utilice $rankFusion búsqueda híbrida para fusionar la similitud vectorial con la relevancia de la búsqueda de texto completo. Esta query híbrida coincide con conceptos semánticos y palabras clave exactas simultáneamente.
Encadene una etapa de reordenación nativa ($rerank) después de la fusión utilizando un modelo de reordenación de Voyage AI para mejorar la precisión de la recuperación. El cross-encoder integrado en la base de datos evalúa fragmentos candidatos conjuntamente con su query para calcular puntuaciones de relevancia precisas. Ejecutar la reclasificación en el pipeline mantiene los registros confidenciales de los proveedores de forma segura dentro del perímetro de la base de datos.
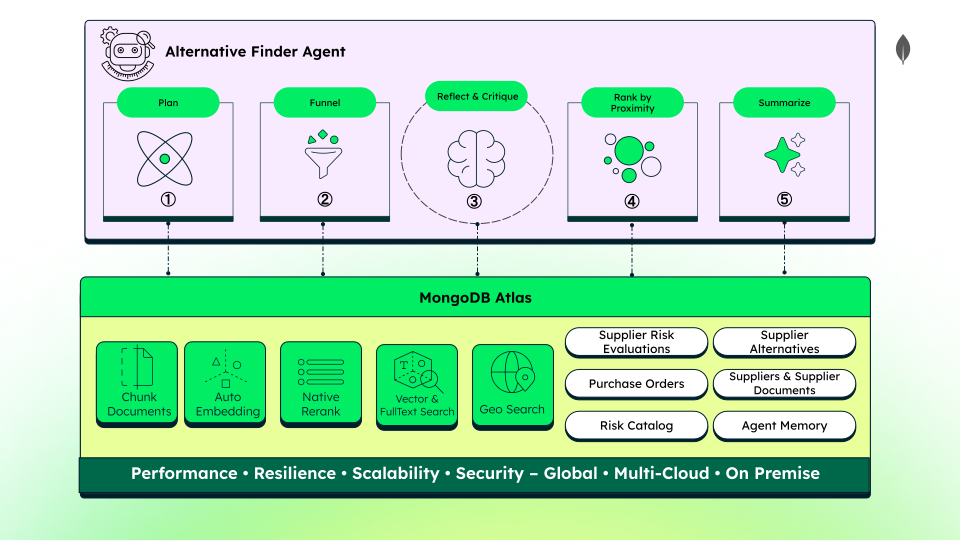
Figura 4. Agente proveedor de buscador alternativo
Inteligencia multilingüe
Busque y analice la documentación global de proveedores en cualquier lenguaje sin crear pipeline de traducción personalizados. El modelo multilingüe de Voyage AI asigna texto de diferentes lenguajes a un espacio vectorial compartido.
Query la base de datos en inglés para recuperar contratos o certificados relevantes escritos en árabe, español, chino o vietnamita. almacenar estas incrustaciones multilingües de forma nativa en MongoDB Atlas para ejecutar búsquedas semánticas multilingües con una latencia cercana a cero.
Consolide la documentación de sus proveedores globales en un único índice de búsqueda multilingüe para simplificar sus flujos de trabajo de cumplimiento internacional y remover los gastos en general de traducción.
Enfoque de modelo de datos
Las bases de datos rígidas fuerzan formatos de datos incompatibles en tablas planas. Las entidades de la cadena de suministro del mundo real cambian constantemente y tienen estructuras complejas y en evolución. Un esquema flexible y nativo de documentos permite que el modelo de datos evolucione al ritmo del negocio. Almacene registros operativos, incrustaciones vectoriales y coordenadas de forma nativa bajo una única API. Evite el tiempo de inactividad de desarrollo de las migraciones de bases de datos rígidas.
Esta solución utiliza ocho colecciones para gestionar el riesgo y el abastecimiento alternativo.
Nombre de colección | Propósito |
|---|---|
| Captura señales de riesgo externas en tiempo real con vencimiento TTL. |
| Codifica puntuaciones y umbrales de riesgo estáticos del Análisis de modos de fallo y sus efectos (AMFE). |
| Almacena registros maestros de proveedores con ubicaciones GeoJSON. |
| Rastrear pedidos activos para cuantificar la exposición financiera. |
| Contiene contratos de proveedores y certificados fragmentados e incrustados automáticamente. |
| Almacena episodios de riesgo históricos para el aprendizaje contextual. |
| Alberga puntuaciones RPN dinámicas y resúmenes de riesgos en lenguaje natural. |
| Almacena preselecciones de candidatos clasificados pendientes de aprobación humana. |
Para obtener una descripción completa del modelo orientado a documentos, consulte el README del backend de la solución. Analice las colecciones external_conditions y supplier_documents para explorar los beneficios del modelo orientado a documentos.
condiciones_externas
La colección external_conditions sirve como punto de entrada para las alertas de riesgo del mundo real, almacenando interrupciones normalizadas. Diferentes tipos de riesgo coexisten en la misma colección sin aplicar un esquema rígido.
Los siguientes son los campos que los documentos comparten en todas las alertas de riesgo.
{ "condition_id": "COND-20260505-0941", "risk_type_triggered": "logistics_disruption", "condition_score": 0.76, "has_physical_location": true, "detected_at": "2026-05-05T09:41:00Z", "valid_until": "2026-05-08T09:41:00Z" }
Las alertas climáticas y logísticas almacenan coordenadas precisas para una ubicación física y un radio de impacto. Las coordenadas deben ser un objeto de punto GeoJSON para ejecutar consultas geoespaciales en los datos. Utilice $geoWithin para encontrar proveedores ubicados completamente dentro de un área afectada especificada.
{ // other shared fields "epicentre": { "type": "Point", "coordinates": [114.1095, 22.5229] }, "impact_radius_km": 80, "has_physical_location": true, }
Las alertas geopolíticas rastrean las fronteras regionales con un arreglo de regiones afectadas. Para query proveedores en las regiones afectadas, utilice el operador $in.
{ // other shared fields "affected_regions": ["CN", "HK"], "has_physical_location": false, }
El ingestion_engine normaliza las diversas cargas útiles de API entrantes en la estructura de documentos limpia que se muestra en los ejemplos de código anteriores.
El polimorfismo le permite query ambos tipos de señal simultáneamente. Ejecute query de coincidencia geográfica unificada utilizando $geoWithin y $in en una sola llamada a la base de datos. Esta consolidación simplifica la lógica de su aplicación y evita divisiones de query que drenan el rendimiento.
supplier_documents
La colección supplier_documents alberga documentación comercial no estructurada que se puede buscar. La siguiente muestra de documento ilustra este diseño de colección:
{ "supplier_id": "SUP-882", "doc_type": "quality_certification", "filename": "certificado_SUP882_2024.pdf", "chunk_index": 2, "chunk_total": 4, "chunk_text": "ISO 9001:2015 and IATF 16949:2016. Valid 2024-11-01 to 2027-10-31...", "page_ref": 1, "valid_until": "2027-10-31T00:00:00Z", "embedding": [/* 1024 dimensions */] }
chunk_text: Almacena un segmento de texto de 400 a 600 tokens de archivos PDF sin procesar. Este fragmento de alta fidelidad divide los contratos grandes en segmentos superpuestos para preservar las cláusulas críticas. Mantiene el contenido de documentos no estructurados almacenado de forma nativa junto con los registros de su base de datos operativa.embedding: Almacena el vector de 1024dimensiones generado por Voyage AI. El modelo multilingüe asigna múltiples lenguajes a un único espacio vectorial compartido. Esta alineación le permite query documentos en español o alemán mediante cadenas de búsqueda en inglés.valid_until: Rastrea las fechas de vencimiento de las certificaciones de cumplimiento para que caduquen automáticamente los registros de proveedores obsoletos.
Compilar la solución
Implementar la solución de riesgo de la cadena de suministro con agentes.
Requisitos previos
Asegúrese de tener las siguientes cuentas, claves y software antes de empezar:
Cuenta de MongoDB Atlas: Un clúster de Atlas (nivel M10 o superior).
Clave de API de Anthropic: Una clave de API activa para impulsar el razonamiento y la planificación de LLM.
Docker Desktop: La aplicación necesaria para ejecutar los servicios de frontend y backend.
Configurar ajustes de Atlas
Active las siguientes capacidades de Atlas antes de implementar código:
Inicie sesión en su cuenta de MongoDB Atlas.
Habilite la etapa de agregación $rerank en la configuración de su proyecto.
Agregue la clave de Voyage Model API de su proyecto a la configuración de su proyecto de Atlas.
Configurar y rellenar la base de datos
Configure su base de datos, importe los archivos de inicialización y compile los índices necesarios para ejecutar la demostración.
Inicie sesión en MongoDB Atlas y cree una base de datos llamada retail-supply-chain-risk en su clúster de Atlas.
Importe los cinco archivos JSON de inicialización de la carpeta Docs/configurar/colecciones:
Seleccione su nueva base de datos en la pantalla Collections.
Haz clic en el icono más (+) o haz clic en Create Collection para añadir cada una de las cinco colecciones.
Seleccione cada colección, haga clic en Import Data y cargue el archivo JSON correspondiente.
Cree los índices de búsqueda necesarios para ejecutar búsqueda vectorial, búsqueda híbrida y consultas geoespaciales. Las configuraciones de índice se encuentran en la carpeta Docs/configurar/índice. Ejecute los siguientes pasos para crear cada índice.
mongosh "<your-connection-string>" --file suppliers-location-2dsphere.js mongosh "<your-connection-string>" --file external_conditions-epicentre-2dsphere.js mongosh "<your-connection-string>" --file suppliers_autoembed_index.js mongosh "<your-connection-string>" --file agent_memory_autoembed_index.js mongosh "<your-connection-string>" --file supplier_documents_vector_index.js mongosh "<your-connection-string>" --file supplier_documents_fulltext_index.js
Clonar el repositorio y configurar las variables de entorno
Clona el repositorio del proyecto de Github.
git clone https://github.com/mongodb-industry-solutions/retail-supply-chain-management.git
Configure las variables de entorno del frontend y del backend:
Copie el archivo de muestra frontend/ejemplo.env en un nuevo archivo
.enven el mismo directorio. Reemplace los valores de los marcadores de posición con los detalles de su configuración. EstablezcaBACKEND_URLenhttp://127.0.0.1:8000.Copie el archivo de muestra backend/.env.ejemplo a un nuevo archivo
.enven el mismo directorio. Reemplace los valores de los marcadores de posición con los detalles de su configuración. Añada su clave de API de Anthropic comoLLM_API_KEY.
Compile y lance la aplicación
Compila y lanza tu entorno multiservicio usando Docker Compose o ejecutando el backend y el frontend por separado.
Para iniciar la aplicación usando Docker Compose, ejecute:
make build
Para ejecutar los servicios manualmente, primero inicie el frontend:
cd frontend npm i npm run dev
A continuación, vaya al directorio raíz e inicie el backend:
make uv_init make uv_sync source backend/.venv/bin/activate cd backend uvicorn main:app --reload
Abra el tablero de frontend en su navegador en http://localhost:3000. Consulte la documentación interactiva de la API en http://localhost:8000/docs.
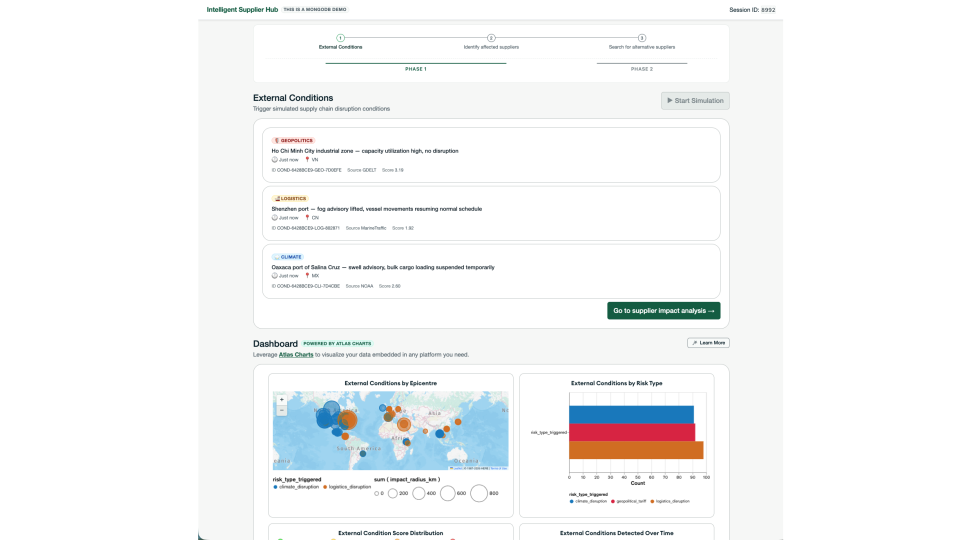
Figura 5. Sistema Inteligente de Centro de Proveedores
Lea la guía del usuario para navegar por la demostración.
Lecciones clave
Esta solución demuestra varios patrones arquitectónicos críticos para crear aplicaciones de cadena de suministro impulsadas por IA:
Cree una capa de inteligencia unificada para controlar el costo: desacople la gestión de proveedores de los sistemas heredados rígidos mediante la creación de una capa de inteligencia unificada en MongoDB Atlas. Consolide los datos operativos, las incrustaciones vectoriales y la memoria del agente en una plataforma sincronizando los datos del ERP mediante CDC. Esta estructura permite a los agentes leer el estado actual sin consultar el ERP directamente. Lea el mismo documento para comprobaciones operativas y recuperación, luego reduzca los datos de forma determinista utilizando filtros geoespaciales, búsqueda híbrida y reclasificación antes de que un LLM lo reciba. Controlar lo que llega al modelo optimiza el rendimiento del razonamiento y reduce los costos de ejecución.
Unificar datos no estructurados en varios lenguajes: Almacenar documentos no estructurados, como contratos PDF, correos electrónicos e informes de auditoría escaneados, junto con registros de proveedores estructurados. Utilice Voyage AI para incrustar estos diversos formatos en una única colección de MongoDB. Este diseño unificado permite queries semánticas en texto e imágenes, lo que simplifica su arquitectura de recuperación sin mantener sistemas de base de datos separados. Además, los modelos de incrustación multimodal permiten queries multilingües sin gastos en general de traducción.
Mantenga la búsqueda y la reclasificación dentro de Atlas: Consolide la búsqueda vectorial, la búsqueda de texto completo y la reclasificación nativa en una sola query de base de datos. Utilice
$rankFusionpara ejecutar búsquedas híbridas y encadene$reranknativo con Voyage AI directamente dentro de su pipeline de agregación. Esto elimina saltos de red extra, latencia de API y la gestión de credenciales personalizadas.
Autores
Florencia Arin, MongoDB
Angie Guemes, MongoDB
Ronan Conlon, MongoDB
Daniel Jamir, MongoDB