MongoDB Atlas ist ein moderner, in Echtzeit arbeitender, hybrider Multi-Cloud-Datenbankdienst, der die Bereitstellung und Verwaltung Ihrer Datenbank vereinfacht und Ihnen alles bietet, was Sie benötigen, um ausfallsichere globale Anwendungen bei den Cloud-Anbietern Ihrer Wahl zu entwickeln. Wir bieten zwei verschiedene Bereitstellungsoptionen: Atlas Core für vorhersehbare Workloads und Atlas Infinite für unvorhersehbare, unregelmäßige Workloads.
Beide Bereitstellungsoptionen nutzen dieselbe Oberfläche, dieselben Treiber und APIs, und Ihre vorhandenen Abfragen sowie Ihr Verbindungscode funktionieren mit beiden gleichermaßen. Der Unterschied besteht darin, wie beide Rechenleistung und Speicher bewältigen. Atlas Core platziert sie auf demselben Node, während Atlas Infinite sie in unabhängige Schichten trennt. Die Wahl zwischen beiden ist eine Frage der Workload-Eignung und gibt Entwicklern die Flexibilität, die passende Bereitstellungsoption für ihre spezifischen Anwendungsanforderungen zu nutzen.
Wichtige Erkenntnisse
- Atlas Core unterstützt den gesamten Funktionsumfang von Atlas und läuft auf Amazon Web Services (AWS), Microsoft Azure und Google Cloud in den Stufen „Free“, „Flex“ und „Dedicated“.
- Atlas Infinite ist jetzt als Public Preview verfügbar und ermöglicht es Ihnen, Rechenleistung und Speicher getrennt zu skalieren. So kann der Speicher wachsen, ohne dass Sie zu einer größeren Cluster-Ebene wechseln müssen.
- Atlas Infinite verkürzt die Skalierungszeit im Vergleich zu Atlas Core um mehr als 96 %, sodass Sie Rechenleistung und Speicherplatz unabhängig voneinander innerhalb von Minuten statt Stunden skalieren können.
- Atlas Infinite unterstützt Replica Sets, die zehnmal mehr Daten als Atlas Core enthalten, und lässt sich so vom Prototyp bis zum Petabyte auf derselben Basis erweitern – mit bis zu 189 % mehr Durchsatz pro Dollar.
- Beide Bereitstellungsoptionen nutzen dieselbe Schnittstelle, dieselben Treiber und dieselben APIs, und Atlas übernimmt auch bei beiden die Bereitstellung, die Installation von Patches, die Datensicherung, die Überwachung und die Skalierung.
Inhaltsverzeichnis
- Worin liegt der Unterschied zwischen Atlas Core und Atlas Infinite?
- Was ist die Atlas Core-Bereitstellungsoption?
- Was ist die Atlas Infinite-Bereitstellungsoption?
- Wie funktioniert die Skalierung bei den einzelnen Bereitstellungsoptionen?
- Wann sollten Sie Atlas Core verwenden?
- Wann sollten Sie Atlas Infinite verwenden?
- FAQ
Worin liegt der Unterschied zwischen Atlas Core und Atlas Infinite?
Obwohl die Ähnlichkeiten zahlreich sind, gibt es einen großen Unterschied: die Art und Weise, wie die beiden Rechenleistung und Speicher bereitstellen
- Die Bereitstellungsoption Atlas Core koppelt Rechenleistung und Speicher auf denselben Knoten. Dedizierte Cluster können den Speicher unabhängig voneinander innerhalb der Grenzen ihres aktuellen Tiers skalieren; das Überschreiten dieser Grenzen erfordert die Skalierung auf ein höheres Tier.
- Die Bereitstellungsoption Atlas Infinite führt Rechenleistung und Speicher als unabhängige Schichten aus, sodass Sie Speicher hinzufügen können, ohne die Cluster-Ebene zu ändern.
Welche Bereitstellungsoption für Sie geeignet ist, hängt davon ab, wie viele eingehende Daten Sie speichern und wie schwer es ist, Ihr Abfragevolumen vorherzusagen. Keine der beiden Optionen ersetzt die andere – sie sind komplementäre Architekturen, die für unterschiedliche Workload-Profile optimiert sind.
Das folgende Diagramm vergleicht die beiden.
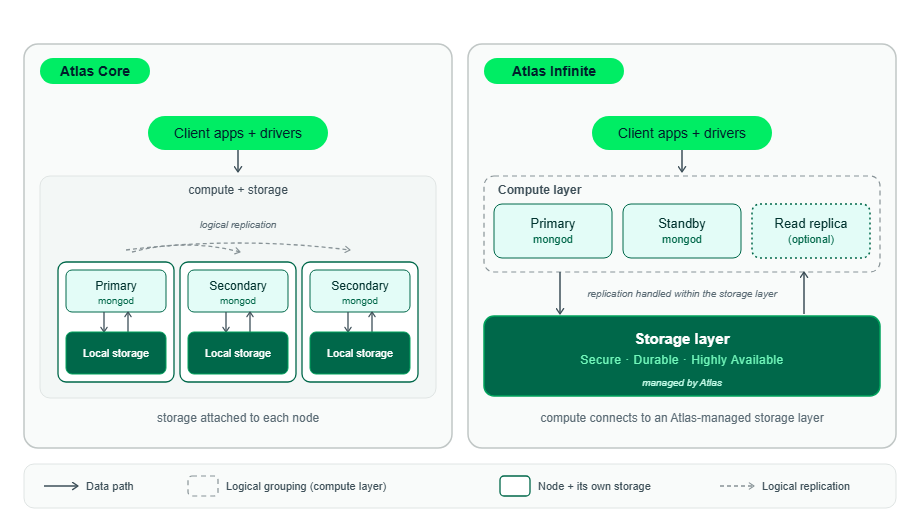
Atlas Core koppelt Rechenleistung und Speicher auf jedem Node, während Atlas Infinite Rechenleistung und Speicher als separate Schichten ausführt.
Die untenstehende Tabelle bietet einen direkten Funktionsvergleich.
Betrachten wir zwei Teams mit sehr unterschiedlichen Workload-Profilen. Das eine betreibt einen Flottenverfolgungsdienst. Seine Datenmenge wächst kontinuierlich, da Fahrzeuge Standort-, Status- und Betriebsdaten generieren, während die Abfrageanfragen im Laufe des Tages starken Schwankungen unterliegen. Spitzen können während der Hauptverkehrszeiten, bei Zwischenfällen, bei Einsatzverteilungen oder bei plötzlichen Kundenaktivitäten auftreten. Wenn Rechenleistung und Speicher gemeinsam skaliert werden, muss das Team möglicherweise von beidem ausreichend bereitstellen, um Spitzenauslastungen zu bewältigen – was dazu führt, dass Ressourcen in ruhigeren Zeiten nicht voll ausgelastet sind. Atlas Infinite eignet sich hierfür hervorragend, da der Speicher mit dem Datensatz wachsen kann, während die Rechenleistung bei Spitzenauslastungen erhöht und bei sinkendem Bedarf wieder reduziert wird.
Das andere Team betreibt einen stabilen, vorhersehbaren Zahlungsdienst über mehrere Regionen hinweg. Seine Verkehrsmuster und Kapazitätsanforderungen sind gut bekannt, und er ist auf Funktionen angewiesen, die Atlas Infinite noch nicht unterstützt. Atlas Core ist die bessere Wahl, da seine Ressourcen vollständig bereitgestellt sind und es die für diesen Workload erforderliche regionenübergreifende Bereitstellung unterstützt.
Was ist die Atlas Core-Bereitstellungsoption?
Atlas Core ist eine Atlas-Cluster-Architektur, bei der die Knoten sowohl Rechenleistung als auch Speicher ausführen. Jeder datentragende Knoten speichert eine Kopie Ihrer Daten auf einer virtuellen Maschine mit eigenem Speicherplatz.
Atlas Core steht für jeden Atlas-Bereitstellungstyp zur Verfügung: Free-Cluster, Flex-Cluster und Dedicated-Cluster auf AWS, Azure und Google Cloud. Es unterstützt den gesamten Atlas-Funktionsumfang, einschließlich regionenübergreifender und Multi-Cloud-Cluster.
Atlas Core deckt ab, was das Zahlungsteam benötigt. Ihre Auslastung ist konstant, daher wird die von ihnen gewählte Stufe auch später noch für sie funktionieren. Sie benötigen außerdem einen Cluster, der über mehr als eine Region laufen kann, und Atlas Core bietet Multi-Region.
Was ist die Atlas Infinite-Bereitstellungsoption?
Atlas Infinite ist eine Atlas-Cluster-Architektur, die Rechnungsleistung und Speicher in unabhängige Schichten unterteilt. MongoDB verwaltet die Speicherschicht, und die Rechenknoten, auf denen Ihre Abfragen ausgeführt werden, stellen eine Verbindung dazu her. Es ist für geschäftskritische, leistungsintensive Workloads ausgelegt.
Atlas Infinite ist als Public Preview verfügbar, sodass Sie es jetzt nutzen können, aber das Produkt und seine Dokumentation können sich während des Vorschauzeitraums ändern. Einige Atlas-Funktionen werden noch nicht unterstützt.
Preview begrenzt auch, wo und in welcher Größe Sie es ausführen können. Atlas Infinite läuft auf AWS, in unterstützten Regionen, auf Replica Sets von M10 bis M60 mit jeweils 128 TB Speicherkapazität.
Die Daten des Flottenverfolgungsteams sammeln sich unabhängig vom Abfrageaufkommen an, sodass auf Atlas Infinite Speicherplatz hinzugefügt werden kann, ohne die Cluster-Stufe zu ändern. Wenn das Team bereits AWS nutzt, müsste es prüfen, ob die jeweilige Region unterstützt wird und ob die Vorschau die benötigten Funktionen abdeckt.
Hier finden Sie weitere wichtige Statistiken:
- Skalierungsverzögerung: Atlas Infinite verkürzt die Skalierungszeit im Vergleich zu Atlas Core um mehr als 96 %. Rechenleistung und Speicher lassen sich innerhalb von Minuten – und nicht erst nach Stunden – automatisch und unabhängig voneinander skalieren.
- Speicherobergrenze: Mit der zehnfachen Kapazität wächst Atlas Infinite auf derselben Grundlage mit Ihnen mit – vom Prototyp bis zum Petabyte. Sie skalieren zu Ihren Bedingungen: dann, wenn Sie mehr Leistung benötigen – und nicht erst, wenn der Speicherplatz knapp wird. Atlas Infinite unterstützt Replica Sets, die zehnmal mehr Daten als Replica Sets in Atlas Core speichern können.
- Kapazitätsplanung: Atlas Infinite erfüllt Ihre Anforderungen in Echtzeit, wenn Sie nach oben und unten skalieren. Atlas Infinite läuft im Vergleich zu Atlas Core außerdem effizienter auf derselben Hardware, sodass Sie nahezu die doppelte Leistung pro Dollar erhalten.
- Neuarchitektur: Es sind keine Anwendungsänderungen erforderlich. Nutzen Sie mehr Elastizität und Skalierbarkeit auf buchstäblich derselben Datenbank.
Atlas Infinite ist eine leistungsfähigere und effizientere Engine. Interne Tests mit MongoDB 9.0 haben gezeigt, dass Atlas Infinite einen um 189 % höheren Durchsatz pro Dollar bietet als Atlas Core.
Wie funktioniert die Skalierung bei den einzelnen Bereitstellungsoptionen?
Bei Atlas Core begrenzt die Stufe, auf der Sie sich befinden, sowohl die Rechenleistung als auch den Speicher. Bei Atlas Infinite wächst der Speicher, ohne dass die Stufe geändert werden muss.
Architektur: Auf Atlas Core befinden sich Rechenleistung und Speicher auf denselben Knoten. Auf Atlas Infinite verwaltet MongoDB die Speicherschicht, und die Rechenknoten stellen eine Verbindung zu ihr her.
Skalierung der Rechenleistung: Bei beiden Optionen ändert sich die Rechenleistung, wenn sich der Cluster ändert: Sie wählen eine andere Cluster-Stufe. Bei Atlas Core startet Atlas Ihre Knoten neu, und dedizierte Cluster bleiben dabei verfügbar. Bei Atlas Infinite werden Ihre Daten nicht verschoben, sodass die Änderung schneller erfolgt. Atlas Infinite verkürzt die Skalierungszeit im Vergleich zu Atlas Core um mehr als 96 % – Skalierung in Minuten, nicht in Stunden.
Speicherskalierung: Auf Atlas Core können Sie den Speicher in Dedicated-Clustern unabhängig von der Rechenleistung skalieren, jedoch nur bis zum Maximalwert der jeweiligen Speicherstufe. Darüber hinaus müssen Sie auf eine höhere Stufe wechseln. Auf Atlas Infinite wird der Speicher unabhängig von der Stufe und ohne Ausfallzeiten erweitert. Atlas Infinite unterstützt Replica Sets, die das Zehnfache der Datenmenge von Replica Sets in Atlas Core enthalten, und lässt sich auf derselben Grundlage vom Prototyp bis zu einem Petabyte skalieren.
Horizontale Skalierung: Durch Sharding werden Ihre Daten auf mehrere Server aufgeteilt, sodass kein einzelner Server alle Daten enthält. Bei Atlas Core führen Sie ein Sharding durch, wenn sich Ihre Daten der Speicherkapazität des Tiers nähern. Bei Atlas Infinite fasst ein einzelner Shard bis zu 128 TB, sodass Sie kein Sharding durchführen müssen, nur um Speicherplatz hinzuzufügen. Sharded-Cluster sind während der Preview auf Atlas Infinite nicht verfügbar.
Dem Flottenverfolgungsteam geht der Speicher aus, bevor ihm die Rechenleistung ausgeht. Ihre Daten häufen sich kontinuierlich an, sodass sie auf Atlas Core das Speichermaximum für ihre Stufe erreichen und auf eine größere Stufe wechseln müssten, um weiterzumachen. Bei Atlas Infinite würden sie Speicher hinzufügen und auf derselben Stufe bleiben.
Wann sollten Sie Atlas Core verwenden?
Verwenden Sie Atlas Core, wenn:
- Sie den gesamten Atlas-Funktionsumfang nutzen möchten
- Sie benötigen Multi-Region- oder Multi-Cloud-Cluster.
- Sie benötigen Sharded-Cluster.
Atlas Core deckt zudem alles ab, was in der Vorschau von Atlas Infinite nicht enthalten ist. Wenn Sie unter Azure oder Google Cloud bereitstellen oder einen Free- oder Flex-Cluster benötigen, ist Atlas Core die Option, die dies unterstützt.
Das Zahlungsteam nutzt Atlas Core. Ihre Auslastung ist konstant, daher würde die Trennung von Rechenleistung und Speicher für sie nicht viel ändern, und sie sind auf Funktionen angewiesen, die die Vorschau noch nicht enthält.
Wann sollten Sie Atlas Infinite verwenden?
Ziehen Sie Atlas Infinite in Betracht, wenn:
- Sie Rechenressourcen und Speicher unabhängig voneinander skalieren möchten, ohne dass es dabei zu Verzögerungen kommt (Minuten statt Stunden).
- Ihr Workload weist Spitzen auf, die nur schwer im Voraus geplant werden können.
- Sie die Speicherkapazität um das bis zu Zehnfache erhöhen möchten, ohne die Cluster-Stufe zu skalieren oder die Architektur Ihrer Anwendung anzupassen.
- Sie wünschen sich fast doppelt so viel Leistung und 189 % mehr Durchsatz pro Dollar.
- Sie wünschen sich schnellere Failover und Recovery.
Atlas Infinite passt zum Flottenverfolgungsteam. Die Daten häufen sich kontinuierlich an, das Abfragevolumen schwankt im Laufe des Tages, und auf Atlas Core müssten sie auf eine größere Stufe wechseln, jedes Mal, wenn ihr Speicherbedarf steigt.
Ähnliche Ressourcen
MongoDB-Clustertypen – Vergleichen Sie Dedicated-Cluster-Stufen ab M10 und erfahren Sie, wie die automatische Skalierung die Kapazität innerhalb der von Ihnen festgelegten Grenzen anpasst.
Was ist das Modell der geteilten Verantwortung? – Erfahren Sie, wie Sicherheits-, Compliance- und Wartungsaufgaben zwischen Ihnen und MongoDB Atlas aufgeteilt werden.
Funktionsweise des MongoDB-Sharding – Erfahren Sie, wie durch horizontale Skalierung Daten über mehrere Instanzen hinweg verteilt werden, wenn Ihr Speicher- und Durchsatzbedarf die Kapazität eines einzelnen Replica Sets überschreitet.
MongoDB University – Nutzen Sie kostenlose Kurse, die Sie in Ihrem eigenen Tempo absolvieren können, sowie offizielle Lernpfade zu den Themen Datenbankadministration, Cluster-Management und Anwendungsentwicklung.
MongoDB-Grundlagen und Tutorials für Entwickler – Entdecken Sie grundlegende Anleitungen zur Einrichtung der Datenbank, zum Entwurf des Dokumentmodells und zu grundlegenden CRUD-Operationen.