保险行业的承保、理赔和服务决策通常依赖于分散在许多不同系统中的上下文,包括保单管理系统、理赔平台、远程信息处理和第三方风险数据等。每次手动汇总这些上下文既缓慢、不一致,又难以进行 Atlas 审核。
此架构描述了 MongoDB Atlas 上的上下文层,这是一个实时操作数据层级,可将业务对象上下文汇集到一个单一的实时对象中,供代理和应用程序进行读取、写入和操作。
上下文层位于现有记录系统与 AI 驱动的承保、理赔和服务工作流程之间,因此保险公司无需更换这些系统即可供代理使用。它结合了灵活的 document model、AI 原生检索、实时变更传播和字段级治理,以满足受监管的代理增强型决策循环所需的低延迟和可审计性要求。
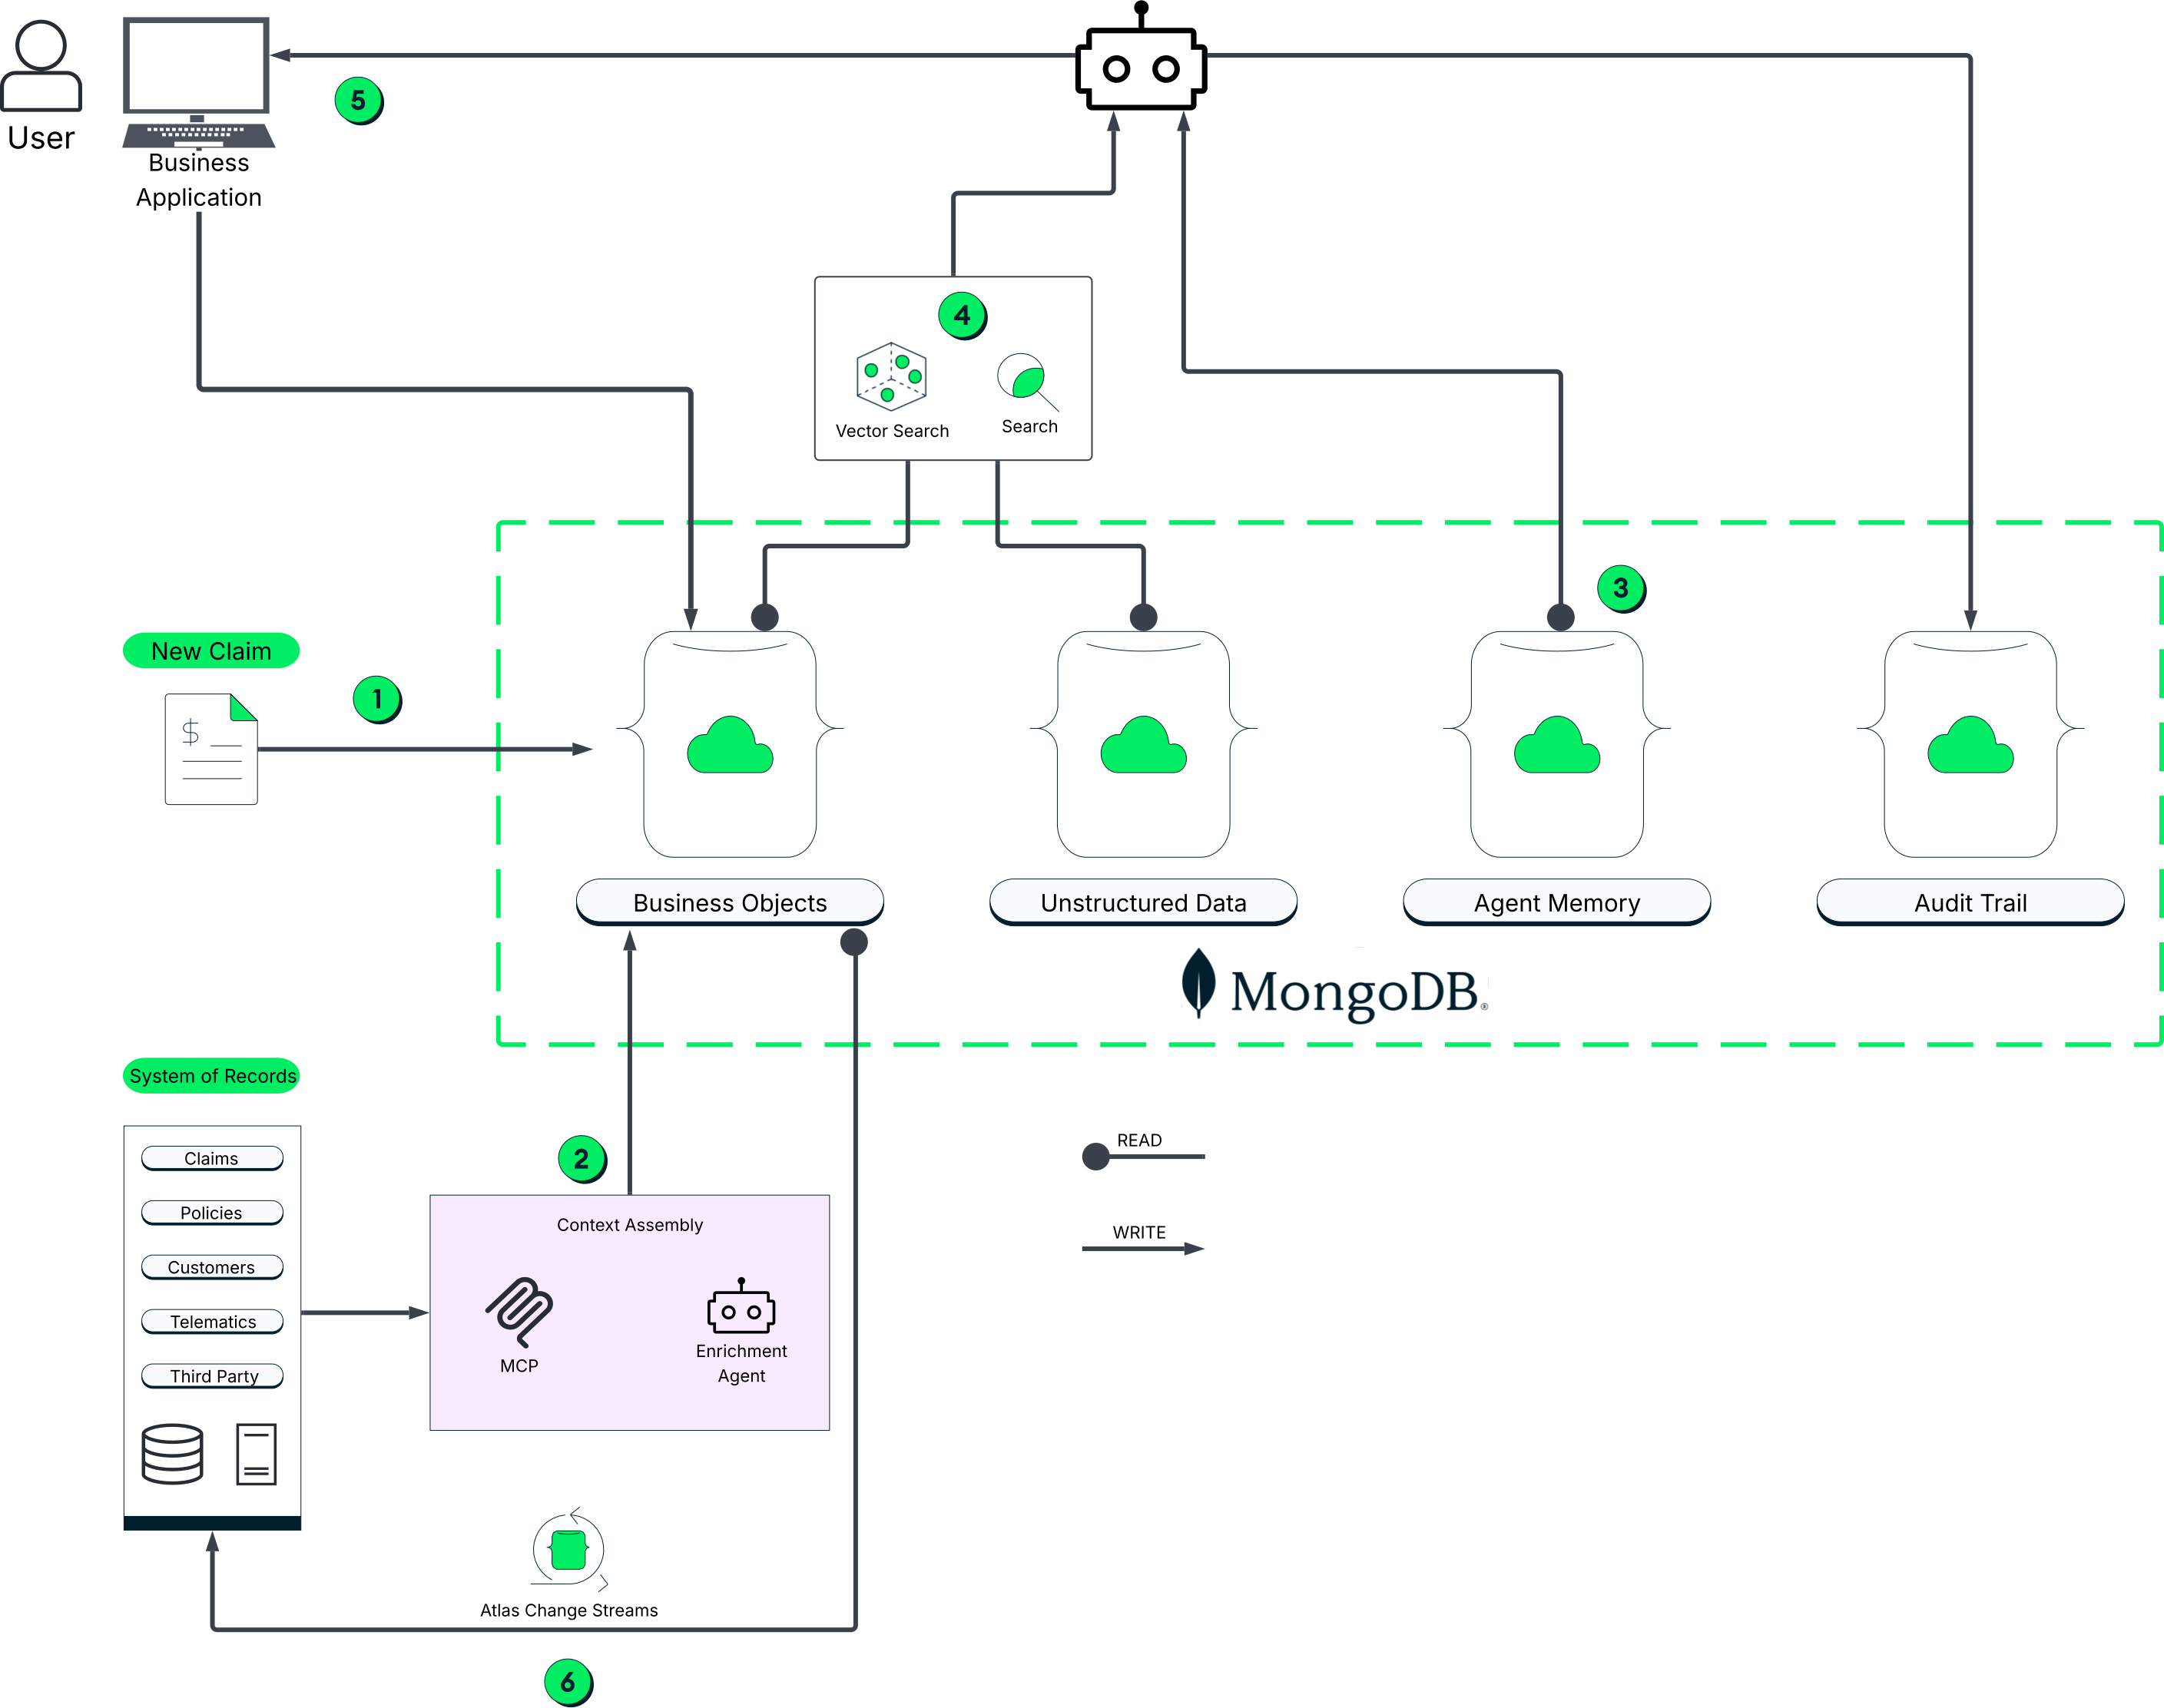
图 1。上下文层架构 和 AI 代理数据流
数据流
以下步骤追踪单个提交或索赔在上下文层中的移动过程,从接收到写回、可审计的决策。
提交或索赔受理
新的提交或索赔到达,摄入服务会捕获核心标识符和初始结构化字段。识别出这些信息后,摄取服务会将其作为单个文档写入 MongoDB Atlas 中的
business_objects集合中。上下文增强与组装
一个专门的充实代理会收集承保人或理赔员所需的其余背景信息,例如覆盖限制、背书、损失说明、理算员备注等。代理从记录系统中汇集数据,以创建单一的实时记录。现在,单个 MongoDB 文档即可容纳承保人或理赔代理收集知识、做出决策和采取操作所需的一切。
代理记忆和状态检索
在进行上下文丰富的同时,该服务还会检索此提交或索赔的先前记忆,因为代理记忆保存了此特定案例的对话历史、决策跟踪、Atlas 审核历史和情绪。这使承保或索赔代理能够恢复工作,并完全记住之前的轮次、建议和人工覆盖。
针对结构化和非结构化内容的 AI 原生检索
该服务针对业务对象和关联的非结构化工件(例如理算员备注、损失叙述或图像元数据)发出混合
$vectorSearch和$search查询。为此,可以使用领域调优的嵌入和重排序,这样代理就能优先看到最相关的历史记录和先例,而不是原始的匹配列表。代理决策、人在循环中和写入
代理查看汇总的上下文,并采取操作,例如发出报价或请求更多信息。在许多情况下,这一操作需要由人工查看,始终将最终修订保持在人工控制之下。最后,该决策及其完整的推理追踪,由代理作为不可变的Atlas 审核记录写回 MongoDB 中自己的决策追踪集合,以确保对代理操作的完全合规、可追溯性和透明度。
实时传播与 Change Streams
MongoDB Change Streams 将更新广播给每个正在监视提交或声明的代理、仪表盘和下游系统。此外,人类用户可以在任何点引入新的信号,以便直接trigger代理,例如在声明上触发欺诈指标,立即启动声明代理,而无需批处理周期。
组件
记录系统
记录系统 (SoR),也称为单一记录系统 (SSoR),是提供服务,作为关键数据元素或数据对象的权威数据源的单一计算机系统。SoR 保存数据的“真实状态”,这意味着它是该特定数据源可用的最新、最准确且合规的版本。
在这种架构中,记录系统仍然是业务事务的来源。它们继续履行其原有职责,而上下文层则在它们之间组装可用的决策上下文。
业务对象和代理内存
业务对象包含操作实体(无论是提交、索赔还是客户记录),作为一个单一的、持续丰富的文档。这确保了每个消费者都能从同一个最新视图中工作,而不必从分散的来源收集信息。MongoDB 将代理内存与此记录一起存储,以便代理在多步决策中保留上下文和 Atlas 审核历史记录。
原生 AI 检索
MongoDB 向量搜索结合全文搜索和重新排序,让代理能够在单个查询中从结构化字段和非结构化工件中检索最相关的损失历史记录、先例或指南,而无需跨单独的向量存储进行协调。
实时传播
MongoDB Change Streams 和原生 Stream Processing 可确保每个代理和下游系统与提交或索赔的当前省/市/自治区保持同步,并允许新信号或事件直接 trigger 代理,而无需等待轮询或批处理周期。
Atlas 审核跟踪
上下文层为每次读取和写入保留不可变的 Atlas 审核跟踪,以便所有 AI 辅助决策始终保持透明和可追溯。一个集合收集了关于每个决策的完整信息,从做出决策的用户/代理的身份,到得出结论的步骤、上下文、AI 元数据、决策结果等等。
限制
这种模式会导入复杂性,应当有意采用。
操作层并不总是最适合分析目的:这种架构不适合仅用于分析的工作负载、存档存储库或不需要实时上下文组装、写入或可审计性的使用案例。如果主要需求是报告或面向批处理的分析,那么分析平台可能就足够了,无需添加操作上下文层。
模式灵活性需要其自身的规范:这种方法也需要在数据建模、身份解析、治理和生命周期管理方面遵循规范。上下文层可以累积大型复杂对象和不断变化的模式,因此,团队必须尽早定义对象边界、预期和更新模式。
上游系统的复杂性不会被消除:它减少了决策时间的碎片化,但仍然依赖于可靠的上游数据访问和数据质量。糟糕的源质量或薄弱的事件设计会出现在上下文层中,而不是消失。
当针对具有预定义数据模型的特定使用案例进行定制,并从经过验证的参考工作流程进行扩展时,该架构的效果最佳。
了解详情
探索其他参考架构: