O Atlas Infinite separa a computação do armazenamento em duas camadas independentes. Os nós de computação executam suas queries, transações e agregações. A camada de armazenamento armazena seus dados de forma durável, mantendo várias cópias para alta disponibilidade. O MongoDB gerencia a camada de armazenamento independentemente da camada de computação, portanto, as operações de dimensionamento e recuperação são executadas sem mover ou replicar dados.
O diagrama a seguir mostra como o Atlas Infinite se encaixa no Atlas, nas camadas de aplicativo, computação e armazenamento, com as interfaces de gerenciamento do Atlas abaixo.
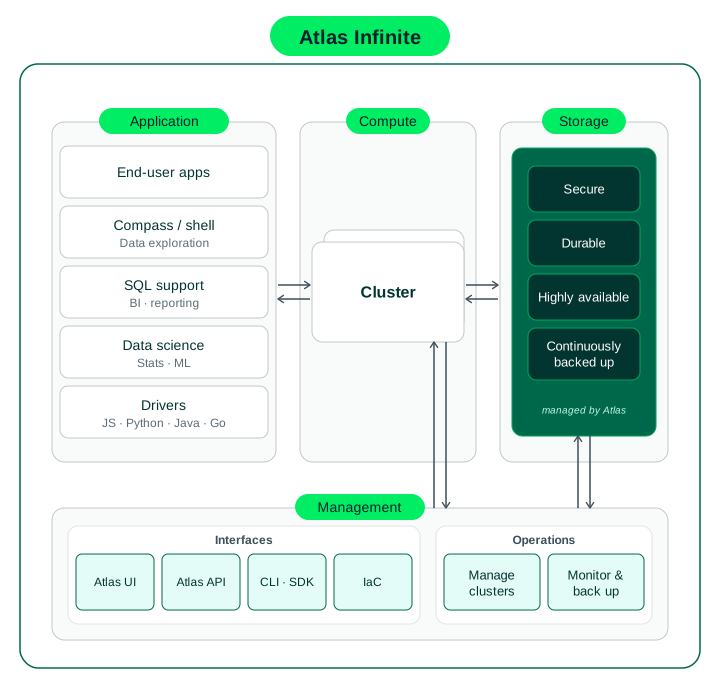
Como a computação e o armazenamento do Atlas Infinite se encaixam na pilha de aplicativos e gerenciamento do Atlas
Camada de computação
Os nós de computação são a camada que executa suas query, transação e agregação. Como os nós de computação são desacoplados do armazenamento, você pode dimensionar a capacidade de computação independentemente do armazenamento. Você pode adicionar capacidade de computação conforme a demanda aumenta e dimensionar quando a demanda descartar. Se você habilitar o dimensionamento automático, o Atlas ajustará a computação para você.
Em visualização pública, o Atlas implanta seus nós de computação em zonas de disponibilidade separadas dentro da região do seu cluster.
Camada de armazenamento
A camada de armazenamento no Atlas Infinite mantém os dados do seu aplicativo duráveis, mantendo várias cópias para alta disponibilidade. Com o Atlas Infinite, o MongoDB gerencia o armazenamento como uma camada independente, separada dos nós de computação que executam a carga de trabalho do seu aplicativo. A camada de armazenamento lida com a replicação, serve leituras e fornece backups contínuos, independentemente da camada de computação. Ao dimensionar a camada do cluster, ou quando um nó de computação falha e o Atlas Infinite realiza um failover, os dados do seu aplicativo permanecem disponíveis na camada de armazenamento para atender às queries. O MongoDB não o copia para os novos nós de computação.
Segurança
O Atlas Infinite isola cada cluster em camadas de armazenamento. O Atlas autentica mutuamente o tráfego interno com certificados X.509 para comunicação dentro da camada de armazenamento.
Como a camada de armazenamento é compartilhada, os dados de cada cliente são criptografados com chaves exclusivas que nunca são compartilhadas entre os clientes. A camada de armazenamento gerencia essas chaves separadamente dos nós de computação, para que cada nó de computação possa descriptografar os dados que recebe. Para aprender como o Atlas criptografa os dados do Atlas Infinite, consulte Visão geral da criptografia em descanso do Atlas.
Replicação e failover
Um cluster Atlas Infinite tem dois nós de computação elegíveis: um primary, que atende às gravações, e um standby, que é o outro nó elegível e assume quando o primary falha ou é reiniciado. Durante a visualização pública, é possível adicionar até cinco nós somente leitura e analíticos para isolamento do volume de trabalho. Seu cluster tem até sete nós de computação no total. Você pode adicionar os seguintes tipos de nó:
Nó somente leitura servem leituras da sua carga de trabalho operacional.
Nó de análise isolam query analíticas da sua carga de trabalho operacional.
Os nós de pesquisa executam cargas de trabalho do MongoDB Search e do MongoDB Vector Search . Os nós de pesquisa são separados dos nós de computação do cluster e não são contabilizados no limite de cinco nós.
Os nós de computação não votam para um primário. A camada de armazenamento coordena o failover em vez de uma eleição entre os nós do cluster. Quando o primário falha ou reinicia, o standby torna-se o primário. A camada de armazenamento mantém seus dados recentes prontamente disponíveis para cada nó de computação. Se um failover interromper uma construção de índice, a construção será retomada automaticamente.
A preferência de leitura funciona como em um cluster do Atlas Core. Você pode usar todos os modos de preferência de leitura e tags de conjunto de réplicas predefinidas.
O driver do seu aplicativo define a preferência de leitura. O padrão do driver é primary, portanto, seu aplicativo envia cada leitura para o primário, a menos que você altere a preferência de leitura.
Um cluster Atlas Infinite tem um nó de espera. Quando seu aplicativo lê de um nó que não seja o primário, essas leituras vão para esse nó de espera, a menos que você adicione nós somente leitura ou nós de análise e defina uma preferência de leitura diferente. Use as seguintes recomendações:
Para servir às leituras operacionais do seu aplicativo a partir de mais de um nó, adicione nós somente leitura. Os nós somente leitura servem a leituras em qualquer preferência de leitura, exceto
primary, portanto, cada nó que você adiciona serve a parte desse tráfego. Para distribuir essas leituras entre o standby e os nós somente leitura, defina uma preferência de leitura desecondaryPreferred. Isso mantém as leituras do seu aplicativo fora do primário e evita a sobrecarga do único nó de standby. Em um cluster Atlas Core, vários secundários espalham essas leituras sem nós adicionados.Para isolar uma carga de trabalho, como análise, das leituras operacionais do seu aplicativo, adicione nós de análise ou nó somente leitura e use tags de conjunto de réplicas predefinidas para direcionar as query para esses nós.
Para dar a cada nó mais capacidade para servir leituras, dimensione a camada do cluster.
O backup, o restaurar e a recuperação pontual operam na camada de armazenamento. Para aprender sobre backup e restauração, consulte Restaurar um cluster do Atlas Infinite.
Write concern em cluster Atlas Infinite
Um write concern descreve o nível de confirmação que você solicita ao MongoDB para uma operação de gravação.
Esta seção descreve os padrões de write concern em um cluster Atlas Infinite, como o Atlas lida com cada campo de write concern e como o write concern difere de um cluster Atlas Core.
Em um cluster Atlas Infinite, a camada de armazenamento armazenar e replica seus dados, e o Atlas confirma seu gravar assim que a camada de armazenamento a captura.
Em um cluster Atlas Infinite, o write concern padrão é w: "majority". Seu aplicativo define o write concern na string de conexão ou para uma única operação de gravar. Você não pode alterar o padrão na IU do Atlas.
Atlas aceita qualquer write concern que seu aplicativo envia e o modifica, quando necessário, para um valor que um cluster Atlas Infinite suporta, para que os write concern do seu aplicativo continuem funcionando.
Em um cluster Atlas Infinite, o Atlas lidar com os campos de write concern da seguinte forma:
Seu aplicativo define o nível de reconhecimento de gravar com
w:Se o seu aplicativo não definir
w, o Atlas aplica o padrão,w: "majority". Em um cluster Atlas Infinite,"majority"refere-se a uma maioria dentro da camada de armazenamento, não a uma maioria dos nós do seu cluster. O Atlas nunca reverte uma gravarw: "majority".Se o seu aplicativo definir
wcomo0ou1, o Atlas aplicará o valor definido pelo seu aplicativo.w: 0solicitações sem reconhecimento. Um gravarw: 1retorna mais cedo do que um gravarw: "majority", mas o Atlas pode reverter isso em falhas raras.Se o seu aplicativo definir
wcomo2ou qualquer número maior que2, o Atlas aplicaráw: "majority".
Seu aplicativo pode definir um limite de tempo com
wtimeout(wtimeoutMSem uma string de conexão), em milissegundos.wtimeoutaplicar aw: "majority"gravar, incluindo gravar que usam o padrão:Se o seu aplicativo definir
wtimeout, uma gravar que o Atlas não puder confirmar retornará um erro de write concern quando atingir o limite dewtimeout.Se o seu aplicativo não definir
wtimeout, gravar aguarda indefinidamente e bloqueia o seu aplicativo.
O Atlas sempre aplica
j: true. A camada de armazenamento persiste cada gravar fora da memória do nó antes que o Atlas a reconheça. A configuraçãojdo seu aplicativo não tem efeito sobre esse comportamento.
O write concern difere entre os cluster do Atlas Infinite e os cluster do Atlas Core das seguintes maneiras:
Em um cluster Atlas Infinite, você define
wcomo0,1ou"majority". Paraw: 1ew: "majority", a camada de armazenamento fornece garantias para você gravar. Paraw: 0, a camada de armazenamento não reconhece sua gravar. Em um cluster Atlas Core, você também pode definirwcomo um número, o que faz uma solicitação de confirmação desse número de nós.Em um cluster Atlas Infinite, o Atlas sempre aplica
j: truee você não pode desativar a confirmação do diário. Em um cluster Atlas Core, você pode desativar a confirmação do diário comj: false.
Oplog em clusters Atlas Infinite
Em um cluster Atlas Infinite, a coleção oplog, local.oplog.rs, não serve para replicação, já que a replicação é tratada na camada de armazenamento. A coleção serve change streams e algumas funções internas que exigem um histórico limitado. A coleção conta para os dados armazenados do seu cluster.
A replicação não usa a coleção oplog. Em um cluster Atlas Infinite, a replicação ocorre na camada de armazenamento, e o Atlas também armazena a coleção oplog,
local.oplog.rs, lá. Cada nó lê da camada de armazenamento, portanto, um nó que entra ou retorna ao cluster não pode ficar para trás da oplog window. Para aprender mais, consulte Replicação e failover.A coleção oplog serve a change streams e funções internas.
local.oplog.rsserve change streams e algumas funções internas que exigem um histórico limitado. A janela de retenção determina até que ponto no passado um fluxo de alterações interrompido pode ser retomado, mas não rege até que ponto no passado você pode restaurar o cluster em si. Para isso, use restauração point-in-time.Por quanto tempo o Atlas mantém as entradas. O Atlas mantém cada entrada de oplog por pelo menos a janela de retenção mínima de oplog. Assim que uma entrada é mais antiga que a janela, o Atlas a exclui. A janela de retenção mínima de oplog padrão é de 24 horas no Atlas Infinite e no Atlas Core. Você pode definir a janela de retenção mínima de oplog em Additional Settings para determinar quanto histórico o cluster mantém.
Como a coleção oplog afeta o tamanho e o custo dos dados. A coleção oplog registra cada gravar no cluster. A coleção oplog conta para os dados armazenados em seu cluster e para seus custos de armazenamento, da mesma forma que em um cluster Atlas Core. O histórico que o Atlas mantém para o Continuous Cloud Backup faz parte dos custos de backup. Esse histórico não conta para o armazenamento do cluster. Para aprender mais, consulte Custos do MongoDB Atlas Infinite Cluster.
Experiência Operacional
Seu aplicativo é executado no Atlas Infinite sem alterações de código. O Atlas Infinite usa o wire protocol do MongoDB, portanto, seu aplicativo se conecta ao seu cluster Atlas Infinite usando drivers do MongoDB e outros métodos de conexão. Você também pode acessar e gerenciar o cluster com FERRAMENTAS programáticas do MongoDB.