Capture o inventário da estante a partir de uma imagem, armazene-o no MongoDB e sincronize as atualizações entre clientes de varejo conectados e offline.
Casos de uso: Edge e Mobile, Inteligência artificial
Setores: Edge e Mobile, Varejo
Produtos: MongoDB Enterprise Advanced
Parceiros: PowerSync
Visão Geral da Solução
Os retalhistas precisam de visibilidade precisa do inventário da giba. Em grandes instalações, as equipes geralmente trabalham em áreas com conectividade inconsistente e dependem de verificações manuais para identificar produtos que precisam ser repostos.
Saiba como converter uma única imagem de estante em um registro de inventário estruturado. Um modelo de linguagem de visão identifica e conta os produtos, enquanto o Enterprise Advanced armazena as imagens capturadas, as contagens de itens e o contexto do aplicação .
O MongoDB fornece a base para distribuir o estado do inventário em sua rede. Os change streams fornecem atualizações em tempo real para o PowerSync, que sincroniza campos selecionados com bancos de dados SQLite locais em dispositivos cliente . Quando a conectividade cai, os dispositivos do cliente continuam trabalhando offline com dados locais e sincronizam após a reconexão.
Esse fluxo de trabalho centralizado no MongoDB integra perfeitamente captura baseada em imagens, modelagem flexível de documento e aplicativos de varejo sincronizados. Ele transforma observações de estantes em dados de inventário que as equipes podem usar nos aplicativos do cliente .
Arquiteturas de referência
O Enterprise Advanced serve como camada de dados operacionais e fonte da verdade para o inventário de estante.
O navegador envia uma imagem da estante para o aplicação de backend. O backend passa a imagem para o modelo de linguagem de visão configurado, valida a resposta estruturada e escreve o documento de inventário resultante no MongoDB.
Cada documento armazena o contexto de captura juntamente com os itens detectados. O MongoDB armazena metadados como tempo de captura, dispositivo, operador, armazenamento, modelo, contagens de itens, valores de confiança e status do ciclo de vida.
Quando você ativa a persistência de mídia, o backend armazena a imagem bruta no armazenamento de objeto compatível com o Amazon S3 e mantém a referência do ativo no MongoDB. Esse design separa grandes objetos de mídia dos registros de inventário operacionais, preservando seus relacionamentos.
Os change streams do MongoDB publicam eventos que o PowerSync usa para sincronizar campos de inventário selecionados com bancos de dados SQLite do lado do cliente . O PowerSync oferece suporte ao acesso local a aplicação e sincronização entre interrupções de conectividade, enquanto o MongoDB continua sendo a fonte da verdade.
Essa arquitetura separa as responsabilidades enquanto mantém uma base de dados unificada:
O MongoDB gerencia o registro de inventário operacional.
O backend controla as operações de gravação.
O VLM (modelo de linguagem de visão) extrai dados estruturados.
O armazenamento de objetos retém imagens brutas.
O PowerSync distribui o estado apoiado MongoDB aos clientes.
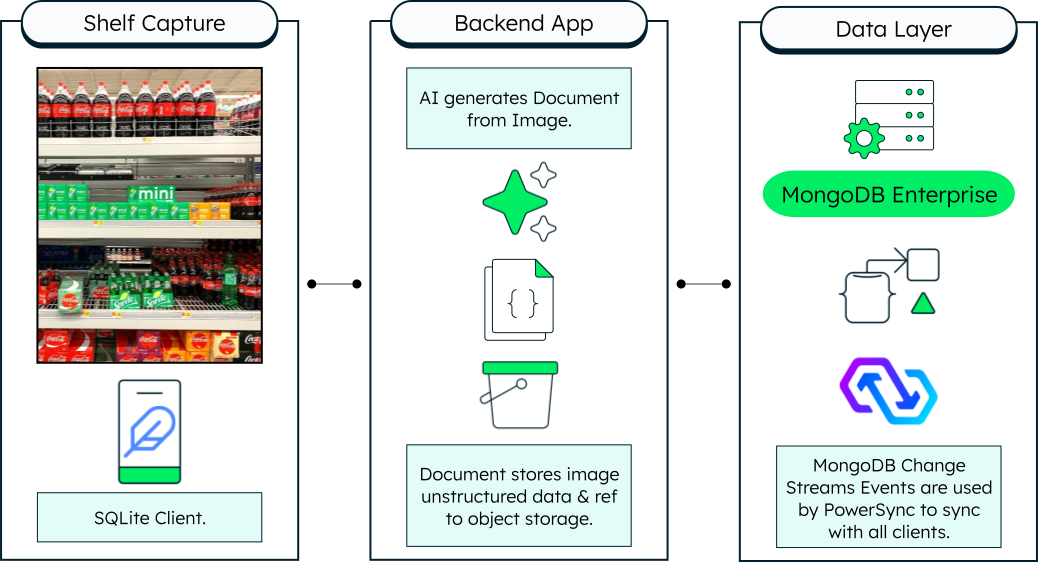
Gráfico 1. Da imagem da estante ao inventário sincronizado: o backend usa um modelo de linguagem de visão para criar um documento de inventário do MongoDB . O MongoDB armazena o registro operacional, o armazenamento de objeto retém a imagem bruta e os change streams geram a sincronização PowerSync com o SQLite no lado do cliente .
Abordagem do modelo de dados
Armazene cada captura de estante como um documento na collection inventory_captures. Mantenha o contexto da captura e o resultado do inventário gerado pelo modelo juntos para que seu aplicação processe e sincronize cada captura como uma única unidade.
O documento registra metadados, incluindo:
Capturar carimbo de data/hora e localização
Enviando dispositivo e operador
Modelo usado para análise de imagem
O status do ciclo de vida da captura
Incorpore os produtos detectados na array items. Cada item contém um nome de produto, contagem detectada e confiança do modelo:
{ "_id": "108d020b-9d3c-4b36-a651-0e1be2b1e899", "captured_at": "2026-07-02T17:45:08.661249+00:00", "device_id": "web-o0its21v", "operator_id": "demo-operator", "store_id": "store-unknown", "cv_model": "qwen2.5", "items": [ { "name": "Nissin Cup Noodles", "count": 5, "confidence": 0.9 }, { "name": "Popcorn Bag", "count": 1, "confidence": 0.9 }, { "name": "Lays Chips", "count": 3, "confidence": 0.9 } ], "status": "ACTIVE", "asset": null }
A incorporação dos itens detectados mantém o resultado do modelo próximo à captura da estante que o gerou. O modelo de documento flexível do MongoDB permite que o aplicação preserve atributos de item adicionais à medida que o modelo envolve, eliminando a necessidade de um esquema rígido para cada produto possível.
O MongoDB continua sendo a fonte da verdade para o registro de inventário. O PowerSync projeta os campos exigidos pelos aplicativos cliente em bancos de dados SQLite locais, enquanto as imagens brutas permanecem no armazenamento de objeto compatível com o Amazon S3 quando você ativa a persistência de mídia.
Explicações do campo
_id: Identificador exclusivo para a captura da estante.captured_at: Registro de data e hora UTC gerado quando o backend recebe a captura.device_id: Identificador do dispositivo cliente que enviou a imagem.operator_id: Identificador para o operador que enviou a captura.store_id: Identificador da loja associada à captura.cv_model: Nome do modelo utilizado para gerar o resultado do inventário.items: array incorporada contendo produtos detectados, contagens e valores de confiança.status: Estado do ciclo de vida da captura. Quando o armazenamento está ativado, o fluxo começa comoPENDING_UPLOADe muda paraACTIVEapós os carregamentos da imagem bruta.asset: Metadados de armazenamento de objetos opcionais. Esse campo énullquando o armazenamento de imagem bruta está desabilitado.
Construir a solução
Use o repositório Varejo-estoque-take do GitHub para implantar e explorar a solução.
Pré-requisitos
Prepare um ambiente local do Kubernetes com recursos suficientes para executar:
MongoDB Enterprise Edition gerenciado pelo MongoDB Ops Manager
PowerSync
Backend do FastAPI
aplicação web Next.js
Armazenamento de objeto compatível com o Amazon S3
Ollama e o modelo de linguagem de visão configurado
Revise o guia de configuração local no repositório para obter as versões de tempo de execução suportadas, os requisitos de memória, os requisitos do modelo e o tempo esperado de configuração.
Implemente a solução
Execute o fluxo de trabalho de configuração:
./scripts/setup.sh
Quando a implantação estiver concluída, verifique se os seguintes serviços estão disponíveis:
MongoDB Enterprise Advanced
MongoDB Ops Manager
PowerSync
aplicação web Next.js
Backend do FastAPI
Armazenamento de objeto compatível com o Amazon S3
Capturar e verificar o inventário
Abra o aplicação da web e envie uma imagem da estante. O backend envia a imagem para o modelo de linguagem de visão, valida a resposta estruturada e escreve o documento de inventário no MongoDB.
Quando você ativa a persistência de mídia, o backend armazena a imagem bruta no armazenamento de objeto compatível com o Amazon S3 e atualiza o status do documento MongoDB . Os change streams do MongoDB direcionam a sincronização do PowerSync para o aplicação cliente .
Execute o fluxo de trabalho de verificação para validar o caminho completo de captura, armazenamento e sincronização:
./scripts/verify.sh
O MongoDB serve como a camada de dados central em todo o fluxo de trabalho. Os documentos do repositório:
Componentes do sistema e scripts de configuração
Processamento de modelo de visão-idioma
Fluxo de trabalho de armazenamento de objetos
Caminho de sincronização
Principais Aprendizados
Capture inventário de estante a partir de uma imagem: use um modelo de linguagem de visão para converter uma imagem de estante em JSON estruturado que o MongoDB armazena e seu aplicação processa.
Modele os dados de inventário como documentos do MongoDB : mantenha os metadados de captura e os itens detectados juntos para que cada documento represente uma única verificação de estante.
Sincronize o estado apoiado MongoDB em todos os dispositivos cliente : use os change streams do MongoDB e o PowerSync para distribuir campos de inventário selecionados sem criar uma lógica de pesquisa personalizada.
Separe os dados operacionais da mídia bruta: armazene dados de inventário e referências de imagem no MongoDB enquanto armazena o framework bruto no armazenamento de objeto compatível com o Amazon S3 ao ativar a persistência de mídia.
Suporte a fluxos de trabalho de varejo desconectados: habilite os aplicativos do cliente a usar dados sincronizados localmente e a reconciliar seu estado ao se reconectar.
Autores
Timóteo Marques, MongoDB
Alberto Camarena Rodriguez, MongoDB
Daniel Jamir, MongoDB