ページの在庫を画像から取得し、 MongoDBに保存し、接続済みおよびオフラインのリテラル クライアント全体でアップデートを同期します。
製品: MongoDB Enterprise Advanced
パートナー: PowerSync
ソリューション概要
小売業者は、商品の在庫状況を正確に可視化する必要があります。大規模な施設では、チームは接続が一貫していない領域にまたがって作業することがよくあり、再追加が必要な製品を特定するために手動チェックに依存します。
単一のシェルテーブルのイメージを構造化された在庫レコードに変換する方法を学びます。視覚言語モデルは製品を識別してカウントし、 MongoDB Enterprise Advanced はキャプチャされたイメージ、商品数、アプリケーションコンテキストを保存します。
MongoDB は、インベントリの状態をネットワーク全体に分散するための基礎を提供します。変更ストリームは PowerSync にリアルタイム更新を提供し、選択したフィールドをクライアントデバイス上のローカル SQLite データベースに同期します。接続が切断されても、クライアントデバイスはローカル データとオフラインで動作し続け、再接続時に同期します。
このMongoDBを基盤としたワークフローは、イメージベースのキャプチャ、柔軟なドキュメントモデリング、同期された販売アプリケーションをシームレスに統合します。これにより、チームがクライアントアプリケーション全体で使用できる在庫データに変換されます。
参照アーキテクチャ
MongoDB Enterprise Advanced は、在庫の運用データレイヤーとソースとして機能します。
ブラウザは シェルイメージをバックエンドアプリケーションに送信します。バックエンドは構成された視覚言語モデルにイメージを渡し、構造化された応答を検証し、結果のインベントリドキュメントをMongoDBに書込みます。
各ドキュメントには、検出された項目とともにキャプチャ コンテキストが保存されます。 MongoDB は、キャプチャ時間、デバイス、演算子、ストア、モデル、アイテム数、コンフィギュレーション値、ライフサイクル ステータスなどのメタデータを保存します。
メディア永続性を有効にすると、バックエンドは未加工のイメージをAmazon S3 互換のオブジェクトストレージに保存し、 MongoDBにアセット参照を保持します。この設計では、大規模なメディアオブジェクトを運用インベントリ レコードから分離すると同時に、それらの関係を維持します。
MongoDB変更ストリームは、選択したインベントリ フィールドをクライアント側のSQLite データベースに同期するために PowerSync が使用するイベントを公開します。 PowerSync はローカルアプリケーションのアクセスと接続中断間での同期をサポートしますが、 MongoDB は真実のソースであり続けます。
このアーキテクチャでは、統合データ基礎を維持しながら、権限を分離します。
MongoDB は運用インベントリレコードを管理します。
バックエンドは書込み (write) 操作を制御します。
VVM(ビジョニング言語モデル)は構造化データを抽出します。
オブジェクトストレージは未加工のイメージを保持します。
PowerSync は、 MongoDBベースの状態をクライアントに分散します。
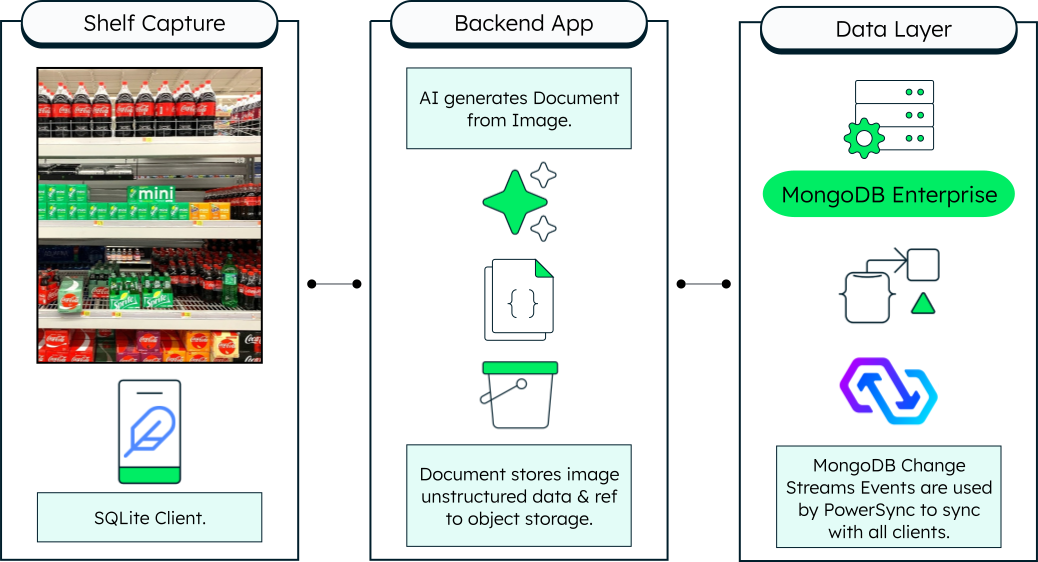
図の 1。エンドポイントのイメージから同期された在庫へ:バックエンドは視覚言語モデルを使用してMongoDB在庫ドキュメントを作成します。 MongoDB は操作レコードを保存し、オブジェクトストレージは未加工のイメージを保持し、変更ストリームはクライアント側のSQLite への PowerSync 同期を実行します。
データモデルアプローチ
各エンドポイントのキャプチャは、ドキュメントとして inventory_capturesコレクションに保存します。キャプチャコンテキストとモデル生成されたインベントリの結果をまとめて保持することで、アプリケーションは各キャプチャを単一のユニットとして処理、同期します。
ドキュメントには、次のようなメタデータが記録されます。
タイムスタンプとロケーションのキャプチャ
送信デバイスと演算子
画像分析に使用されるモデル
キャプチャのライフサイクル ステータス
検出された製品を items 配列に埋め込みます。各項目には、製品名、検出数、モデル信頼性が含まれています。
{ "_id": "108d020b-9d3c-4b36-a651-0e1be2b1e899", "captured_at": "2026-07-02T17:45:08.661249+00:00", "device_id": "web-o0its21v", "operator_id": "demo-operator", "store_id": "store-unknown", "cv_model": "qwen2.5", "items": [ { "name": "Nissin Cup Noodles", "count": 5, "confidence": 0.9 }, { "name": "Popcorn Bag", "count": 1, "confidence": 0.9 }, { "name": "Lays Chips", "count": 3, "confidence": 0.9 } ], "status": "ACTIVE", "asset": null }
検出された項目を埋め込むと、モデル出力はそれを生成した shell キャプチャに近い状態に維持されます。 MongoDBの柔軟なドキュメントモデル、モデルが変化するにつれてアプリケーションが追加のアイテム属性を保持できるようになり、すべての製品に対して固定的なスキーマが必要なくなります。
MongoDB は、 インベントリレコードの真実のソースであり、 PowerSync は、クライアントアプリケーションに必要なフィールドをローカル SQLite データベースにプロジェクションしますが、メディア永続性を有効にすると、未加工のイメージはAmazon S3 互換のオブジェクトストレージに残ります。
フィールドの説明
_id: シェルキャプチャのユニーク識別子。captured_at:バックエンドがキャプチャを受信したときに生成された UTC タイムスタンプ。device_id: イメージを送信したクライアントデバイスの識別子。operator_id: キャプチャを送信した演算子の識別子。store_id: キャプチャに関連付けられたストアの識別子。cv_model: 在庫結果を生成するために使用されるモデルの名前。items: 検出された製品、カウント、および信頼値を含む埋め込み配列。status: キャプチャのライフサイクル状態。ストレージが有効になっている場合、フローはPENDING_UPLOADとして開始され、未加工のイメージがアップロードされるとACTIVEに変わります。asset: 任意のオブジェクト ストレージメタデータ。このフィールドは、未加工イメージストレージが無効になっている場合、nullです。
ソリューションのビルド
ソリューションを配置および検討するには、リポジトリを使用します。
前提条件
以下を実行するのに十分なリソースを持つローカルKubernetes環境を準備します。
MongoDB Ops Managerによって管理されるMongoDB Enterprise Server
PowerSync
FastAPIバックエンド
Next.js ウェブアプリケーション
Amazon S3 互換オブジェクトストレージ
Ollma と構成済みの視覚言語モデル
サポートされているランタイム バージョン、メモリ要件、モデル要件、予想されるセットアップ時間については、リポジトリでローカル セットアップガイドを確認してください。
在庫の取得と検証
ウェブアプリケーションを開き、shell イメージを送信します。バックエンドはイメージを視覚言語モデルに送信し、構造化された応答を検証し、在庫ドキュメントをMongoDBに書込みます。
メディア永続性を有効にすると、バックエンドは未加工のイメージをAmazon S3 互換のオブジェクトストレージに保存し、 MongoDBドキュメントのステータスを更新します。 MongoDB変更ストリームは、クライアントアプリケーションへの PowerSync 同期を実行します。
検証ワークフローを実行して、完全な取得、ストレージ、および同期パスを検証します。
./scripts/verify.sh
MongoDB は、ワークフロー全体で中央データレイヤーとして機能します。リポジトリドキュメント:
配置コンポーネントとセットアップスクリプト
視覚言語モデル処理
オブジェクトストレージワークフロー
同期パス
キーポイント
イメージからページの在庫を取得: 視覚言語モデルを使用して、置換用階層の画像をMongoDB が保存し、アプリケーションが処理する構造化JSONに変換します。
MongoDBドキュメントとしてのインベントリ データのモデル化:メタデータのキャプチャと検出アイテムをまとめて保持することで、各ドキュメントが1 回のシェルチェックを表すようにします。
MongoDBベースの状態をクライアントデバイス間で同期: MongoDB Change Streams と PowerSync を使用して、カスタム ポーリング ロジックを構築せずに選択したインベントリ フィールドを分散します。
運用データを未加工のメディアから分離します 。在庫データとイメージ参照をMongoDBに保存し、メディアの永続性を有効にすると、未加工のフレームをAmazon S3 互換のオブジェクトストレージに保存します。
切断されたリテラル ワークフローをサポート:クライアントアプリケーションがローカルで同期されたデータを使用し、再接続時にその状態を調整できるようにします。
作成者
MongoDB、Timothy Markand、 MongoDB
Alberto Camarena Rodriguez, MongoDB
MongoDB、 MongoDB