MongoDB Atlas의 그리드 지원 에이전트를 통해 그리드 토폴로지를 모니터링하고, 날씨 데이터로 수요를 예측하고, 고객을 분석하고, 이 모든 것을 쿼리합니다.
산업: 제조 및 모빌리티, 에너지 관리
제품 및 도구: MongoDB Atlas, MongoDB 벡터 검색, MongoDB Time Series 컬렉션, Voyage AI by MongoDB
솔루션 개요
공공 기업은 고주파 스마트 계측 데이터를 확장하여 수집하지만, 팀은 여전히 모니터링, 예측, 고객 분석 및 AI 워크플로우를 별도 시스템에서 관리하는 경우가 많습니다.
이러한 분편화는 데이터 파이프라인의 중복, 느린 결정 및 높은 운영 비용을 초래합니다.
Smart Grid Intelligent Platform은 실시간 모니터링, 네트워크 작업, 수요 예측, 고객 지능 및 그리드 지원 에이전트를 위한 하나의 운영 데이터 계층을 사용하여 MongoDB Atlas에서 이러한 워크로드를 실행하는 방법을 보여줍니다.
이 솔루션을 사용하여 다음을 수행할 수 있습니다.
실시간으로 그리드 모니터링: 데이터베이스에서 직접 장애를 감지하고, 전력 요율을 추적하고, 이상 현상(전압 스파이크, 비정상적 소비) 플래그를 지정합니다.
네트워크 운영: 그리드 토폴로지(유틸리티 → 변전소 → 피더 → 트랜스포머)를 시각화하고, 변전소 상태를 점수매기고, 실시간 용량 활용율에서 피크 부하 경고 및 장애 위험을 표시합니다.
날씨를 활용한 예측 수요: 외부 날씨 데이터(냉난방지 일수) 를 활용하여 리전별 예상 수요 및 피크 시기를 프로젝트하여 용량을 계획하고 과부하를 방지합니다.
고객 이해: 동일한 계량기 데이터에서 요금 권장, 소비 경향, 가전 단계 분석 및 사용 구간을 표시합니다.
자연어를 통한 작업: 그리드 지원 에이전트를 통해 그리드, 네트워크, 지식 기반 및 고객 데이터를 쿼리합니다.
MongoDB Atlas는 Time Series 데이터, 유연한 데이터 모델링, 데이터베이스 내 처리 및 AI 기반 검색을 위한 내장 역량으로 이 설계를 지원합니다.
MongoDB Atlas Time Series: 네이티브 Time Series 컬렉션은 고주파 측정값을 효율적으로 저장하고 빠른 시계열 쿼리를 제공합니다.
**집계 프레임워크**: 분석은 앱이 아니라 데이터베이스에서 실행됩니다.
$setWindowFields을 사용한$group갭도와 아일랜드 장애 감지, 과 를 사용한$stdDevSamp이상 및 요구 통계, 각 자산의 정격 용량에 대한 가장기/변전소 활용률. 고주파 읽기(요구, 예측)는 이미 그리드 컨텍스트를 포함하는 데이터에 대해 단일 컬렉션 스캔으로 실행됩니다.유연한 document model: 네트워크가 진화함에 따라 마이그레이션할 필요가 없는 고정된 스키마로 제어와 고객 및 그리드 네트워크 계층이 온디맨드로 연결된 관련 문서로 존재합니다.
Atlas Vector Search(자동화된 Voyage AI 임베딩 포함): 별도의 임베딩 서비스 작업 없이 도메인 지식 기바에 대한 시맨틱 검색. Voyage AI 참조
하이브리드 검색: Reciprocal Rank Fusion(RRF)가 결합되어 더 유용한 검색 결과를 제공하는 벡터 및 전문 검색 결과입니다.
MongoDB의 에이전트 AI: Atlas에 영구적으로 저장되는 도메인별 스킬 및 대화 메모리가 있는 LangGraph 다중 에이전트 도우미. 운영 데이터와 함께 컨텍스트가 저장되므로 외부 상태 저장 필요 없습니다.
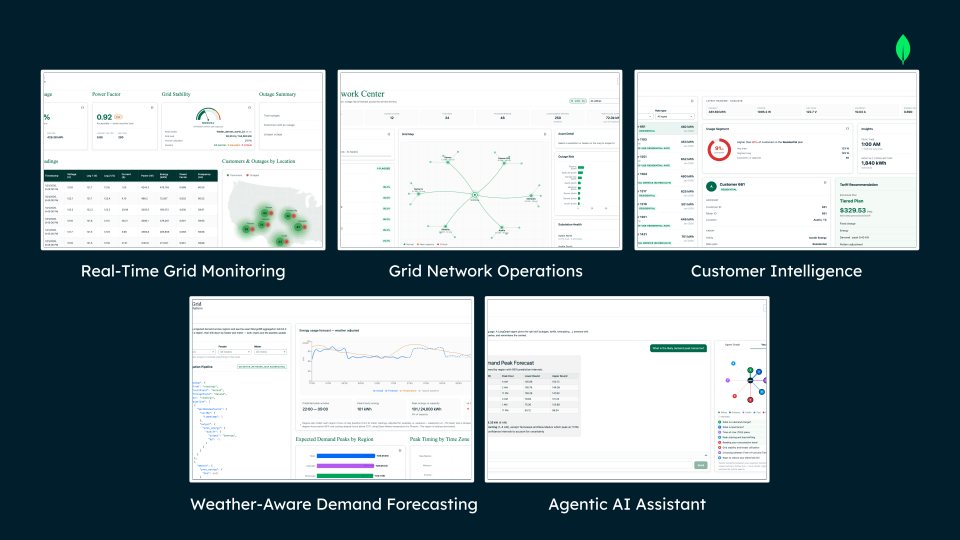
그림 1. 스마트 그리드 지능형 플랫폼의 주요 기능
참조 아키텍처
이 플랫폼은 단일 MongoDB Atlas 클러스터에서 다음 계층을 결합합니다.
모니터링, 네트워크, 예측 및 고객 보기를 제공하는 운영 데이터 계층 입니다.
사용자가 자연어로 전체를 쿼리할 수 있는 에이전트 AI 계층.
두 개 모두 동일한 문서에서 읽으므로 정보를 복사하거나 동기화하는 별도 시스템이 필요하지 않습니다.
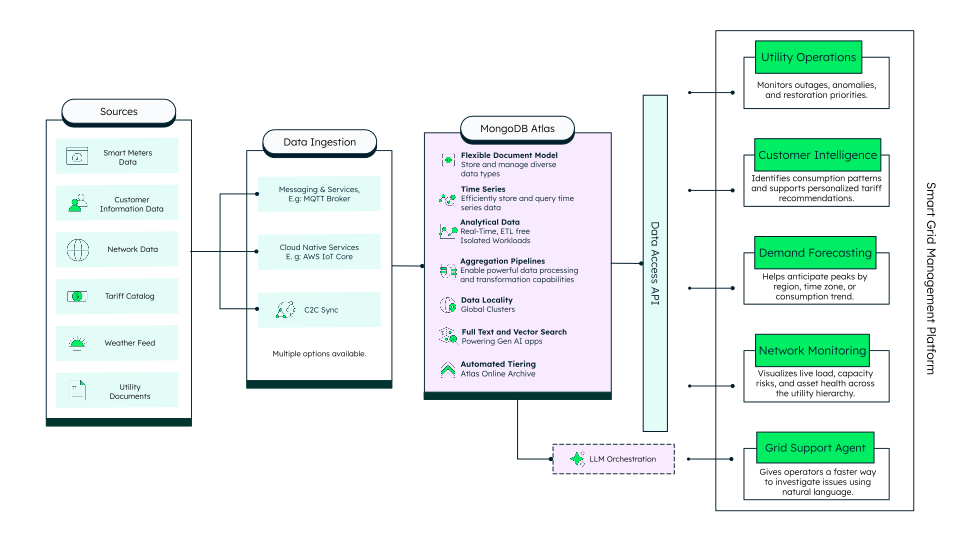
그림 2. 고수준 스마트 그리드 아키텍처 - 운영 데이터 계층
운영 데이터 계층
스마트 그리드 독서는 time series 컬렉션에 저장되고, 집계 프레임워크는 데이터베이스에서 분석을 계산하며, 그 결과는 모니터링, 네트워크, 예측 및 고객 보기를 제공합니다.
아키텍처를 통해 데이터가 흐름은 방식은 다음과 같습니다:
수집(Time Series): 고주파 스마트 계측값(전압, 전류, 전력, 에너지, 전력 요소 및 가전기 수준 하위 부하)은
readingsAtlas Time Series 컬렉션에 저장되며 확장된 규모에서 빠른 시계열 쿼리에 최적화됩니다.그리드 토폴로지 모델: 그리드 계층(유틸리티 → 변전소 → 피더 → 변압기, 용량 포함) 데이터는
network컬렉션에 저장되며,meter_network_map은 각 계측기를 피더에 연결합니다. 이 모델은 유연하기 때문에 스키마 마이그레이션 없이 토폴로지를 진화시킬 수 있습니다.데이터베이스 내 처리(집계 프레임워크): 각 보기는 데이터가 있는 곳에서 실행되는 집계 파이프라인으로 구동됩니다.
모니터링:
$setWindowFields및$shift(갭맘 및 섬) 장애 감지,$stdDevSamp(N-시그마) 매개변수 단위 이상 감지, 및 전력 요소 추적.네트워크 센터: 각 피더의 실시 부하를 합산하고 자산의 정격 용량_kw와 비교하여 활용률을 계산한 다음 유틸리티 → 변전소 → 피더 → 변압기 계층 전체의 변전소 건강 점수, 최대 부하 경고 및 장애 위험을 도출합니다.
예측:
$group+$avg및$stdDevSamp를 사용하여 리전/시간별 예상 수요 및 예측 간격을 계절 모델(시간 및 요일) 및 외부 날씨(내냉/냉난 일수)로 풍부하여 예측하고 피크 시간 보기를 제공합니다.고객:
tariff_catalog에 대한 요금 권장, 인사이트, 가전제품 분석, 사용 세그먼트 및 소비 경향.
외부 강화: 예측 워크로드는 리전별 시간당 기온을 위해 Open-Meteo 날씨 API를 호출하며, 파이프라인은 이를 도일 기능으로 변환하여 수요 예측이 실제 날씨 상태를 반영하도록 합니다.
프레젠테이션: Next.js(App Router)에서 각 파이프라인을 API 경로를 통해 노출하고 결과를 실시간 대시보드로 렌더링하는 애플리케이션입니다. 모든 카드에는 기본 문서와 그 뒤의 정확한 집계 파이프라인을 보여주는 "문서 표시" 보기가 포함되어 있습니다.
이것이 중요한 이유: 모니터링, 네트워크 작업, 예측 및 고객 인텔리전스는 모두 동일한 운영 문서에서 읽습니다. 집계 프레임워크는 별도 분석 엔진을 대체하며, 유연한 document model은 치수, 고객 및 진화하는 그리드 계층을 함께 유지하므로 플랫폼은 시스템 간 데이터를 복사하거나 조정하지 않고도 확장됩니다.
Agentic AI Layer
사용자의 자연어 질문은 질문을 추론하고, 올바른 도구를 호출하고, MongoDB에서 데이터를 조회하고, 기반이 된 답변을 반환하는 LangGraph 다중 에이전트 오케스트레이터를 통해 흐릅니다. 이 모든 과정에서 대화 메모리와 검색 데이터는 동일한 Atlas 클러스터에 존재합니다.
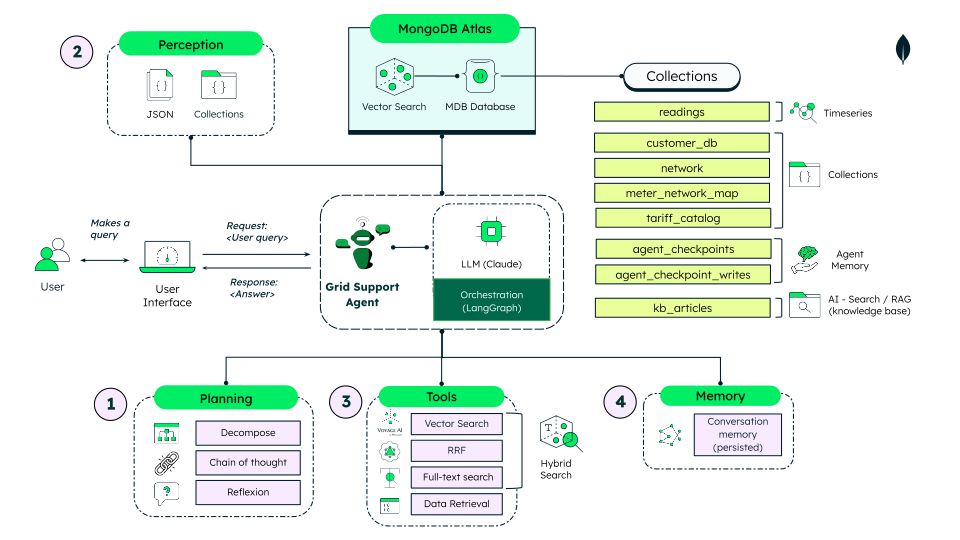
그림 3. 고수준 LLM 오케스트레이션 - Agentic AI 계층
쿼리가 아키텍처를 통해 흐르는 방법은 다음과 같습니다.
사용자 쿼리(인터페이스): 사용자가 그리드 지원 에이전트에 자연어로 질문합니다. 인터페이스는 요청(요청:
<user query>)을 에이전트에 보내고 나중에 응답(응답:<answer>)을 렌더링합니다.인식: 에이전트는 사용자 쿼리와 플랫폼의 컬렉션에 JSON으로 저장된 운영 데이터를 포함하여 세계를 MongoDB 문서로 인식합니다. 이는 에이전트가 추론하는 컨텍스트입니다.
계획: LangGraph 오케스트레이터는 요청을 해석하고 올바른 도메인 워크플로우로 라우팅하며 필요한 도구를 호출하고 기반 답변을 반환합니다.
도구: 에이전트는 선택한 도구를 실행합니다.
지식 기반에 대한 하이브리드 검색(RAG): 가장 유용한 구절을 위해 상호 순위 합치(RRF)로 합치된 벡터 검색(의미론) 및 전문 검색(키워드).
데이터 검색: 운영 컬렉션(그리드, 네트워크, 고객, 요금) 에 대한 MongoDB 집계를 통해 실시간 데이터로 답변합니다.
메모리: 대화 상태가 MongoDB Atlas(
agent_checkpoints,agent_checkpoint_writes)에 영구적으로 저장되므로 에이전트는 외부 상태 저장 없이 턴 간 컨텍스트를 기억합니다.추론 및 생성(오케스트레이션): LangGraph 오케스트레이션 계층은 루프를 조정하고 LLM(Claude)은 조회된 컨텍스트를 추론하고 최종 답변을 합성하여 사용자에게 반환합니다.
함께 가져오기: AI 계층은 논리를 복제하지 않습니다. 데이터 검색 도구는 운영 대시보드의 기능을 제공하는 동일한 집계를 호출하며, 두 계층 모두 데이터, 검색 및 에이전트 메모리에 대해 하나의 Atlas 클러스터를 공유합니다.
데이터 모델 접근 방식
이 솔루션은 MongoDB Atlas 단일 데이터 계층에서 모니터링, 네트워크 작업, 예측, 고객 인텔리전스 및 그리드 지원 에이전트를 실행합니다.
MongoDB document model은 운영, 검색 및 메모리 데이터를 유연한 컬렉션으로 조직하여 별도 시스템이 정보를 저장, 동기화 또는 조정할 필요 없이 연결되도록 하여 이를 가능하게 합니다.
이 솔루션은 운영 워크로드와 AI 기능 모두를 지원하기 위해 함께 작동하는 일련의 MongoDB 컬렉션을 기반으로 구축됩니다.
readingsTime Series 측정기 데이터를 저장합니다.customer_db,network,meter_network_map및tariff_catalog에는 주요 고객, 그리드, 매핑 및 요금 데이터가 저장됩니다.agent_checkpoints그리고agent_checkpoint_writes에서 에이전트 메모리를 유지합니다.kb_articles지식 기반에 대한 AI 검색을 제공합니다.
이러한 컬렉션은 모니터링, 분석 및 지능형 사용자 상호 작용을 위한 하나의 연결된 데이터 계층을 제공합니다. 다음 섹션에서는 각 컬렉션에 대해 자세히 설명하고 구조가 전체 솔루션을 지원하는 방법을 설명합니다.
readings: 시간 시리즈 컬렉션에 간격별 측정값 하나, 전기 측정값, 가전제품 수준 하위 부하, 사전 계산된 간격 소비량(interval_kwh), 및 그 데노르말라이즈된 그리드 문맥(피더/변전소/유틸리티)을 저장합니다.
{ "timestamp": { "$date": "2026-07-08T17:00:00.000Z" }, "dataid": 661, "power_factor": 0.933, "city": "Austin", "frequency": 60.043, "voltage": 119.958, "energy": 53.76054, "feeder_id": "feeder_austin_south_02", "kitchen_power": 168.8, "power": 3246.151, "env_power": 1112.159, "heating_power": 344.741, "utility_id": "utility_austin", "laundry_power": 61.352, "current": 29.004, "_id": { "$oid": "6a760c8ee48b9c05164d7d57" }, "avg_reading": 119.958, "interval_kwh": 0.81154, "ev_power": 0, "volt_leg_1": 118.982, "has_ev": true, "transformer_id": "transformer_austin_south_02_01", "hvac_power": 1559.099, "substation_id": "substation_austin_south", "volt_leg_2": 120.934, "state": "Texas" }
network: 유틸리티 계층을 연결된 문서로 모델링합니다.parent_asset_id은 유틸리티 → 변전소 → 공급장 → 변압기 계층을 구성하며 각 자산에는 고유한 용량과 위치가 있습니다.
{ "_id": { "$oid": "6a43f5a0fc0d1c3b5276bb29" }, "asset_id": "transformer_austin_south_02_02", "asset_type": "transformer", "city": "Austin", "state": "TX", "name": "Austin South Transformer 02-02", "parent_asset_id": "feeder_austin_south_02", "capacity_kw": 1500, "voltage_kv": 0.48, "status": "active", "location": { "type": "Point", "coordinates": [ -97.7131, 30.263199999999998 ] } }
tariff_catalog배열로 포함된 계층 밴드와 함께 요금 제도를 저장하므로 전체 계획은 하나의 문서로 읽힙니다.
{ "_id": { "$oid": "6a760c89e48b9c05164d7d4c" }, "utilityName": "Austin Energy", "rateName": "Residential", "fixedChargeFirstMeter": 15, "fixedChargeUnits": "$/month", "energyRateStrux": [ { "energyRateTiers": [ { "max": 300, "unit": "kWh", "rate": 0.04106, "adj": 0.06455 }, { "max": 900, "unit": "kWh", "rate": 0.05138, "adj": 0.06455 }, { "max": 2000, "unit": "kWh", "rate": 0.07525, "adj": 0.06455 }, { "unit": "kWh", "rate": 0.10884, "adj": 0.06455 } ] } ], "energyWeekdaySched": [... ], "energyWeekendSched": [... ], "effectiveDate": { "$date": "2025-05-01T00:00:00.000Z" }, "sourceReference": "https://austinenergy.com/-/media/project/websites/shared/pdfs/rates/tariff.pdf?rev=382867d1201343b78d6a940e4ef471b5&hash=51DA5A20032359FB44C3F61BFB5E7F5E", "rate_type": "tiered", "city": "Austin", "state": "TX", "location_label": "Austin, TX" }
kb_articles지식 기반을 저장하고 Atlas Vector Search(자동화된 Voyage AI 임베딩 포함) 및 전문 검색을 위해 인덱싱합니다. 임베딩은 별도 임베딩 파이프라인 없이 Atlas가 텍스트 필드에서 생성합니다.
{ "_id": { "$oid": "6a711e3759c1cc549f2e8c42" }, "slug": "what-is-power-factor", "category": "Glossary", "text": "Power factor is the ratio of real power (kW, the power that does useful work) to apparent power (kVA, the total power drawn). It ranges from 0 to 1. A power factor near 1.0 means electricity is being used efficiently; a low power factor (for example below 0.9) means a lot of reactive power is being drawn, which stresses the grid and can incur penalties for commercial customers. Motors, transformers, and other inductive loads lower the power factor.", "title": "What is power factor?", "updatedAt": { "$date": "2026-08-04T19:30:01.654Z" } }
meter_network_map각 미터(dataid)를 그리드 토폴로지(피더, 변전소, 유틸리티 및 변압기)에서의 위치에 매핑합니다. 동일한 컨텍스트는 각 독서에도 노르말라이즈되어 있으므로 고주파수 보기는 조인 없이 읽습니다.customer_db: 강조된 계량dataid을 사용하여 각 고객의 위치(도시 및 상태)를 저장합니다. 요금 계획과 사용 세그먼트는 온디맨드(즉tariff_catalog에서 집계로) 파생됩니다.agent_checkpoints그리고agent_checkpoint_writes: LangGraph에 의해 managed되는 에이전트 메모리를 저장하며, 어시스턴트의 대화 상태가 스레드별로 유지되므로 외부 상태 저장소 없이 턴 간에 걸쳐 컨텍스트가 유지됩니다.
Why the document model fits this solution:
각 판독값에는 해당 순간에 대한 모든 정보가 담겨 있습니다: 계량기 판독값은 전기 측정값과 기기 수준 하위 부하를 하나의 문서에 포함하며, 단일 판독값을 재구성하기 위한 조인이 없습니다. time series 컬렉션에 저장된 이러한 데이터는 고주파로 효율적으로 수집되고 쿼리됩니다.
그리드 계층은 존재하는 그대로 모델링됩니다: 네트워크(유틸리티 → 변전소 → 피더 → 변압기)는 플랫폼이 토폴로지 보기를 조립하기 위해 이동하는 연결된 문서로 저장되며, 각 독서는 해당 계층에서의 위치를 가지므로 모델은 스키마 마이그레이션 없이 성장하거나 변경할 수 있습니다.
스키마는 마이그레이션 없이 진화합니다: 새로운 애플라이언스 하위 로드, 고객 속성 또는 자산 필드를 새로운 필드로 추가할 수 있으므로 플랫폼이 확장되면 기존 문서, 파이프라인 및 애플리케이션 워크플로우가 계속 작동합니다.
동일한 데이터는 모든 워크로드를 지원합니다: 모니터링, 예측 및 고객 대시보드 뒤의 집계는 모든 운영 컬렉션에서 실행되며, 이 컬렉션은 그리드 모델 전체에 걸친 조인을 지원하여 중복을 줄이고 별도 시스템을 사용할 필요가 없습니다.
AI 데이터는 운영 데이터와 함께 존재합니다: 지식 기반, 벡터 및 전문 검색, 그리고 에이전트의 대화 메모리는 모두 동일한 MongoDB Atlas 클러스터에 존재하므로 검색, 추론 컨텍스트 및 운영 분석이 별도의 인프라스트럭처 없이 함께 작업합니다.
솔루션 빌드
Smart Grid Intelligent Platform은 MongoDB Atlas를 사용하여 실시간 모니터링, 네트워크 작업, 수요 예측, 고객 인텔리전스 및 그리드 지원 에이전트를 위한 단일 데이터 계층을 구성합니다.
다음과 같은 개략적인 단계를 따라 솔루션을 배포합니다. 자세한 설정 지침, 샘플 데이터 및 실행 가능한 코드는 Github 리포지토리에서 확인할 수 있습니다.
애플리케이션 배포
Next.js 프론트엔드를 시작합니다.
MongoDB 집계 파이프라인으로 구동되는 실시간 모니터링, 네트워크, 예측 및 고객 대시보드를 활성화합니다.
그리드 지원 에이전트(LangGraph 오케스트레이션, 하이브리드 검색 및 Atlas에 영구적으로 저장된 대화 메모리)를 활성화합니다.
http://localhost:3000에서 플랫폼을 탐색해 보세요.
주요 학습 사항
단일 데이터 플랫폼에서 작업 통합: 단일 MongoDB Atlas 클러스터에서 모니터링, 네트워크 작업, 예측 및 고객 인텔리전스를 실행하면 별도 시스템간에 계량 데이터를 복사하고 조정하는 비용과 지연이 제거됩니다. 이 방법은 총 소유 비용을 줄여 새로운 기능을 더 빠르게 생산에 적용할 수 있게 합니다.
원시 계측 데이터를 운영 결정으로 변환: 집계 파이프라인에서 장애, 용량 활용률 및 이상 지문을 직접 계산하여 연산자가 그리드 상태에 실시간으로 대응할 수 있도록 합니다. 이로 장애 시간을 줄이고 연쇄 장애로 이어지기 전에 과부하를 방지할 수 있습니다.
날씨 인식 예측으로 용량 계획 수립: 외부 날씨 데이터(내연 및 냉방 도일 수 포함) 로 수요 예측을 풍부하게 하여 공공재의 피크를 예측하고 용량을 사전에 할당할 수 있도록 돕습니다. 이로써 비용이 많이 드는 긴급 대응을 줄이고 그리드 신뢰도를 향상시킵니다.
통합 인텔리전스로 고객 결과 개선: 동일한 계측 데이터에서 요금 추천, 소비 경향, 사용 세그먼트를 제공하여 공공자기업이 고객에게 관련있고 개인화된 지침을 제공하여 고객의 참여를 유도할 수 있습니다. 이는 만족도와 유지율에 도움을 줍니다.
MongoDB에서 에이전트 기반 AI로 팀의 역량 강화: LangGraph 다중 에이전트 도우미를 사용하여 어떤 연산자든 자연어로 그리드, 네트워크 및 고객을 쿼리할 수 있습니다. 이는 데이터 액세스를 민주화하고 특수 보고서나 분석가를 기다리지 않고 의사 결정을 가속화합니다.
작성자
Muhammad Atif
Andrea Fatima Figueroa Lopez
Maria José Cordova Igartua
Javier Guajardo Canseco
Andrea Alaman Calderon