Supervise la topología de la red, pronostique la demanda con datos meteorológicos, analice a los clientes y query todo a través de un agente de soporte de red en MongoDB Atlas.
caso de uso: Búsqueda inteligente, IoT
Industrias: Fabricación y movilidad, gestión de energía
Productos y herramientas: MongoDB Atlas, MongoDB búsqueda vectorial, MongoDB colecciones de series de tiempo, Voyage AI by MongoDB
emparejar: Anthropic, LangChain
Descripción general de la solución
Las empresas de servicios públicos recopilan datos de medidores inteligentes de alta frecuencia a escala, pero los equipos a menudo siguen gestionando la supervisión, la previsión, el análisis de clientes y los flujos de trabajo de IA en sistemas separados.
Esa fragmentación crea pipeline de datos duplicados, decisiones más lentas y costos operativos más altos.
La plataforma inteligente Smart Grid muestra cómo puede ejecutar esas cargas de trabajo en MongoDB Atlas mediante el uso de una capa de datos operativa para la supervisión en tiempo real, las operaciones de red, la previsión de la demanda, la inteligencia del cliente y un agente de soporte de red.
Utilice esta solución para:
Supervise la red en tiempo real: detecte interrupciones del servicio, rastree el factor de potencia y marque anomalías (picos de voltaje, consumo inusual) directamente en la base de datos.
Operar la red: visualizar la topología de la red (utilidad → subestación → alimentador → transformador), calificar el estado de la subestación y mostrar advertencias de carga máxima y riesgo de interrupción del servicio a partir de la utilización de la capacidad en tiempo real.
Previsión de la demanda con el tiempo: proyecte la demanda esperada y el momento de máxima actividad por región, enriquecida con datos meteorológicos externos (días de grado de calefacción y refrigeración), para planificar la capacidad y evitar sobrecargas.
Comprender a los clientes: recomendaciones de tarifas de superficie, tendencias de consumo, desgloses a nivel de electrodomésticos y segmentos de uso a partir de los mismos datos del medidor.
Actuar a través del lenguaje natural: query la cuadrícula, la red, la base de conocimientos y los datos del cliente a través de un agente de soporte de cuadrícula.
MongoDB Atlas admite este diseño con funcionalidades incorporadas para datos de series de tiempo, modelado de datos flexible, procesamiento en la base de datos y recuperación con IA:
MongoDB Atlas Time Series: las colecciones de series de tiempo nativas almacenan lecturas de medidores de alta frecuencia de manera eficiente y potencian queries temporales rápidas.
Aggregation Framework: análisis ejecutados en la base de datos, no en la aplicación, detección de interrupciones del servicio de brechas e islas con
$setWindowFields, estadísticas de anomalías y demanda con$groupy$stdDevSamp, y utilización del alimentador/subestación medida con respecto a la capacidad nominal de cada activo. Las lecturas de alta frecuencia (demanda, pronóstico) se ejecutan como un escaneo de colección única sobre lecturas que ya llevan su contexto de cuadrícula.Modelo orientado a documentos flexible: los medidores, los clientes y la jerarquía de la red eléctrica viven como documentos relacionados, unidos on-demand, sin un esquema rígido que migrar a medida que la red evoluciona.
Atlas Vector Search con incrustaciones automatizadas de Voyage AI: búsqueda semántica sobre una base de conocimiento de dominio sin un servicio de incrustación independiente para operar. Consulta Voyage AI
Búsqueda híbrida: resultados vectoriales y de texto completo fusionados con Reciprocal Rank Fusion (RRF) para una recuperación más relevante.
IA agentic en MongoDB: un asistente multiagente de LangGraph con habilidades por dominio y memoria de conversación persistente en Atlas, de modo que el contexto se almacena junto con los datos operativos, sin almacenamiento de estado externo.
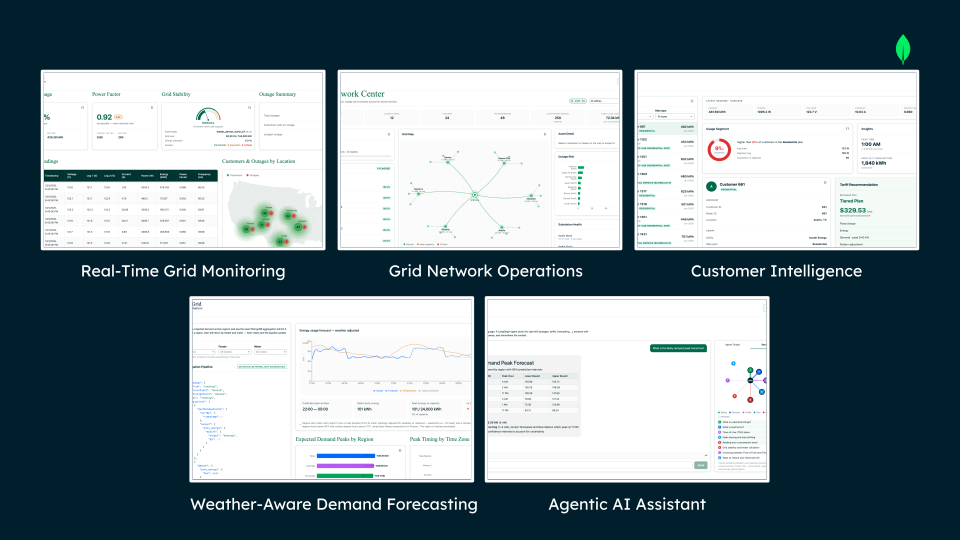
Figura 1. Funcionalidades principales de la plataforma inteligente Smart Grid
Arquitecturas de Referencia
La plataforma combina las siguientes capas en un único clúster de MongoDB Atlas:
Una capa de datos operativos que impulsa la supervisión, la red, la previsión y las vistas de los clientes.
Una capa de IA de agente que permite a los usuarios realizar query en lenguaje natural.
Ambos leen los mismos documentos, por lo que no necesita sistemas separados para copiar o sincronizar información.
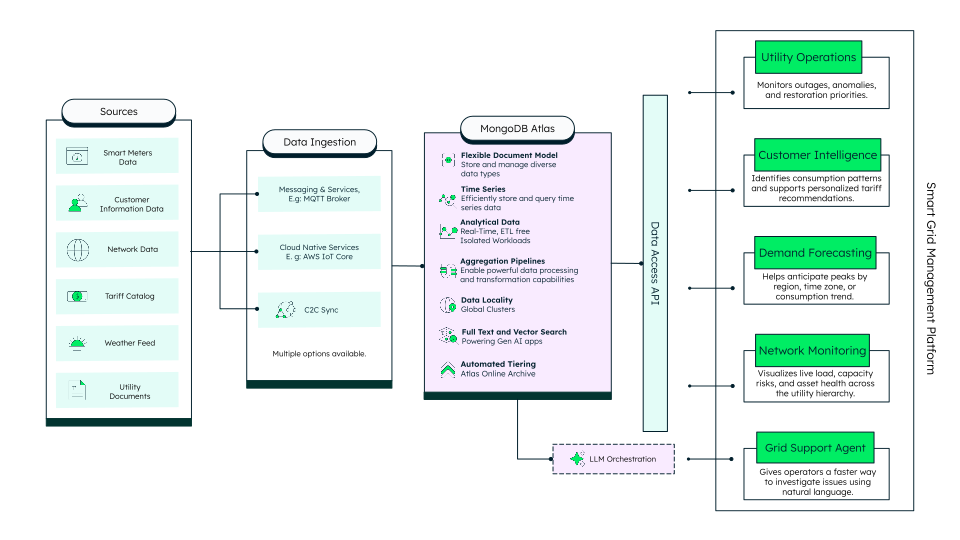
Figura 2. Arquitectura de Smart Grid de alto nivel: capa de datos operativos
Capa de datos operativos
Las lecturas de la red inteligente llegan a una colección de series de tiempo, el marco de agregación calcula el análisis en la base de datos y los resultados impulsan la supervisión, la red, la previsión y las vistas de los clientes.
Así es como fluyen los datos a través de la arquitectura:
Ingesta (serie de tiempo): Las lecturas de medidores inteligentes de alta frecuencia (voltaje, corriente, potencia, energía, factor de potencia y subcargas a nivel de electrodomésticos) se almacenan en la colección de series de tiempo de Atlas
readings, optimizadas para query temporales rápidas a escalar.Modelo de topología de red: La jerarquía de red (utilidad → subestación → alimentador → transformador, con capacidades) reside en la colección
network, ymeter_network_mapvincula cada medidor a su alimentador. Dado que el modelo es flexible, la topología puede evolucionar sin migraciones de esquema.Procesamiento en la base de datos (Aggregation Framework): cada vista funciona con un pipeline de agregación que se ejecuta donde residen los datos:
Supervisión: detección de interrupciones del servicio con
$setWindowFieldsy$shift(brechas e islas), detección de anomalías por medidor con$stdDevSamp(N-sigma) y seguimiento del factor de potencia.Centro de red: suma la carga en vivo de cada alimentador y la compara con la capacidad nominal_kw del activo para calcular la utilización, luego deriva las puntuaciones de estado de la subestación, las advertencias de carga máxima y el riesgo de interrupción del servicio en toda la jerarquía de servicios públicos → subestación → alimentador → transformador.
Previsión: demanda esperada y su intervalo de predicción por región/hora con
$group+$avgy$stdDevSamp, proyectados hacia adelante mediante un modelo estacional (hora del día y día de la semana) y enriquecidos con el clima externo (días de grado de calefacción/refrigeración), además de una vista de sincronización máxima.Clientes: recomendaciones de tarifas contra
tariff_catalog, además de perspectivas, desgloses de electrodomésticos, segmentos de uso y tendencias de consumo.
Enriquecimiento externo: la carga de trabajo de previsión llama a la API meteorológica Open-Meteo para obtener las temperaturas por hora por región, que el pipeline convierte en funcionalidades de grados-día para que las previsiones de demanda reflejen las condiciones meteorológicas reales.
Presentación: una aplicación Next.js (App Router) expone cada pipeline a través de rutas de API y renderiza los resultados como tableros en vivo. Cada tarjeta incluye una vista de "Mostrar documento" que revela los documentos subyacentes y el pipeline de agregación exacto que hay detrás.
Por qué es importante: la supervisión, las operaciones de red, la previsión y la inteligencia del cliente leen de los mismos documentos operativos. El marco de agregación reemplaza un motor de análisis independiente, y el modelo orientado a documentos flexible mantiene los medidores, los clientes y la jerarquía de cuadrícula en evolución juntos, de modo que la plataforma escala sin copiar ni conciliar datos entre sistemas.
Agentic AI Layer
La pregunta en lenguaje natural de un usuario fluye a través de un orquestador multiagente de LangGraph que razona sobre la pregunta, llama a las herramientas adecuadas, recupera datos de MongoDB y devuelve una respuesta fundamentada. Todo mientras su memoria de conversación y sus datos de búsqueda residen en el mismo clúster de Atlas.
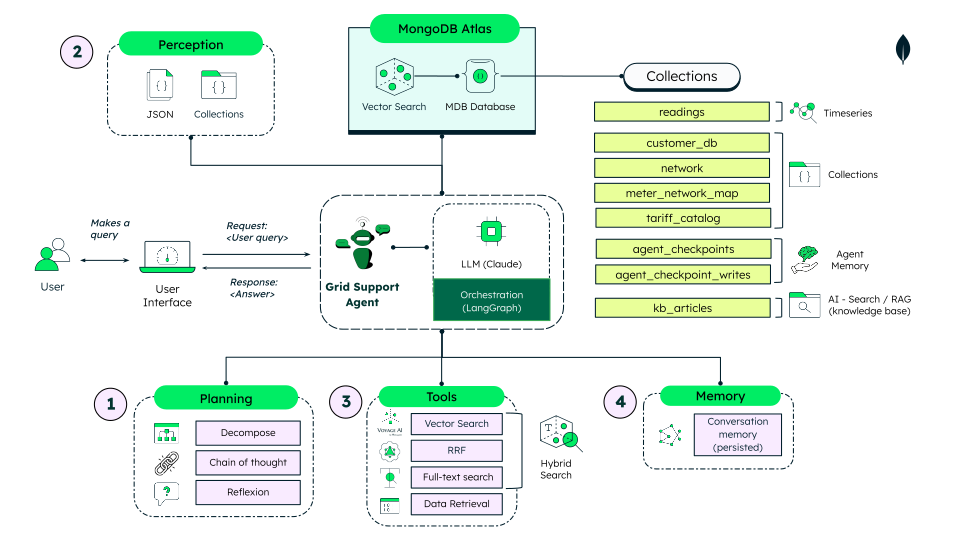
Figura 3. Orquestación LLM de alto nivel: capa de IA agentica
Así es como una query fluye a través de la arquitectura:
Query de usuario (interfaz): un usuario hace una pregunta en lenguaje natural al agente de soporte de la cuadrícula. La interfaz envía la solicitud (solicitud:
<user query>) al agente y, posteriormente, renderiza la respuesta (respuesta:<answer>).Percepción: el agente percibe su mundo como documentos de MongoDB, la query del usuario más los datos operativos almacenados como JSON en las colecciones de la plataforma. Este es el contexto sobre el que razona el agente.
Planificación: el orquestador de LangGraph interpreta la solicitud, la enruta al flujo de trabajo de dominio correcto, llama a las herramientas necesarias y devuelve una respuesta fundamentada.
Herramientas: el agente ejecuta las herramientas seleccionadas:
Búsqueda híbrida (RAG) sobre la base de conocimiento: búsqueda vectorial (semántica) y búsqueda de texto completo (palabra clave) fusionadas con Reciprocal Rank Fusion (RRF) para los pasajes más relevantes.
Recuperación de datos: agregaciones de MongoDB sobre las colecciones operativas (cuadrícula, red, clientes, tarifas) para responder con datos en vivo.
Memoria: el estado de la conversación se mantiene en MongoDB Atlas (
agent_checkpoints,agent_checkpoint_writes), por lo que el agente recuerda el contexto en todas las interacciones sin un almacén de estado externo.Razonamiento y generación (orquestación): la capa de orquestación de LangGraph coordina el bucle, y el LLM (Claude) razona sobre el contexto recuperado y sintetiza la respuesta final, que se devuelve al usuario.
Unión: la capa de IA no duplica la lógica, sus herramientas de recuperación de datos llaman a las mismas agregaciones que alimentan los tableros operativos, y ambas capas comparten un clúster de Atlas para datos, búsqueda y memoria del agente.
Enfoque de modelo de datos
Esta solución ejecuta la supervisión, las operaciones de red, la previsión, la inteligencia del cliente y un agente de soporte de red en una única capa de datos de MongoDB Atlas.
El modelo orientado a documentos de MongoDB lo hace posible al organizar los datos operativos, de búsqueda y de memoria en colecciones flexibles que permanecen conectadas sin necesidad de sistemas separados para almacenar, sincronizar o conciliar la información.
Esta solución se compila en un conjunto de colecciones de MongoDB que funcionan juntas para admitir tanto las cargas de trabajo operativas como las capacidades de IA:
readingsalmacena datos de medidores de series de tiempo.customer_db,network,meter_network_mapytariff_catalogalmacenan los datos principales del cliente, la red, la asignación y las tarifas.agent_checkpointsyagent_checkpoint_writespersisten la memoria del agente.kb_articlespotencia la búsqueda de IA en la base de conocimiento.
Juntas, estas colecciones proporcionan una capa de datos conectada para la supervisión, el análisis y las interacciones inteligentes del usuario. Las siguientes secciones describen cada colección con más detalle y explican cómo su estructura es compatible con la solución general
readings: Almacena una lectura de medidor por intervalo, mediciones eléctricas, subcargas a nivel de electrodomésticos, consumo de intervalo precalculado (interval_kwh) y su contexto de cuadrícula desnormalizado (alimentador/subestación/utilidad), en una colección de series de tiempo.
{ "timestamp": { "$date": "2026-07-08T17:00:00.000Z" }, "dataid": 661, "power_factor": 0.933, "city": "Austin", "frequency": 60.043, "voltage": 119.958, "energy": 53.76054, "feeder_id": "feeder_austin_south_02", "kitchen_power": 168.8, "power": 3246.151, "env_power": 1112.159, "heating_power": 344.741, "utility_id": "utility_austin", "laundry_power": 61.352, "current": 29.004, "_id": { "$oid": "6a760c8ee48b9c05164d7d57" }, "avg_reading": 119.958, "interval_kwh": 0.81154, "ev_power": 0, "volt_leg_1": 118.982, "has_ev": true, "transformer_id": "transformer_austin_south_02_01", "hvac_power": 1559.099, "substation_id": "substation_austin_south", "volt_leg_2": 120.934, "state": "Texas" }
network: Modela la jerarquía de servicios públicos como documentos vinculados.parent_asset_idforma la jerarquía de servicios públicos → subestación → alimentador → transformador, y cada activo tiene su propia capacidad y ubicación.
{ "_id": { "$oid": "6a43f5a0fc0d1c3b5276bb29" }, "asset_id": "transformer_austin_south_02_02", "asset_type": "transformer", "city": "Austin", "state": "TX", "name": "Austin South Transformer 02-02", "parent_asset_id": "feeder_austin_south_02", "capacity_kw": 1500, "voltage_kv": 0.48, "status": "active", "location": { "type": "Point", "coordinates": [ -97.7131, 30.263199999999998 ] } }
tariff_catalog: Almacena planes de tarifas con sus bandas de nivel incrustadas como un arreglo, de modo que un plan completo se lee como un documento.
{ "_id": { "$oid": "6a760c89e48b9c05164d7d4c" }, "utilityName": "Austin Energy", "rateName": "Residential", "fixedChargeFirstMeter": 15, "fixedChargeUnits": "$/month", "energyRateStrux": [ { "energyRateTiers": [ { "max": 300, "unit": "kWh", "rate": 0.04106, "adj": 0.06455 }, { "max": 900, "unit": "kWh", "rate": 0.05138, "adj": 0.06455 }, { "max": 2000, "unit": "kWh", "rate": 0.07525, "adj": 0.06455 }, { "unit": "kWh", "rate": 0.10884, "adj": 0.06455 } ] } ], "energyWeekdaySched": [... ], "energyWeekendSched": [... ], "effectiveDate": { "$date": "2025-05-01T00:00:00.000Z" }, "sourceReference": "https://austinenergy.com/-/media/project/websites/shared/pdfs/rates/tariff.pdf?rev=382867d1201343b78d6a940e4ef471b5&hash=51DA5A20032359FB44C3F61BFB5E7F5E", "rate_type": "tiered", "city": "Austin", "state": "TX", "location_label": "Austin, TX" }
kb_articles: Almacena la base de conocimiento del dominio, indexada para Atlas Vector Search (con incrustaciones automatizadas de Voyage AI) y búsqueda de texto completo. Atlas genera incrustaciones a partir del campo de texto sin un pipeline de incrustación independiente.
{ "_id": { "$oid": "6a711e3759c1cc549f2e8c42" }, "slug": "what-is-power-factor", "category": "Glossary", "text": "Power factor is the ratio of real power (kW, the power that does useful work) to apparent power (kVA, the total power drawn). It ranges from 0 to 1. A power factor near 1.0 means electricity is being used efficiently; a low power factor (for example below 0.9) means a lot of reactive power is being drawn, which stresses the grid and can incur penalties for commercial customers. Motors, transformers, and other inductive loads lower the power factor.", "title": "What is power factor?", "updatedAt": { "$date": "2026-08-04T19:30:01.654Z" } }
meter_network_map: Asigna cada medidor (dataid) a su lugar en la topología de la red (alimentador, subestación, servicio público y transformador). Ese mismo contexto también se desnormaliza en cada lectura, por lo que las vistas de alta frecuencia lo leen sin una unión.customer_db: Almacena la ubicación de cada cliente (ciudad y estado), con la clave del medidordataid. El plan de tarifas y el segmento de uso se derivan on-demand (detariff_catalogy por agregación).agent_checkpointsyagent_checkpoint_writes: almacena la memoria del agente, gestionada por LangGraph, donde el estado de conversación del asistente se mantiene por hilo para que el contexto sobreviva a través de los turnos, sin almacenamiento de estado externo.
Por qué el modelo orientado a documentos se adapta a esta solución:
Cada lectura contiene toda la información sobre ese momento: la lectura de un contador integra sus mediciones eléctricas y las subcargas de cada electrodoméstico en un solo documento, sin necesidad de unir varias lecturas para reconstruir una única lectura. Almacenados en una colección de series de tiempo, estos datos se ingieren y query de forma eficiente y con alta frecuencia.
La jerarquía de la cuadrícula se modela tal como existe: la red (utilidad → subestación → alimentador → transformador) se almacena como documentos vinculados que la plataforma recorre para ensamblar vistas de topología, y cada lectura lleva su lugar en esa jerarquía, por lo que el modelo puede crecer o cambiar sin migraciones de esquema.
El esquema evoluciona sin migraciones: se pueden agregar nuevas subcargas de dispositivos, atributos de clientes o campos de activos como nuevos campos, de modo que los documentos, pipelines y flujos de trabajo de aplicaciones existentes sigan funcionando a medida que la plataforma se expande.
Los mismos datos admiten todas las cargas de trabajo: las agregaciones detrás de la supervisión, la previsión y los tableros de clientes se ejecutan en las mismas colecciones operativas que admiten uniones en el modelo de cuadrícula, lo que reduce la duplicación y evita sistemas separados.
Los datos de IA conviven con los datos operativos: la Base de Conocimiento, la búsqueda vectorial y de texto completo, y la memoria de conversación del agente conviven en el mismo clúster de MongoDB Atlas, por lo que la recuperación, el contexto de razonamiento y el análisis operativo funcionan juntos sin una infraestructura separada.
Compilar la solución
La plataforma inteligente Smart Grid utiliza MongoDB Atlas como una única capa de datos para la supervisión en tiempo real, las operaciones de red, la previsión de la demanda, la inteligencia del cliente y un agente de soporte de red.
Siga estos pasos de alto nivel para implementar la solución. Para obtener instrucciones de configuración detalladas, datos de muestra y código ejecutable, consulte el repositorio de GitHub.
Configura tu entorno.
Instale los requisitos previos (Node.js para el frontend de Next.js, Python con uv para el backend).
Cree un clúster de MongoDB Atlas (M10 o superior, necesario para Atlas Vector Search con incrustaciones automatizadas).
Obtenga una clave de API de Voyage AI y una clave de API de Anthropic (el agente de soporte de la cuadrícula utiliza Claude).
Configure las variables de entorno para la URI de conexión de MongoDB, los nombres de la base de datos y de la colección, y las credenciales de la API.
Configure su base de datos.
Aprovisionamiento del modelo de datos y los datos de soporte necesarios para los flujos de trabajo operativos, de red, de clientes, de precios y de base de conocimiento.
Habilita las capacidades de indexación y recuperación necesarias para admitir análisis de cuadrícula y búsqueda híbrida.
Sembrar la Base de Conocimiento.
Cargar los artículos de la Base de Conocimiento del dominio.
Habilite Atlas Vector Search con incrustaciones automatizadas de Voyage AI, de modo que las incrustaciones se generen en la base de datos.
Habilite la búsqueda de texto completo para admitir la recuperación híbrida (vector + palabra clave).
Implemente su aplicación.
Inicia el frontend de Next.js.
Habilite los tableros de supervisión en tiempo real, red, pronóstico y cliente, cada uno impulsado por pipeline de agregación de MongoDB.
Habilite el agente de soporte de la red (orquestación de LangGraph, búsqueda híbrida y memoria de conversación persistente en Atlas).
Explore la plataforma en http://localhost:3000.
Lecciones clave
Consolidar operaciones en una única plataforma de datos: ejecutar la supervisión, las operaciones de red, la previsión y la inteligencia del cliente en un clúster de MongoDB Atlas elimina el costo y el retraso de copiar y conciliar los datos del medidor en sistemas separados. Este enfoque reduce el costo total de propiedad y permite que las nuevas capacidades se pongan en producción más rápido.
Convierta los datos sin procesar del medidor en decisiones operativas: calcule las interrupciones del servicio, la utilización de la capacidad y las anomalías directamente en los pipeline de agregación para que los operadores puedan actuar sobre las condiciones de la red en tiempo real. Esto reduce el tiempo de inactividad y evita sobrecargas antes de que se conviertan en fallas.
Planifique la capacidad con pronósticos basados en el clima: enriquezca los pronósticos de demanda con datos meteorológicos externos (incluidos los días de grado de calefacción y refrigeración) para ayudar a las empresas de servicios públicos a anticipar los picos y asignar la capacidad de forma proactiva. Esto reduce la costosa respuesta de emergencia y mejora la confiabilidad de la red.
Mejore los resultados de los clientes con inteligencia unificada: sirva recomendaciones de tarifas, tendencias de consumo y segmentos de uso de los mismos datos de medidor para ayudar a las empresas de servicios públicos a interactuar con los clientes con una orientación relevante y personalizada. Esto apoya la satisfacción y la retención.
Potencie a los equipos con IA de agente en MongoDB: utilice un asistente de múltiples agentes de LangGraph para permitir que cualquier operador query la cuadrícula, la red y los clientes en lenguaje natural. Esto democratiza el acceso a los datos y acelera las decisiones sin tener que esperar informes o analistas especializados.
Autores
Muhammad Atif
Andrea Fatima Figueroa Lopez
Maria José Cordova Igartua
Javier Guajardo Canseco
Andrea Alaman Calderon