explain 結果を使用して、クエリに関する次の情報を判別できます。
クエリの完了までにかかった時間
クエリでインデックスが使用されているかどうか
クエリを実行するためにスキャンされたドキュメントとインデックス キーの数
注意
クエリの explain プランの結果は、MongoDB のバージョンによって変更される可能性があります。
cursor.explain("executionStats") メソッドと db.collection.explain("executionStats") メソッドは、クエリのパフォーマンスに関する統計を提供します。これらの統計は、クエリでインデックスが使用されているかどうか、またどのように使用されているかを測定するために役立ちます。詳細についてはdb.collection.explain()を参照してください。
クエリのパフォーマンス評価
このページの例では、 sample_mflix データセット のデータを使用します。このデータセットを自己管理型MongoDBデプロイにロードする 方法の詳細については、「 サンプル データセットをロードする 」を参照してください。サンプルデータベースに変更を加えた場合、このページの例を実行するには、データベースを削除して再作成する必要がある場合があります。
このページの例では、 sample_mflixサンプルデータセット のデータを使用します。このデータセットを配置にロードする方法の詳細については、「 Atlas 配置へのサンプル データのインポート 」を参照してください。
データセットを読み込んだ後、 MongoDB Compass を同じ配置に接続し、moviesコレクションを開きます。
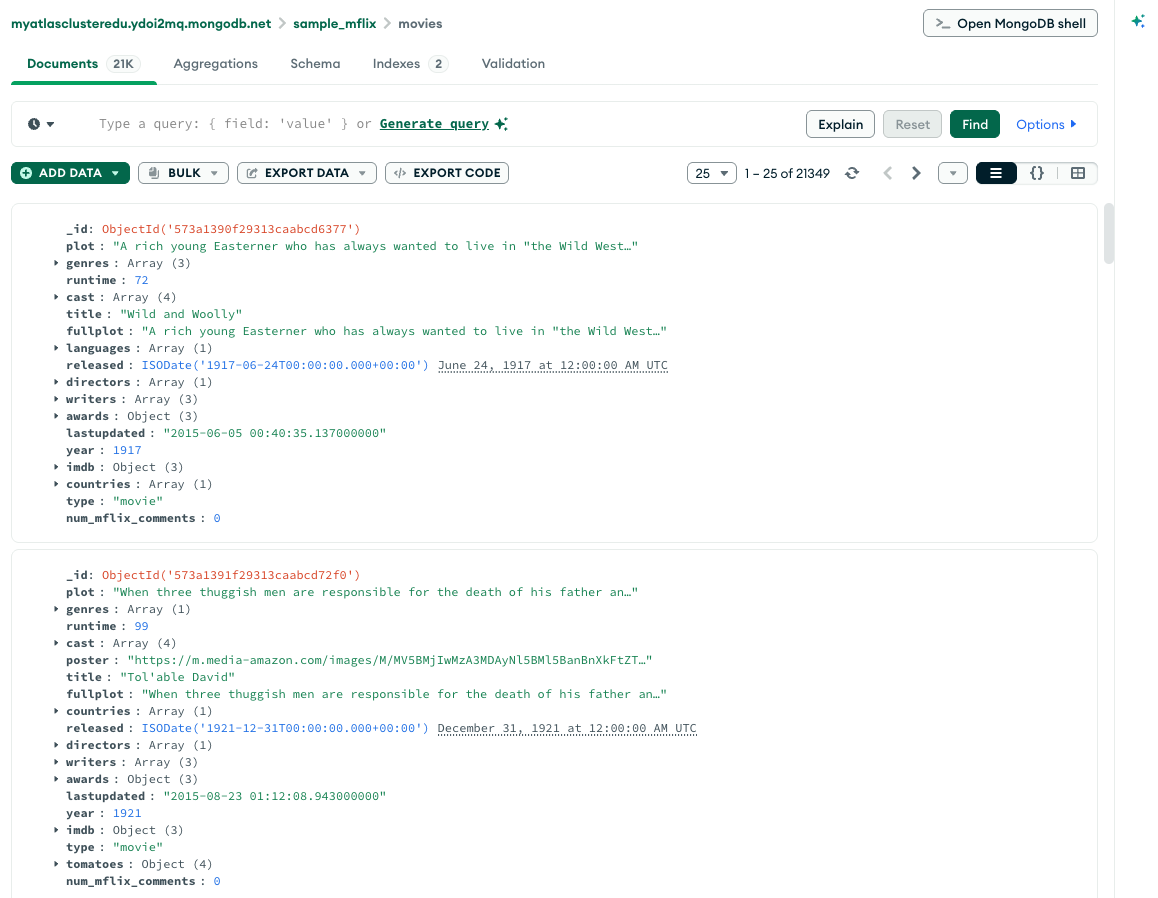
コレクションドキュメントはMongoDB Compassに以下のように表示されます。
インデックスなしのクエリ
次のクエリは、year フィールドの値が 2000 から 2005 までの間のドキュメントを取得します。
db.movies.find( { year: { $gte: 2000, $lte: 2005 } } )
このクエリは、コレクション内の 21349 ドキュメントの 3809 と一致します。
選択したクエリ プランを表示するには、 cursor.explain("executionStats") カーソル メソッドを find コマンドの後に続けて記述します。
db.movies.find( { year: { $gte: 2000, $lte: 2005 } } ).explain("executionStats")
{ queryPlanner: { namespace: 'sample_mflix.movies', winningPlan: { stage: 'COLLSCAN', '...': '...' }, '...': '...' }, executionStats: { executionSuccess: true, nReturned: 3809, totalKeysExamined: 0, totalDocsExamined: 21349, executionStages: { stage: 'COLLSCAN', '...': '...' }, '...': '...' }, '...': '...' }
queryPlanner.winningPlan.stageはコレクションスキャンを示すCOLLSCANを表示します。コレクションスキャンは、
mongodが結果を特定するためにコレクション全体をドキュメントごとにスキャンする必要があったことを示しています。これは通常、コストのかかる操作であり、クエリが遅くなる可能性があります。executionStats.nReturned3809には3 が表示され、選出されたクエリプランが,809 ドキュメントを返すことを示します。executionStats.totalKeysExaminedは0を表示し、このクエリがインデックスを使用していないことを示します。は を表示し、
executionStats.totalDocsExamined21349MongoDB21 349がコレクション内のすべての, ドキュメントをスキャンして,3809 に一致するドキュメントを検索する必要があったことを示します。
次のクエリは、year フィールドの値が 2000 から 2005 までの間のドキュメントを取得します。
次のフィルターを Compass のクエリ バーにコピーし、[Find] をクリックします。
{ year: { $gte: 2000, $lte: 2005 } }
このクエリは、コレクション内の 21349 ドキュメントの 3809 と一致します。
クエリプランを表示するには、クエリ バーの Explain をクリックします。
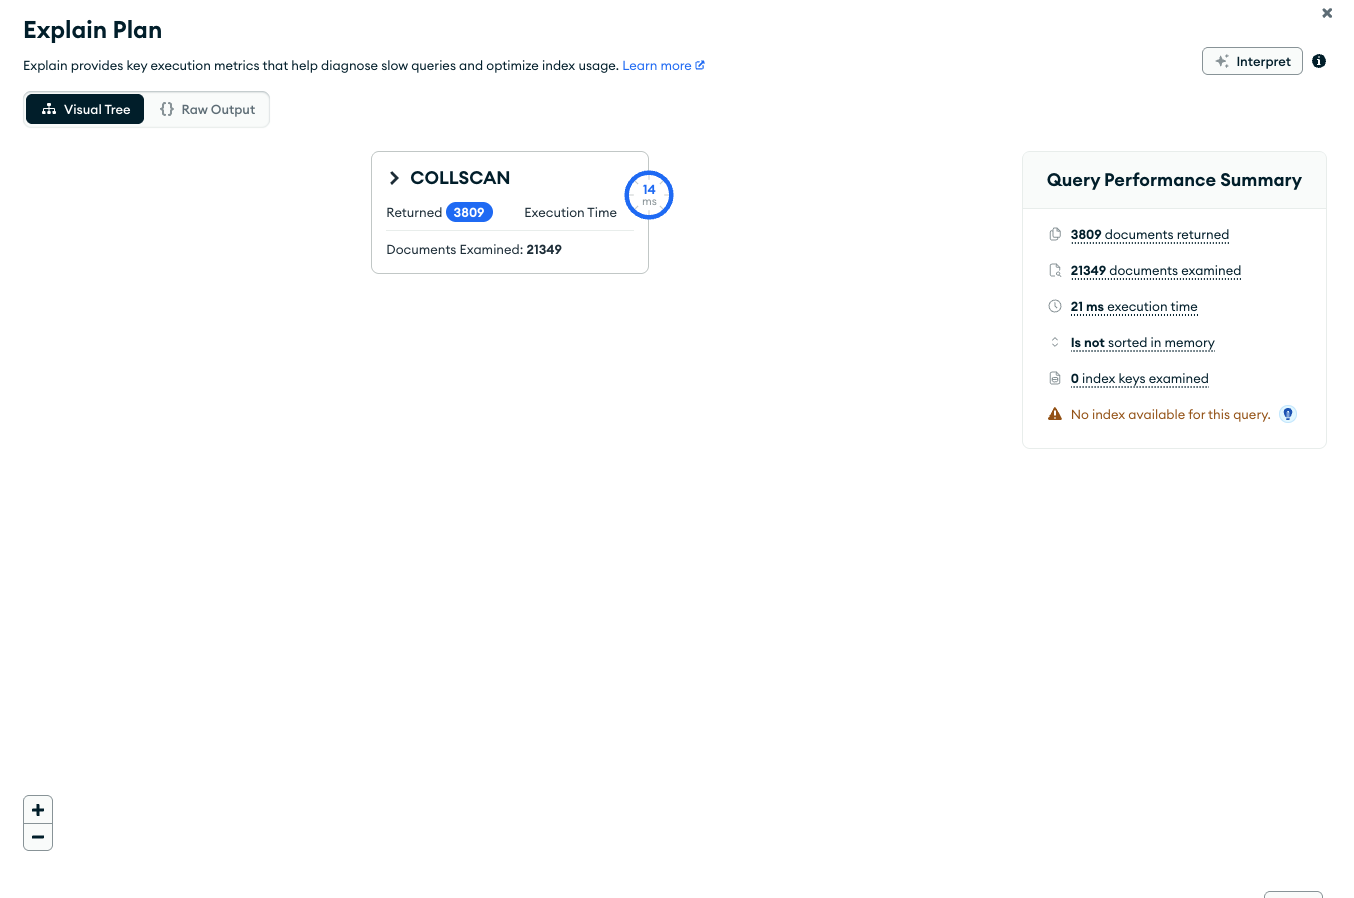
MongoDB Compass はクエリプランを次のように表示します。
ビジュアル ツリー
Query Performance Summary には、クエリの実行統計が表示されます。
Documents Returned は
3809を表示し、選出されたクエリプランが3、809 ドキュメントを返すことを示します。Documents Examined は
21349を表示し、3,809 に一致するドキュメントを検索するためにMongoDB がコレクション内のすべての 21,349 ドキュメントをスキャンする必要があったことを示します。Index Keys Examined は、このクエリがインデックスを使用していないことを示す
0を表示します。
MongoDB Compass は
COLLSCANクエリ ステージを表示し、このクエリにコレクションスキャンが使用されたことを示します。コレクションスキャンは、mongodが結果を特定するためにコレクション全体をドキュメントごとにスキャンする必要があったことを示しています。これは通常、コストのかかる操作であり、クエリが遅くなる可能性があります。
Raw JSON
Raw Output オプションをクリックすると、Explain Plan の詳細は未加工JSON形式で表示することもできます。
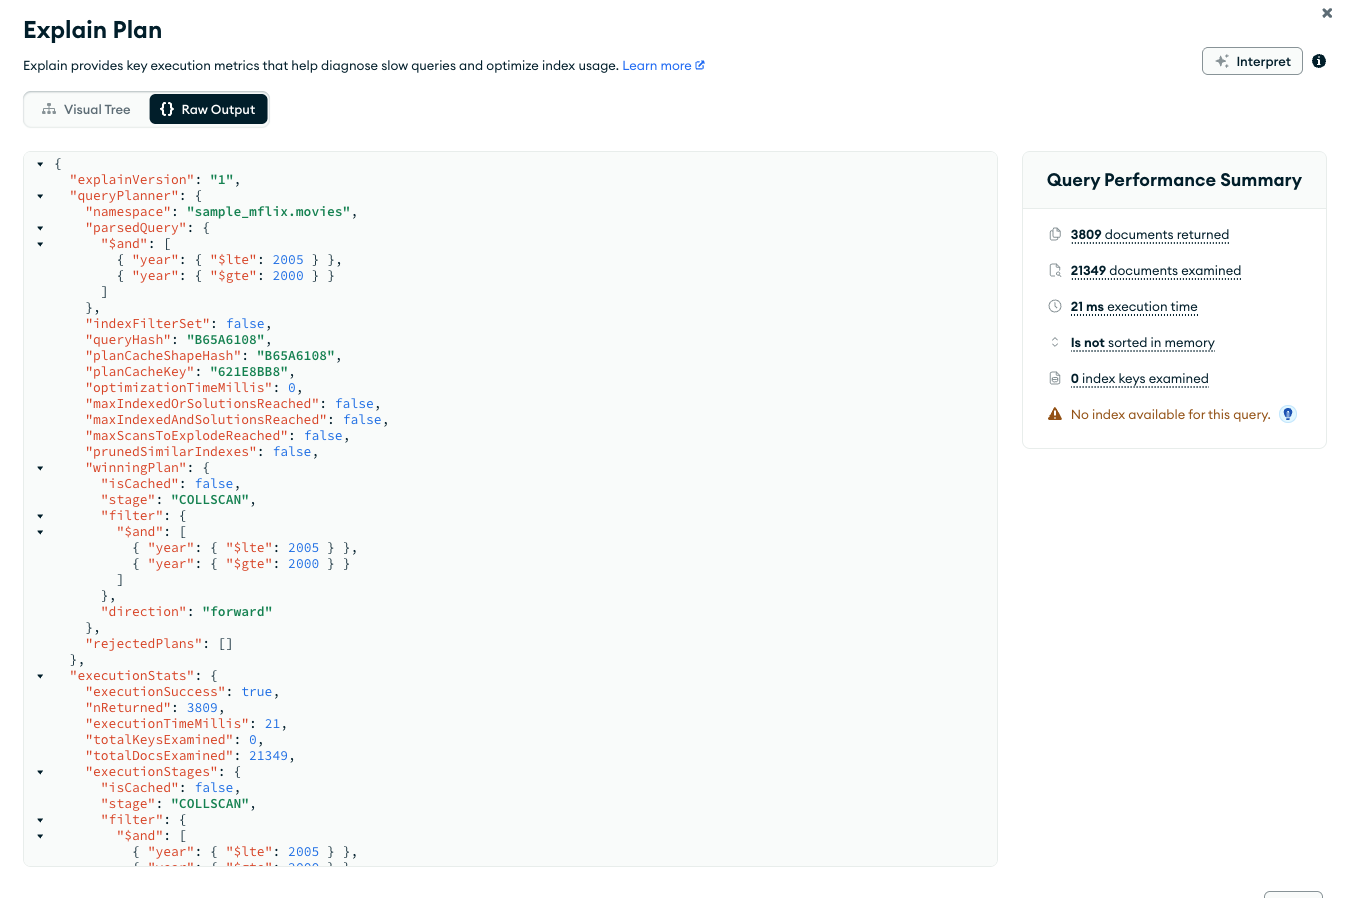
一致するドキュメントの数と検査されたドキュメントの数との差から、クエリは効率を向上させるためにインデックスを使用すると効果があると考えられます。
インデックスありのクエリ
year フィールドのクエリをサポートするには、year フィールドにインデックスを追加します。
db.movies.createIndex( { year: 1 } )
クエリプランの統計を表示するには、explain() メソッドを使用します。
db.movies.find( { year: { $gte: 2000, $lte: 2005 } } ).explain("executionStats")
{ queryPlanner: { namespace: 'sample_mflix.movies', winningPlan: { stage: 'FETCH', inputStage: { stage: 'IXSCAN', keyPattern: { year: 1 }, '...': '...' }, '...': '...' }, '...': '...' }, executionStats: { executionSuccess: true, nReturned: 3809, totalKeysExamined: 3809, totalDocsExamined: 3809, '...': '...' }, '...': '...' }
queryPlanner.winningPlan.inputStage.stageはインデックスの使用を示すためにIXSCANを表示します。executionStats.nReturned3809には3 が表示され、選出されたクエリプランが,809 ドキュメントを返すことを示します。executionStats.totalKeysExamined38093は809 を表示し、 MongoDBmongodが, インデックスエントリをスキャンしたことを示します。検査されたキーの数は、返されたドキュメントの数と一致します。つまり、 はインデックスキーを調べるだけで結果を返すことができました。mongod3809はすべてのドキュメントをスキャンする必要はなく、一致するドキュメントのみをメモリに取り込む必要がありました。これにより、クエリが非常に効率的になります。executionStats.totalDocsExaminedは38093を表示し、 MongoDB が,809 ドキュメントをスキャンしたことを示します。
year フィールドのクエリをサポートするには、year フィールドにインデックスを追加します。
sample_mflix.moviesコレクションのIndexesタブをクリックします。[Create をクリックし、ドロップダウン メニューから [Index] を選択します。
Select or type a field nameドロップダウンから
yearを選択します。Select a typeドロップダウンから
1 (asc)を選択します。[Create Index] をクリックします。
注意
[インデックス名] フィールドを空白のままにすると、MongoDB Compass はインデックスのデフォルト名を作成します。
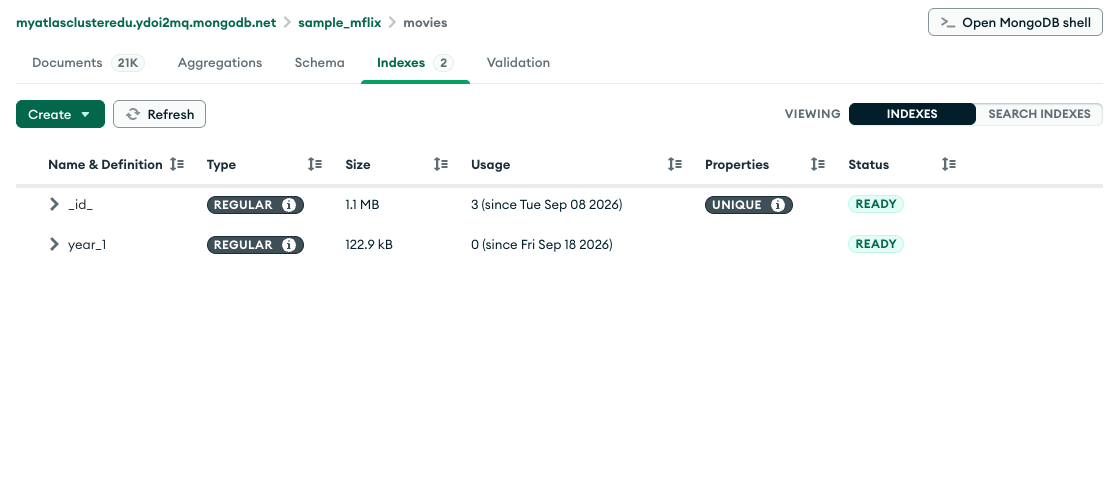
これで [Indexes] タブに新しく作成したインデックスが表示されます。
sample_mflix.movies コレクションの [Documents] タブに戻り、前の手順のクエリを再実行します。
{ year: { $gte: 2000, $lte: 2005 } }
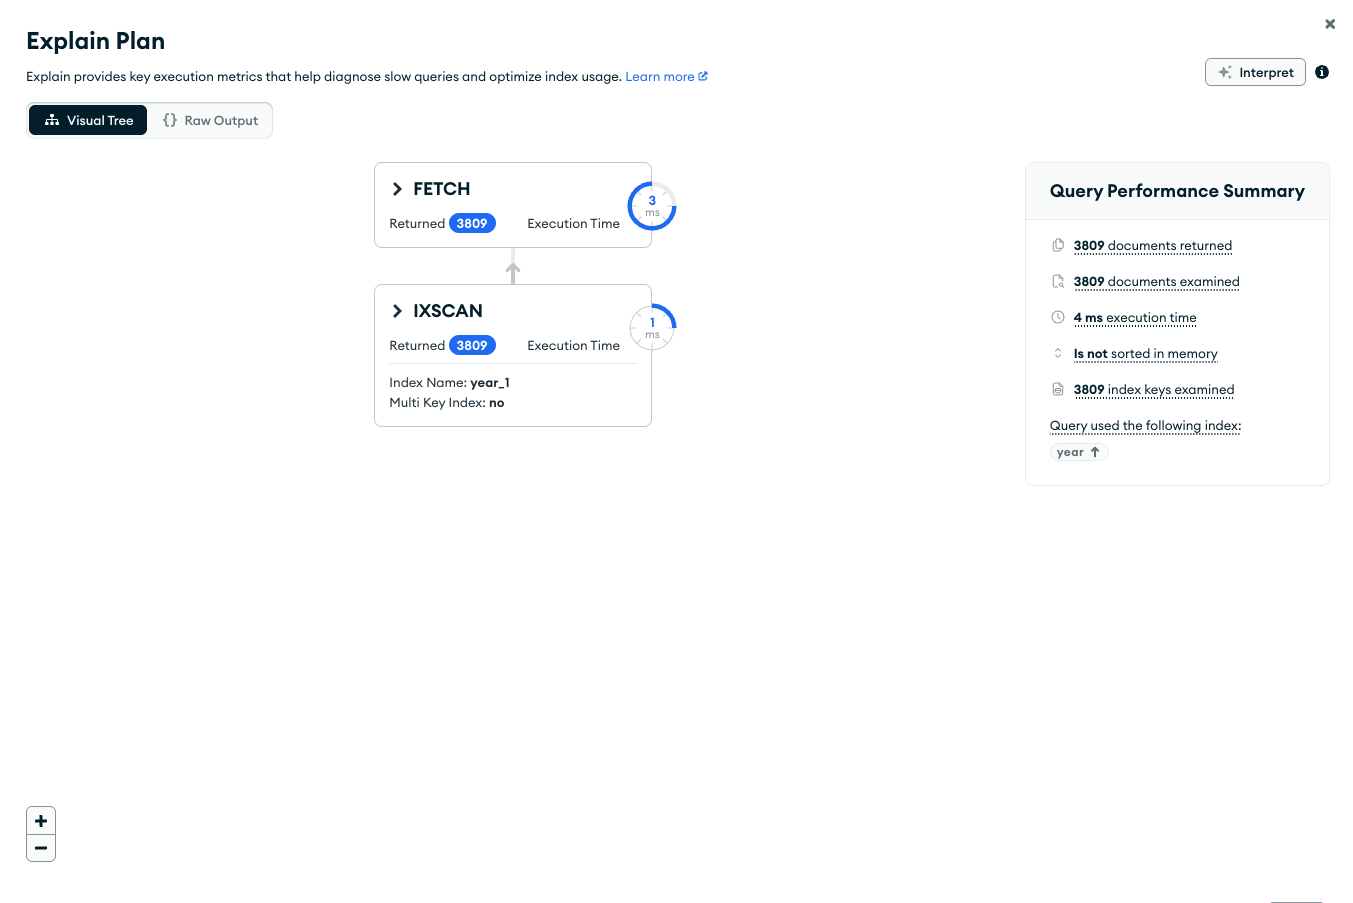
Explain Plan モーダルを開きます。 MongoDB Compass はクエリプランを次のように表示します。
ビジュアル ツリー
Query Performance Summary には、クエリの実行統計が表示されます。
Documents Returned は
3809を表示し、選出されたクエリプランが3、809 ドキュメントを返すことを示します。Documents Examined MongoDB が3、809 ドキュメントをスキャンしたことを示す
3809を表示します。MongoDB Compass は、Query Performance Summary の下部で、クエリが
yearインデックスを使用したことを示します。
Query Performance SummaryMongoDB Compass は、 の左側にクエリ ステージ
FETCHとIXSCANIXSCANmongodFETCHを表示します。 は、 が ステージを実行してドキュメントを取得する前に、クエリを満たすためにインデックスを使用したことを示します。
Raw JSON
説明の詳細は、Raw Output オプションをクリックすると、生のJSON形式で表示することもできます。
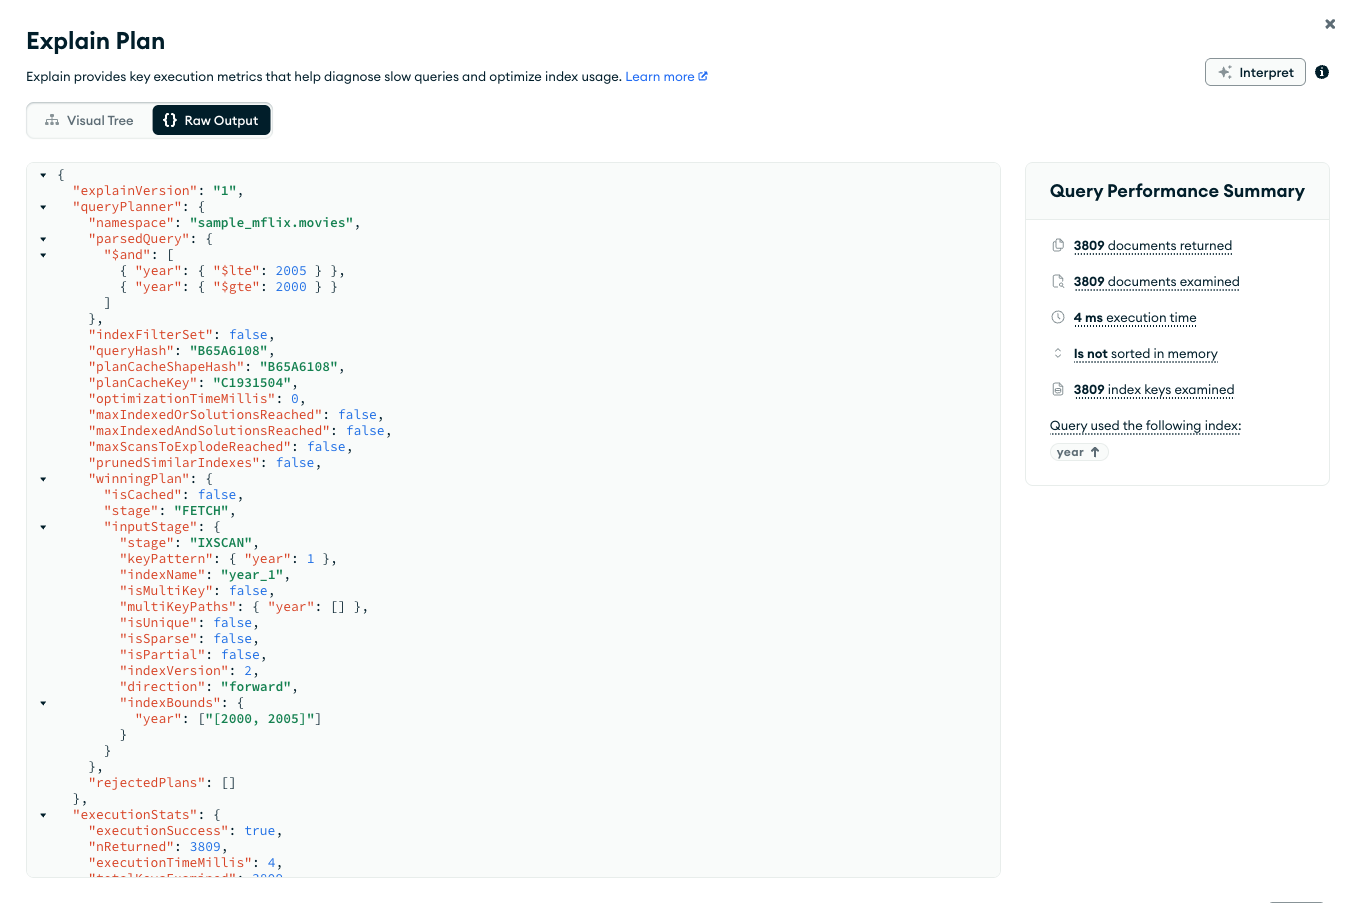
インデックスがない場合、クエリはコレクション全体をスキャンして、一致するドキュメントを返します。クエリでは各ドキュメント全体をスキャンする必要があり、場合によってはドキュメントをメモリに取り込む必要もあります。そのため、 クエリ操作にコストと時間がかかる可能性があります。
インデックスを使用して実行すると、クエリは返された数のインデックスエントリとドキュメントのみをスキャンするため、クエリの効率が向上します。
インデックスのパフォーマンスを比較する
複数のインデックスを使用してクエリのパフォーマンスを手動で比較するには、hint() メソッドとexplain() メソッドを組み合わせて使用できます。
次のクエリを考えてみましょう。
db.movies.find( { year: { $gte: 2000, $lte: 2005 }, rated: "PG" } )
このクエリは 235 ドキュメントと一致します。
クエリをサポートするために、複合インデックスを追加する。複合インデックスでは、フィールドの順序が重要です。
たとえば、次の2つの複合インデックスを追加してください。最初のインデックスは、まずyearフィールドで並べ替え、次にratedフィールドで並べ替えます。2番目のインデックスは、まずratedで並べ替え、次にyearフィールドで並べ替えます。
db.movies.createIndex( { year: 1, rated: 1 } ) db.movies.createIndex( { rated: 1, year: 1 } )
クエリに対する最初のインデックスの影響を評価してください。
db.movies.find( { year: { $gte: 2000, $lte: 2005 }, rated: "PG" } ).hint( { year: 1, rated: 1 } ).explain("executionStats")
{ queryPlanner: { namespace: 'sample_mflix.movies', winningPlan: { stage: 'FETCH', inputStage: { stage: 'IXSCAN', keyPattern: { year: 1, rated: 1 }, '...': '...' }, '...': '...' }, '...': '...' }, executionStats: { executionSuccess: true, nReturned: 235, totalKeysExamined: 246, totalDocsExamined: 235, '...': '...' }, '...': '...' }
MongoDB は246個のインデックスキー(executionStats.totalKeysExamined)をスキャンして、235個の一致するドキュメント(executionStats.nReturned)を返しました。
クエリに対する第2インデックスの影響を評価する。
db.movies.find( { year: { $gte: 2000, $lte: 2005 }, rated: "PG" } ).hint( { rated: 1, year: 1 } ).explain("executionStats")
{ queryPlanner: { namespace: 'sample_mflix.movies', winningPlan: { stage: 'FETCH', inputStage: { stage: 'IXSCAN', keyPattern: { rated: 1, year: 1 }, '...': '...' }, '...': '...' }, '...': '...' }, executionStats: { executionSuccess: true, nReturned: 235, totalKeysExamined: 235, totalDocsExamined: 235, '...': '...' }, '...': '...' }
MongoDB は235個のインデックスキー(executionStats.totalKeysExamined)をスキャンして、235個の一致するドキュメント(executionStats.nReturned)を返しました。
したがって、2{ rated: 1, year: 1 } 番目の複合インデックスである は、例クエリをサポートするためのより効率的なインデックスになります。MongoDBサーバーはMongoDBインデックスを使用して一致するすべてのドキュメントを検索するために235index keys をスキャンするだけで済むため、246 と比較して複合インデックス{ year: 1, rated: 1 } を使用します。