KubernetesクラスターにMongoDB Search とベクトル検索を配置することで、アプリケーション内で強力な検索体験を直接構築できます。MongoDB Search とベクトル検索を使用すると、伝統的なテキスト検索とAI搭載のベクトル検索機能の両方を構築できます。これらはオンプレミスMongoDBデータベースと自動的に同期します。このアプローチにより、高度な検索機能を提供しながら、別々のシステムを同期させる必要がなくなります。詳しくは以下を参照してください。
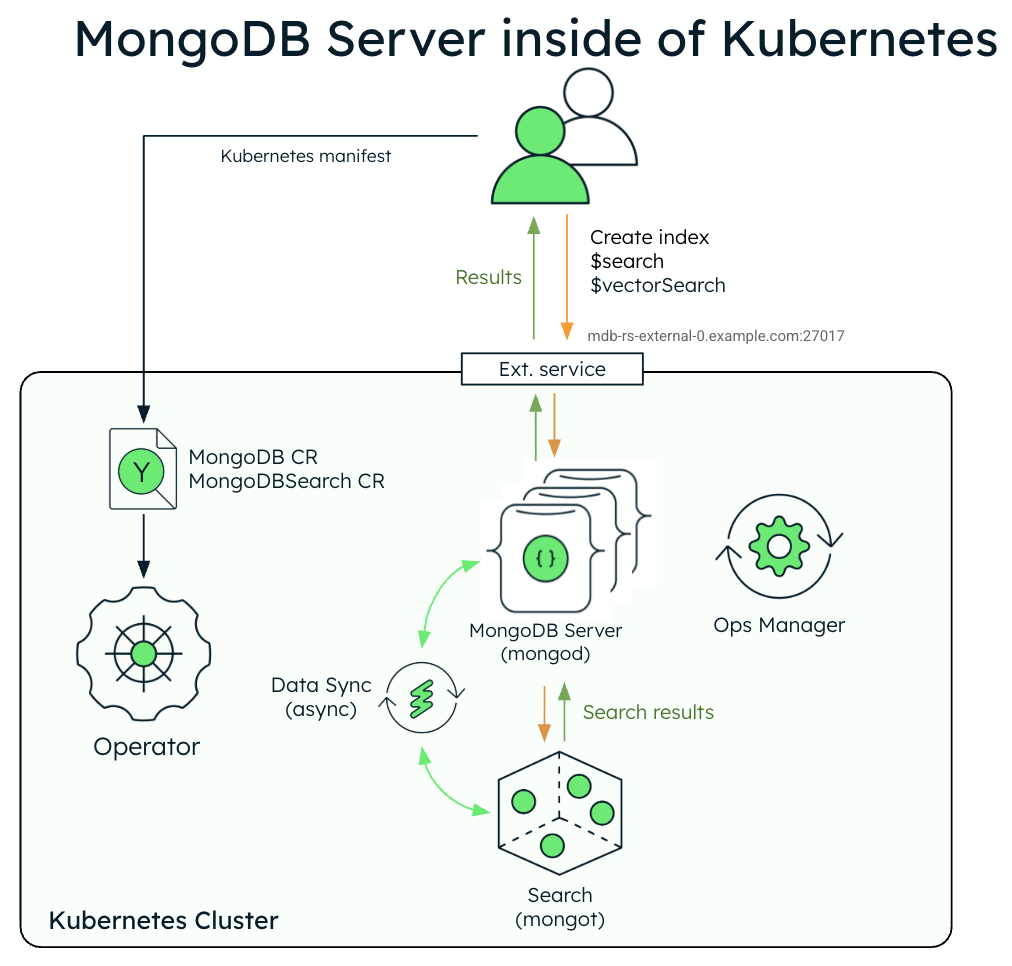
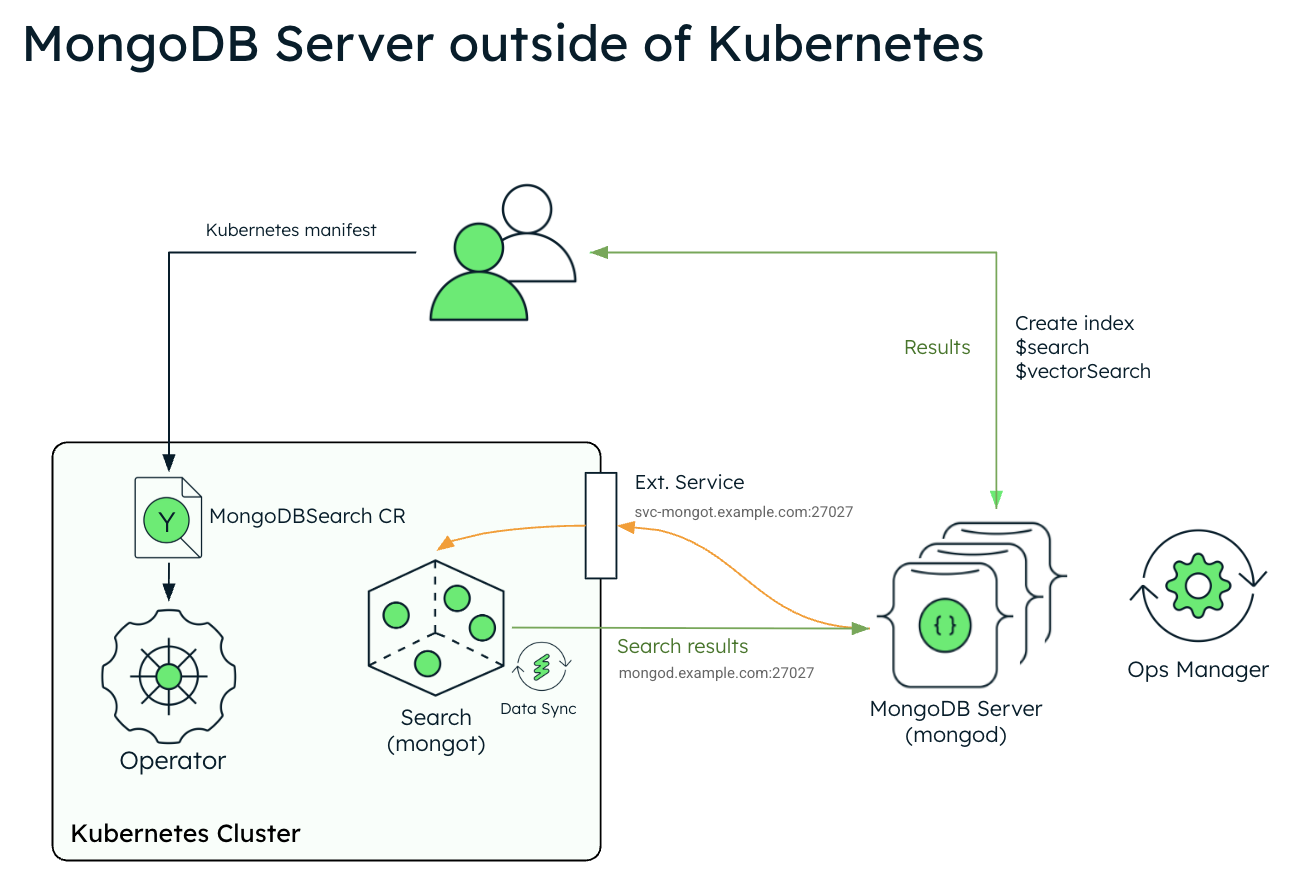
オンプレミス配置で全文検索やセマンティック検索などの検索機能を有効にするには、 MongoDB Search およびベクトル検索プロセス(mongot)を配置し、それをMongoDBデータベース配置(mongod)に接続する必要があります。mongot の配置は任意であり、提供される検索機能を使用する予定の場合にのみ必要です。
MongoDB データベース プロセス(mongod)は、mongot のすべての検索クエリのプロキとして機能します。mongod は、クエリを処理する mongot にクエリを転送します。mongot は、クエリ結果を mongod に返し、 はその結果をユーザーに転送します。mongot と直接交流することはありません。
各 mongot プロセスには、データベースや他の検索ノードと共有されていない独自の永続ボリュームがあります。ストレージ は、データベースから継続的に提供されるデータから構築されたインデックスを維持するために使用されます。インデックス定義(メタデータ)はデータベース自体に保存されます。
mongot は、次のアクションを実行します。
インデックスを管理します。
mongotは、データベース内のインデックス定義を更新します。データベースからデータを取得します。
mongotノードは、データベースへの永続的な接続をリアルタイムで確立します。検索クエリを処理します。
When
mongodreceives a$search,$searchMeta, or$vectorSearchquery, it directs the query to one of themongotnodes. Themongotthat receives the query processes the query, aggregates the data, and returns the results tomongod, which it forwards to the user.
mongot コンポーネントは 1 つのMongoDBレプリカセットと厳密に結合されているため、複数のデータベースやレプリカセットで共有することはできません。レプリカセット配置の場合、専用検索ノードの 1 つのグループがレプリカセットを提供します。シャーディングされたクラスターの場合、各シャードは mongot ノードの独自のグループを維持します。シャードは mongot インスタンスを共有しません。
mongot と mongod の間のネットワーク接続は両方向で行われます。
mongotは、インデックスの構築とクエリの実行に使用されるデータを取得するためにレプリカセットへの接続を確立します。mongodはmongotに接続して、インデックス マネジメントやデータのクエリなどの検索関連の操作を転送します。
spec.clusters[].replicasフィールドは、 Kubernetes 演算子が配置する mongot インスタンスの数を制御します。レプリカセットソースの場合、spec.clusters[].replicas は mongot ポッドの合計数を設定します。シャーディングされたクラスターソースの場合、spec.clusters[].replicas はシャードあたりの mongot ポッドの数を設定します。
spec.clusters[].replicas を 1 より大きい値に設定する場合は、mongod と mongot ポッドの間に L7 ロードバランサーを配置する必要があります。mongod プロセスは mongot への単一の永続的な TCP 接続を開くため、L4 ロードバランサーは複数の mongot インスタンスにクエリを分散できません。すべてのトラフィックはその 1 つの接続を介してフローします。L7 ロードバランサーはHTTP/2 と gRPC を理解しているため、クエリカーソルの実行中は各ストリームを単一の mongot に固定しながら、個々の gRPC ストリームを mongot ポッドに分散することができます。
MongoDB Search とベクトル検索の配置
Kubernetes 演算子 の有無による検索配置アーキテクチャに大きな違いはありません。Kubernetes Operator は、完全に機能する検索ノードを配置するのに必要な手順を簡素化します。特にデータベースも Kubernetes Operator によって管理されている場合は、その傾向が顕著です。
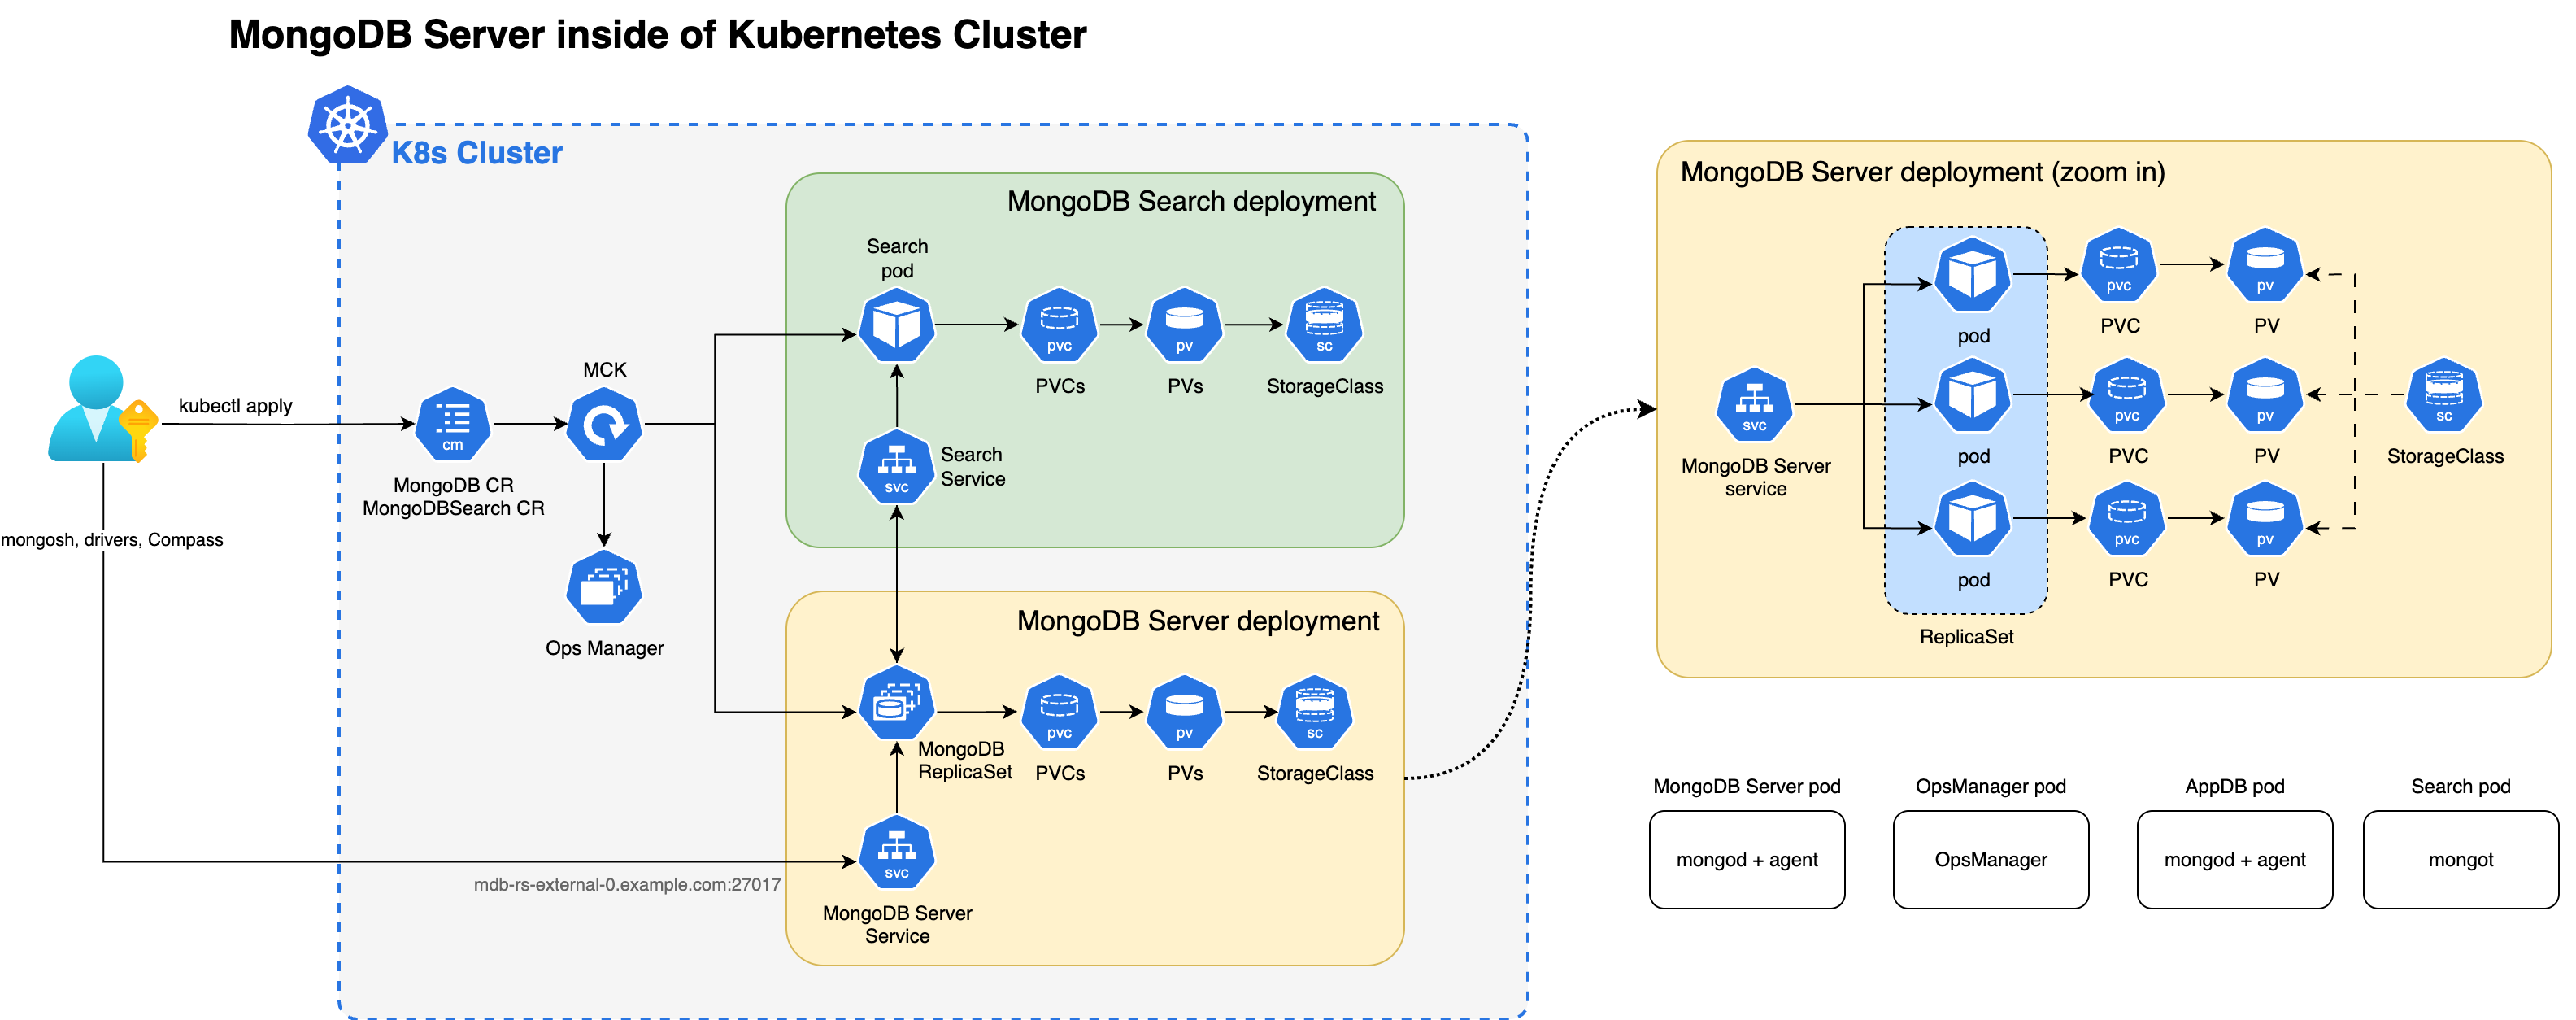
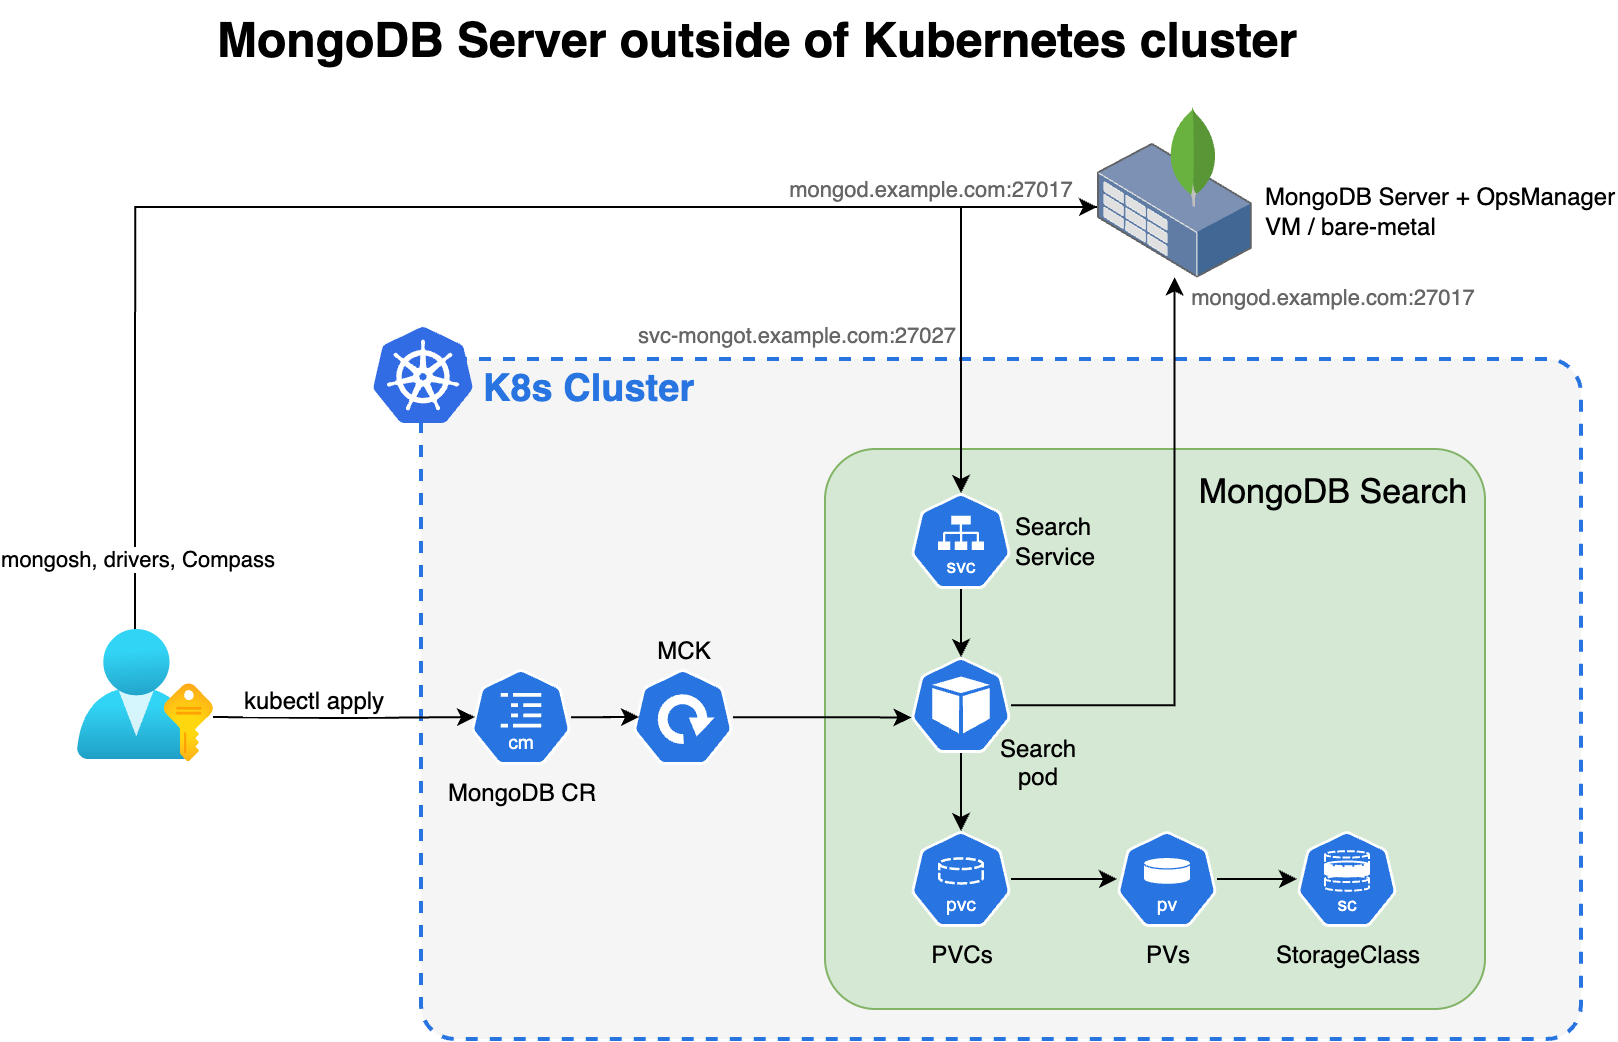
配置するには、MongoDBSearch カスタム リソース(CR)を適用します。これをKubernetes Operator が取得して mongot ポッドを取得して配置を開始し、spec で指定された永続ストレージをリクエストします。Kubernetes Operator を通じて配置されたMongoDB Search とベクトル検索 は、同じKubernetes Operator によって配置されたMongoDBレプリカセットまたはシャーディングされたクラスター、または完全に独立したKubernetesの外部MongoDBデプロイ(レプリカセットまたはシャーディングされたクラスター)を対象にすることができます。使用するように mongot を配置して構成する方法については、以下をご覧ください。
KubernetesのMongoDBレプリカセットについては、MongoDB Community Edition でのインストールと使用またはMongoDB Enterprise Edition での検索のインストールと使用を参照してください。
外部MongoDBレプリカセットは、外部MongoDB Enterprise Edition を使用してMongoDB Search およびベクトル検索をインストールして使用する を参照してください。
前提条件
でMongoDB Search とベクトル検索 を使用するには、次の手順に従います。
MongoDB Community を配置するには、 Kubernetes演算子 を使用して、完全に機能するMongoDB 8.2 以降のレプリカセットまたはシャーディングされたクラスターがKubernetesクラスター内に配置されている必要があります。
MongoDB Enterprise配置では、次のいずれかの方法で、完全に機能するMongoDB 8.2 以降のレプリカセットまたはシャーディングされたクラスターが配置されている必要があります。
Kubernetes演算子を使用するKubernetesクラスター内
Kubernetesクラスターの外部
Cloud ManagerまたはMongoDB Ops Manager のインスタンス
始める前に、以下の点を考慮してください。
設定タスク
次の表は、 Kubernetes 演算子が自動的に実行する構成タスクと、 KubernetesにMongoDB Search とベクトル検索を正常に配置するし、 KubernetesのMongoDBレプリカセットまたはシャーディングされたクラスターまたは 外部MongoDB配置に接続するために実行する必要があるアクションを示しています。
タスク | (Kubernetes 内) 実行者 | (外部 MongoDB) 実行者 |
|---|---|---|
Deploy Ops Manager inside Kubernetes | Kubernetes 演算子 | Kubernetes 演算子 |
Kubernetes の外部でのCloud ManagerまたはMongoDB Ops Managerの配置 | あなたの | あなたの |
MongoDBレプリカセットまたはシャーディングされたクラスターの配置 | Kubernetes 演算子 | あなたの |
MongoDBSearch カスタムリソースを作成する | あなたの | あなたの |
MongoDB配置への接続文字列の提供 | Kubernetes 演算子 | あなたの |
| Kubernetes 演算子 | Kubernetes 演算子 |
各 | Kubernetes 演算子 | あなたの |
| Kubernetes Operator と MongoDBUserリソースを適用することで | あなたの |
クエリ検索に必要な権限を持つユーザーでMongoDBレプリカセットを構成する | あなたの | あなたの |
MongoDB Search およびベクトル検索インデックスの作成 | あなたの | あなたの |
各 | 不要 | あなたの |
| 不要 | あなたの |
マネージド ロードバランサーの構成( | Kubernetes 演算子 | Kubernetes 演算子 |
非マネージド ロードバランサーの構成( | あなたの | あなたの |
シャードごとの TLS 証明書のプロビジョニング(TLS を使用したシャーディングされたクラスター) | あなたの | あなたの |
ロードバランサーを外部で公開する(外部MongoDB + マネージド DB) | 不要 | あなたの |
セキュリティ
次の画像は、mongot プロセスのセキュリティ設定を示しています。MongoDB 配置が Kubernetes クラスター内で実行されている場合、Kubernetes 演算子は MongoDB Search およびベクトル検索のキーファイル認証を自動的に設定します。MongoDB 配置が外部である場合は、レプリカセットのキーファイル認証情報を含む kubernetes secret を作成し、それを MongoDBSearch CR 内で参照する必要があります。
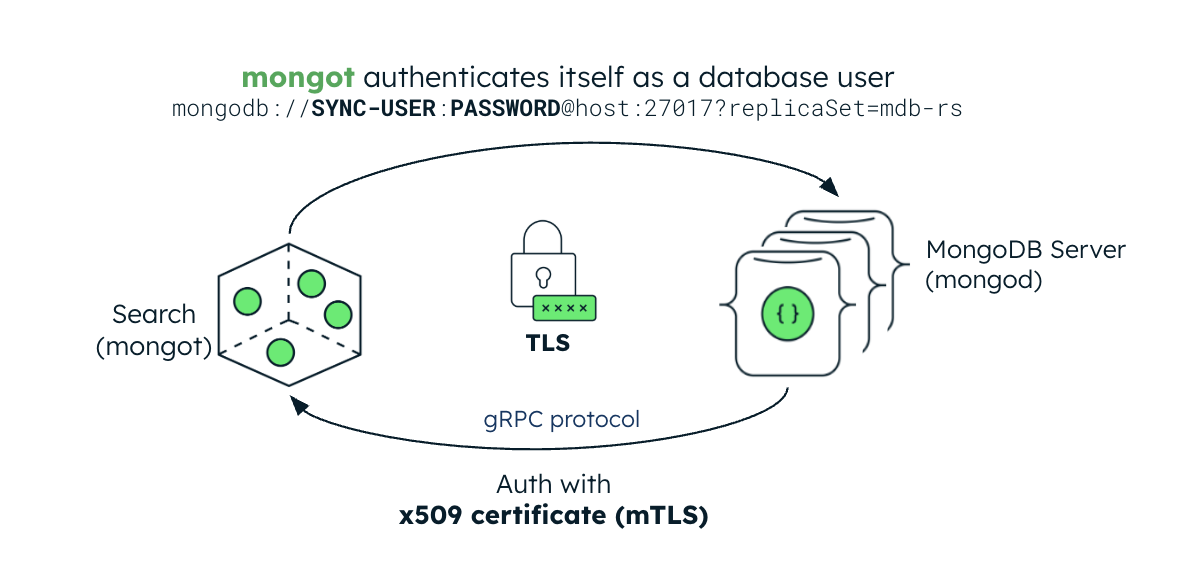
認証
mongot プロセスは、mTLS を使用して mongod 接続を認証します。TLS を有効にすると、mongot プロセスは MongoDB 配置の TLS 証明書をクライアント証明書として認証に使用します。この証明書は、mongot に構成されている CA 証明曰と照合して検証されます。認証が正常に機能するように、mongot と mongod の両方を TLS を有効にして構成する必要があります。
同じKubernetesクラスター内のMongoDBリソースをインデックスように構成された場合、MongoDB と MongoDBSearch リソースの両方が TLS 用に構成されている場合、 Kubernetes Operator は mongod CA 証明書を mongot に自動的に伝達し、検索クエリ接続で mTLS を有効にします。MongoDBレプリカセットがKubernetesの外部に配置されている場合は、レプリカセットのCA証明書を含むKubernetes secretを作成し、MongoDBSearch.spec.source.external.tls.caフィールドで参照、検索クエリリクエストでmTLS認証を有効にする必要があります。
トランスポート層のセキュリティ
MongoDBSearch は、TLS を使用して通信中のデータと認証情報を保護できます。インデックスマネジメントコマンドと検索クエリの場合は、spec.security.tls フィールドを設定し、TLS 証明書を提供します。このフィールドを空のオブジェクト ({}) に設定すると、デフォルト設定で TLS を有効にできます。
バージョン1.8.0から非推奨 : spec.security.tls.certificateKeySecretRef は非推奨です。レプリカセット配置の場合、Kubernetes 演算子は今でも certificateKeySecretRef をサポートしていますが、spec.security.tls.certsSecretPrefix に移行する必要があります。シャーディングされたクラスターの配置では、Kubernetes 演算子がシャードごとに個別の mongot サーバー証明書シークレットを読み取るため、certificateKeySecretRef は使用できません。
spec.security.tls.certsSecretPrefix は、任意フィールドです。これを指定すると、 Kubernetes Operator は読み込むすべての証明書シークレット名に <certsSecretPrefix>- を先頭に追加します。Kubernetes Operator は、次の証明書シークレットを読み取ります。
mongot 証明書
クラスター トポロジー | mongot 証明書 |
|---|---|
レプリカセット |
|
シャーディングされたクラスター |
|
ロード バランサー証明書
spec.clusters[].loadBalancer.managed を設定すると、ロードバランサーのクライアント証明書は [<certsSecretPrefix>-]<name>-search-lb-0-client-cert になります。次の表は、ロードバランサーのサーバー証明書を示しています。
クラスター トポロジー | 証明書 |
|---|---|
レプリカセット |
|
シャーディングされたクラスター |
|
TLS 証明書は、 MongoDBレプリカセットが使用する CA 証明書を発行したのと同じ CA によって発行され、署名されている必要があります。
MongoDBSearch と MongoDB の両方がKubernetes Operator によって配置されると、基礎の mongot と mongod の構成は大部分がKubernetes Operator 自体によって処理されます。MongoDBレプリカセットをKubernetesクラスターの外部に配置する場合、次のようにします。
.spec.source.external.tlsフィールドには、mongodの構成に使用したのと同じ CA 証明書を含むKubernetes Secret を入力する必要があります。searchTLSModeパラメータは、mongod構成でrequireTLSに設定する必要があります。
ロード バランサー mTLS
ロードバランサーがない場合、mongod は mTLS を使用して mongot に直接接続します。mongod は独自のクライアント証明書を提示し、mongot は信頼できる CA に対してそれを検証します。
マネージド ロードバランサー(spec.clusters[].loadBalancer.managed)を構成すると、Envy プロキシは mongod からの mTLS 接続を終了し、mongot への新しい mTLS 接続を確立します。ロードバランサーは接続を終了して再確立するため、mongot に接続するときに、元の mongod 証明書ではなく、独自のクライアント証明書が使用されます。mongot CA は、ロード バランサーのクライアント証明書を発行した認証局を信頼する必要があります。Kubernetes 演算子 は、Envy TLS 構成を自動的に管理します。次の証明書が必要です。
mongodが接続する Envy プロキシのサーバー証明書。ロードバランサーはこの証明書を使用して受信 mTLS 接続を終了します。Envy プロキシのクライアント証明書。アップストリーム mTLS 接続を確立するときにロードバランサーが
mongotに提示するもの。
spec.security.tls.certsSecretPrefix が定義する命名規則に従って、これらの証明書をKubernetes Secret としてプロビジョニングします。完全な命名パターンについては、 MongoDB Search とベクトル検索の設定 を参照してください。
診断データ
各mongotポッドは、ポッド内の/mongot/data/diagnostic.data/にFTDCファイルを書き込み (write)ます。FTDC は、詳細な mongot 内部状態をキャプチャするバイナリ診断ストリームであり、Search の問題を診断するために MongoDB Support が使用するプライマリ アーティファクトです。FTDC はデフォルトで有効になっています。サポートケースのために FTDC ファイルをコピーする方法を学ぶには、トラブルシューティング mongot 配置を参照してください。
Kubernetes 演算子は、search StatefulSet上のvolumeClaimTemplateを使用して、各mongotポッドの/mongot/dataにPersistentVolumeClaimをマウントし、mongotはそのボリューム上の/mongot/data/diagnostic.data/にFTDCファイルを書き込みます。データは PersistentVolumeClaim に保存されるため、Podの再起動や再スケジュールが発生してもデータは保持されます。StatefulSetがPodを置き換える際、同じ PersistentVolumeClaim を再接続するためです。このボリュームは spec.clusters[].persistence で構成します。MongoDBSearchリソースの設定。