MongoDB Atlas は、エージェントによる意図ベースのネットワーキングの統一されたオペレーションデータレイヤーとして機能し、AI エージェントが複雑なネットワークをリアルタイムで自動的に構成、モニター、修復できるようにします。
ユースケース: Gen AI
業種: 電気通信
製品: MongoDB Atlas、 MongoDB Search、 MongoDB Atlas Vector Search、 Voyage AI
ソリューション概要
通信 とメディア は、ソフトウェアや fin Tech と同様に、 AI の採用を先順位する業界の 1 つです。しかし、リーダーと他のユーザーとのギャップは大きくなり続けます。AIAIの最上位にある会社は、ピアの約 2 倍の収益が増加していますが、すべての会社の 34 分の 3 は、 AIプロジェクトからの具体的な値をまだ示していません。通信 組織は、特に 1 つの面で が先行しています。エージェントとしてのAIの採用率は、あらゆる業界の中で最も高いものです。ギャップはモデルではありません。エージェントがライブ ネットワーク データを操作するために必要なすべての基盤があります。
データ パイプライン
vectorSearch
埋め込み
短期メモリと長期メモリ
リアルタイム プロセシング
エージェントネットワークオートメーション、この差は閉じられます。エンジニアがリクエストを手動でデバイス構成に変換する代わりに、オートメーションエージェントが目的、プランの変更を解釈し、ネットワークに影響を与え、その結果を検証します。 IBN は、このパターンの最も明確な式です。ネットワークの結果をプレーンなビジネス用語で表現すると、システムは追加の介入なしにそれを配信し、維持します。
IBN では、演算子のカスタマーは、その構築方法ではなく、必要なものを説明します。例: 新しいフラグメント ストアを開きます。 POS トラフィックの優先順位 を付与し、ゲスト Wire を厳密に分離し、監視機能を追加して、POSレイテンシを40 ミリ秒未満に維持します。
中央エージェントはその意図をネットワークポリシーに翻訳し、サービスをプロビジョニングし、継続的にモニターします。ネットワークが約束から外れると、エージェントは原因を診断し、独自で修正を適用する。
MongoDB Atlasは、このワークフローを推進する操作データレイヤとして機能します。エージェントが必要とするすべてのリソースを1つのデータベースに統合し、現在のネットワーク状態、カスタマー合意、イベント履歴、および演算子のインサイトにわたるリアルタイムクエリを提供します。AIレイヤーはデータに直接接続し、メッセージバス、キャッシュ、ETLパイプラインを削除します。参照アーキテクチャセクションでは、このフレームワークがどのように機能するかを詳しく説明しています。
参照アーキテクチャ
このソリューションは、MongoDB Atlas によってバックアップされた単一のエージェントで実行されます。図 1 は、主なコンポーネントを示しています。
ReAct ベースのオーケストレータ
2 段階の意味ルーター
専用 MCP マイクロサービスのセット
ネットワークのデータとエージェントのメモリを保存する Atlas コレクション
すべてのサービスは Atlas から読み取りと書き込みを行い、メッセージ バス、キャッシュ、ETL パイプラインを維持する必要がなくなります。この基盤は拡張可能です。同じオーケストレーター、ルーター、メモリレイヤーは、MCP サービスとコレクションを追加することで新しいドメインを取り込みます。このフレームワークは、what-if キャパシティー プランニングのためのデジタル ネットワーク ツインなどの将来のユースケースの土台を整えます。
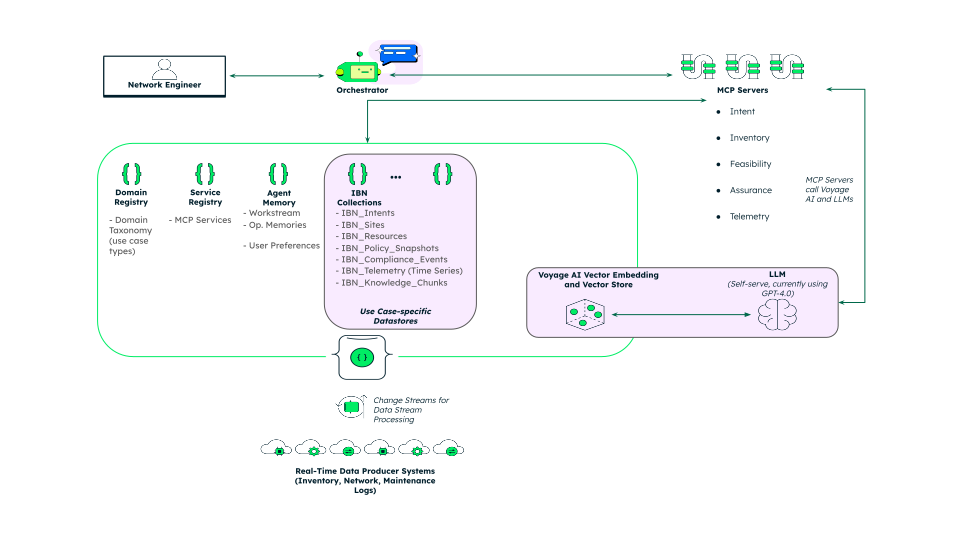
図 1オーケストレータは、サービス カタログ、IBN コレクション、エージェントのメモリを保存する MongoDB Atlas を介して各クエリをルーティングします。
クエリを適切なサービスにルーティングする
サービスの数が増えるにつれ、エージェントは適切なサービスを選択する可頼性の高い方法が必要になります。ルーティングは 2 つのステージで実行され、どちらも MongoDB によってバックアップされます。
まず、小型 LLM は、サービスごとではなくドメインごとに数行を使用して、短いドメインの分類法に対してクエリを分類します。このフレームワークにより、サービスが増えてもルーティングの精度が保たれます。次に、選択したドメインにフィルターされた Atlas $vectorSearch が、最適なサービスを取得します。サービス カタログは Atlas にあり、クエリはそれを介してルーティングされます。
インテント ライフサイクル
ネットワークの結果のインテントは、初期リクエストから最終解決まで、次のサービスを経由します。
インテントサービス: LLM を使用して自然言語リクエストを構造化されたフィールドにパースします。インテントの状態が、提出、実行可能、計画済み、アクティブ、違反、クローズの各ステージを移行するにつれて追跡します。
インベントリサービス: 物理ネットワークを保持し、地理空間座標と各ロケーションで利用可能なリソースを場にマッピングします。場で予備デバイスが必要な場合は、地理空間クエリを使用して最も近くにある利用可能なデバイスを検索します。
実現可能性サービス: 意図を現在のインベントリと照合し、具体的なサービスプランを構築し、そのプランの不可変のスナップショットを書き込みます。変更ごとに新しいスナップショットが作成されるため、プランニングの全履歴は監査可能な状態に保たれます。
保証サービス: 合意したターゲットに対してライブテレメトリをモニターします。メトリクスがそのスレッショルを超えると、コンプライアンスイベントが記録され、ダッシュボードにリアルタイムでプッシュされます。
テレメトリー シミュレーター: イベントをオンデマンドで挿入することで、管理された環境で違反、診断、修復の全サイクルをテストできます。
単一クエリで診断
ライブでの違反は最も要求の厳しい瞬間を生み出します。新しい店舗での POS レイテンシが 40 ms の目標を超えると仮定します。保証エージェントは、チケットを開く代わりに、知識ベースに対して特定のフィルターを適用する単一の Atlas 集計パイプラインを実行し、4 つの次元に対する単一の診断クエリを作成します。
意味的類似度:
$vectorSearchキューの予定の衝突、厳密なゲストのセグメンテーションの有効化、リンク使用率の低下など、説明が現在の違反に最も近い過去のインシデントを検索します。構造化されたフィルター: 結果を過去のインシデントに限定するため、ランブックとポリシー テンプレートでは一致が薄まりません。
時間ウィンドウ: 180 日以前のインシデントを除外することで、以前のネットワーク状態からの結論が結果を誤導することがなくなります。
地理空間境界: 検索をローカルに保持することで、ある都市でのインシデントが別の都市での診断を歪めることがなくなります。
これらの操作は Atlas Vector Search インデックス内でプレフィルターとして実行され、類似計算が実行される前に候補セットを絞り込みます。応答は、最近の過去のインシデント、その根本原因、および実証済みのランブックをまとめて返します。エージェントはランブックを適用し、リカバリイベントを記録し、ダッシュボードは緑色に変わります。Atlas の 1 つのパイプラインは、別々のシステムにわたる複数の協調されたクエリパスを置き換えます。
データモデルアプローチ
IBN はさまざまなデータシェイプで機能し、MongoDB Atlas はそれらをすべて 1 か所に保持します。次の各コレクションはワークフローの一部にマップされます。
ibn_intents: 解析された意図とそのライフサイクル状態を保存します。レイテンシシーリングやセグメンテーションポリシーなど、リクエストで指定されたすべてのフィールドが含まれています。ibn_sites: 地理空間ルックアップ用の 2dsphere インデックス付き座標を持つネットワークサイトが含まれます。ibn_resources: 各場で利用可能なネットワーク リソースが含まれています。ibn_policy_snapshots: 計画履歴全体を保存する不可変の計画スナップショットを保存します。ibn_telemetry. メトリクサンプルを時系列コレクションに保存します。ibn_compliance_events: すべての違反と復旧のレコードを保存します。ibn_knowledge_chunks: 過去のインシデント、ランブック、テンプレートを保存し、Voyage AI によるベクトル検索のために自動的に埋め込みます。
エージェントのメモリは MongoDB 内にもあり、ネットワーク データと一緒に専用のコレクションに保存されます。
agent_workstreams: 現在の作業スレッドの短期コンテキストを保存します。agent_memories:ワークストリームがクローズされると、長期的な事実を抽出します。セッション間でのリコールのためにベクトルインデックス化されています。user_preferences: エンジニアがエージェントに教える指示を保存します。
単一の Atlas Vector Search インデックスにより、4 次元診断クエリが可能になります。Atlas auto-embedding を使用すると、インデックスをテキスト フィールドに指定するだけで、Atlas が自動的に埋め込みを生成して保存します。別個の埋め込みパイプラインやサービスを実行する必要はありません。同じインデックスでは、自動埋め込みテキスト フィールドを構造化されたフィルター、時間フィルター、地理空間フィルターとペアリングします。その結果、$vectorSearch ステージで複数のクエリ エンジンの仕事を行います。
{ "fields": [ { "type": "autoEmbed", "modality": "text", "path": "text", "quantization": "float", "model": "voyage-4" }, { "type": "filter", "path": "kind" }, { "type": "filter", "path": "segment" }, { "type": "filter", "path": "market" }, { "type": "filter", "path": "plan_id" }, { "type": "filter", "path": "ts" }, { "type": "filter", "path": "lng" }, { "type": "filter", "path": "lat" } ] }
ソリューションのビルド
この GitHubリポジトリで完全なデモが利用できます。リポジトリをクローンして、次の手順に従います。
エージェントを実行し、ライブで監視します
ウェブ サーバーを起動し、ブラウザをインタラクティブシェルの http://localhost:8070 / に点。
./bin/start.sh
上部ナビゲーションのボタンでは、次の操作を行えます。
MongoDB コレクションにシードデータをフィードします。
デモを再実行するためにデータをリセットします。
別のブラウザー ウィンドウを開いて IBN ダッシュボードを表示します。
モニターされている場のライブ状態をリアルタイムで表示します。
インテントのライフサイクル全体を試します
ブラウザーでのチャットから、リクエストから復旧までの完全なインテントをエージェントにおけるステップバイステップで説明します。違反の診断プロンプトは、4 次元の診断クエリを実行します。
-I'm opening a new Alpenmarkt store at Marienplatz Munich. POS priority, guest WiFi strictly separated, camera uplink, online by 18:00, max 40ms POS latency, 99.95% availability -feasibility check -propose and activate -inject morning rush -diagnose violation -apply runbook
キーポイント
データを 1 つのストアに統合する: インテントレコード、地理空間サイト、時系列テレメトリ、およびベクトルインデックスされた知識を、1 つのドライバーと 1 つのパイプラインで照会できる 1 つの MongoDB Atlas データベースに保存します。
1 つのクエリで複数のディメンションを検索する: ベクトル類似度、構造化されたフィルター、時間ウィンドウ、地理空間境界を 1 つの Atlas Vector Search ステージで結合します。アプリケーション側のオーケストレーションは不要です。
リアルタイムの変更をストリームする: MongoDB Change Streams を使用して、インテントの有効化、違反、復旧をポーリングなしでダッシュボードにプッシュします。
エージェントにメモリを与える: 短期のコンテキスト、長期の事実、およびユーザー設定をコレクションとして保存します。これにより、エージェントは再トレーニングすることなく、使用することで性能が向上します。
インテントのライフサイクル全体を自動化する: 1 つのエージェントで、ライブデータに基づいてネットワークインテントを端から端まで解析、計画、有効化、保証、修復します。
作成者
Benjamin Lorenz, MongoDB
Aditya Vikram Roy、MongoDB
Diego Canales, MongoDB